Este tópico explica como gerenciar riscos de opinião pública analisando avaliações de delivery.
Contexto
Muitas empresas usam plataformas online para coletar feedback dos clientes. Esse retorno pode ser positivo (elogios) ou negativo (críticas). Compreender a opinião pública é fundamental para garantir que a qualidade dos produtos atenda às expectativas dos consumidores. Além disso, analisar o conteúdo das avaliações ajuda a identificar tendências e orientar o desenvolvimento de produtos.
As plataformas de feedback online geram um grande volume de avaliações diariamente. A análise manual desses dados é ineficiente e frequentemente imprecisa. Portanto, automatizar esse processo é essencial para coletar e avaliar a opinião pública com eficácia. A plataforma PAI oferece algoritmos baseados em vetorização e classificação de texto que usam avaliações históricas rotuladas para criar um modelo de classificação. Esse modelo prevê automaticamente o sentimento de novas avaliações. O framework completo está disponível como modelo predefinido no Designer. Baseada em um conjunto de dados real com 11.987 avaliações de delivery rotuladas, esta solução automatiza o gerenciamento de riscos de opinião pública para sentimentos positivos e negativos, atingindo precisão de aproximadamente 75%.
Use o modelo de pipeline predefinido no Designer para configurar rapidamente uma solução de gerenciamento de risco de opinião pública em um ou dois dias. Isso permite a análise inteligente e em larga escala de avaliações. A precisão do modelo aumenta conforme mais dados são coletados. Esta solução aplica-se a diversos cenários de análise de texto, como filtragem de spam e classificação de sentimentos em artigos de notícias.
Conjunto de dados
O conjunto de dados deste pipeline contém informações anonimizadas e rotuladas de uma plataforma real de delivery. A tabela a seguir descreve os campos.
|
Campo |
Tipo |
Descrição |
|
label |
DOUBLE |
Rótulo de sentimento. Valores válidos:
|
|
review |
STRING |
Conteúdo da avaliação. |
Visualize a seguir exemplos do conjunto de dados. Avaliações positivas (label: 1) incluem "A comida estava tão deliciosa e incrível, me sinto ótimo, e a entrega foi rápida" e "Entrega rápida, a comida continua deliciosa, nota dez". Avaliações negativas (label: 0) incluem "O gosto está terrível" e "A comida era claramente sobra, completamente diferente do que comprei antes".
Crie o pipeline de controle de risco
-
Acesse a página do Machine Learning Designer.
Faça login no PAI console.
No painel de navegação à esquerda, clique em Workspaces. Na página Workspaces, clique em nome do workspace que deseja gerenciar.
No painel de navegação à esquerda, escolha .
-
Construa o pipeline.
Na página do Designer, clique em aba Preset Templates.
Na lista de modelos, selecione Public Opinion Risk Control Based on Takeaway Reviews e clique em Create.
-
Na caixa de diálogo Create Pipeline, configure os parâmetros. Use as configurações padrão para todos os parâmetros.
O parâmetro Data Storage especifica o caminho de um bucket do OSS para armazenar dados temporários e modelos gerados durante a execução do pipeline.
-
Clique em Confirm.
A criação do pipeline leva cerca de 10 segundos.
Na lista de pipelines, clique duas vezes no pipeline Public Opinion Risk Control Based on Takeaway Reviews.
-
O Designer constrói automaticamente o pipeline a partir do modelo predefinido, conforme mostrado abaixo.
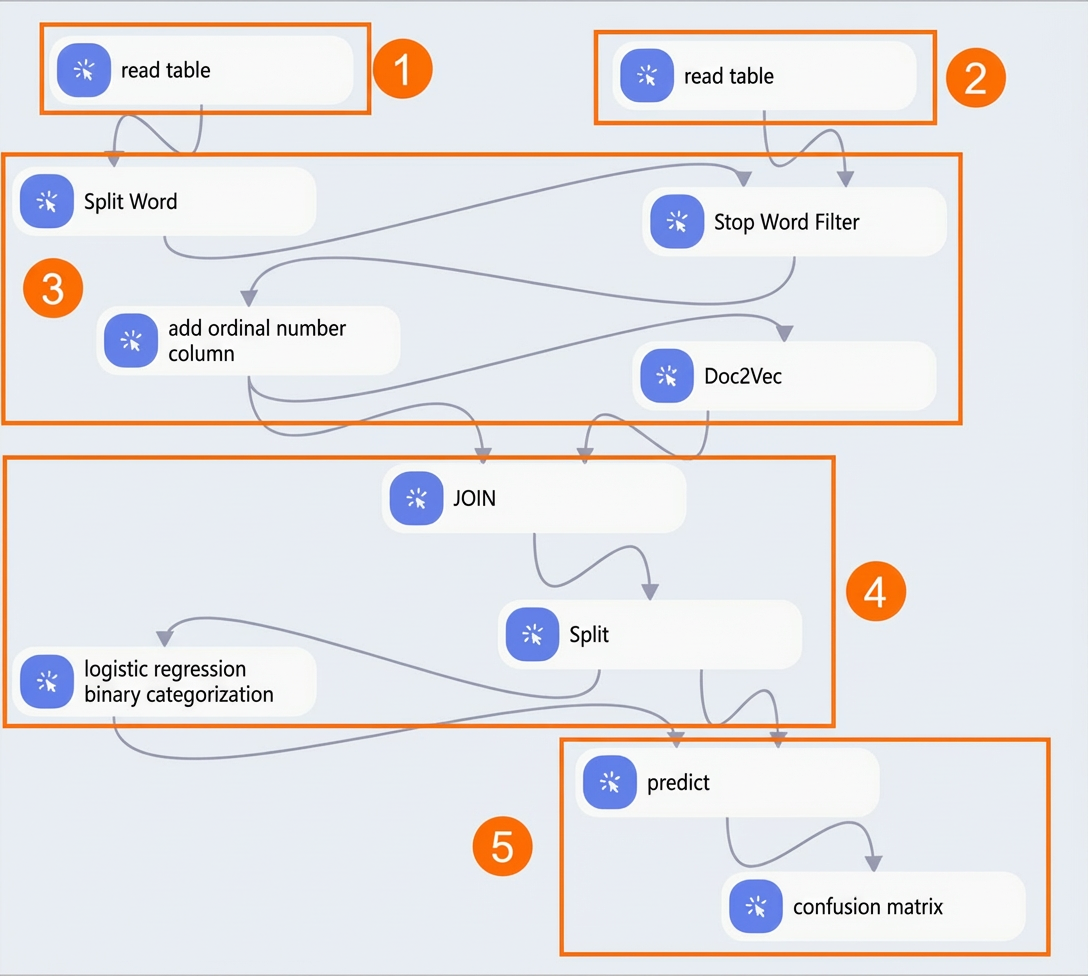
Seção
Descrição
①
Fonte de dados correspondente aos dados de avaliação.
②
Stopwords. Esta seção filtra palavras como verbos auxiliares e pontuação. Carregue manualmente uma lista de stopwords. Por exemplo, a lista stop_word contém entradas como
$,0a9,?e_.③
Vetorização de texto. O algoritmo Doc2Vec converte cada avaliação em um vetor semântico. Cada linha do vetor representa o significado de uma avaliação. Após a execução do pipeline, clique com o botão direito em Doc2Vec na tela e escolha para visualizar a tabela de vetores de texto.
④
Geração do modelo de classificação. Um componente de divisão separa o texto vetorizado em conjuntos de dados de treinamento e de teste. Em seguida, um algoritmo de regressão logística usa o conjunto de treinamento para treinar um modelo de classificação binária. Esse modelo determina se uma avaliação é positiva ou negativa.
⑤
Matriz de confusão para avaliar o desempenho do modelo.
-
Execute o pipeline e visualize os resultados.
Clique em ícone Executar
 na parte superior da tela.
Após a conclusão da execução do pipeline, clique com o botão direito no componente Confusion Matrix na tela e clique em Visual Analysis no menu de atalho.
Na seção Confusion Matrix, clique em aba Summary para visualizar as estatísticas de avaliação do modelo.