Crie um modelo para prever a qualidade do ar com base na análise de dados reais de Pequim coletados ao longo de um ano e identifique os poluentes que mais impactam os níveis de PM 2,5.
Conjunto de dados
Este experimento utiliza dados horários de qualidade do ar de Pequim referentes a 2016. A tabela a seguir descreve os campos do conjunto de dados.
|
Nome do campo |
Tipo |
Descrição |
|
time |
STRING |
Data da coleta dos dados. |
|
hour |
STRING |
Hora da coleta dos dados. |
|
pm2 |
STRING |
Índice de PM 2,5. |
|
pm10 |
STRING |
Índice de PM 10. |
|
so2 |
STRING |
Índice de dióxido de enxofre (SO2). |
|
co |
STRING |
Índice de monóxido de carbono (CO). |
|
no2 |
STRING |
Índice de dióxido de nitrogênio (NO2). |
Previsão da qualidade do ar
-
Acesse a página do Machine Learning Designer.
Faça login no PAI console.
No painel de navegação à esquerda, clique em Workspaces. Na página Workspaces, clique no nome do workspace a ser gerenciado.
No painel de navegação à esquerda, escolha .
-
Crie um pipeline.
Na página do Designer, clique na aba Preset Templates.
Na seção Air Quality Prediction, clique em Create.
-
Na caixa de diálogo Create Pipeline, configure os parâmetros. Use as configurações padrão para todos os parâmetros.
O parâmetro Data Storage especifica o caminho de um bucket do OSS para armazenar dados temporários e modelos gerados durante a execução do pipeline.
-
Clique em Confirm.
A criação do pipeline leva cerca de 10 segundos.
Na lista de pipelines, clique duas vezes no pipeline Air Quality Prediction para abri-lo.
-
O sistema cria o pipeline automaticamente a partir do modelo predefinido.
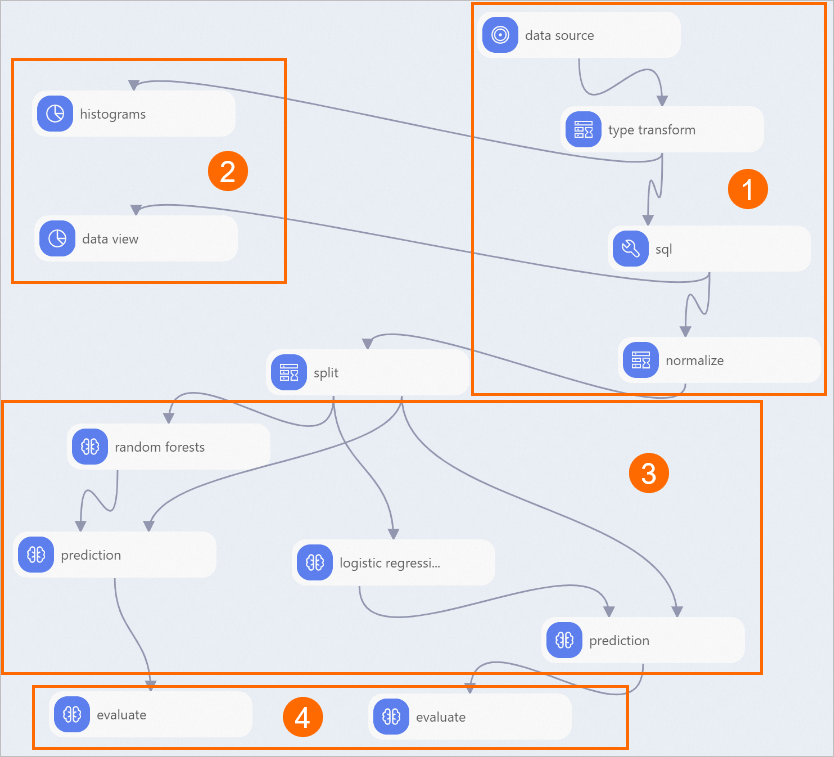
Região
Descrição
①
Importação e pré-processamento de dados:
-
O componente Read Data Table importa o conjunto de dados.
-
O componente Type Transform converte os dados de STRING para DOUBLE.
-
O componente SQL Script converte a coluna de rótulo para o tipo binário 0 ou 1. Neste experimento, a coluna pm2 é a coluna de rótulo. Valores superiores a 200, indicativos de poluição severa do ar, recebem a marcação 1. Os demais valores recebem a marcação 0. Utilize a seguinte instrução SQL:
select time,hour,(case when pm2>200 then 1 else 0 end),pm10,so2,co,no2 from ${t1}; -
O componente Normalization padroniza os dados dos indicadores de poluentes para remover a dimensionalidade.
②
Análise estatística:
-
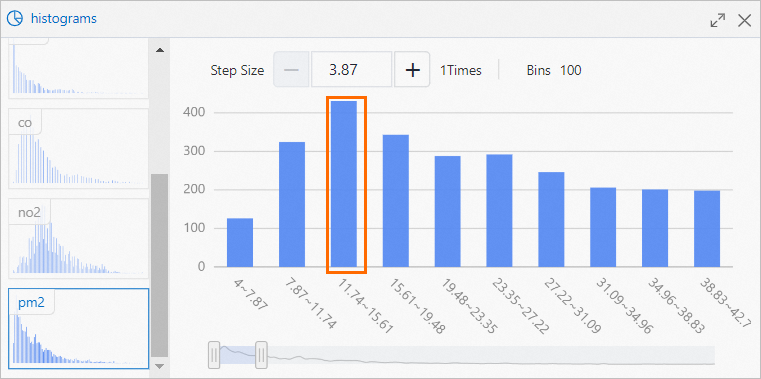
O componente Histogram visualiza a distribuição de cada poluente.
Por exemplo, para PM2,5, a faixa de valores mais frequente varia de 11,74 a 15,61, com 430 ocorrências, conforme a figura a seguir.
-
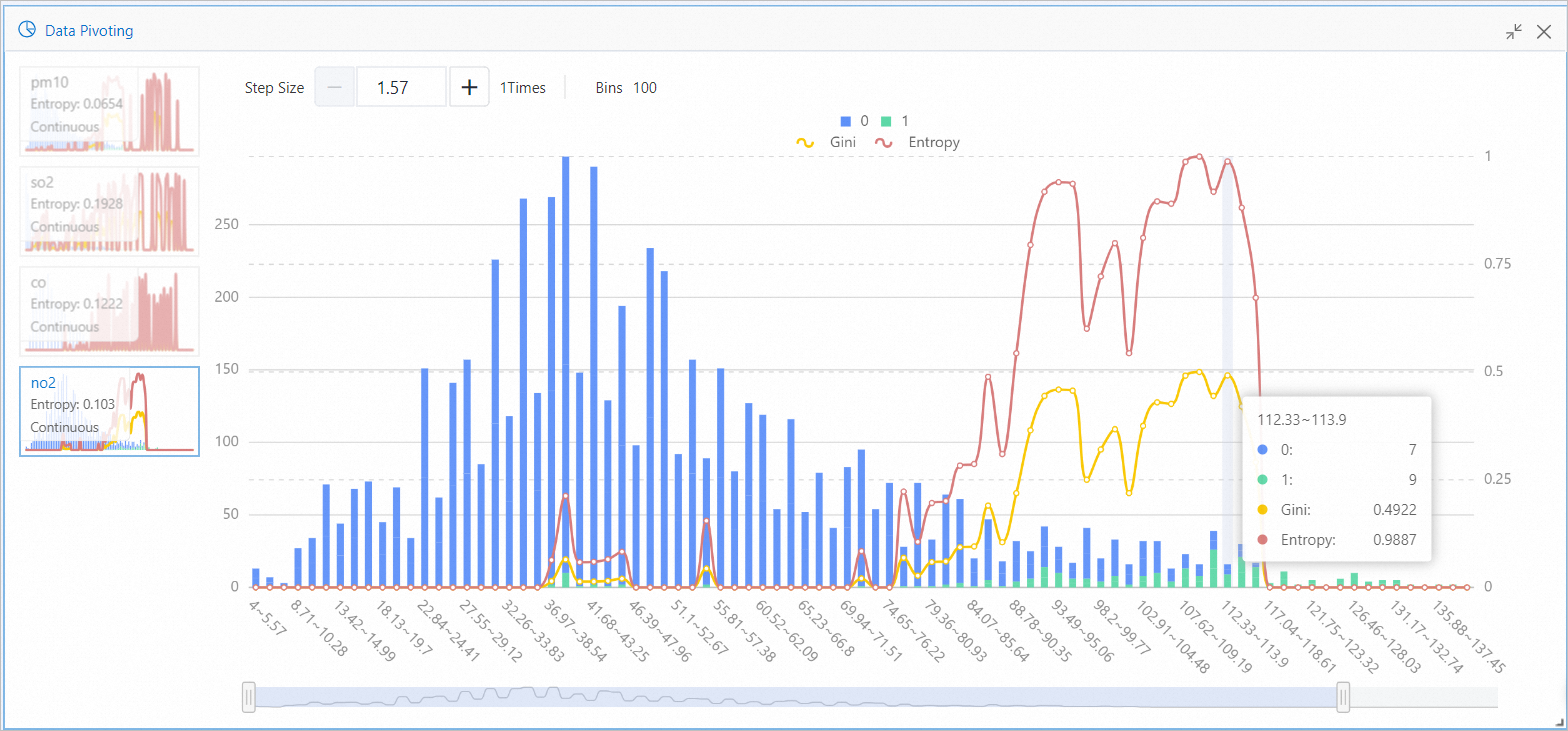
O componente Data View mostra como as faixas de valores de cada poluente afetam o resultado.
Para o recurso no2, por exemplo, a faixa de 112,33 a 113,9 contém 7 instâncias do rótulo alvo 0 e 9 instâncias do rótulo alvo 1, como mostra a figura abaixo. Isso indica maior probabilidade de poluição severa quando o valor de no2 está nessa faixa. As métricas Entropia e Gini medem o ganho de informação, ou seja, o impacto dessa faixa de recurso sobre o valor alvo. Um valor maior sinaliza um impacto mais significativo.
③
Treinamento e previsão do modelo: os componentes Random Forest e Binary Logistic Regression treinam o modelo.
④
Avaliação do modelo.
-
-
Execute o pipeline e visualize os resultados do modelo.
Clique no ícone Executar
 na parte superior da tela.
Após a conclusão do pipeline, clique com o botão direito no componente Binary Classification Evaluation, localizado após o componente Random Forest na tela, e selecione Visual Analysis no menu de atalho.
-
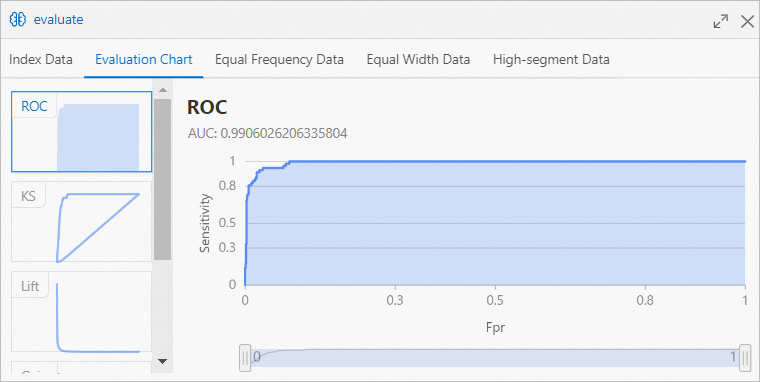
Na caixa de diálogo Binary Classification Evaluation, clique na aba Evaluation Charts para visualizar os resultados da previsão do modelo Random Forest.
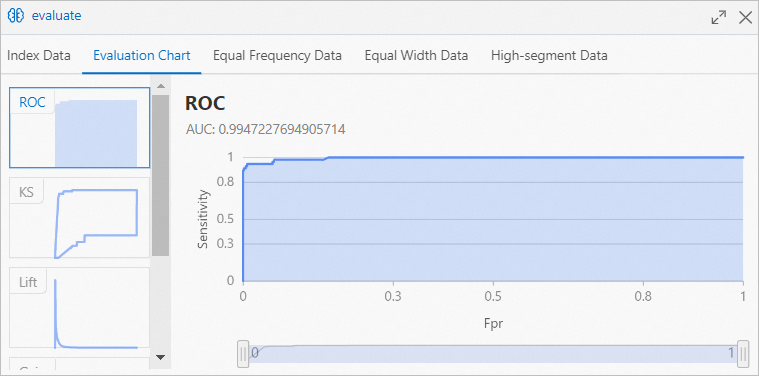 A Área Sob a Curva (AUC) supera 99%, o que demonstra alta precisão nas previsões do modelo Random Forest.
Clique com o botão direito no componente Binary Classification Evaluation, posicionado após o componente Binary Logistic Regression na tela, e selecione Visual Analysis no menu de atalho.
-
Na caixa de diálogo Binary Classification Evaluation, clique na aba Evaluation Charts para verificar os resultados da previsão do modelo Binary Logistic Regression.
 A AUC ultrapassa 98%, indicando elevada precisão preditiva para o modelo Binary Logistic Regression.