Este tópico descreve os códigos de status e os erros comuns retornados ao chamar um service.
Descrições dos códigos de status
|
Código de status |
Descrição |
|
200 |
O service processou a solicitação com sucesso. |
|
400 |
The Request Body format is incorrect ou ocorreu uma exceção no código do processador personalizado. Nota
Se o código do seu processador personalizado lançar uma exceção, o servidor retornará um código de status 400. Para diferenciar isso de outros erros, configure seu processador personalizado para retornar um código de status específico para exceções. |
|
401 |
Falha na autenticação do service. Para obter mais informações, consulte 401 Authorization Failed. |
|
404 |
Service não encontrado. Para obter mais informações, consulte 404 Not Found. |
|
405 |
Método não permitido. Por exemplo, o servidor retorna um erro 405 se você enviar uma solicitação POST para um servidor que suporta apenas solicitações GET. Tente usar um método HTTP diferente. |
|
408 |
A solicitação atingiu o tempo limite. O servidor tem um tempo limite padrão de 5 segundos para cada solicitação. Você pode configurar isso definindo o campo Nota
O tempo total de processamento de uma única solicitação inclui o tempo de computação do Processor, o tempo para receber pacotes de dados da rede e qualquer tempo gasto aguardando em uma fila. |
|
429 |
A solicitação acionou o limite de taxa.
|
|
450 |
|
|
499 |
O cliente fechou a conexão. Quando um cliente fecha ativamente uma conexão, ele não recebe o código de status 499. Em vez disso, o servidor registra quaisquer solicitações não processadas dessa conexão com um código de status 499. Por exemplo, se um cliente tiver um tempo limite HTTP de 30 ms e a latência de processamento no lado do servidor for de 50 ms, o cliente abandonará a solicitação após 30 ms e fechará a conexão. Um código de status 499 aparecerá então no monitoramento do lado do servidor. |
|
500 |
Erro interno do servidor. O servidor encontrou uma condição inesperada que o impediu de atender à solicitação. |
|
501 |
Não implementado. O servidor não suporta a funcionalidade necessária para atender à solicitação. |
|
502 |
Bad Gateway. O servidor, enquanto atuava como gateway ou proxy, recebeu uma resposta inválida de um servidor upstream. |
|
503 |
Service indisponível. Ao acessar um service por meio de um gateway, se todas as instâncias do service de backend não estiverem em estado pronto, o gateway retornará um código de status 503. Para obter mais informações, consulte 503 no healthy upstream. |
|
504 |
Tempo limite do gateway. Para obter mais informações, consulte 504 timeout. |
|
505 |
Versão HTTP não suportada. O servidor não suporta a versão do protocolo HTTP usada na solicitação. |
Códigos de erro de invocação do SDK
Ao usar o SDK oficial do EAS para chamar um service, o SDK pode gerar seus próprios códigos de erro, que podem diferir daqueles retornados pelo servidor. Sempre consulte os códigos de erro nos logs do gateway e do service como a source da verdade.
|
Código de status |
Descrição |
|
512 |
Ao usar o SDK Golang do EAS, se o cliente se desconectar ativamente, o SDK retornará um código de erro 512. Esse tempo limite do lado do cliente corresponde a um código de status 499 no lado do servidor. |
Erros comuns
404 Não encontrado
Um erro 404 geralmente indica um caminho de solicitação inválido, um corpo de solicitação incorreto ou uma API que o service não suporta. Use os cenários a seguir para solucionar problemas com base na mensagem de erro específica recebida.
Tipo de erro 1: {"object":"error","message":"The model `` does not exist.","type":"NotFoundError","param":null,"code":404}
Causa: O parâmetro model no corpo da solicitação está vazio ou é inválido ao chamar o endpoint /v1/chat/completions de um service implantado com vLLM.

Solução: O valor do parâmetro model deve ser um nome de modelo válido. Consulte nomes de modelos válidos usando o endpoint v1/models.
Tipo de erro 2: {"detail":"Not Found"}
Causa: O caminho da solicitação está incompleto ou incorreto. Por exemplo, ao chamar o endpoint de chat de um service LLM, você não anexou o caminho v1/chat/completions à URL base.

Solução: Certifique-se de que o caminho da solicitação de API esteja completo e correto. Para services LLM, consulte LLM service invocation.
Tipo de erro 3: Chamar o endpoint /v1/models do BladeLLM retorna 404: Not Found.
Causa: O service implantado com BladeLLM não suporta o endpoint v1/models.

Solução: Para obter uma lista de APIs suportadas, consulte BladeLLM service invocation parameter configurations.
Tipo de erro 4: A página de depuração online retorna um erro 404 sem outras informações.
Causa: O caminho da solicitação está incorreto. Ao usar a depuração online, a URL base é tipicamente http://123***.cn-hangzhou.pai-eas.aliyuncs.com/predict/service_name. Modificar ou excluir incorretamente a parte do nome do service da URL resulta em um erro 404.

Solução: Ao usar a depuração online, normalmente não é necessário modificar ou excluir a URL padrão. Anexe o caminho específico da API que você precisa chamar.
Tipo de erro 5: Uma chamada de API para o ComfyUI retorna "404 not found page".
400 Bad Request
O formato do corpo da solicitação está incorreto. Verifique cuidadosamente o formato do corpo da solicitação, como a estrutura JSON, nomes de campos e tipos de dados.
401 Falha na autorização
O token de autenticação está ausente, incorreto ou foi usado indevidamente. Verifique o seguinte:
-
Verifique se o token está correto. Na página Overview do service, clique em View Invocation Information na seção Basic Information.
NotaPor padrão, o service gera automaticamente o token de autenticação. Você também pode especificar um token personalizado e atualizá-lo durante as atualizações do service.
-
Verifique se o token está definido corretamente.
Se você usar o comando
curl, adicione o token ao campoAuthorizationno cabeçalho HTTP. Por exemplo:curl -H 'Authorization: NWMyN2UzNjBiZmI2YT***' http:// xxx.cn-shanghai.aliyuncs.com/api/predict/echo.Se você usar um SDK para acessar o service, chame a função
SetToken()correspondente. Para obter mais informações, consulte Instructions for using the Java SDK.
504 timeout
O servidor, atuando como gateway ou proxy, não recebeu uma resposta oportuna de um servidor upstream. Isso geralmente significa que a inferência do modelo está demorando muito. Para resolver esse problema:
No código do seu cliente, aumente o tempo limite da solicitação HTTP.
Para tarefas de longa duração, use o modo EAS Queue Service (Invocação Assíncrona), projetado para lidar com tarefas de inferência em lote ou de longa duração.
450: Solicitação descartada porque a fila está cheia
Quando uma instância de computação do lado do servidor recebe uma solicitação, ela primeiro coloca a solicitação em uma fila. Quando um worker na instância fica disponível, ele recupera dados da fila para processamento. O número padrão de workers é 5, que você pode ajustar usando o campo metadata.rpc.worker_threads no arquivo JSON crie um service. Se o tempo de processamento do worker for muito longo, as solicitações podem se acumular na fila. Quando a fila está cheia, a instância rejeita imediatamente novas solicitações com um código de status 450 para evitar que o enfileiramento excessivo aumente a latência e torne o service indisponível. O comprimento padrão da fila é 64, que você pode ajustar usando o campo metadata.rpc.max_queue_size no arquivo JSON crie um service.
Limitar o comprimento da fila também atua como uma forma de limitação de taxa para evitar que picos de tráfego causem falha em cascata no service.
Soluções:
Se você receber um pequeno número de códigos de status 450, tente novamente a solicitação. Como as instâncias do lado do servidor são independentes, uma nova tentativa pode ser roteada para uma instância menos ocupada, tornando o problema transparente para o cliente. No entanto, não tente novamente indefinidamente, pois isso anularia o propósito da proteção de limitação de taxa.
Se todas as solicitações retornarem um código de status 450, isso pode indicar que o código dentro do processador está travado. Se todos os workers entrarem em deadlock durante o processamento de solicitações e não estiverem mais recuperando dados da fila, será necessário depurar o código do processador para encontrar o bug.
503 no healthy upstream
Você recebe um erro 503 com a mensagem "no healthy upstream" durante a depuração online:
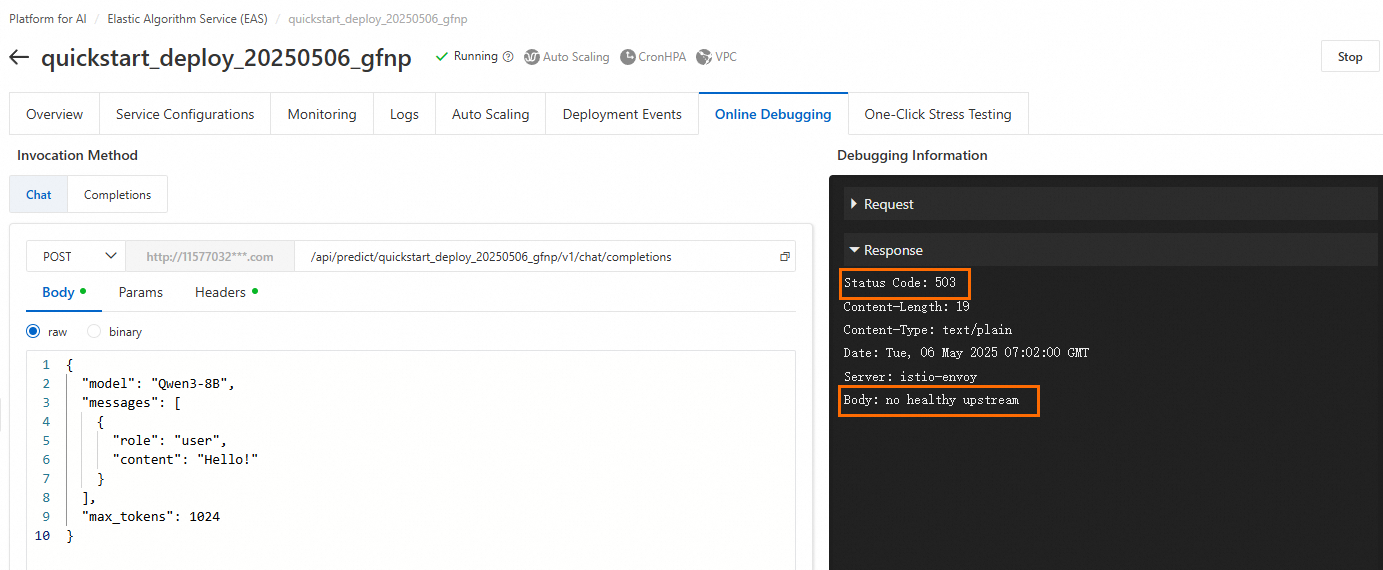
Solucione o problema da seguinte forma:
Verifique o status da instância. Se a instância tiver parado, Reinicie o Service.
-
Se o status do service for Running, a instância pode ter recursos insuficientes, como CPU, memória ou memória GPU, o que leva à falta de espaço de buffer.
Se você estiver usando recursos públicos, tente fazer a chamada novamente fora dos horários de pico ou mude para uma especificação de recurso ou região diferente.
Se você estiver usando um recurso dedicado (EAS Resource Group), certifique-se de que o grupo de recursos reservou CPU, memória e memória GPU suficientes para a instância. Recomendamos deixar pelo menos 20% dos recursos livres como buffer.
Outro cenário comum é quando o status do service é Running e todas as instâncias estão Ready após a implantação. No entanto, uma solicitação aciona um bug no código, o que faz com que a instância do service de backend falhe e pare de responder. Nessa situação, o gateway retorna um código de status 503 para o cliente. Para identificar e corrigir o bug, use os logs.
Erro: Unexpected token 12606 while expecting start token 200006
Ao usar o vllm para implantar o gpt-oss, as chamadas de service podem retornar o seguinte erro:

Solução: Tente implantar com aceleração SGLang.
Erro de invocação curl: no URL specified
Você recebe um erro no URL specified após enviar uma solicitação com o seguinte comando:
curl -X http://17****.cn-hangzhou.pai-eas.aliyuncs.com/api/predict/service_name/**path** \
-H "Content-Type: application/json" \
-H "Authorization: **********==" \
-d '{"***":"****"}'Causa: O comando curl usa a flag -X, mas falta o método, como POST.
A invocação retorna codificação ASCII
Modifique seu código da seguinte forma:
from flask import Flask, Response

@app.route('/hello', methods=['POST'])
def get_advice():
    result = "result"
    return Response(result, mimetype='text/plain', charset='utf-8')
Como resolver "[WARN] connection is closed: End of file" ou "Write a Invalid stream: End of file" nos logs do service?
Este log de aviso indica que o cliente ou o servidor fechou a conexão, e o servidor estava tentando gravar uma resposta de volta nessa conexão fechada. Uma conexão pode ser fechada de duas maneiras:
Tempo limite do lado do servidor: No modo Processor, o tempo limite padrão do lado do servidor é de 5 segundos. Você pode alterar isso usando o parâmetro
metadata.rpc.keepalivedo service. Quando o tempo limite é atingido, o servidor fecha a conexão e registra um código de status 408 em seu monitoramento.Tempo limite do lado do cliente: As configurações do seu código de chamada determinam o tempo limite do lado do cliente. Se o cliente não receber uma resposta HTTP dentro do período de tempo limite configurado, ele fechará ativamente a conexão. O servidor então registra um código de status 499 em seu monitoramento.
upstream connect error or disconnect/reset before headers. reset reason: connection termination
Problemas como tempo limite de conexão persistente ou cargas de instância desequilibradas geralmente causam esse erro. Se o tempo de processamento do lado do servidor exceder o tempo limite HTTP configurado no cliente, o cliente abandonará a solicitação e fechará ativamente a conexão. Um código de status 499 aparecerá então no monitoramento do lado do servidor. Você pode verificar as métricas de monitoramento para confirmação adicional. Para tarefas de inferência demoradas, deploy an asynchronous inference service.
Como resolver falhas na depuração online para services implantados com um processador Tensorflow/Pytorch?
Por motivos de desempenho, os Processors TensorFlow/PyTorch usam um formato protobuf não plaintext para o corpo da solicitação. A depuração online atualmente suporta apenas entrada de texto plaintext. Portanto, você não pode depurar services implantados com esses processadores diretamente no console. Use os SDKs EAS fornecidos para chamar o service. Para obter informações sobre SDKs em diferentes linguagens, consulte Service Invocation SDKs.