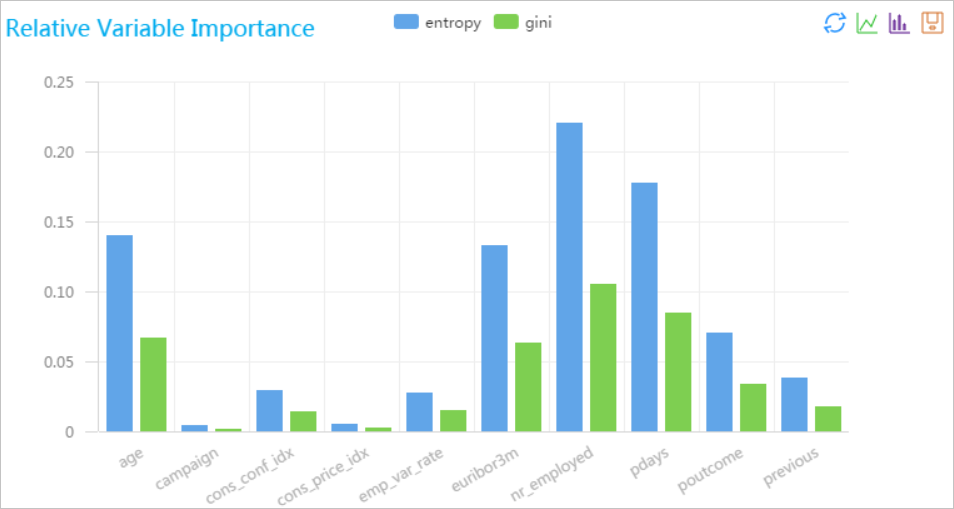
A Avaliação de Importância de Features do Random Forest é um método para analisar a contribuição de cada feature nos resultados da previsão em um modelo de random forest. Esse processo determina a importância das features calculando a redução média da impureza para cada feature em todas as árvores de decisão ou utilizando a importância por permutação. Dessa forma, é possível identificar quais features têm maior impacto no desempenho do modelo.
Configuração do componente
Método 1: Interface gráfica
No Machine Learning Designer, adicione o componente Random Forest Feature Importance Evaluation ao seu pipeline e configure seus parâmetros no painel à direita:
|
Aba |
Parâmetro |
Descrição |
|
Field Settings |
Feature Columns |
Colunas de features a serem utilizadas da tabela de entrada. Este parâmetro é opcional. Por padrão, todas as colunas exceto a coluna de rótulo são selecionadas. |
|
Target Column |
Obrigatório. |
|
|
Parameter Settings |
Parallel Computing Cores |
Número de núcleos para computação paralela. |
|
Memory Size per Core |
Tamanho da memória por núcleo, em MB. |
Método 2: Comando PAI
Configure o componente Random Forest Feature Importance Evaluation executando um comando PAI no componente SQL Script. Para mais informações, consulte Cenário 4: Executar comandos PAI no componente SQL Script.
pai -name feature_importance -project algo_public
    -DinputTableName=pai_dense_10_10
    -DmodelName=xlab_m_random_forests_1_20318_v0
    -DoutputTableName=erkang_test_dev.pai_temp_2252_20319_1
    -DlabelColName=y
    -DfeatureColNames="pdays,previous,emp_var_rate,cons_price_idx,cons_conf_idx,euribor3m,nr_employed,age,campaign,poutcome"
-Dlifecycle=28 ;|
Parâmetro |
Obrigatório |
Padrão |
Descrição |
|
inputTableName |
Sim |
Nenhum |
Nome da tabela de entrada. |
|
outputTableName |
Sim |
Nenhum |
Nome da tabela de saída. |
|
labelColName |
Sim |
Nenhum |
Nome da coluna de rótulo na tabela de entrada. |
|
modelName |
Sim |
Nenhum |
Nome do modelo de entrada. |
|
featureColNames |
Não |
Todas as colunas exceto a coluna de rótulo |
Colunas de features a serem utilizadas da tabela de entrada. |
|
inputTablePartitions |
Não |
Tabela inteira |
Partições a serem utilizadas da tabela de entrada. |
|
lifecycle |
Não |
Não especificado |
Ciclo de vida da tabela de saída. |
|
coreNum |
Não |
Calculado automaticamente |
Número de núcleos. |
|
memSizePerCore |
Não |
Calculado automaticamente |
Tamanho da memória por núcleo, em MB. |
Exemplo
-
Gere dados de treinamento usando uma instrução SQL.
Este exemplo cria uma tabela chamada
pai_dense_10_10selecionando colunas específicas e as primeiras 10 linhas da tabelabank_data. Crie a tabela conforme suas necessidades reais de negócio.drop table if exists pai_dense_10_10; create table pai_dense_10_10 as select age,campaign,pdays, previous, poutcome, emp_var_rate, cons_price_idx, cons_conf_idx, euribor3m, nr_employed, y from bank_data limit 10; -
Construa o pipeline. Para mais informações, consulte Pipelines personalizados.
Defina
ycomo a coluna de rótulo e todas as outras colunas como colunas de features. No parâmetro Columns Forced to Convert, selecioneageecampaignpara processá-las como features enumeradas. Mantenha os valores padrão para todos os outros parâmetros.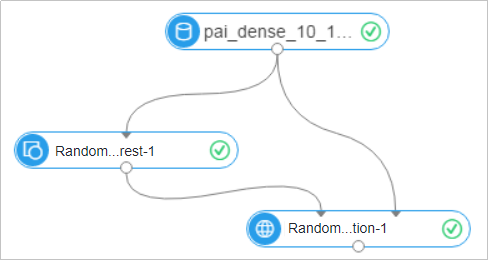
-
Execute o pipeline e visualize os resultados. A saída abaixo mostra os valores de importância das features gerados pelo componente Random Forest Feature Importance Evaluation.
colname                gini                        entropy
age                    0.06625000000000003          0.13978726292803723
campaign               0.00175000000000003          0.00434851554559677
cons_conf_idx          0.01399999999999999          0.0290840949701885
cons_price_idx         0.002                        0.00498044991346125
emp_var_rate           0.01470000000000003          0.0267863068026093
euribor3m              0.06300000000000003          0.132193634884603
nr_employed            0.10499999999999998          0.220322724807673
pdays                  0.0845                       0.177503292343975
poutcome               0.03360000000000001          0.070503271938455
previous               0.01770000000000004          0.038103810058015
Após a conclusão da execução, clique em com o botão direito no componente Random Forest Feature Importance Evaluation e selecione View Analytics Report.