O PerfTracker é uma ferramenta de análise e diagnóstico de desempenho online para treinamento de modelos em larga escala. Quando um job de treinamento apresenta problemas de desempenho, o PerfTracker coleta registros de execução de kernels CUDA e funções Python, além de dados de monitoramento de hardware de cada worker, e gera um relatório analítico que identifica nós lentos, aponta funções de gargalo e detecta problemas de travamento.
Limitações
O PerfTracker oferece suporte apenas a jobs de treinamento que utilizam o framework PyTorch.
Recursos
Principais recursos
Coleta de dados online: Coleta registros de execução para todos os tipos de função (como kernels CUDA e funções Python) de cada worker, juntamente com dados de monitoramento de hardware para GPUs, NVLink, PCIe e DRAM com precisão de 100 microssegundos.
Análise de desempenho no nível da função: Gera relatórios de desempenho por função e diagnostica automaticamente as causas raiz da degradação de desempenho, incluindo nós lentos e funções com tempos de execução anormais. Os relatórios também permitem análise manual aprofundada para orientar a otimização.
Destaques da solução
Profiling online granular: Transfere a coleta de dados da reprodução offline para captura granular em tempo real, melhorando a atualidade e a precisão.
Análise multinó eficiente: Automatiza a análise de desempenho codificando conhecimento especializado em algoritmos de diagnóstico, permitindo identificação e localização eficiente de problemas.
Como funciona
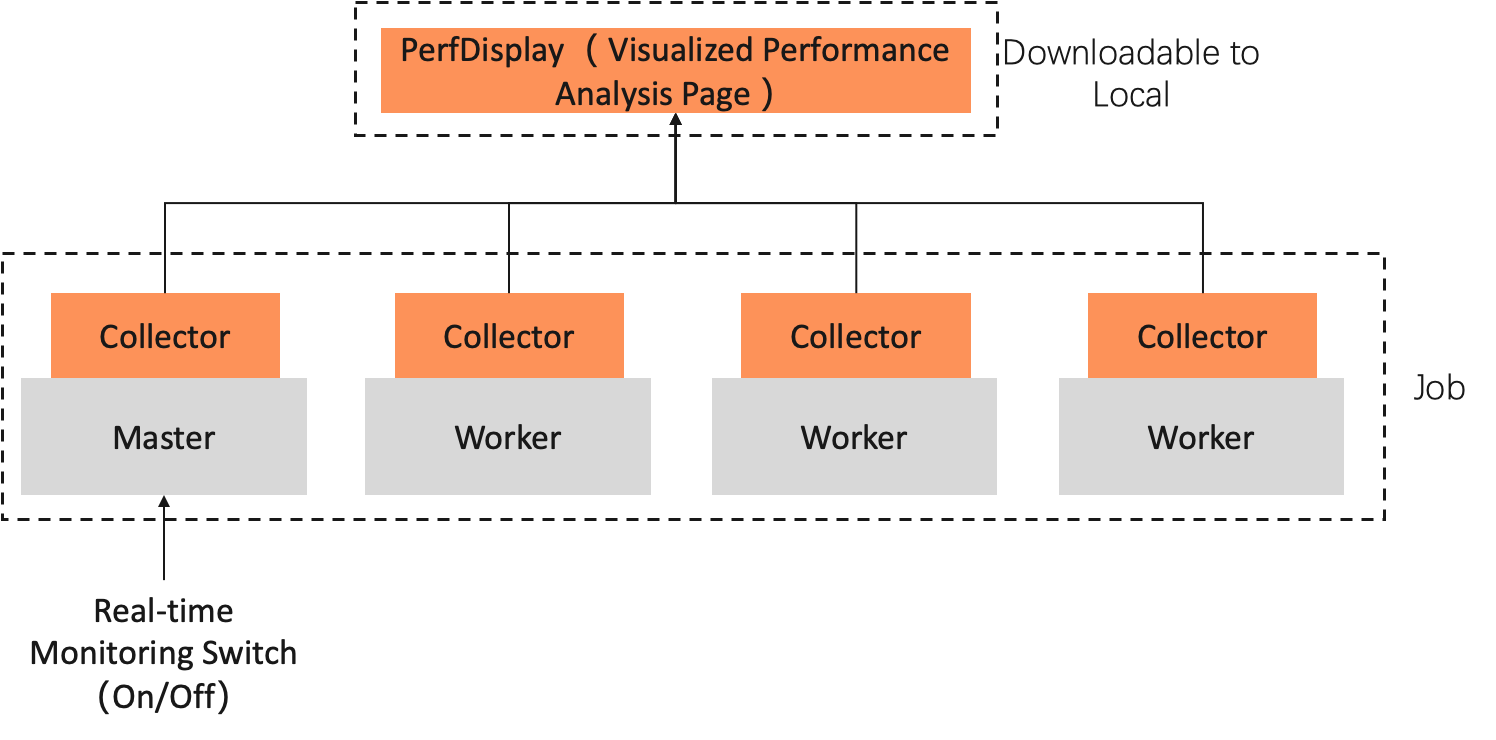
O PerfTracker possui dois componentes: Collector e PerfDisplay. O Collector executa dentro do contêiner do job, independentemente do processo de treinamento. O PerfDisplay fornece uma interface local baseada na web para visualização dos relatórios de análise.
-
PerfTracker Collector: Realiza monitoramento online full-stack de alta precisão usando a API Torch profiler e nsys para coletar dados brutos de monitoramento, incluindo:
Registros de execução de todas as funções de runtime, incluindo funções de kernel CUDA (kernels de computação e comunicação), funções de kernel de lançamento de GPU, operações de memória da GPU e funções Python, fornecendo um registro 100% preciso do comportamento do programa para análise de desempenho no nível do código.
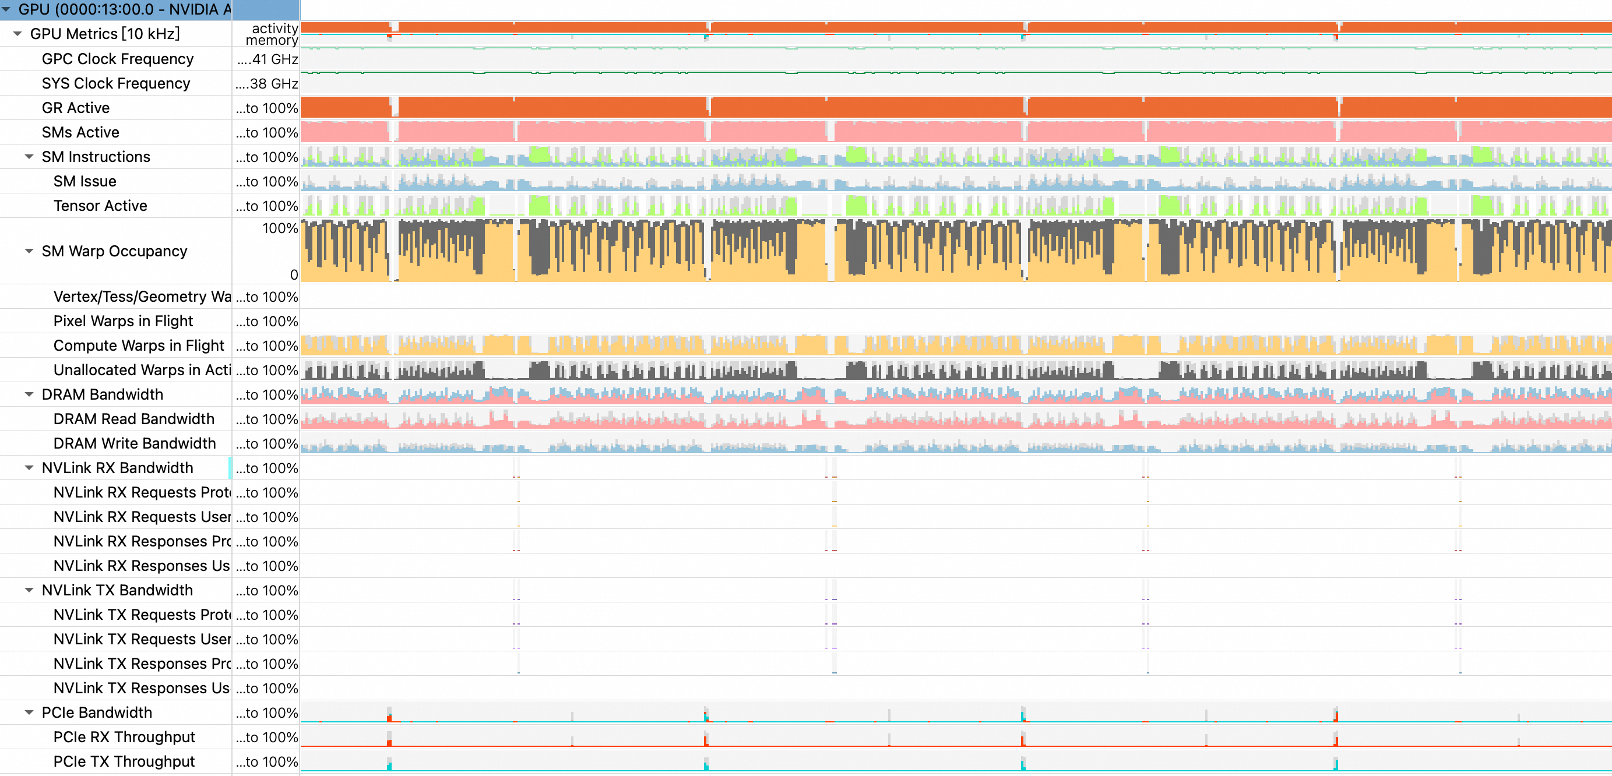
Dados de monitoramento para várias métricas de hardware, como GPUs, NVLink, PCIe e DRAM, com precisão de 100 microssegundos.
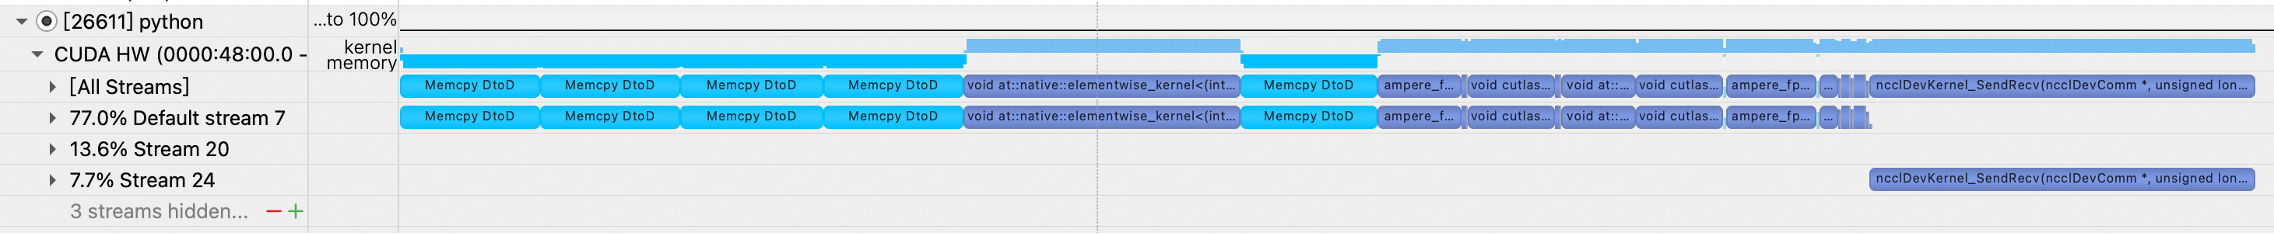
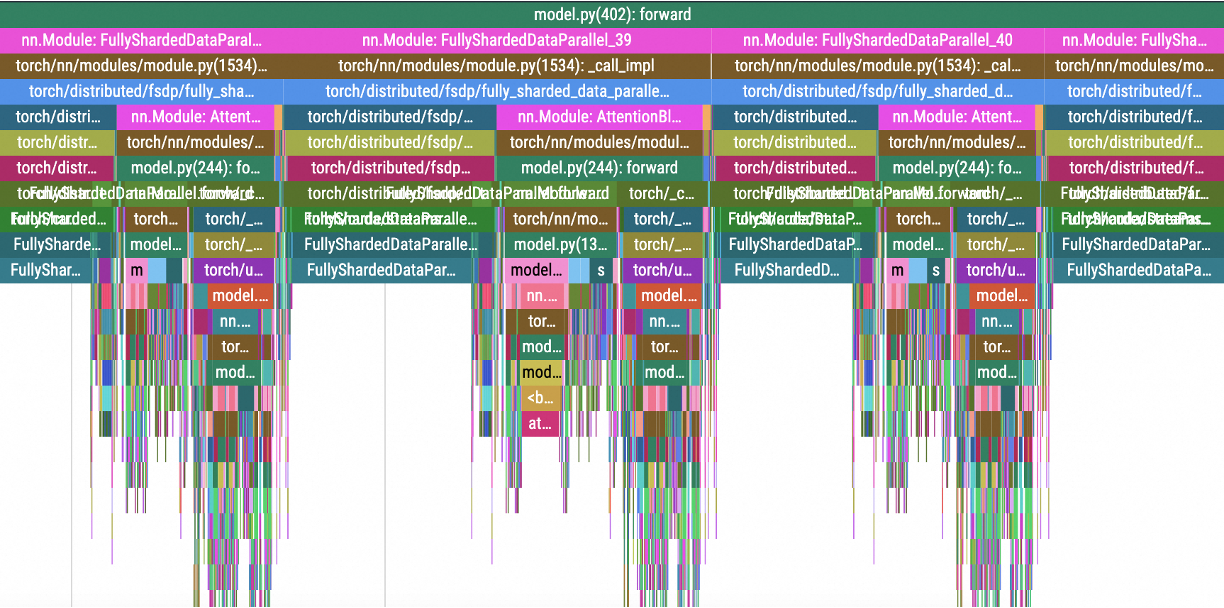
As figuras a seguir mostram exemplos dos dados coletados:
-
Funções de kernel CUDA e operações de memória da GPU
-
Funções Python e kernels de lançamento de GPU
-
Dados de monitoramento de hardware
PerfDisplay: Agrega e analisa os dados coletados para gerar relatórios e visualizações de análise de desempenho.
Procedimento
Prepare seu código de treinamento
-
Modifique seu script de treinamento para importar o módulo PerfTracker e marcar cada etapa de treinamento.
-
Importe o módulo PerfTracker no início do seu script de treinamento. O código a seguir fornece um exemplo:
try: from c4d_perftracker_collector.PerfTracker import PerfTracker my_tracer = PerfTracker() except: my_tracer = None -
Marque as etapas no seu código de treinamento.
Para usar o PerfTracker, marque as etapas no seu código de treinamento. Cada vez que
tracer.step()é executado, o PerfTracker registra o evento, permitindo que o backend controle quantas iterações são perfiladas.while iteration < args.train_iters: ... # Training code if my_tracer is not None: my_tracer.step() # Mark a step
O script
training.pya seguir é um exemplo simples que inclui a instrução de importação e o marcador de etapa:import torch import time import torch.distributed as dist import argparse try: from c4d_perftracker_collector.PerfTracker import PerfTracker my_tracer = PerfTracker() except: my_tracer = None dist.init_process_group("nccl") torch.cuda.set_device(dist.get_rank()) # Check if CUDA is available. if torch.cuda.is_available(): print("CUDA is available!") device = torch.device('cuda') # Use the default CUDA device. else: print("CUDA is not available.") device = torch.device('cpu') # Use the CPU if CUDA is not available. def matmul(): matrix_a = torch.randn(1000, 1000) matrix_b = torch.randn(1000, 1000) # Move the matrices to the CUDA device. matrix_a = matrix_a.to(device) matrix_b = matrix_b.to(device) # Perform matrix multiplication. result = torch.matmul(matrix_a, matrix_b) result_cpu = result.to('cpu') print(result_cpu) del matrix_a, matrix_b, result torch.cuda.empty_cache() for i in range(1000): matmul() time.sleep(dist.get_rank()) print("Epoch:", i) if my_tracer is not None: my_tracer.step() dist.barrier() -
Faça upload do seu script de treinamento (por exemplo, training.py) para um diretório de armazenamento, como um Object Storage Service (OSS) bucket.
Crie um job de treinamento
-
Ao criar um job de treinamento, baixe e instale o PerfTracker no comando de inicialização. As outras configurações são iguais às de um job típico. Após concluir a configuração, clique em OK para criar o job. Veja um exemplo abaixo:
Parâmetro
Descrição
Environment Information
Image Configuration
Selecione uma imagem com PyTorch 2.0 ou posterior. Este exemplo usa
easyanimate:1.1.5-pytorch2.2.0-gpu-py310-cu118-ubuntu22.04.Storage Mount
Clique em OSS, selecione o diretório OSS onde seu script de treinamento está localizado e defina o Mount Path. Este exemplo usa
/mnt/data/.Start Command
# Download the PerfTracker installation package.
wget -t 5 -w 2 -P /mnt/data https://network-research-lingjun-open-oss.oss-cn-hangzhou.aliyuncs.com/files/c4d_perftracker_collector-1.4.0-py3-none-any.whl
# Install PerfTracker.
pip3 install /mnt/data/c4d_perftracker_collector-1.4.0-py3-none-any.whl
# Run the training script (for example, training.py).
CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7 torchrun --nproc_per_node=4 /mnt/data/training.py
Substitua
/mnt/data/pelo caminho de montagem do seu conjunto de dados.NotaPara jobs em larga escala, downloads de alta concorrência na inicialização podem ser lentos. Recomendamos baixar o pacote PerfTracker para seu diretório de armazenamento usando a linha de comando antes de iniciar o job.
Resource Information
Framework
Selecione PyTorch.
Task Resources
Selecione uma especificação de recurso. Este exemplo usa
ecs.gn6e-c12g1.12xlarge. Enquanto o job estiver em execução, clique no nome do job alvo. Na aba Overview, localize a instância mestre na seção Instance e clique em Access container na coluna Actions.
-
Execute um dos seguintes comandos para salvar os resultados da análise. Use esses resultados para diagnosticar a causa dos problemas de desempenho.
-
Opção 1: Salvar apenas os resultados da análise, sem o trace bruto.
c4d_perftracker --trigger-on --auto-analyze --output-dir /mnt/data/ -
Opção 2: Se houver armazenamento suficiente, como no Cloud Parallel File Storage (CPFS) ou Object Storage Service (OSS), recomendamos usar o seguinte comando para salvar tanto os resultados da análise quanto o trace bruto. Isso permite confirmação manual após o diagnóstico inicial. Observe que o trace de um único worker pode ter várias centenas de megabytes, então você pode excluí-lo manualmente após o diagnóstico.
c4d_perftracker --trigger-on --auto-analyze --output-dir /mnt/data/ --save-raw-trace allNeste comando,
/mnt/data/especifica o diretório onde o trace bruto é salvo. Defina este valor como o caminho de montagem do seu conjunto de dados para salvar o trace bruto nele.
Após salvar os resultados da análise, visualize o relatório no PerfDisplay (consulte a próxima seção). O PerfTracker também fornece parâmetros adicionais (consulte o Apêndice) para ajudar a identificar a causa raiz dos problemas de desempenho.
-
Visualize os resultados da análise
Consulte Analysis Mode para gerar e salvar os resultados da análise. Após a execução bem-sucedida do comando, o sistema gera uma pasta
<timestamp>/PerfDisplayno diretório. Quando a análise for concluída, as pastas PerfDisplay/ e raw_trace/ serão geradas na lista de arquivos do Bucket OSS.-
Copie a pasta PerfDisplay para o diretório de montagem
/mnt/datada source de dados. Consulte the ossutil 2.0 command-line tool para baixar a pastaPerfDisplaypara sua máquina local. (Você pode compactar a pasta antes de baixá-la.)tar -cvf trace.tar PerfDisplay/ mv trace.tar /mnt/data Na sua máquina local, acesse a pasta
PerfDisplaye executesudo python3 app.py(talvez não seja necessário usarsudono Linux). Em seguida, abra http://127.0.0.1:5000/ em um navegador web para visualizar o relatório de desempenho.
Os relatórios do PerfTracker indicam funções que afetam o desempenho do job e sinalizam anomalias. As funções são organizadas nas seguintes categorias, e a interface web oferece opções interativas com instruções detalhadas.
Funções de computação da GPU
GPU Compute:
[2025-03-04 06:04:00,046 PerfTracker] (compute_functions.py 131) INFO: {
    "min/median/max GPU utilization (in [0,1])": [
        0.27586059769318555,
        0.28605496203987174,
        0.2945494558115959
    ],
    "workers with abnormal GPU utilization": {},
    "major_kernel_executions": {
        "void multi_tensor_apply_kernel<TensorListMetadata<4>, AdamFunctor<float, float, int>, float, float, float, float, float, float, adamMode_t, float>(long, int volatile*, TensorListMetadata<4>, AdamFunctor<float, float, int>, float, float, float, float, float, float, adamMode_t, float)320_1_1|512_1_1": {
            "median cost per execution (ms)": 403.7,
            "bottleneck ratio (in [0,1])": 0.01608086667957405
        },
        "sm80_xmma_gemm_f16f16_f16f32_f32_nn_n_tilesize160x128x32_stage4_warpsize2x2x1_tensor16x8x16_kernel7_16_1|128_1_1": {
            "median cost per execution (ms)": 130.0,
            "bottleneck ratio (in [0,1])": 0.015779752711771233
        },
        "ampere_fp16_s16816gemm_fp16_128x128_ldg8_f2f_stages_32x5_nt16_32_1|128_1_1": {
            "median cost per execution (ms)": 132.60000000000002,
            "bottleneck ratio (in [0,1])": 0.013880912782219888
        },
        "void (anonymous namespace)::indexing_backward_kernel<c10::Half, 4>(long const*, long const*, c10::Half const*, c10::Half*, long, long, long, long, bool)256_16_1|32_4_1": {
            "median cost per execution (ms)": 1202.25,
            "bottleneck ratio (in [0,1])": 0.012148757934008617
        },
        "ampere_fp16_s16816gemm_fp16_128x128_ldg8_f2f_stages_32x5_nt16_24_1|128_1_1": {
            "median cost per execution (ms)": 105.6,
            "bottleneck ratio (in [0,1])": 0.005656117080836238
        }
    },
    "workers with potential GPU issues": [],
    "detailed report": {}
}
Como interpretar o relatório:
"min/median/max GPU utilization (in [0,1])": Mostra que, em todos os workers, a utilização máxima da GPU foi de 29,4%, a mínima foi de 27,5% e a mediana foi de 28,6%."workers with abnormal GPU utilization": Se estiver vazio, nenhum worker apresenta utilização de GPU significativamente discrepante. Caso contrário, lista os IDs dos workers discrepantes e suas respectivas utilizações de GPU."major_kernel_executions": Lista as execuções de kernel da GPU que consumiram mais tempo, incluindo o custo mediano por execução e a taxa de gargalo (percentual do desempenho ponta a ponta)."workers with potential GPU issues": Lista os IDs dos workers com execução de kernel da GPU mais lenta. Se estiver vazio, todos os workers estão apresentando desempenho normal."detailed report": Aparece quando"workers with potential GPU issues"não está vazio. Especifica qual worker executou qual função de kernel mais lentamente que o normal e por quanto.
Operações de memória da GPU
GPU memory operations:
[2025-03-04 06:04:00,048 PerfTracker] (gpu_mem.py 37) INFO: {
    "Memcpy DtoD (Device -> Device)": {
        "avg bottleneck ratio (in [0,1])": 0.010486858246092,
        "abnormal_workers": {
            "job_x08j11173.cloud.sqa.na131_2_122482.json": 0.010614755325049817,
            "job_x08j11173.cloud.sqa.na131_8_122483.json": 0.0105935370201344,
            "job_x08j11173.cloud.sqa.na131_1_122484.json": 0.010571838319204434,
            "job_x08j11173.cloud.sqa.na131_0_122485.json": 0.010551186610995748,
            "job_x08j11173.cloud.sqa.na131_2_122487.json": 0.010408514784026183,
            "job_x08j11173.cloud.sqa.na131_5_122489.json": 0.010394903160689894,
            "job_x08j11173.cloud.sqa.na131_8_122486.json": 0.010387693451926115,
            "job_x08j11173.cloud.sqa.na131_9_122488.json": 0.010372437296709398
        }
    }
}
Como interpretar o relatório:
"avg bottleneck ratio (in [0,1])": Indica que o tempo médio gasto em operações Memcpy DtoD durante o período de monitoramento foi de 1,048% do tempo ponta a ponta."abnormal_workers": Oito workers apresentaram tempos de execução anormais para Memcpy DtoD. Para operações de memória da GPU, uma taxa de gargalo maior que 0,01 (1%) é considerada anormal.
Comunicação coletiva
Communication:
{
    "nvlink ring send": {
        "ncclDevKernel_AllReduce_Sum_f16_RING_LL(ncclDevComm*, unsigned long, ncclWork*)": {
            "example_of_normal_worker": {
                "worker": "job_x08j11173.cloud.sqa.na131_0_66930.json",
                "different from other workers": 0,
                "features": {
                    "bottleneck ratio (in [0,1])": 0.2743985289797289,
                    "avg throughput (%)": 73.75921390374332,
                    "throughput std (%)": 11.384679144385027
                }
            },
            "abnormal_workers": []
        }
    },
    "nvlink ring recv": {
        "ncclDevKernel_AllReduce_Sum_f16_RING_LL(ncclDevComm*, unsigned long, ncclWork*)": {
            "example_of_normal_worker": {
                "worker": "job_x08j11173.cloud.sqa.na131_3_66933.json",
                "different from other workers": 2,
                "features": {
                    "bottleneck ratio (in [0,1])": 0.27346865947352955,
                    "avg throughput (%)": 72.70337362637363,
                    "throughput std (%)": 12.658093406593407
                }
            },
            "abnormal_workers": []
        }
    },
    "pcie sendrecv send": {
        "ncclDevKernel_SendRecv(ncclDevComm*, unsigned long, ncclWork*)": {
            "example_of_normal_worker": {
                "worker": "job_x08j11173.cloud.sqa.na131_0_66930.json",
                "different from other workers": 3,
                "features": {
                    "bottleneck ratio (in [0,1])": 0.07248997985478658,
                    "avg throughput (%)": 46.667,
                    "throughput std (%)": 14.636000000000001
                }
            },
            "abnormal_workers": []
        }
    },
    "pcie sendrecv recv": {
        "ncclDevKernel_SendRecv(ncclDevComm*, unsigned long, ncclWork*)": {
            "example_of_normal_worker": {
                "worker": "job_x08j11173.cloud.sqa.na131_7_66936.json",
                "different from other workers": 1,
                "features": {
                    "bottleneck ratio (in [0,1])": 0.0643436909425455,
                    "avg throughput (%)": 54.833333333333336,
                    "throughput std (%)": 14.166666666666666
                }
            },
            "abnormal_workers": []
        }
    },
    "pcie ring send": {
        "ncclDevKernel_AllReduce_Sum_f16_RING_LL(ncclDevComm*, unsigned long, ncclWork*)": {
            "example_of_normal_worker": {
                "worker": "job_x08j11173.cloud.sqa.na131_0_66930.json",
                "different from other workers": 0,
                "features": {
                    "bottleneck ratio (in [0,1])": 0.2743985289797289,
                    "avg throughput (%)": 41.36698734177215,
                    "throughput std (%)": 14.653768987341774
                }
            },
            "abnormal_workers": []
        }
    },
    "pcie ring recv": {
        "ncclDevKernel_AllReduce_Sum_f16_RING_LL(ncclDevComm*, unsigned long, ncclWork*)": {
            "example_of_normal_worker": {
                "worker": "job_x08j11173.cloud.sqa.na131_0_66930.json",
                "different from other workers": 0,
                "features": {
                    "bottleneck ratio (in [0,1])": 0.2743985289797289,
                    "avg throughput (%)": 41.5311475409836,
                    "throughput std (%)": 15.282721311475411
                }
            },
            "abnormal_workers": []
        }
    }
}
Este relatório categoriza as funções de comunicação coletiva por tipo e fornece análise de desempenho para cada uma.
"example_of_normal_worker"mostra os parâmetros de desempenho normais para a função, incluindo sua taxa de gargalo (parcela do tempo ponta a ponta excluindo sobreposição com computação), throughput médio e desvio padrão do throughput."abnormal_workers", se não estiver vazio, lista workers com desempenho anormal para aquela função de comunicação e suas métricas.
Runtime CUDA
CUDA Runtime:
[2025-03-04 06:04:00,047 PerfTracker] (cuda_runtimes.py 43) INFO: {
    "cudaLaunchKernel": {
        "avg bottleneck ratio (in [0,1])": 0.039727736621541394,
        "avg execution time / monitoring duration (in [0,1])": 0.06956947111288565,
        "abnormal_workers": {
            "job_x08j11173.cloud.sqa.na131_5_122489.json": 0.05342638907019616,
            "job_x08j11173.cloud.sqa.na131_8_122483.json": 0.05125160206973098,
            "job_x08j11173.cloud.sqa.na131_2_122487.json": 0.04770049253555521,
            "job_x08j11173.cloud.sqa.na131_8_122486.json": 0.04358845044879828,
            "job_x08j11173.cloud.sqa.na131_0_122485.json": 0.042635952262081556,
            "job_x08j11173.cloud.sqa.na131_9_122488.json": 0.0354174573296689,
            "job_x08j11173.cloud.sqa.na131_1_122484.json": 0.023585242093250733,
            "job_x08j11173.cloud.sqa.na131_2_122482.json": 0.02021630716304934
        }
    }
}
Como interpretar o relatório:
"avg bottleneck ratio (in [0,1])": Indica que o tempo médio gasto em cudaLaunchKernel durante o período de monitoramento foi de 3,97% (excluindo sobreposição com computação)."avg execution time / monitoring duration (in [0,1])": Mostra que o tempo médio gasto em cudaLaunchKernel foi de 6,95% da duração total do monitoramento (incluindo sobreposição com computação)."abnormal_workers": Oito workers apresentaram tempos de execução anormais para cudaLaunchKernel. Para funções de runtime CUDA, uma taxa de gargalo maior que 0,01 (1%) é considerada anormal.
Funções Python
Python functions:
[2025-03-04 06:04:00,048 PerfTracker] (python_functions.py 43) INFO: {
    "pretrain_gpt.py: <module>|megatron/training.py: pretrain|megatron/training.py: train|megatron/training.py: train_step|megatron/core/pipeline_parallel/schedules.py: forward_backward_pipelining_without_interleaving|megatron/core/pipeline_parallel/schedules.py: backward_step|megatron/core/pipeline_parallel/schedules.py: custom_backward|<built-in method run_backward of torch._C._EngineBase object at 0x>": {
        "job_x08j11173.cloud.sqa.na131_2_122487.json": 0.16970858578301054,
        "job_x08j11173.cloud.sqa.na131_5_122489.json": 0.16821543761561655,
        "job_x08j11173.cloud.sqa.na131_0_122485.json": 0.16787961852913025,
        "job_x08j11173.cloud.sqa.na131_8_122483.json": 0.16769273336153187,
        "job_x08j11173.cloud.sqa.na131_8_122486.json": 0.14482595694389258,
        "job_x08j11173.cloud.sqa.na131_9_122488.json": 0.10359829140378449,
        "job_x08j11173.cloud.sqa.na131_1_122484.json": 0.06543764774209325,
        "job_x08j11173.cloud.sqa.na131_2_122482.json": 0.06217541348063737
    },
    "pretrain_gpt.py: <module>|megatron/training.py: pretrain|megatron/training.py: train|megatron/training.py: train_step|megatron/core/pipeline_parallel/schedules.py: forward_backward_pipelining_without_interleaving|megatron/core/pipeline_parallel/schedules.py: forward_step|pretrain_gpt.py: forward_step|nn.Module: DistributedDataParallel_0|torch/nn/modules/module.py: _call_impl|megatron/core/distributed/distributed_data_parallel.py: forward|nn.Module: Float16Module_0|torch/nn/modules/module.py: _call_impl|megatron/model/module.py: forward|nn.Module: GPTModel_0|torch/nn/modules/module.py: _call_impl|megatron/model/gpt_model.py: forward|nn.Module: TransformerLanguageModel_0|torch/nn/modules/module.py: _call_impl|megatron/model/language_model.py: forward|nn.Module: ParallelTransformer_0|torch/nn/modules/module.py: _call_impl|megatron/model/transformer.py: forward": {
        "job_x08j11173.cloud.sqa.na131_9_122488.json": 0.02471835416438489,
        "job_x08j11173.cloud.sqa.na131_0_122485.json": 0.02022024568555683,
        "job_x08j11173.cloud.sqa.na131_2_122482.json": 0.015394834126935101,
        "job_x08j11173.cloud.sqa.na131_2_122487.json": 0.011625367332189284
    },
    "pretrain_gpt.py: <module>|megatron/training.py: pretrain|megatron/training.py: train|megatron/training.py: train_step": {
        "job_x08j11173.cloud.sqa.na131_0_122485.json": 0.012272193902698852
    },
    "autograd::engine::evaluate_function: LinearWithGradAccumulationAndAsyncCommunicationBackward|LinearWithGradAccumulationAndAsyncCommunicationBackward|torch/autograd/function.py: apply|torch/cuda/amp/autocast_mode.py: decorate_bwd|megatron/core/tensor_parallel/layers.py: backward|<built-in method matmul of Tensor object at 0x>|aten::matmul|aten::mm": {
        "job_x08j11173.cloud.sqa.na131_2_122487.json": 0.014066713574814782,
        "job_x08j11173.cloud.sqa.na131_0_122485.json": 0.013168949365116213,
        "job_x08j11173.cloud.sqa.na131_8_122483.json": 0.013000378454189552,
        "job_x08j11173.cloud.sqa.na131_5_122489.json": 0.012500119397472594,
        "job_x08j11173.cloud.sqa.na131_8_122486.json": 0.012470581043494208
    },
    "autograd::engine::evaluate_function: FastLayerNormFNBackward|FastLayerNormFNBackward|torch/autograd/function.py: apply|apex/contrib/layer_norm/layer_norm.py: backward|<built-in method ln_bwd of PyCapsule object at 0x>": {
        "job_x08j11173.cloud.sqa.na131_0_122485.json": 0.010127612754279463
    },
    "pretrain_gpt.py: <module>|megatron/training.py: pretrain|megatron/training.py: train|megatron/training.py: train_step|megatron/core/pipeline_parallel/schedules.py: forward_backward_pipelining_without_interleaving": {
        "job_x08j11173.cloud.sqa.na131_2_122487.json": 0.01041679269251709
    },
    "autograd::engine::evaluate_function: torch::autograd::AccumulateGrad": {
        "job_x08j11173.cloud.sqa.na131_8_122486.json": 0.013633967050768714
    }
}
Este relatório lista funções Python que consomem mais de 1% do tempo total de execução, excluindo o tempo que se sobrepõe à computação da GPU, comunicação e outras operações. As funções são agrupadas por nome e, para cada grupo, todos os workers que excedem o limiar de 1% são listados com seus percentuais de tempo.
Apêndice
Parâmetros da CLI do PerfTracker
Referências
Para uma explicação detalhada da metodologia do PerfTracker, consulte PerfTracker: Online Performance Troubleshooting for Large-scale Model Training in Production.