A compressão de modelos reduz o tamanho e a complexidade computacional do modelo por meio de técnicas como a quantização, com impacto mínimo no desempenho preditivo. Essa abordagem é ideal para cenários com memória GPU limitada ou quando é necessário reduzir os custos de implantação.
Como funciona
O PAI Model Gallery oferece suporte à quantização de modelos baseada na técnica Weight-only Quantization. Ao utilizar a estratégia MinMax-8Bit ou MinMax-4Bit, você converte os parâmetros de peso em ponto flutuante do modelo em representações inteiras de 8 bits ou 4 bits. Isso diminui o tamanho do modelo e o uso de memória GPU, mantendo um bom desempenho.
Comprimir um modelo
-
Treine o modelo.
É necessário treinar o modelo antes de comprimi-lo. Para mais informações, consulte Implantação e treinamento de modelos.
-
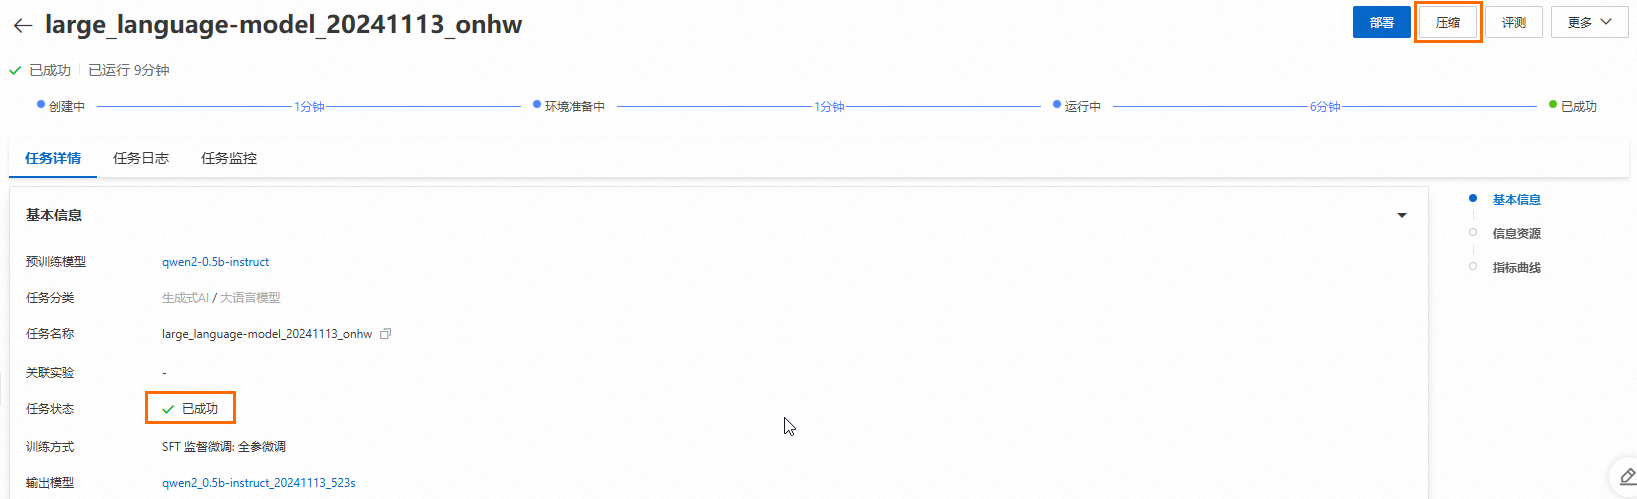
Após a conclusão do treinamento do modelo, clique em Compression no canto superior direito da página Task details.
-
Configure os parâmetros de compressão.
A tabela a seguir descreve os principais parâmetros.
Parâmetro
Descrição
Método de compressão
Somente a quantização de modelo (Weight-only Quantization) tem suporte. Esse método converte os parâmetros de peso para uma largura de bits menor, reduzindo o uso de memória GPU durante a inferência.
Estratégia de compressão
-
MinMax-8Bit: quantiza os pesos do modelo para inteiros de 8 bits usando escalonamento min-max.
-
MinMax-4Bit: quantiza os pesos do modelo para inteiros de 4 bits usando escalonamento min-max.
Para outros parâmetros, consulte Implantação e treinamento de modelos.
-
-
Clique em Compression.
O sistema redireciona você para a página Task details, onde é possível visualizar as informações básicas do job de compressão, o status em tempo real e os logs da tarefa.
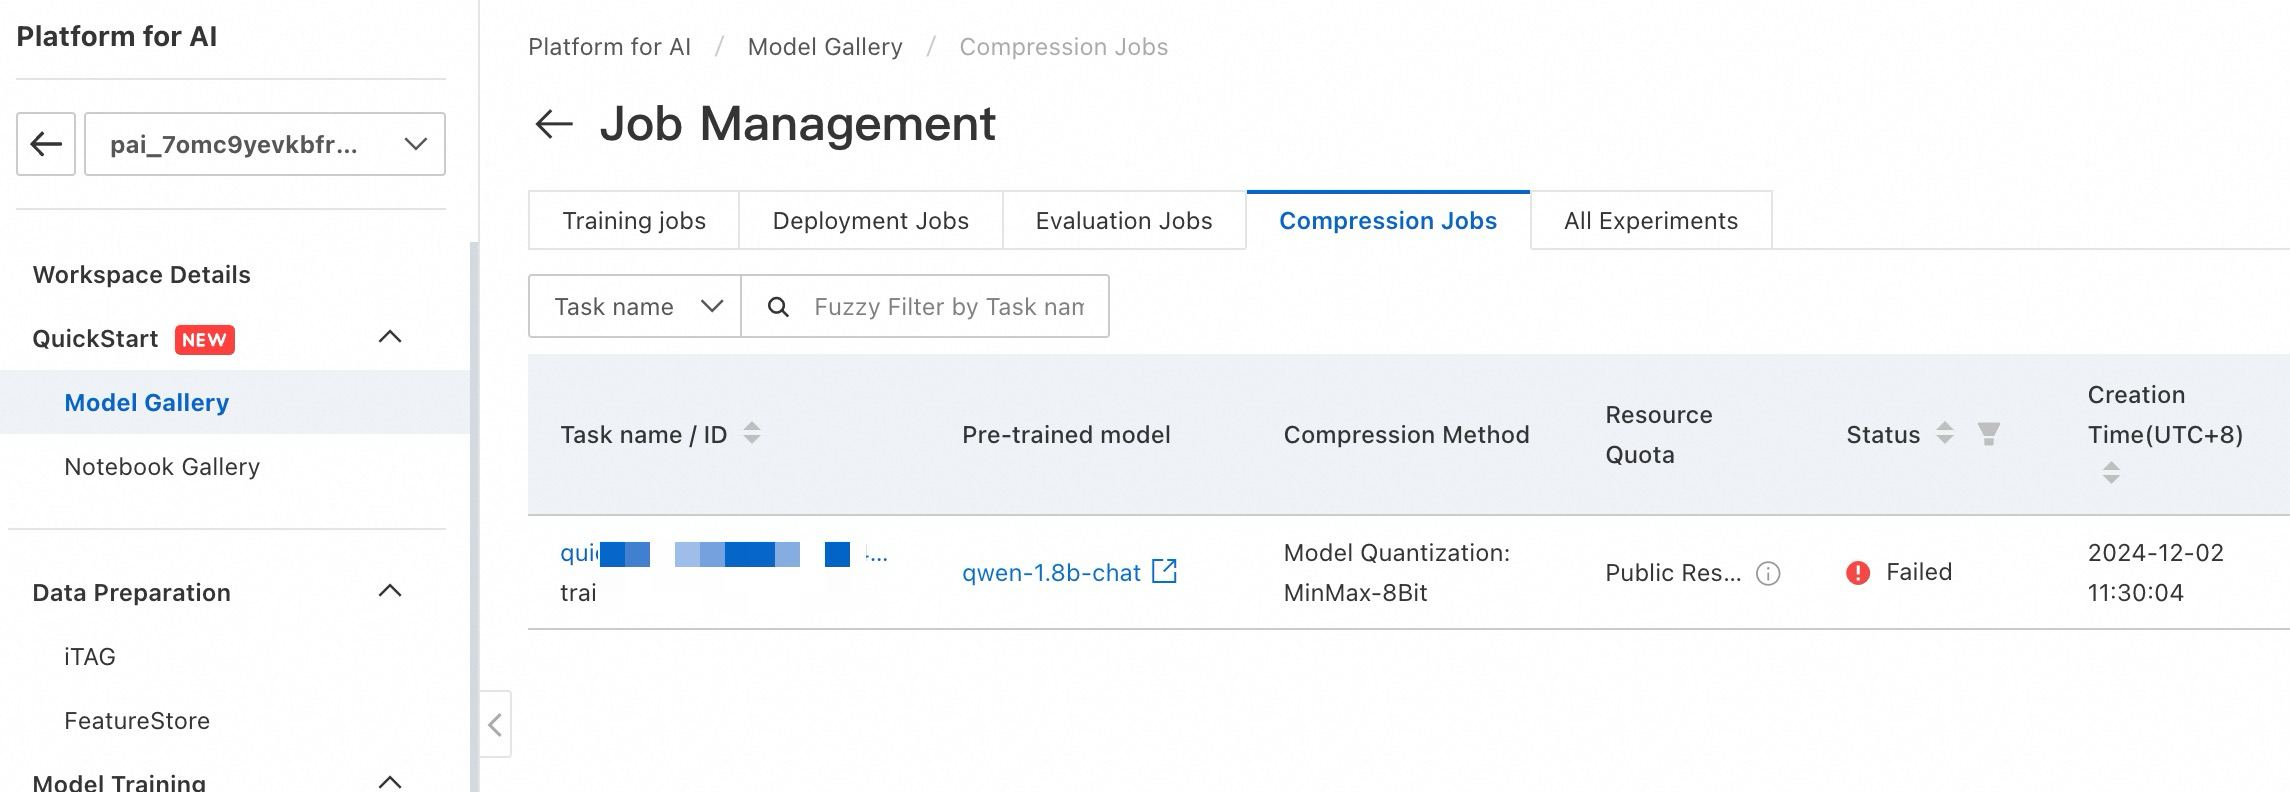
Visualize jobs de compressão
Para visualizar os jobs de compressão, acesse PAI Model Gallery > Job Management > Compression Jobs.