As bases de conhecimento do LangStudio transformam documentos do OSS em índices vetoriais para geração aumentada por recuperação (RAG). Crie uma base de conhecimento uma única vez e reutilize-a em vários fluxos de aplicação.
Como funciona
Uma base de conhecimento converte arquivos do OSS em conteúdo recuperável por LLMs em três etapas:
-
Leitura e fragmentação de dados: Lê os arquivos de origem no OSS e os divide em unidades processáveis.
Documentos não estruturados: O sistema analisa e divide o conteúdo em blocos de texto menores e semanticamente completos (chunks).
Dados estruturados: A fragmentação ocorre por linha.
Imagens: O processamento é integral, sem fragmentação.
Vetorização: Um modelo de embedding converte cada chunk ou imagem em um vetor numérico que representa seu significado semântico.
Armazenamento e indexação: Os dados vetoriais são armazenados em um banco de dados vetorial e um índice é criado para recuperação.
Primeiros passos
Crie uma base de conhecimento do tipo Documento e utilize-a em um fluxo de aplicação:
-
Crie uma base de conhecimento. Acesse o LangStudio e selecione um workspace. Na aba Knowledge Base, clique em Create Knowledge Base. Configure os parâmetros abaixo e clique em OK.
Parâmetro
Descrição
Basic Configuration
Name
Insira um nome personalizado para a base de conhecimento, como
test_kg.Data Source OSS Path
Local onde os arquivos de origem estão armazenados. Exemplo:
oss://examplebucket.oss-cn-hangzhou-internal.aliyuncs.com/test/original/.Output OSS Path
Armazena resultados intermediários de análise e dados de índice. A saída final depende do tipo de banco de dados vetorial selecionado. Exemplo:
oss://examplebucket.oss-cn-hangzhou-internal.aliyuncs.com/test/output/.ImportanteSe a Instance RAM Role do runtime for a função padrão do PAI, defina este parâmetro como um diretório dentro do caminho de armazenamento padrão do workspace atual no Bucket do OSS.
Type
Selecione Document.
Embedding Model and Database
Embedding Type
Selecione Alibaba Cloud Model Studio Service (crie uma conexão primeiro, consulte Connection Configuration) e escolha a conexão e o modelo.
Vector Database Type
Escolha FAISS para testes rápidos.
-
Faça upload dos arquivos.
Na aba Knowledge Base, clique na base de conhecimento desejada. Na página Overview, alterne para a aba Documents. Esta aba exibe os documentos da fonte de dados do OSS configurada.
-
Adicione ou atualize arquivos com o botão Upload ou envie-os diretamente para a fonte de dados no OSS. Por exemplo, faça upload do arquivo rag_test_doc.txt pela página. Para formatos de arquivo suportados, consulte Knowledge Base Types.

-
Atualize o índice. Após o upload dos arquivos, clique em Update Index no canto superior direito. Na caixa de diálogo, configure os recursos de computação e a rede. Quando a tarefa for concluída com êxito, o status do arquivo mudará para Indexed. Clique em um arquivo para visualizar seus chunks. Para bases de conhecimento de imagens, o sistema retorna listas de imagens.
NotaPara chunks de documentos armazenados no Milvus, defina o status individualmente como Enabled ou Disabled. Chunks desativados não são recuperados durante as buscas.

-
Execute um teste de recuperação. Após atualizar o índice, mude para a aba Recall Test. Insira uma consulta e ajuste os parâmetros de recuperação para testar o desempenho.

-
Use a base de conhecimento em um fluxo de aplicação. Após os testes, recupere informações da base de conhecimento em um application flow. No nó da base de conhecimento, ative os recursos de reescrita de consulta e reclassificação de resultados e visualize a consulta reescrita no rastreamento de execução.

O resultado é uma
List[Dict]. CadaDictpossui as chavescontentescore, que representam o chunk recuperado e sua pontuação de similaridade com a consulta.[ { "score": 0.8057173490524292, "content": "Due to the uncertainty caused by the pandemic, XX Bank proactively increased provisions for impairment losses on loans, advances, and non-credit assets based on economic trends and forecasts for China or the Chinese mainland. The bank also increased the write-off and disposal of non-performing assets to improve the provision coverage ratio. In 2020, the net profit reached 28.928 billion CNY, a year-on-year increase of 2.6%, and profitability gradually improved.\n(CNY in millions) 2020 2019 Change (%)\nOperating Results and Profitability\nOperating Income 153,542 137,958 11.3\nOperating Profit Before Impairment Losses 107,327 95,816 12.0\nNet Profit 28,928 28,195 2.6\nCost-to-Income Ratio(1)(%) 29.11 29.61 down 0.50 percentage points\nAverage Return on Total Assets (%) 0.69 0.77 down 0.08 percentage points\nWeighted Average Return on Equity (%) 9.58 11.30 down 1.72 percentage points\nNet Interest Margin(2)(%) 2.53 2.62 down 0.09 percentage points\nNote: (1) Cost-to-Income Ratio = Business and management fees / Operating income.", "id": "49f04c4cb1d48cbad130647bd0d75f***1cf07c4aeb7a5d9a1f3bda950a6b86e", "metadata": { "page_label": "40", "file_name": "2021-02-04_XX_Insurance_Group_Co_Ltd_XX_China_XX_2020_Annual_Report.pdf", "file_path": "oss://my-bucket-name/datasets/chatglm-fintech/2021-02-04__XX_Insurance_Group_Co_Ltd__601318__China_XX__2020_Annual_Report.pdf", "file_type": "application/pdf", "file_size": 7982999, "creation_date": "2024-10-10", "last_modified_date": "2024-10-10" } }, { "score": 0.7708036303520203, "content": "7.2 billion CNY, a year-on-year increase of 5.2%.\n2020\n(CNY in millions) Life and Health Insurance Business, Property and Casualty Insurance Business, Banking Business, Trust Business, Securities Business, Other Asset Management Business, Technology Business, Other Business and Consolidation Elimination, Group Consolidated\nNet profit attributable to shareholders of the parent company 95,018 16,083 16,766 2,476 2,959 5,737 7,936 (3,876) 143,099\nMinority interest 1,054 76 12,162 3 143 974 1,567 281 16,260\nNet profit (A) 96,072 16,159 28,928 2,479 3,102 6,711 9,503 (3,595) 159,359\nItems excluded:\n Short-term investment fluctuation(1)(B) 10,308 – – – – – – – 10,308\n Impact of discount rate change (C) (7,902) – – – – – – – (7,902)\n One-time significant items and others excluded by management as not part of daily operating income and expenditure (D) – – – – – – 1,282 – 1,282\nOperating profit (E=A-B-C-D) 93,666 16,159 28,928 2,479 3,102 6,711 8,221 (3,595) 155,670\nOperating profit attributable to shareholders of the parent company 92,672 16,", "id": "8066c16048bd722d030a85ee8b1***36d5f31624b28f1c0c15943855c5ae5c9f", "metadata": { "page_label": "19", "file_name": "2021-02-04_XX_Insurance_Group_Co_Ltd_XXX_China_XX_2020_Annual_Report.pdf", "file_path": "oss://my-bucket-name/datasets/chatglm-fintech/2021-02-04__XX_Insurance_Group_Co_Ltd__601318__China_XX__2020_Annual_Report.pdf", "file_type": "application/pdf", "file_size": 7982999, "creation_date": "2024-10-10", "last_modified_date": "2024-10-10" } } ]
Recursos
Tipo de base de conhecimento
Selecione o tipo de base de conhecimento correspondente aos seus arquivos:
Documentos: Suporta
.html,.htm,.pdf,.txt,.docx,.mde.pptx.Dados estruturados: Compatível com
.jsonl,.csv,.xlsxe.xls.Imagens: Aceita
.jpg,.jpeg,.pnge.bmp.
Configurações especiais:
-
Para bases de conhecimento do tipo Documento, configure a Chunk Configuration. Estes campos são obrigatórios. Para obter orientações sobre como definir parâmetros de fragmentação, consulte Chunking parametertuning.
Chunk Size: Número máximo de caracteres por chunk de texto. Padrão: 1024 caracteres.
Chunk Overlap: Quantidade de caracteres sobrepostos entre chunks adjacentes para garantir continuidade contextual. Padrão: 200 caracteres.
Em bases de conhecimento de dados estruturados, configure as Field Settings. Faça upload de um arquivo (como animal.csv) ou adicione campos manualmente para especificar quais dados participarão da indexação e recuperação.
Escolha um banco de dados vetorial
Ambientes de produção: Utilize Milvus ou Elasticsearch, pois suportam processamento de dados vetoriais em grande escala.
-
Ambiente de teste: Use FAISS, que não exige banco de dados adicional. Os arquivos da base de conhecimento e os índices gerados ficam armazenados no Output OSS Path. O FAISS é ideal para testes funcionais ou pequenos conjuntos de dados, mas o desempenho pode cair com grandes volumes.
NotaBases de conhecimento do tipo Imagem não suportam FAISS.
Estratégia de atualização de índice
|
Método de atualização |
Descrição |
Observações |
|
Atualização manual |
Clique em Update Index no console. Ideal quando os arquivos mudam com pouca frequência. |
Processa arquivos integralmente ou de forma incremental. |
|
Atualização automática |
Cria uma regra no EventBridge que aciona a indexação sempre que houver alterações nos arquivos do OSS. |
Importante
Taxas de mensagens são cobradas durante atualizações automáticas.
|
|
Atualização agendada |
Utiliza uma tarefa recorrente do DataWorks para atualizar o índice periodicamente (por exemplo, diariamente). |
Depende do DataWorks. Tarefas recorrentes entram em vigor na base T+1 (configurações feitas hoje serão executadas amanhã). |
Métodos de configuração:
Atualização manual
Clique em Update Index. O sistema envia uma tarefa de workflow do PAI para pré-processar, fragmentar, vetorizar e indexar os arquivos. Parâmetros da tarefa:
|
Parâmetro |
Descrição |
|
Recurso de computação |
Recursos de computação para nós do workflow. Use recursos públicos ou utilize Lingjun resources e recursos de computação gerais por meio de cotas de recursos.
|
|
Configuração de VPC |
Ao acessar o banco de dados vetorial ou o serviço de Embedding via rede interna, garanta que a VPC selecionada seja a mesma ou tenha comunicação com as VPCs desses serviços. |
|
Configuração de Embedding |
|
Atualização automática
Acesse o console do EventBridge e ative o EventBridge.
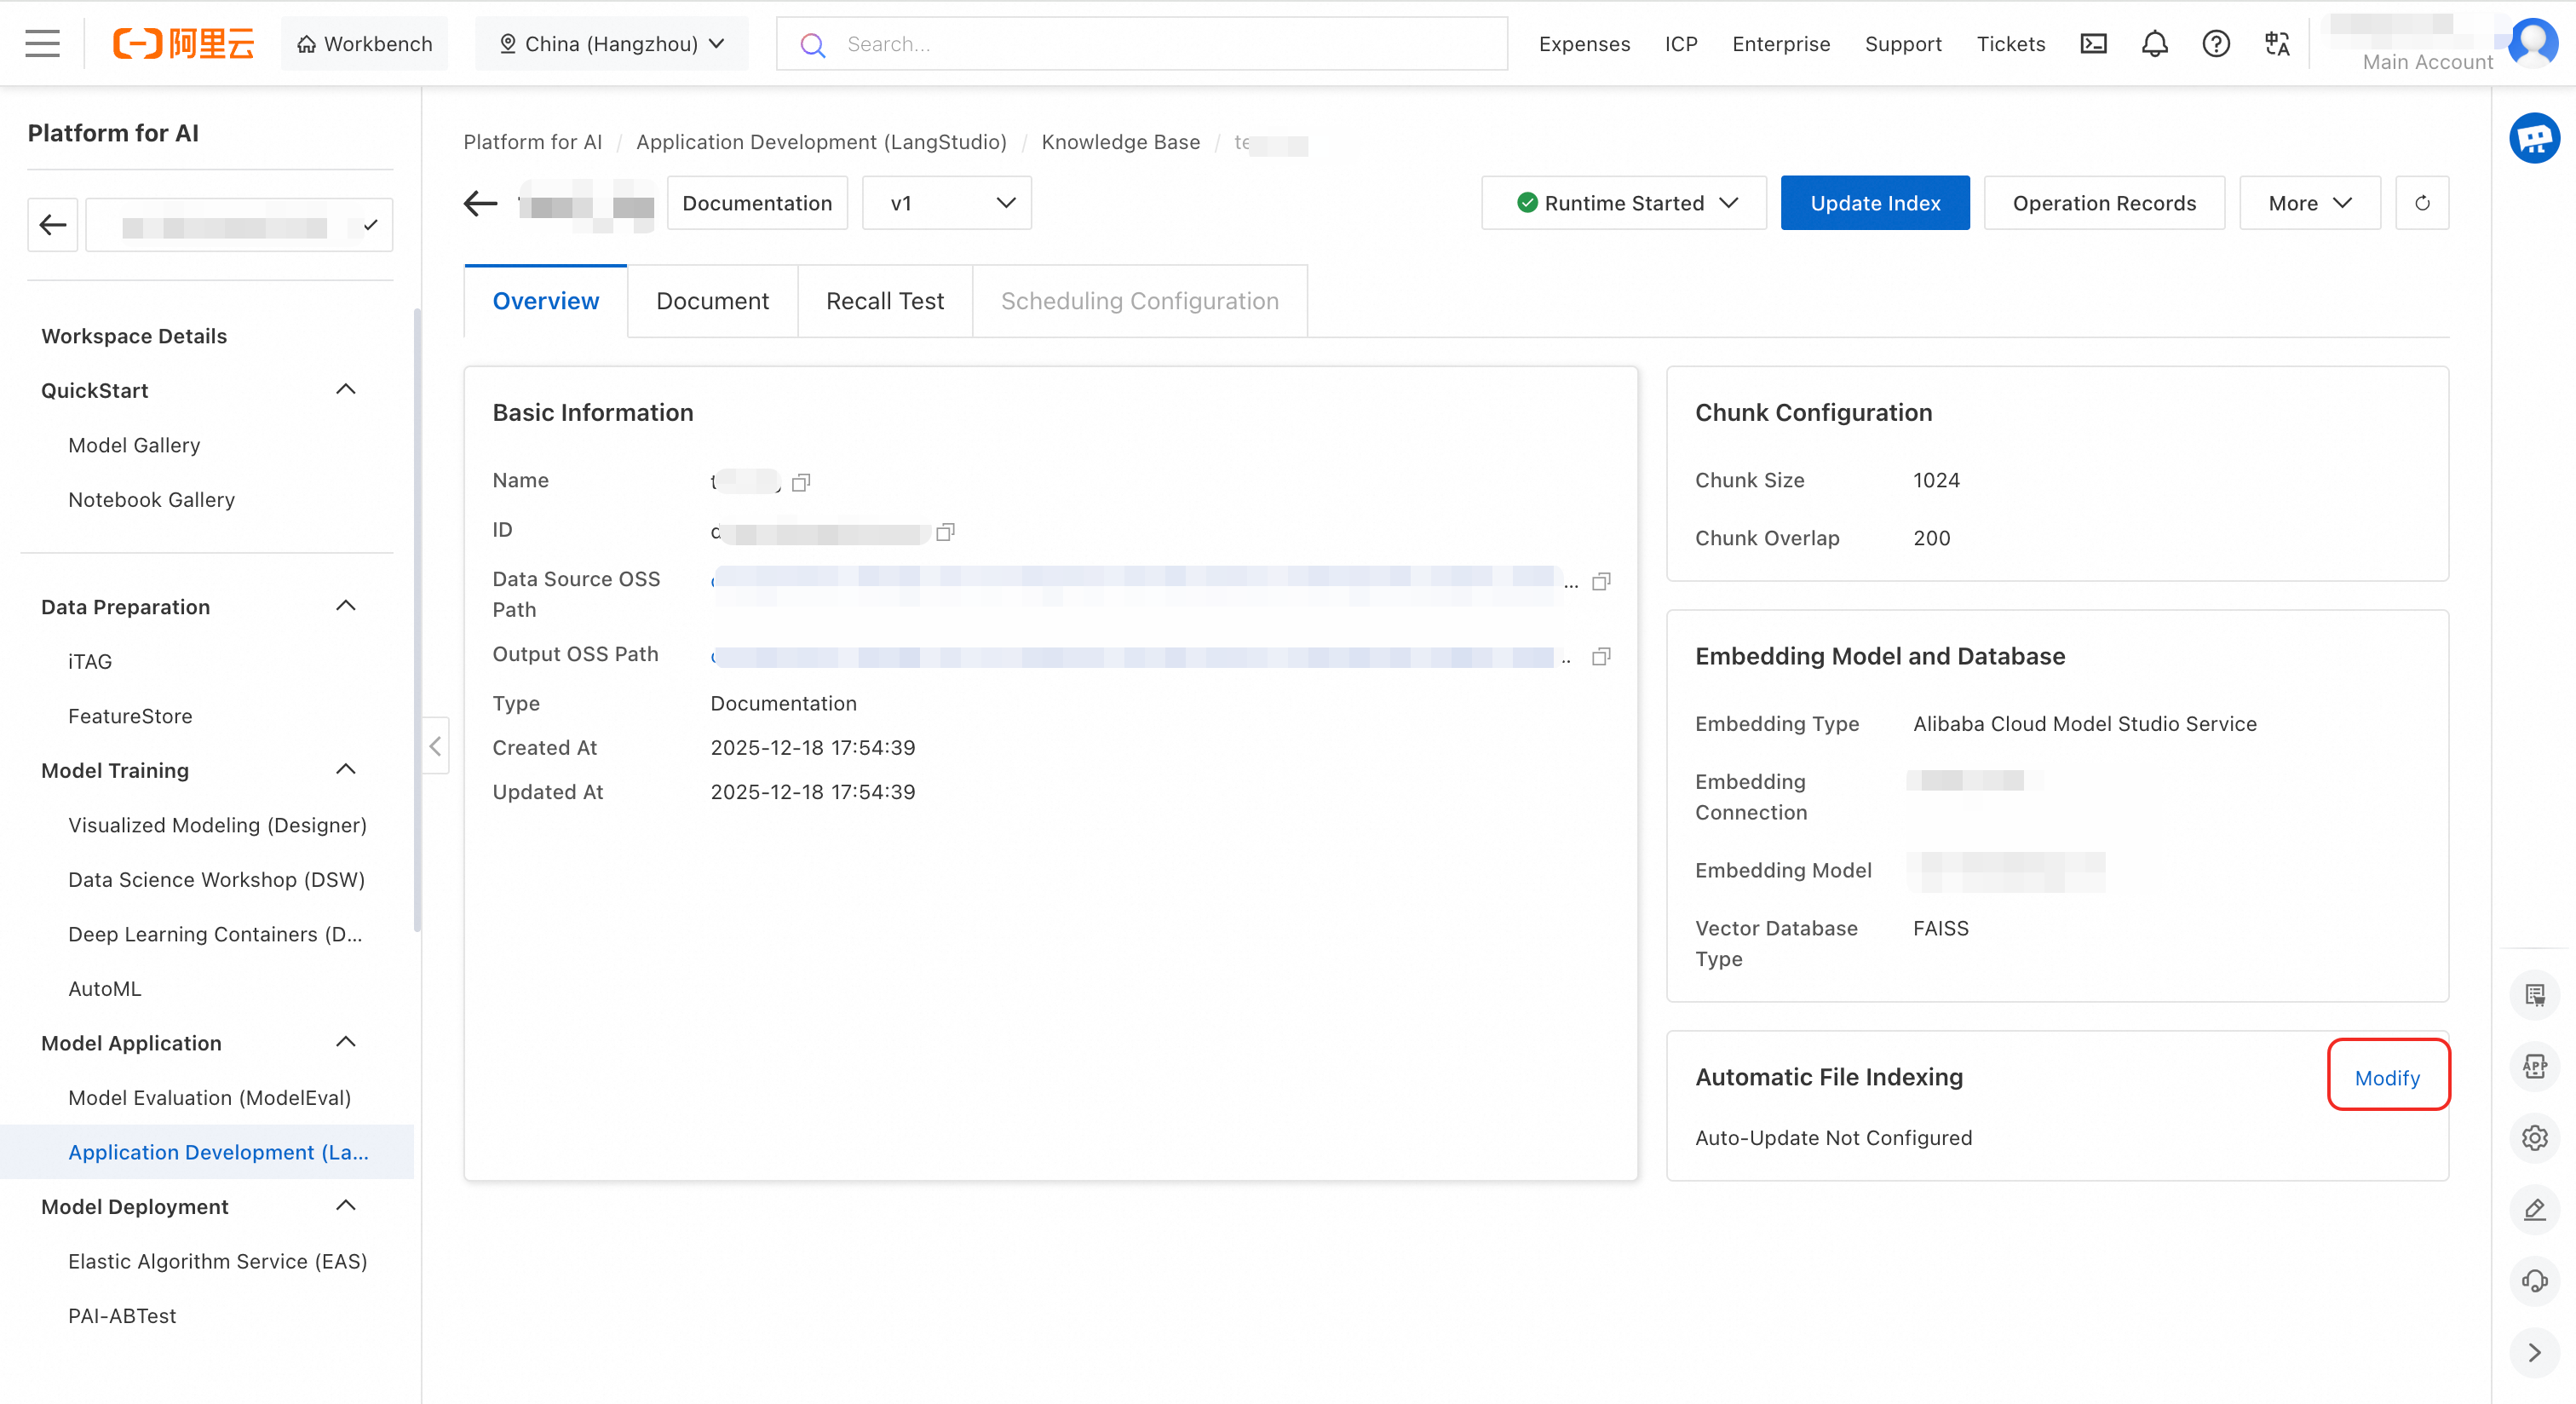
Configure as atualizações automáticas de índice. Acesse a página de detalhes da base de conhecimento. Na aba Overview, na seção Automatic File Indexing no canto inferior direito, clique em Modify.
-
Configure os recursos de computação e a VPC e clique em OK. Depois disso, alterações nos arquivos acionam tarefas de indexação automaticamente, sem intervenção manual.
ImportanteOs recursos de computação configurados aqui são usados apenas quando os arquivos são atualizados. Nenhuma taxa de recurso será cobrada se não houver alterações nos arquivos.
-
Faça alterações nos arquivos do OSS.
Após configurar atualizações automáticas de arquivos, há um atraso de alguns minutos até que as regras entrem em vigor. Aguarde pelo menos 3 minutos antes de operar nos arquivos.
Para excluir um arquivo usando a API do OSS, especifique uma versão para acionar o evento de alteração.
-
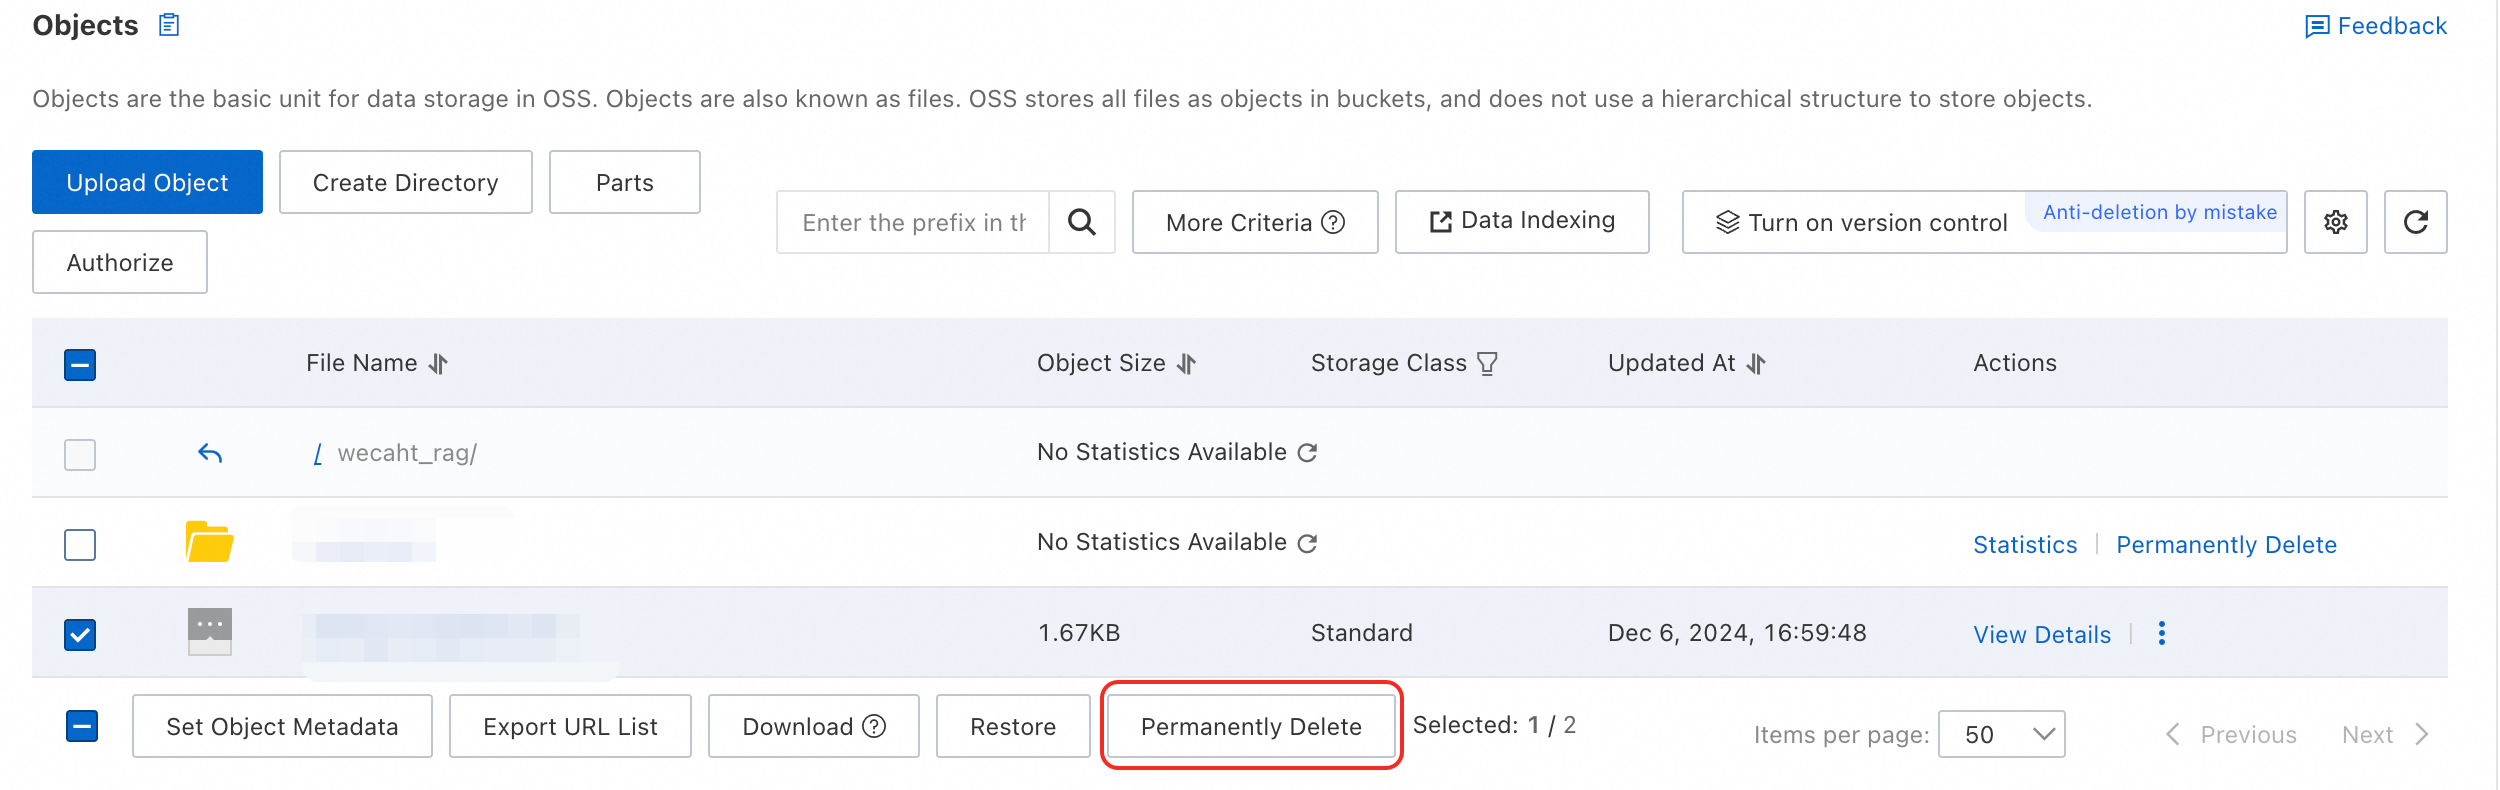
Para excluir um arquivo no console, selecione-o e clique em Permanently Delete na parte inferior.
Visualize as tarefas de indexação. Após alterar um arquivo, aguarde cerca de 3 minutos. A tarefa de construção de índice acionada automaticamente aparecerá na lista de registros de operação.
Atualização agendada
O recurso de atualização agendada depende do DataWorks. Certifique-se de ter ativado este serviço. Caso contrário, consulte Purchase guide.
Na página de detalhes da base de conhecimento, clique em no canto superior direito, conclua as configurações e envie.

-
Visualize configurações de agendamento e tarefas recorrentes
O sistema cria um workflow no DataWorks DataStudio e o publica como uma tarefa recorrente no DataWorks Operation Center. Tarefas recorrentes entram em vigor na base T+1. Visualize a configuração de agendamento na página de configuração de agendamento da base de conhecimento.

-
Descrições dos parâmetros de configuração agendada:
Ciclo de agendamento: Frequência com que o nó é executado em produção (quantidade de instâncias de ciclo geradas e horários de execução).
Horário agendado: Momento específico em que o nó será executado.
Definição de timeout: Duração após a qual um nó em execução falha e encerra.
Data de vigência: Intervalo de tempo durante o qual o nó executa seu agendamento automático. Fora desse intervalo, o nó deixa de ser agendado automaticamente.
-
Grupo de recursos de agendamento: Usado para atualizações agendadas do DataWorks. Se ainda não criou um grupo de recursos do DataWorks, clique em Create Now na lista suspensa para ir à página de criação. Após a criação, vincule o grupo de recursos ao workspace atual.

Os parâmetros de agendamento estão descritos em Time property configuration description.
Visualize o conjunto de dados
Após uma atualização de índice bem-sucedida, o sistema registra o Output OSS Path como um conjunto de dados. Visualize-o em AI Asset Management - Datasets. O conjunto de dados compartilha o nome da base de conhecimento e registra a saída da construção do índice.

Configure o runtime
Selecione um runtime para visualizar chunks e executar testes de recuperação. Essas operações acessam o banco de dados vetorial e o serviço de Embedding.
Requisitos do runtime:
Se estiver acessando o banco de dados vetorial ou o serviço de Embedding via endereço de rede interna, garanta que a VPC do runtime seja a mesma ou tenha comunicação com as deles.
Ao selecionar uma função personalizada para Instance RAM Role, conceda a essa função permissões de acesso ao OSS (recomendamos
AliyunOSSFullAccess). Granting permissions to a RAM role.
Se a versão do runtime estiver desatualizada (anterior a 2.1.4), ela pode não aparecer na lista suspensa. Crie um novo runtime.
Gerencie múltiplas versões
Clone uma versão testada da base de conhecimento como uma nova versão oficial para isolar os ambientes de desenvolvimento e produção.
Alterne entre versões usando a lista suspensa ao lado do tipo na página de detalhes da base de conhecimento. Selecione a versão desejada no nó da base de conhecimento de um fluxo de aplicação.

A clonagem envia uma tarefa de workflow visível nos registros de operação.

Configure parâmetros de recuperação
Top K: Quantidade máxima de chunks relevantes a recuperar. Intervalo: 1 a 100.
Limiar de pontuação: Limiar de pontuação de similaridade (0 a 1). Apenas chunks com pontuação acima deste valor são retornados.
Padrão de Recuperação: O padrão é Dense (vetorial). A recuperação híbrida (vetor + palavra-chave) requer Milvus 2.4.x+ ou Elasticsearch. Select a retrieval mode.
Condição de filtro de metadados: Restringe o escopo de busca usando metadados. Use metadata.
Reescrita de consulta: Usa um LLM para esclarecer consultas vagas ou dependentes de contexto, melhorando a precisão da recuperação. Query rewrite.
-
Reclassificação de Resultados: Utiliza um modelo de reclassificação para reordenar resultados, colocando os mais relevantes no topo. Result Reranking.
NotaRequer um modelo de reclassificação. Tipos de conexão suportados: Model Studio, AI Search Open Platform Model Service e General Reranker Model Service.
Otimize o desempenho de recuperação
Ajuste parâmetros de fragmentação
Princípios orientadores
Limite de contexto do modelo: O tamanho do chunk não deve exceder o limite de tokens do modelo de Embedding.
Integridade da informação: Os chunks devem conter significado semântico completo, sem excesso de ruído. Considere fragmentar por parágrafo em textos estruturados.
Mantenha a continuidade: Defina a sobreposição como 10%-20% do tamanho do chunk para evitar perda de contexto nas fronteiras.
Evite interferência repetitiva: Sobreposição excessiva introduz redundância e reduz a eficiência da recuperação.
Sugestões de depuração
Otimização iterativa: Comece com um valor inicial (como tamanho de chunk 300 e sobreposição 50) e itere com base nos resultados de recuperação e P&R para encontrar as configurações ideais para seus dados.
Limites de linguagem natural: Se o texto tiver uma estrutura clara (por exemplo, dividido por capítulos ou parágrafos), considere dividi-lo seguindo seus limites naturais para preservar a integridade semântica.
Guia rápido de otimização
|
Problema |
Sugestão de otimização |
|
Resultados de recuperação irrelevantes |
Aumente o tamanho do chunk, diminua a sobreposição do chunk. |
|
Contexto do resultado incoerente |
Aumente a sobreposição do chunk. |
|
Não encontra correspondência adequada (baixa revocação) |
Aumente moderadamente o tamanho do chunk. |
|
Custos elevados de computação ou armazenamento |
Diminua o tamanho do chunk, diminua a sobreposição do chunk. |
A tabela a seguir fornece tamanhos recomendados de chunk e sobreposição para diferentes tipos de texto, com base em experiências anteriores:
|
Tipo de texto |
Tamanho de chunk recomendado (chunk_size) |
Tamanho de sobreposição recomendado (chunk_overlap) |
|
Texto curto (FAQ, resumo) |
100 a 300 |
20 a 50 |
|
Texto regular (notícias, blog) |
300 a 600 |
50 a 100 |
|
Documentos técnicos (API, artigo) |
600 a 1024 |
100 a 200 |
|
Documentos longos (jurídico, livro) |
1024 a 2048 |
200 a 400 |
Escolha um modo de recuperação
Cada modo de recuperação tem pontos fortes adequados a diferentes cenários:
Recuperação densa (vetorial): Excelente para compreender semântica. Converte tanto a consulta quanto os documentos em vetores e determina a relevância semântica calculando a similaridade vetorial.
Recuperação esparsa (palavra-chave): Destaca-se na correspondência exata. Baseada em modelos tradicionais de frequência de termos (como BM25), calcula a relevância com base na frequência e posição da palavra-chave em um documento.
Recuperação híbrida: Combina o melhor de ambos. Mescla resultados de busca vetorial e por palavra-chave e os reclassifica usando algoritmos como Reciprocal Rank Fusion (RRF) ou fusão ponderada.
|
Modo de recuperação |
Prós e contras |
Cenários |
|
Recuperação densa (vetorial) |
|
|
|
Recuperação esparsa (palavra-chave) |
|
|
|
Recuperação híbrida |
|
|
Use metadados para filtrar a recuperação
Valor da filtragem por metadados
Recuperação precisa, menos ruído: Metadados podem servir como filtro durante a recuperação. Filtrar com metadados permite excluir documentos irrelevantes e evita que o modelo de geração receba conteúdo não relacionado. Por exemplo, quando um usuário pergunta "Encontre romances de ficção científica escritos por Liu Cixin", o sistema pode usar as condições de metadados
author=Liu Cixinecategory=science fictionpara localizar diretamente os documentos mais relevantes.-
Experiência do usuário aprimorada
Recomendações personalizadas: Use metadados para fornecer recomendações personalizadas com base nas preferências históricas do usuário (como preferência por documentos de "ficção científica").
Interpretabilidade melhorada: Incluir metadados de um documento (como autor, fonte, data) nos resultados ajuda os usuários a julgar sua credibilidade e relevância.
Suporte a expansão multilíngue ou multimodal: Metadados como "idioma" ou "tipo de mídia" simplificam o gerenciamento de bases de conhecimento com vários idiomas ou mídias mistas, como texto e imagens.
Como usar
Limitações do recurso:
Versão da imagem do runtime: Deve ser 2.1.8 ou posterior.
Banco de dados vetorial: Apenas Milvus e Elasticsearch são suportados.
Tipo de base de conhecimento: Suporta documentos ou dados estruturados. Imagens não são suportadas.
-
Configure variáveis de metadados. Para bases de conhecimento que usam Milvus, localize a seção Metadata na aba Overview. Clique em Edit para configurar variáveis (por exemplo, uma variável chamada
author). Não use campos reservados.
-
Marque documentos. Acesse a página de detalhes do chunk do documento, clique em Edit Metadata e adicione a variável de metadados e seu valor (por exemplo,
author=Alex). Na página Overview, visualize o uso de metadados e a contagem de valores.
-
Teste o efeito de filtragem. Na aba Recall Test, adicione uma condição de filtro de metadados e execute um teste.

Nota: Os documentos recuperados na imagem foram marcados na etapa 2.
-
Use em um fluxo de aplicação. Configure a condição de filtro de metadados no nó da base de conhecimento.

Reescrita de consulta e reclassificação de resultados
Reescrita de consulta
Reescreve consultas vagas, coloquiais ou dependentes de contexto em perguntas claras e independentes para melhorar a recuperação.
-
Cenários recomendados:
A consulta do usuário é vaga ou incompleta (ex.: "Quando ele nasceu?" sem contexto).
Em uma conversa de múltiplas voltas, a consulta depende do contexto (ex.: "O que ele fez depois disso?").
O recuperador ou LLM tem baixo desempenho e não compreende a consulta com precisão.
Uso de método tradicional de recuperação por índice invertido (como BM25) em vez de recuperação semântica.
-
Não recomendado para:
A consulta do usuário já é muito clara e específica.
O LLM tem excelente desempenho e forte compreensão da consulta.
O sistema exige baixa latência e não pode arcar com atrasos adicionais da reescrita.
Reclassificação de resultados
Reordena os resultados de recuperação para priorizar os documentos mais relevantes.
-
Cenários recomendados:
O recuperador inicial fornece resultados instáveis (como de BM25 ou DPR).
A classificação dos resultados de recuperação é crítica (como exigir alta precisão Top-1 em sistemas de busca ou P&R).
-
Não recomendado para:
O sistema tem recursos limitados e não pode arcar com sobrecarga adicional de inferência.
O desempenho do recuperador inicial já é suficientemente forte e a reclassificação oferece melhoria limitada.
O tempo de resposta é crítico, como em cenários de busca em tempo real.
FAQ
Como solucionar falhas em tarefas de atualização de índice ou clonagem de versão?
Siga estas etapas quando uma tarefa falhar:
-
Visualize registros de operação: Na página de detalhes da base de conhecimento, localize a tarefa com falha nos Operation Records e clique em View Task.

-
Verifique os logs da tarefa: O sistema redireciona você para a página de workflow do PAI. Verifique os logs do nó que falhou.

Por exemplo, a tarefa de workflow para atualizar o índice de uma base de conhecimento do tipo Documento inclui os três nós a seguir. Exceto pelo nó read-oss-file, cada nó cria uma tarefa PAI-DLC. Você também pode visualizar detalhes da tarefa DLC através da Job URL nos logs.
read-oss-file: Lê arquivos do OSS.
rag-parse-chunk: Responsável pelo pré-processamento e fragmentação de documentos.
rag-sync-index: Responsável por gerar embeddings dos chunks de texto e sincronizá-los com o banco de dados vetorial.
Por que arquivos de sistema (como requirements.txt) aparecem na base de conhecimento?
Causa: A base de conhecimento indexa todos os arquivos no Input OSS Path configurado. Definir esse caminho como a raiz do projeto pode indexar involuntariamente arquivos de sistema como requirements.txt, .DS_Store, .git/, __pycache__/ ou *.pyc.
Solução:
Crie um diretório dedicado (por exemplo,
knowledge-base-docs/) no OSS contendo apenas os arquivos que deseja indexar.Atualize o Input OSS Path da base de conhecimento para apontar para este diretório.
Arquivos comuns a excluir:
requirements.txt,.DS_Store,.git/,__pycache__/,*.pyc,*.log.
Como remover arquivos indexados incorretamente da base de conhecimento?
Para remover um arquivo já indexado dos resultados de recuperação:
-
Exclua do OSS: Remova o arquivo usando um destes métodos:
Console: Selecione o arquivo e clique em Permanently Delete.
API: Especifique um parâmetro de versão para acionar o evento de alteração.
-
Aguarde a reindexação automática: Se você configurou a Automatic Update (consulte Automatic update):
Aguarde pelo menos 3 minutos para que a regra entre em vigor.
Verifique a aba Operation Records para confirmar que a tarefa de reindexação foi concluída.
Atualização manual (se a atualização automática não estiver configurada): Clique em Update Index no canto superior direito para acionar uma reindexação completa.
Verifique a remoção: Confira a aba Documents para confirmar que o status do arquivo mudou de Indexed para removido.
Os registros de índice podem levar alguns minutos para se propagarem totalmente ao banco de dados vetorial. Se o arquivo ainda afetar a recuperação após a reindexação, tente acionar outra atualização manual de índice.