A Clusterização K-means é um algoritmo de aprendizado não supervisionado que divide um conjunto de dados em K clusters ao minimizar a soma dos erros quadráticos (SSE) dentro de cada cluster. O algoritmo atribui iterativamente os pontos de dados ao centroide do cluster mais próximo e recalcula as posições dos centroides até que as atribuições se estabilizem ou o número máximo de iterações seja atingido.
Como funciona
Selecione os centroides iniciais. Amostre aleatoriamente K pontos de dados como centroides iniciais ou use um dos métodos de inicialização compatíveis (random, topk, k-means++, uniform ou uma tabela externa de centroides).
Atribua pontos de dados aos clusters. Calcule a distância de cada ponto de dados para todos os centroides e atribua cada ponto ao centroide mais próximo.
Atualize os centroides. Recalcule a posição de cada centroide como a média de todos os pontos atribuídos àquele cluster.
Repita até a convergência. Repita as etapas 2 e 3 até que a variação do valor da função objetivo entre iterações consecutivas seja menor que o limiar de convergência ou até atingir o número máximo de iterações.
A Clusterização K-means trata os pontos de dados como vetores espaciais. Há suporte para colunas dos tipos INT ou DOUBLE. Quando a entrada está no formato esparso, também há suporte para colunas do tipo STRING.
Configure o componente
Método 1: Configurar no Machine Learning Designer
Na página de detalhes do pipeline no Machine Learning Designer, adicione o componente K-means Clustering ao pipeline e configure os parâmetros a seguir.
| Aba | Parâmetro | Descrição |
|---|---|---|
| Fields Setting | Feature Columns | Colunas da tabela de entrada usadas para treinamento. Separe os nomes das colunas com vírgulas (,). Há suporte para os tipos INT e DOUBLE. Para entradas esparsas, também há suporte para o tipo STRING. |
| Appended Columns | Colunas de entrada a anexar à tabela de resultados da clusterização. Separe os nomes das colunas com vírgulas (,). | |
| Input Sparse Matrix | Indica se os dados de entrada estão no formato esparso. Dados esparsos são representados como pares chave-valor. | |
| KV Pair Delimiter | Delimitador entre pares chave-valor. Padrão: vírgula (,). | |
| KV Delimiter | Delimitador entre chaves e valores dentro de um par. Padrão: dois-pontos (:). | |
| Parameters Setting | Clusters | Número de centroides do cluster. Valores válidos: 1–1000. |
| Distance Measurement Method | Métrica de distância. Valores válidos: Euclidean, Cosine, Cityblock. | |
| Centroid Initialization Method | Método para inicializar centroides. Valores válidos: Random, First K, Uniform, K-means++, Use Initial Centroid Table. | |
| Maximum Iterations | Número máximo de iterações. Valores válidos: 1–1000. | |
| Convergence Criteria | Limiar para interromper as iterações. O algoritmo para quando a diferença da função objetivo entre duas iterações consecutivas cai abaixo deste valor. | |
| Initial Random Seed | Semente para inicialização aleatória. Padrão: hora atual. Defina um valor fixo para obter resultados estáveis e reproduzíveis. | |
| Tuning | Cores | Número de núcleos de computação. Padrão: determinado pelo sistema. |
| Memory Size per Core | Memória por núcleo. Unidade: MB. |
Método 2: Usar comandos PAI
Passe parâmetros usando comandos PAI. Utilize o componente SQL Script para executar comandos PAI. Para mais informações, consulte Cenário 4: Executar comandos PAI dentro do componente SQL script.
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_input
    -DselectedColNames=f0,f1
    -DappendColNames=f0,f1
    -DcenterCount=3
    -Dloop=10
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=random
    -Dseed=1
    -DmodelName=pai_kmeans_test_output_model_
    -DidxTableName=pai_kmeans_test_output_idx
    -DclusterCountTableName=pai_kmeans_test_output_couter
-DcenterTableName=pai_kmeans_test_output_center;|
**Parâmetro** |
**Obrigatório** |
**Padrão** |
**Descrição** |
||
|
|
Sim |
— |
Nome da tabela de entrada. |
||
|
|
Não |
Todas as colunas |
Colunas da tabela de entrada usadas para treinamento. Separe os nomes das colunas com vírgulas (,). Há suporte para os tipos INT e DOUBLE. Para entradas esparsas, também há suporte para o tipo STRING. |
||
|
|
Não |
Todas as partições |
Partições da tabela de entrada usadas para treinamento. Formatos compatíveis: |
||
|
|
Não |
— |
Colunas de entrada a anexar à tabela de resultados da clusterização. Separe os nomes das colunas com vírgulas (,). |
||
|
|
Não |
|
Indica se os dados de entrada estão no formato esparso. Valores válidos: |
||
|
|
Não |
|
Delimitador entre pares chave-valor. |
||
|
|
Não |
|
Delimitador entre chaves e valores dentro de um par. |
||
|
|
Sim |
10 |
Número de centroides do cluster. Valores válidos: 1–1000. |
||
|
|
Não |
|
Métrica de distância. Valores válidos: |
x - c |
` |
|
|
Não |
|
Método de inicialização de centroides. Valores válidos:- |
||
|
|
Não |
— |
Nome da tabela que contém os centroides iniciais. Tem efeito apenas quando |
||
|
|
Não |
100 |
Número máximo de iterações. Valores válidos: 1–1000. |
||
|
|
Não |
0.1 |
Limiar de convergência. O algoritmo para quando a diferença da função objetivo entre duas iterações consecutivas é menor que este valor. |
||
|
|
Não |
Hora atual |
Semente aleatória inicial. Defina um valor fixo para obter resultados estáveis e reproduzíveis. |
||
|
|
Não |
— |
Nome do modelo offline de saída. |
||
|
|
Sim |
— |
Nome da tabela de resultados da clusterização, que contém a atribuição de cluster para cada registro. |
||
|
|
Não |
— |
Partição na tabela de resultados da clusterização. |
||
|
|
Não |
— |
Nome da tabela de estatísticas da clusterização, que contém o número de pontos de dados em cada cluster. |
||
|
|
Não |
— |
Nome da tabela de centroides da clusterização. |
||
|
|
Não |
Padrão do sistema |
Número de núcleos de computação. Valores válidos: 1–9999. Deve ser especificado junto com |
||
|
|
Não |
Padrão do sistema |
Memória por núcleo. Valores válidos: 1024–65536. Unidade: MB. |
||
|
|
Não |
— |
Ciclo de vida da tabela de saída. Unidade: dias. |
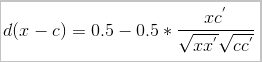 - Cityblock (distância de Manhattan):
Saída
O componente produz três tabelas de saída.
Tabela de resultados da clusterização (idxTableName)
|
Coluna |
Descrição |
|
|
Colunas anexadas da tabela de entrada. |
|
|
ID do cluster atribuído a cada ponto de dados. |
|
|
Distância de cada ponto de dados ao centroide do cluster atribuído. |
Tabela de estatísticas da clusterização (clusterCountTableName)
|
Coluna |
Descrição |
|
|
ID do cluster. |
|
|
Número de pontos de dados no cluster. |
Tabela de centroides da clusterização (centerTableName)
|
Coluna |
Descrição |
|
|
ID do cluster. |
|
|
Coordenadas do centroide para cada coluna de recurso selecionada durante o treinamento. |
Exemplos
Entrada densa
Etapa 1: Crie dados de teste.
Crie uma tabela opcional de centroides iniciais:
create table pai_kmeans_test_init_center as
select * from
(
  select 1 as f0, 2 as f1
  union all
  select 1 as f0, 3 as f1
  union all
  select 1 as f0, 4 as f1
) tmp;
Crie a tabela de entrada:
create table pai_kmeans_test_input as
select * from
(
  select 'id1' as id, 1 as f0, 2 as f1
  union all
  select 'id2' as id, 1 as f0, 3 as f1
  union all
  select 'id3' as id, 1 as f0, 4 as f1
  union all
  select 'id4' as id, 0 as f0, 3 as f1
  union all
  select 'id5' as id, 0 as f0, 4 as f1
) tmp;
Etapa 2: Envie o job de clusterização.
Com uma tabela externa de centroides:
drop table if exists pai_kmeans_test_output_idx;
yes
drop table if exists pai_kmeans_test_output_couter;
yes
drop table if exists pai_kmeans_test_output_center;
yes
drop offlinemodel if exists pai_kmeans_test_output_model_;
yes
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_input
    -DinitCenterTableName=pai_kmeans_test_init_center
    -DselectedColNames=f0,f1
    -DappendColNames=f0,f1
    -DcenterCount=3
    -Dloop=10
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=external
    -Dseed=1
    -DmodelName=pai_kmeans_test_output_model_
    -DidxTableName=pai_kmeans_test_output_idx
    -DclusterCountTableName=pai_kmeans_test_output_couter
    -DcenterTableName=pai_kmeans_test_output_center;
Com centroides iniciais selecionados aleatoriamente:
drop table if exists pai_kmeans_test_output_idx;
yes
drop table if exists pai_kmeans_test_output_couter;
yes
drop table if exists pai_kmeans_test_output_center;
yes
drop offlinemodel if exists pai_kmeans_test_output_model_;
yes
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_input
    -DselectedColNames=f0,f1
    -DappendColNames=f0,f1
    -DcenterCount=3
    -Dloop=10
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=random
    -Dseed=1
    -DmodelName=pai_kmeans_test_output_model_
    -DidxTableName=pai_kmeans_test_output_idx
    -DclusterCountTableName=pai_kmeans_test_output_couter
    -DcenterTableName=pai_kmeans_test_output_center;
Etapa 3: Visualize os resultados.
Tabela de resultados da clusterização (idxTableName):
+------------+------------+---------------+------------+
| f0         | f1         | cluster_index | distance   |
+------------+------------+---------------+------------+
| 1          | 2          | 0             | 0.0        |
| 1          | 3          | 1             | 0.5        |
| 1          | 4          | 2             | 0.5        |
| 0          | 3          | 1             | 0.5        |
| 0          | 4          | 2             | 0.5        |
+------------+------------+---------------+------------+
Tabela de estatísticas da clusterização (clusterCountTableName):
+---------------+---------------+
| cluster_index | cluster_count |
+---------------+---------------+
| 0             | 1             |
| 1             | 2             |
| 2             | 2             |
+---------------+---------------+
Tabela de centroides da clusterização (centerTableName):
+---------------+------------+------------+
| cluster_index | f0         | f1         |
+---------------+------------+------------+
| 0             | 1.0        | 2.0        |
| 1             | 0.5        | 3.0        |
| 2             | 0.5        | 4.0        |
+---------------+------------+------------+
Entrada esparsa
Etapa 1: Crie dados de teste.
create table pai_kmeans_test_sparse_input as
select * from
(
  select 1 as id, "s1" as id_s, "0:0.1,1:0.2" as kvs0, "2:0.3,3:0.4" as kvs1
  union all
  select 2 as id, "s2" as id_s, "0:1.1,2:1.2" as kvs0, "4:1.3,5:1.4" as kvs1
  union all
  select 3 as id, "s3" as id_s, "0:2.1,3:2.2" as kvs0, "6:2.3,7:2.4" as kvs1
  union all
  select 4 as id, "s4" as id_s, "0:3.1,4:3.2" as kvs0, "8:3.3,9:3.4" as kvs1
  union all
  select 5 as id, "s5" as id_s, "0:5.1,5:5.2" as kvs0, "10:5.3,6:5.4" as kvs1
) tmp;
Quando múltiplas colunas esparsas são usadas como entrada, elas são mescladas. Por exemplo, ao selecionar tanto kvs0 quanto kvs1, a primeira linha se expande para:
0:0.1,1:0.2,2:0.3,3:0.4,4:0,5:0,6:0,7:0,8:0,9:0,10:0Valores ausentes são preenchidos com 0. A matriz esparsa resultante tem 5 linhas e 11 colunas (indexadas de 0 a 10). Se um ID de coluna for grande (por exemplo, 123456789:0.1), as dimensões da matriz crescem proporcionalmente, consumindo CPU e memória significativas. Renumere as colunas sequencialmente a partir de 0 ou 1 para reduzir o tamanho da matriz.
Etapa 2: Envie o job de clusterização.
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_sparse_input
    -DenableSparse=true
    -DselectedColNames=kvs0,kvs1
    -DappendColNames=id,id_s
    -DitemDelimiter=,
    -DkvDelimiter=:
    -DcenterCount=3
    -Dloop=100
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=topk
    -Dseed=1
    -DmodelName=pai_kmeans_test_input_sparse_output_model
    -DidxTableName=pai_kmeans_test_sparse_output_idx
    -DclusterCountTableName=pai_kmeans_test_sparse_output_couter
    -DcenterTableName=pai_kmeans_test_sparse_output_center;
Etapa 3: Visualize os resultados.
Tabela de resultados da clusterização (idxTableName):
+------------+------------+---------------+---------------------------+
| id         | id_s       | cluster_index | distance                  |
+------------+------------+---------------+---------------------------+
| 4          | s4         | 0             | 2.90215437218629          |
| 5          | s5         | 1             | 0.0                       |
| 1          | s1         | 2             | 0.7088723439378913        |
| 2          | s2         | 2             | 1.1683321445547923        |
| 3          | s3         | 0             | 2.0548722588034516        |
+------------+------------+---------------+---------------------------+
Tabela de estatísticas da clusterização (clusterCountTableName):
+---------------+---------------+
| cluster_index | cluster_count |
+---------------+---------------+
| 0             | 2             |
| 1             | 1             |
| 2             | 2             |
+---------------+---------------+
Tabela de centroides da clusterização (centerTableName):
+---------------+----------------------------------------+----------------------------------+
| cluster_index | kvs0                                   | kvs1                             |
+---------------+----------------------------------------+----------------------------------+
| 0             | 0:2.6,1:0,2:0,3:1.1,4:1.6,5:0         | 6:1.15,7:1.2,8:1.65,9:1.7,10:0  |
| 1             | 0:5.1,1:0,2:0,3:0,4:0,5:5.2           | 6:5.4,7:0,8:0,9:0,10:5.3        |
| 2             | 0:0.6,1:0.1,2:0.75,3:0.2,4:0.65,5:0.7 | 6:0,7:0,8:0,9:0,10:0            |
+---------------+----------------------------------------+----------------------------------+
Solução de problemas
Algo Job Failed-System Error-Null feature value found
A tabela de entrada contém valores NULL ou vazios. Preencha os valores ausentes usando os valores padrão de imputação antes de executar o job.
Algo Job Failed-System Error-Feature count can't be more than 2000000
A entrada esparsa possui um ID de coluna superior a 2.000.000. Renumere as colunas sequencialmente começando de 0 ou 1.
Algo Job Failed-System Error-kIOError:Write failed for message: comparison_measure
O modelo de centroide é muito grande para gravação. Renumere as colunas esparsas começando de 0 ou 1 para reduzir o tamanho do modelo. Se o valor de col * centerCount exceder 270.000.000, remova o parâmetro modelName do comando e execute o job novamente.
FAILED: Failed Task createCenterTable:kOtherError:ODPS-0130161:[1,558] Parse exception - invalid token ',', expect ")"
Um nome de coluna na tabela de entrada é uma palavra-chave reservada do SQL. Renomeie a coluna para evitar conflitos com palavras-chave SQL.
A distância cosseno gera menos de K clusters
Ao usar a distância cosseno, alguns clusters podem ficar vazios porque K centroides iniciais podem incluir vetores paralelos. Vetores paralelos são tratados como o mesmo centroide, então alguns pontos de dados nunca são atribuídos a eles. Para evitar isso, forneça centroides iniciais explícitos usando uma tabela externa de centroides (initCenterMethod=external) para garantir K pontos iniciais distintos.