Avalia o desempenho de um modelo de clustering com base em dados brutos e resultados de agrupamento para gerar métricas de avaliação.
Limitações
Os relatórios de visualização deste componente estão disponíveis apenas no Machine Learning Studio original.
Informações básicas
O índice Calinski-Harabasz, também conhecido como Critério de Razão de Variância (VRC), é uma métrica de avaliação calculada pela seguinte fórmula.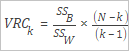
|
Parâmetro |
Descrição |
|
SSB |
Variância entre clusters, definida da seguinte forma.
|
|
SSW |
Variância dentro dos clusters, definida da seguinte forma.
|
|
N |
Número total de registros. |
|
k |
Número de centros de cluster. |
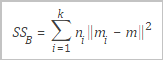 Onde:
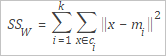 Onde:
Configuração do componente
Configure o componente de avaliação de modelo de clustering por um dos métodos a seguir.
Método 1: GUI
Defina os parâmetros do componente na página de pipeline do Machine Learning Designer.
|
Aba |
Parâmetro |
Descrição |
|
Field Settings |
Evaluation Columns |
Colunas a serem avaliadas. |
|
Input is Sparse Format |
Indica se os dados de entrada estão no formato chave-valor (KV) esparso. |
|
|
Key-Value Pair Delimiter |
Padrão: vírgula (,). |
|
|
Key-Value Inner Delimiter |
Padrão: dois pontos (:). |
|
|
Execution Tuning |
Number of Cores |
Use em conjunto com Memory per Core. Deve ser um número inteiro positivo. |
|
Memory per Core |
Use em conjunto com Number of Cores. Unidade: MB. |
Método 2: Comando PAI
Execute um comando PAI no componente SQL Script para definir os parâmetros do componente. Para mais informações, consulte SQL Script.
PAI -name cluster_evaluation
    -project algo_public
    -DinputTableName=pai_cluster_evaluation_test_input
    -DselectedColNames=f0,f3
    -DmodelName=pai_kmeans_test_model
-DoutputTableName=pai_ft_cluster_evaluation_out;|
Parâmetro |
Obrigatório |
Descrição |
Padrão |
|
inputTableName |
Sim |
Nome da tabela de entrada. |
Nenhum |
|
selectedColNames |
Não |
Colunas da tabela de entrada a serem avaliadas. Para especificar várias colunas, separe os nomes por vírgulas (,). |
Todas as colunas |
|
inputTablePartitions |
Não |
Partições da tabela de entrada usadas na avaliação. Formatos compatíveis:
Nota
Ao especificar múltiplas partições, separe-as por vírgulas (,). |
Tabela inteira |
|
enableSparse |
Não |
Indica se os dados de entrada estão em formato esparso. Valores válidos: |
false |
|
itemDelimiter |
Não |
Delimitador entre pares chave-valor no formato esparso. |
Vírgula (,). |
|
kvDelimiter |
Não |
Delimitador entre chave e valor no formato esparso. |
Dois pontos (:). |
|
modelName |
Sim |
Modelo de clustering de entrada. |
Nenhum |
|
outputTableName |
Sim |
Tabela de saída. |
Nenhum |
|
lifecycle |
Não |
Ciclo de vida da tabela de saída. |
Nenhum |
Exemplo
-
Gere dados de teste com uma instrução SQL.
create table if not exists pai_cluster_evaluation_test_input as select * from ( select 1 as id, 1 as f0,2 as f3 union all select 2 as id, 1 as f0,3 as f3 union all select 3 as id, 1 as f0,4 as f3 union all select 4 as id, 0 as f0,3 as f3 union all select 5 as id, 0 as f0,4 as f3 )tmp; -
Crie um modelo de clustering usando um comando PAI. Este exemplo utiliza clustering k-means.
PAI -name kmeans -project algo_public -DinputTableName=pai_cluster_evaluation_test_input -DselectedColNames=f0,f3 -DcenterCount=3 -Dloop=10 -Daccuracy=0.00001 -DdistanceType=euclidean -DinitCenterMethod=random -Dseed=1 -DmodelName=pai_kmeans_test_model -DidxTableName=pai_kmeans_test_idx -
Execute o componente de avaliação de modelo de clustering por meio de um comando PAI.
PAI -name cluster_evaluation -project algo_public -DinputTableName=pai_cluster_evaluation_test_input -DselectedColNames=f0,f3 -DmodelName=pai_kmeans_test_model -DoutputTableName=pai_ft_cluster_evaluation_out; -
Visualize a tabela de saída pai_ft_cluster_evaluation_out. Após a execução do componente, a tabela de saída contém um valor
calinharaigual a3, um valorcenterCountigual a3e um valorcountigual a5. A tabela a seguir descreve os campos da tabela de saída.Campo
Descrição
count
Número total de registros.
centerCount
Quantidade de centros de cluster.
calinhara
Índice Calinski-Harabasz.