O EAS verifica automaticamente a capacidade de computação da GPU e a integridade da comunicação entre nós em implantações distribuídas de grande escala.
Escopo de aplicação
Este recurso se aplica aos serviços de inferência distribuída multinó implantados em recursos Lingjun.
Conceitos principais
-
Momento da verificação:
Antes da inicialização da instância: Executado antes da inicialização do aplicativo na instância do serviço (Pod). Detecta problemas de hardware ou de rede para evitar falhas na inicialização.
Durante a execução da instância: Executado como um processo em segundo plano, simultaneamente ao serviço.
-
Item de verificação:
Antes da inicialização da instância: Verificação de desempenho de computação, verificação de comunicação entre nós e verificação cruzada de computação e comunicação.
Durante a execução da instância: Apenas C4D (verificação de integridade da GPU).
Para obter detalhes sobre os itens de verificação, consulte Apêndice: Itens de verificação.
-
Tratamento de estado anormal:
Falha na inicialização da instância: Se o sistema detectar um problema, ele encerra a inicialização da instância atual.
Nenhuma ação: O sistema apenas registra um evento sem executar outras ações.
Procedimento
Ative e configure o monitoramento de computação
Acesse o PAI console. Selecione uma região na parte superior da página. Em seguida, selecione o workspace desejado e clique em Enter Elastic Algorithm Service (EAS).
Clique em Deploy Service. Na seção Custom Model Deployment, clique em Custom Deployment.
-
Na seção Features, em Stability Guarantee, ative Compute monitoring & fault tolerance. No painel exibido, configure os parâmetros de verificação. Para usar um arquivo JSON, consulte Apêndice: Parâmetros de arquivo JSON.
NotaÉ possível adicionar verificações tanto para "Before running" quanto para "Instance running".
-
Configure a verificação pré-execução (opcional):
Momento da verificação: Selecione Before running.
Item de verificação: Selecione os itens de verificação conforme necessário, como Run Compute Performance Check e Run Node Communication Check. Por padrão, GPU GEMM, All-Reduce (single-node) e All-Reduce (between two nodes) estão ativados.
Defina um tempo limite adequado com base nas durações estimadas em Itens de verificação. O sistema executa as verificações em sequência. O tempo limite padrão é de 5 minutos. O sistema trata como falha qualquer verificação que exceda esse tempo.
Tratamento de estado anormal: O padrão é Instance startup failed. Selecione Rebuild Instance com base na sua política de recuperação de desastres.
-
Configure a verificação durante a execução (opcional):
Momento da verificação: Selecione Instance running.
Item de verificação: Apenas o C4D está disponível.
Tratamento de estado anormal: Apenas a opção Ignore está disponível.
-
Visualize resultados da verificação
Após configurar este recurso, visualize os relatórios de verificação de uma das seguintes maneiras:
-
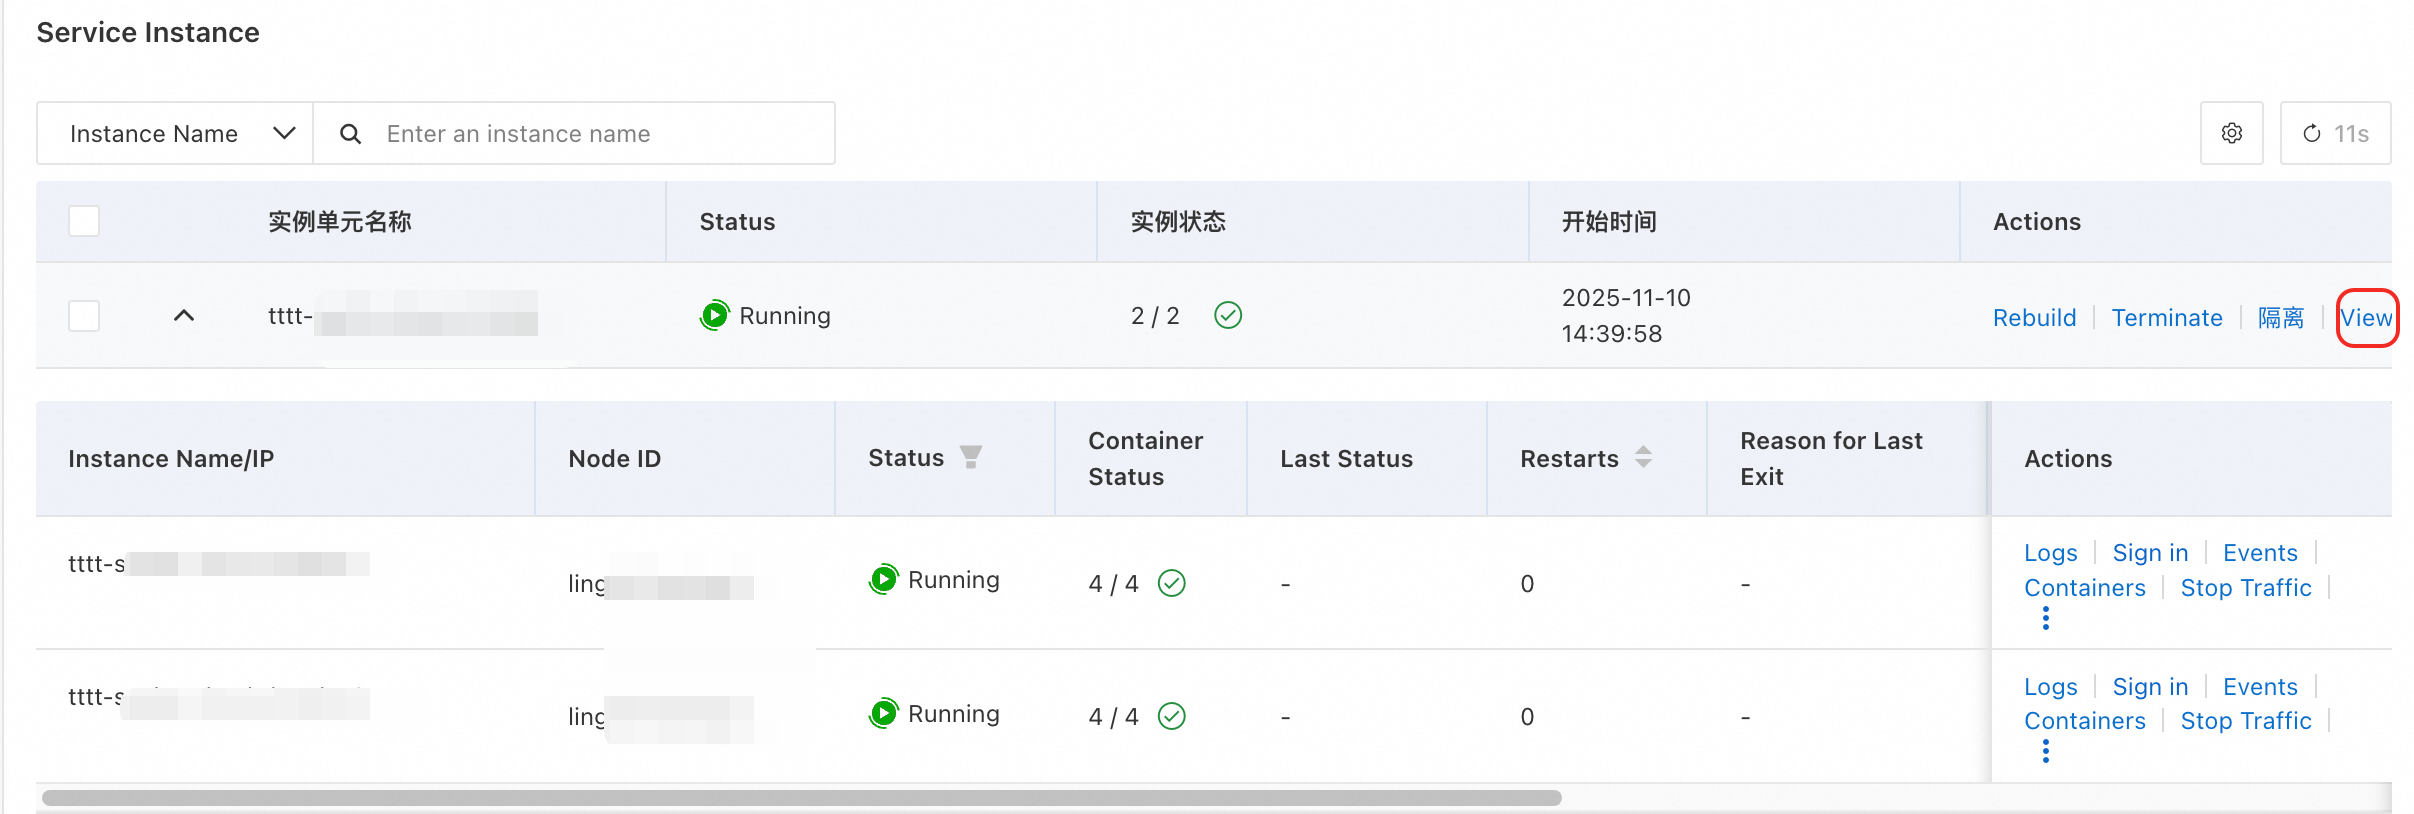
Método 1: Pela lista de instâncias
Na página de detalhes do serviço, acesse a aba Overview.
Em Instância do serviço, localize a instância de destino e clique em View results na coluna Actions.
-
Método 2: Pelos eventos de implantação
Na página de detalhes do serviço, acesse a aba Deployment Events.
Localize um evento do tipo
SanityCheckSucceededouSanityCheckFailede clique em View results na coluna Actions.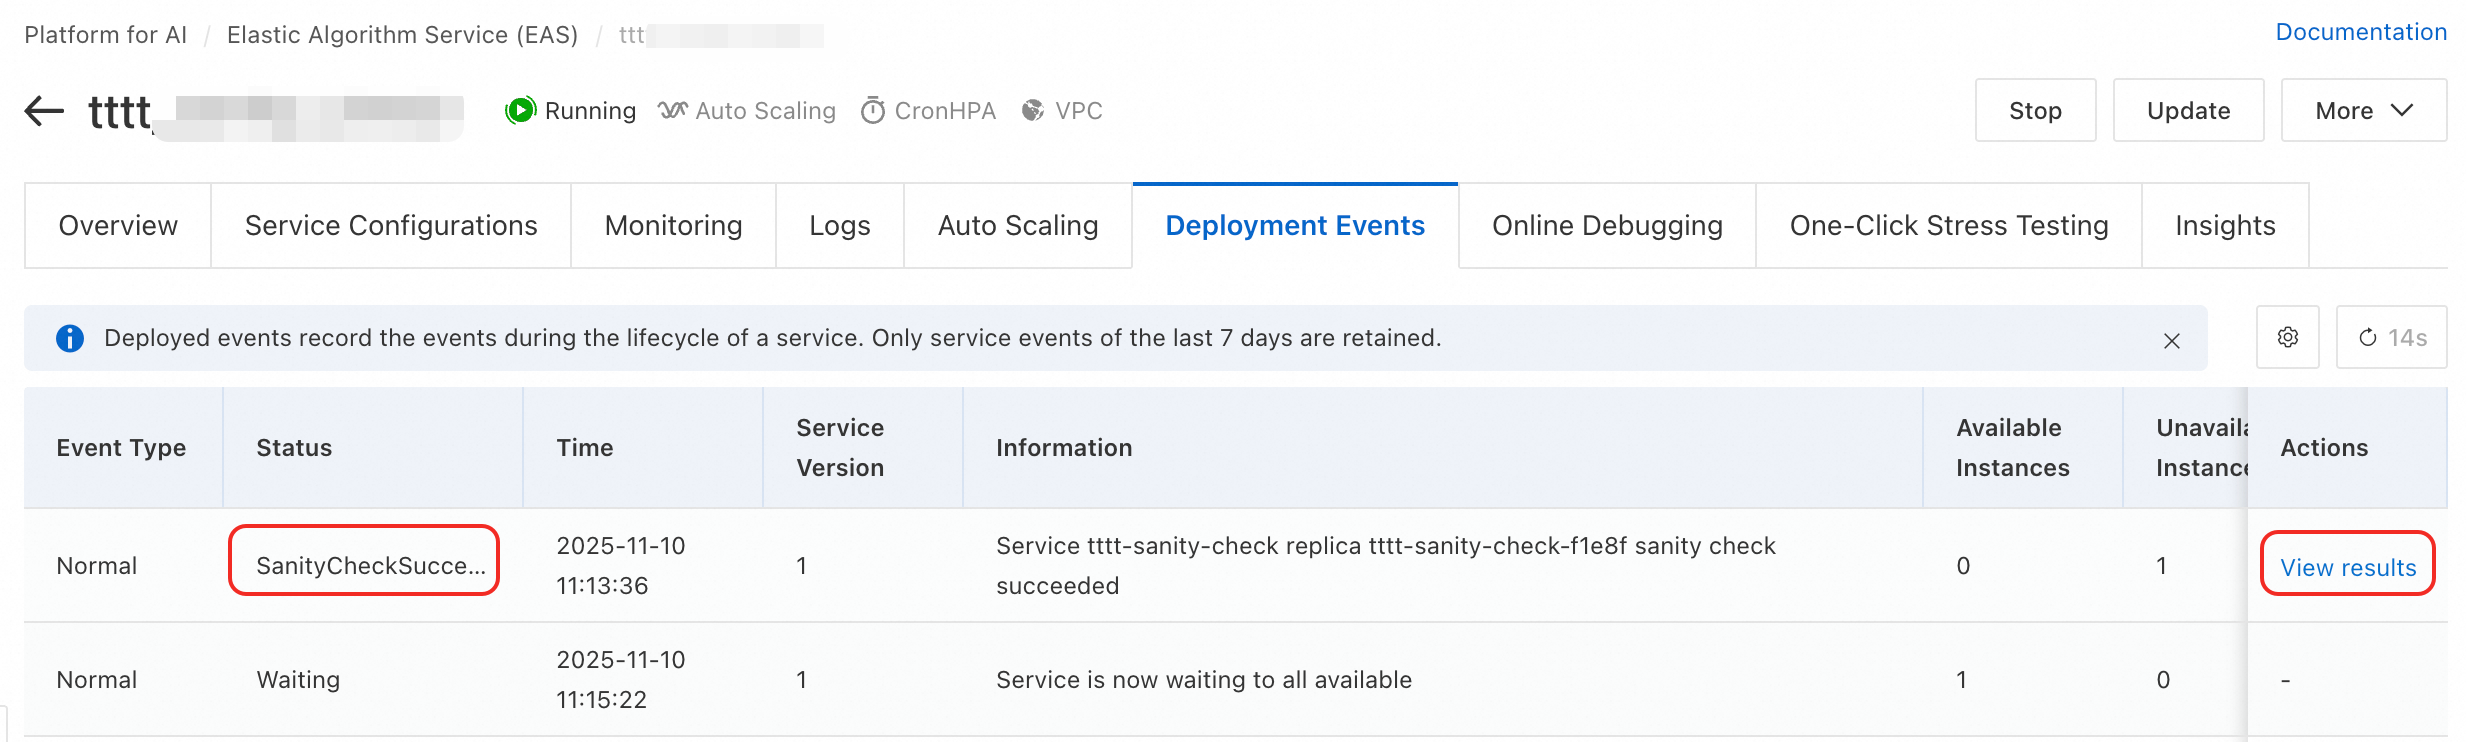
O painel lateral Health check results será exibido. Visualize os relatórios detalhados de cada item de verificação.
FAQ
Quais são as causas comuns para falha na verificação de All-Reduce?
Uma falha na verificação de All-Reduce geralmente indica problemas de comunicação de rede, como alta latência, perda severa de pacotes ou configuração incorreta de Remote Direct Memory Access (RDMA) entre os nós. Use os dados detalhados no relatório para solucionar problemas em nós com comunicação lenta.
Apêndice: Itens de verificação
|
Item de verificação |
Descrição |
Duração estimada |
|
|
Antes da inicialização da instância |
|||
|
Verificação de desempenho de computação |
GPU GEMM |
Verifica o desempenho de GPU GEMM para identificar:
|
1 minuto |
|
GPU Kernel Launch |
Verifica a latência de inicialização do kernel da GPU para identificar:
|
1 minuto |
|
|
Verificação de comunicação entre nós |
All-Reduce |
Verifica o desempenho da comunicação entre nós em diferentes padrões para identificar:
|
Por verificação de comunicação coletiva: 5 minutos |
|
All-to-All |
|||
|
All-Gather |
|||
|
Multi-All-Reduce |
|||
|
PyTorch-Gloo |
Verifica a comunicação entre nós por meio do PyTorch Gloo para identificar nós com defeito. |
1 minuto |
|
|
Conectividade de rede |
Verifica a conectividade de rede dos nós head ou tail para identificar problemas de conectividade. |
2 minutos |
|
|
Verificação cruzada de computação e comunicação |
MatMul/All-Reduce Overlap |
Verifica o desempenho de nó único quando os kernels de comunicação e computação se sobrepõem para identificar:
|
1 minuto |
|
Durante a execução da instância |
|||
|
C4D |
Verifica a integridade da GPU durante a execução da instância. |
||
Apêndice: Parâmetros de arquivo JSON
Exemplo de configuração
{
    "aimaster": {
        "runtime_check": {
            "fail_action": "retain",
            "micro_benchmarks": "c4d"
        },
        "sanity_check": {
            "fail_action": "retain",
            "micro_benchmarks": "gemm_flops,all_reduce_1,all_reduce_2,kernel_launch,all_reduce,all_to_all_2,all_gather_2,all_gather,multi_all_reduce_2,multi_all_reduce,pytorch_gloo_2,network_connectivity,comp_comm_overlap",
            "timeout": 100
        }
    }
}
Parâmetros
|
Parâmetro |
Descrição |
||
|
aimaster |
runtime_check Verificações executadas durante a execução da instância. |
fail_action |
Ação a ser executada quando um estado anormal for detectado. |
|
micro_benchmarks |
Item de verificação. Valor válido: C4D. |
||
|
sanity_check Verificações executadas antes da inicialização da instância. |
fail_action |
Ação a ser executada quando um estado anormal for detectado. |
|
|
micro_benchmarks |
Itens de verificação. Separe vários itens com vírgulas. |
||
|
timeout |
Duração máxima da verificação, em minutos. |
||