O AIMaster aumenta a estabilidade e a continuidade de jobs distribuídos de deep learning em grande escala. Ele resolve problemas como exceções de software e hardware, travamentos de jobs e falhas de instâncias por meio de monitoramento de jobs, decisões de tolerância a falhas e controle de recursos.
Contexto
O deep learning é amplamente utilizado. À medida que os modelos e os dados crescem, o treinamento distribuído se torna uma prática comum. Com o aumento do número de instâncias de jobs, exceções de software e hardware podem causar falhas nos jobs.
Para garantir a operação estável de jobs distribuídos de deep learning em grande escala, o DLC oferece um recurso de monitoramento de tolerância a falhas baseado no AIMaster. O AIMaster é um componente no nível do job. Ao ativar esse recurso, uma instância do AIMaster é executada junto com as outras instâncias do seu job para fornecer monitoramento, decisões de tolerância a falhas e controle de recursos.
Limitações
Atualmente, o AIMaster suporta os seguintes frameworks: PyTorch, MPI, TensorFlow e ElasticBatch.
Etapa 1: Ativar o monitoramento de tolerância a falhas
É possível ativar o recurso de monitoramento de tolerância a falhas no console ou usando um SDK ao enviar um job de treinamento do DLC.
No console
Ao enviar um job de treinamento do DLC no console, acesse a seção Fault Tolerance and Diagnosis, ative a chave Automatic Fault Tolerance e configure parâmetros adicionais. Para mais informações, consulte Create a training job. O DLC inicia então uma função extra do AIMaster para monitorar o job durante todo o seu ciclo de vida e executar a tolerância a falhas quando ocorrerem erros.

Detalhes:
Configure parâmetros adicionais na caixa de texto Other Cofiguration. Para detalhes sobre os parâmetros, consulte Appendix: Fault tolerance parameters.
-
Após ativar o Hanging Detection, você pode habilitar o recurso C4D Detection. O C4D (Calibrating Collective Communication over Converged ethernet - Diagnosis) é uma ferramenta de diagnóstico desenvolvida pela Alibaba Cloud para identificar jobs lentos ou travados no treinamento de modelos grandes. Para mais informações, consulte Use C4D.
NotaO C4D depende da ACCL (biblioteca de comunicação coletiva de alto desempenho da Alibaba Cloud). Certifique-se de que a ACCL esteja instalada. Para mais informações, consulte ACCL: Alibaba Cloud high-performance collective communication library.
Atualmente, a detecção C4D está disponível para jobs do DLC que utilizam o Lingjun AI Computing Service.
Depois de ativar o Hanging Detection, utilize a ferramenta de análise de snapshot da pilha de chamadas de função para localizar a linha exata do código onde ocorre o travamento do job. É necessário configurar o limiar de detecção de travamento para que essa ferramenta funcione corretamente. Para mais informações, consulte "Use the function call stack snapshot analysis tool".
Via the DLC SDK
Etapa 2: Configurar recursos avançados
Escolha entre os seguintes recursos avançados conforme suas necessidades de monitoramento.
Configurar notificações de tolerância a falhas
Após ativar o monitoramento de tolerância a falhas para um job, configure as notificações para eventos de tolerância a falhas. Na página Workspace Details, escolha Configure Workspace > Configure Event Notification. Em seguida, clique em Create Event Rule e defina o tipo de evento como DLC task > Automatic Fault Tolerance. Para mais informações, consulte Workspace Event Center.
Quando um job de treinamento encontra uma exceção, como perda NaN, use o SDK do AIMaster no seu código para enviar uma mensagem de notificação personalizada:
Para usar este recurso, instale o pacote wheel do AIMaster. Para mais informações, consulte FAQ.
from aimaster import job_monitor as jm

job_monitor_client = jm.Monitor(config=jm.PyTorchConfig())

...

if loss == Nan and rank == 0:
  st = job_monitor_client.send_custom_message(content="The training loss of the job is NaN.")
  if not st.ok():
      print('failed to send message, error %s' % st.to_string())
Configurar palavras-chave personalizadas de erros repetíveis
O monitoramento de tolerância a falhas inclui detecção integrada para erros repetíveis comuns. Caso deseje que o AIMaster execute a tolerância a falhas quando palavras-chave específicas aparecerem nos logs de uma instância com falha, configure-as no seu código. Após a configuração, o módulo de monitoramento verifica o final do log da instância com falha em busca dessas palavras-chave.
A política de tolerância a falhas deve estar definida como ExitCodeAndErrorMsg.
-
Exemplo de configuração de palavras-chave personalizadas de erros repetíveis para um job PyTorch
from aimaster import job_monitor as jm

jm_config_params = {}
jm_config = jm.PyTorchConfig(**jm_config_params)
monitor = jm.Monitor(config=jm_config)
monitor.set_retryable_errors(["connect timeout", "error_yyy", "error_zzz"])
Os parâmetros configurados em monitor.set_retryable_errors correspondem às palavras-chave personalizadas de erros repetíveis.
-
Exemplo de configuração de palavras-chave personalizadas de erros repetíveis para um job TensorFlow
from aimaster import job_monitor as jm

jm_config_params = {}
jm_config = jm.TFConfig(**jm_config_params)
monitor = jm.Monitor(config=jm_config)
monitor.set_retryable_errors(["connect timeout", "error_yyy", "error_zzz"])
Configurar detecção de travamento de job por etapas
Por padrão, a configuração de detecção de travamento aplica-se a todo o job. No entanto, os jobs frequentemente são executados em etapas distintas. Por exemplo, a comunicação entre nós durante a inicialização pode levar mais tempo do que durante a fase de treinamento, onde os logs são atualizados com maior frequência. Para detectar rapidamente um travamento de job durante o processo de treinamento, o DLC oferece um recurso de detecção de travamento por etapas. Isso permite configurar intervalos diferentes de detecção de travamento para diferentes fases do job. Configure da seguinte forma:
monitor.reset_config(jm_config_params)

# Example:
#     monitor.reset_config(job_hang_interval=10)
#     or
#     config_params = {"job_hang_interval": 10, }
#     monitor.reset_config(**config_params)
Abaixo está um exemplo de detecção de travamento por etapas para um job PyTorch.
import torch
import torch.distributed as dist
from aimaster import job_monitor as jm

jm_config_params = {
    "job_hang_interval": 1800 # Global 30-minute detection.
}
jm_config = jm.PyTorchConfig(**jm_config_params)
monitor = jm.Monitor(config=jm_config)

dist.init_process_group('nccl')

...

# impl these two funcs in aimaster sdk
# user just need to add annotations to their func
def reset_hang_detect(hang_seconds):
    jm_config_params = {
        "job_hang_interval": hang_seconds
    }
    monitor.reset_config(**jm_config_params)

def hang_detect(interval):
    reset_hang_detect(interval)
    ...

@hang_detect(180) # Reset hang detection to 3 minutes, for this function's scope only.
def train():
    ...

@hang_detect(-1) # Disable hang detection temporarily, for this function's scope only.
def test():
    ...

for epoch in range(0, 100):
    train(epoch)
    test(epoch)
    self.scheduler.step()
Usar o C4D
O C4D (Calibrating Collective Communication over Converged ethernet - Diagnosis) é uma ferramenta desenvolvida pela Alibaba Cloud para diagnosticar jobs lentos ou travados no treinamento de modelos grandes. O C4D depende da biblioteca de comunicação coletiva de alto desempenho da Alibaba Cloud (ACCL). Certifique-se de que a ACCL esteja instalada e que as variáveis de ambiente estejam configuradas corretamente. Para mais informações, consulte ACCL: Alibaba Cloud high-performance collective communication library. Atualmente, é possível usar o recurso de detecção C4D ao selecionar o Lingjun AI Computing Service para um job do DLC.
Visão geral do recurso
O C4D agrega informações de status de todos os nós em um job para determinar se algum nó apresenta problemas na camada de comunicação ou em outra área.

Todos os parâmetros
Após ativar o recurso de detecção C4D, configure os seguintes parâmetros na caixa de texto Other Configurations:
Parâmetro | Descrição | Valor de exemplo |
--c4d-log-level | Define o nível de log de saída do C4D. Valores válidos:
O valor padrão é Warning, que gera logs nos níveis Warning e Error. Recomendamos usar o valor padrão para operação normal. Para solucionar problemas de desempenho, defina o nível como Info. |
|
--c4d-common-envs | Define as variáveis de ambiente para execução do C4D. O formato é
|
|
Para logs de nível de erro, o AIMaster isola automaticamente o nó correspondente e reinicia o job. A lógica de tratamento para cada nível de log é a seguinte:
Nível de erro | Descrição | Ações |
Error | Por padrão, um travamento de job na camada de comunicação que exceda três minutos causa a falha do job. Você pode modificar esse padrão configurando os parâmetros C4D_HANG_TIMEOUT e C4D_HANG_TIMES. | O AIMaster isola automaticamente o nó relatado no log. |
Warning | Por padrão, um travamento de job na camada de comunicação que exceda 10 segundos afeta o desempenho, mas não causa a falha do job. Você pode modificar esse padrão configurando o parâmetro C4D_HANG_TIMEOUT. | Sem isolamento automático de nó. Confirmação manual necessária. |
Um travamento de job fora da camada de comunicação que exceda 10 segundos pode causar a falha do job. | Sem isolamento automático de nó. Confirmação manual necessária. | |
Info | Lentidão na camada de comunicação e fora dela. | Esses logs de diagnóstico destinam-se principalmente a problemas de desempenho e exigem confirmação manual. |
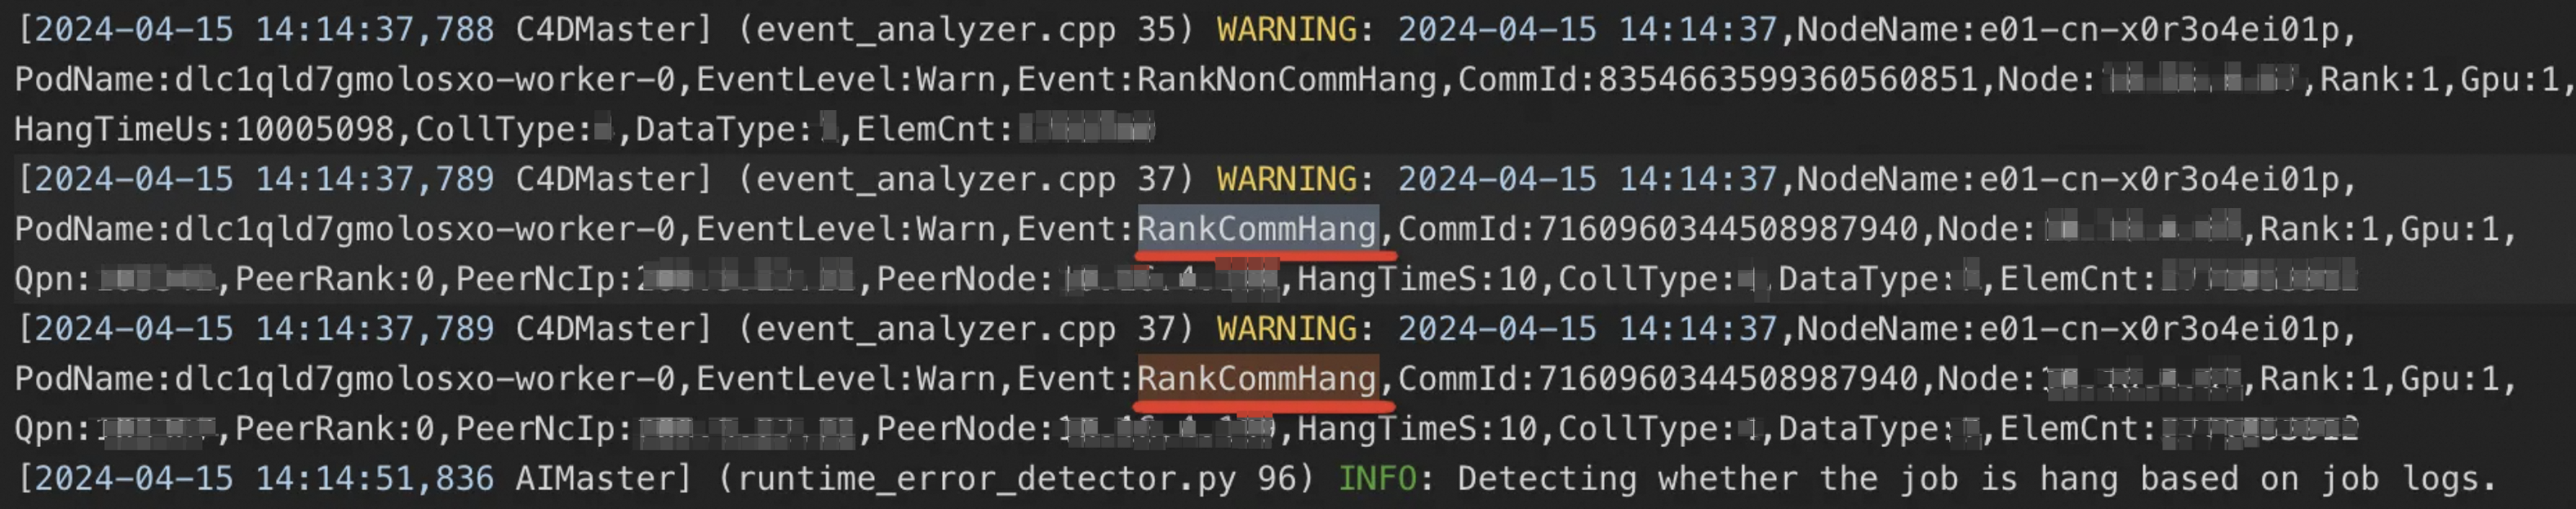
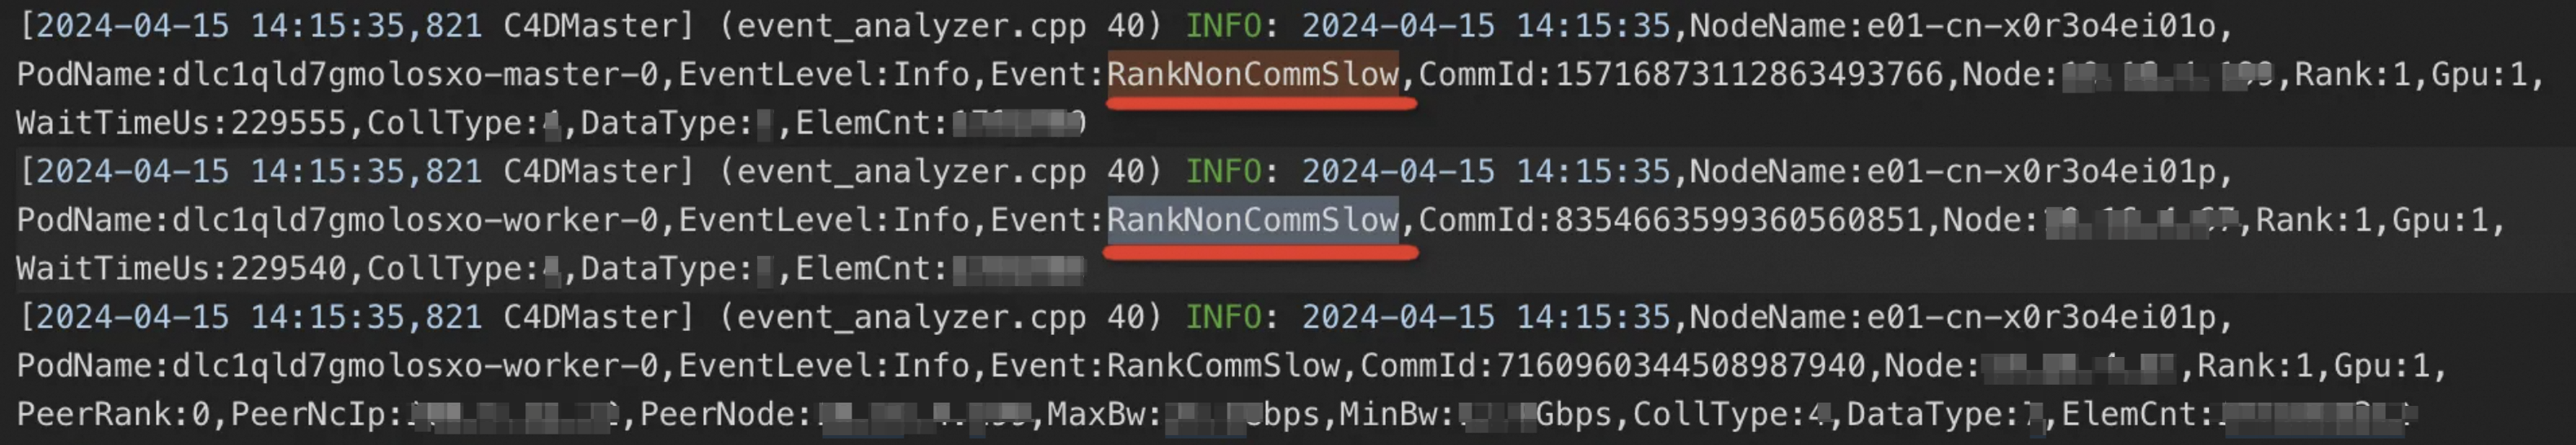
Se você notar que um job do DLC está lento ou travado, acesse a lista de jobs do DLC e clique em nome do job para abrir a página de visão geral do job. Na seção Instances, visualize o log do nó AIMaster para ver os resultados do diagnóstico C4D. Para mais informações sobre os resultados do diagnóstico, consulte Diagnostic result examples.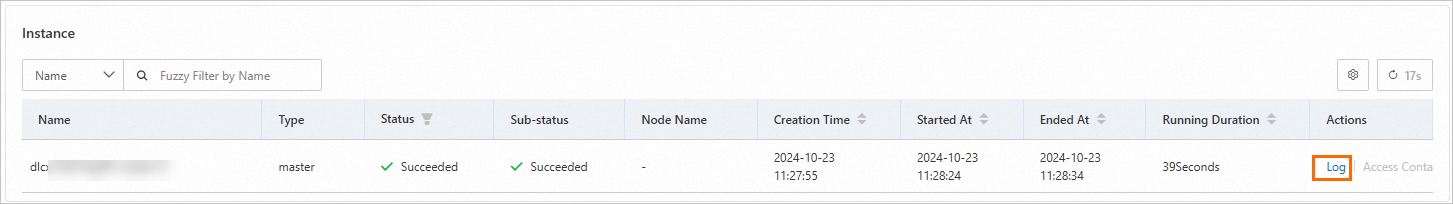
Exemplos de resultados de diagnóstico
RankCommHang: indica que um nó tem um travamento na camada de comunicação.
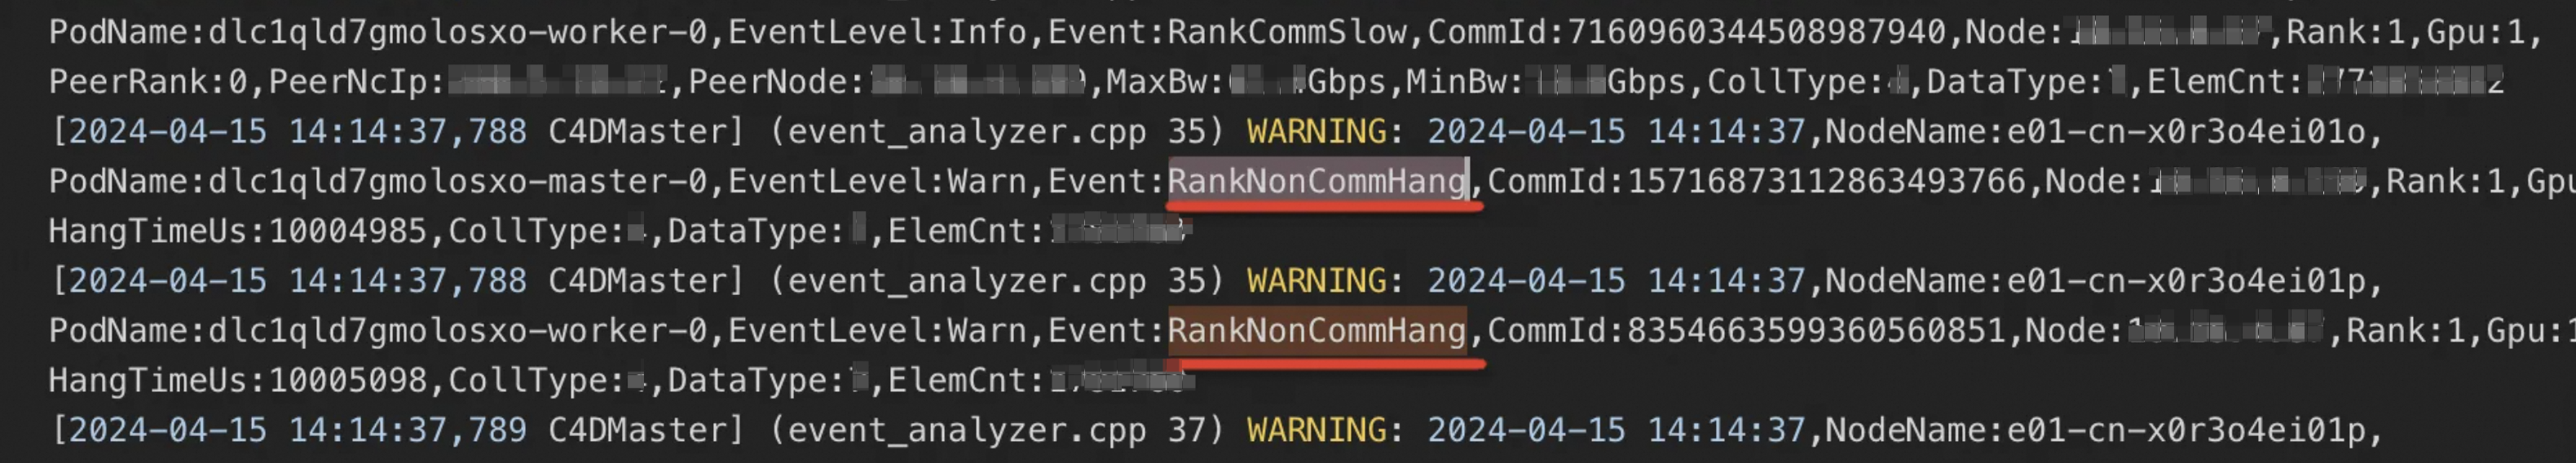
RankNonCommHang: indica que um nó tem um travamento fora da camada de comunicação, como um travamento no processo de computação.
RankCommSlow: indica que um nó está lento na camada de comunicação.
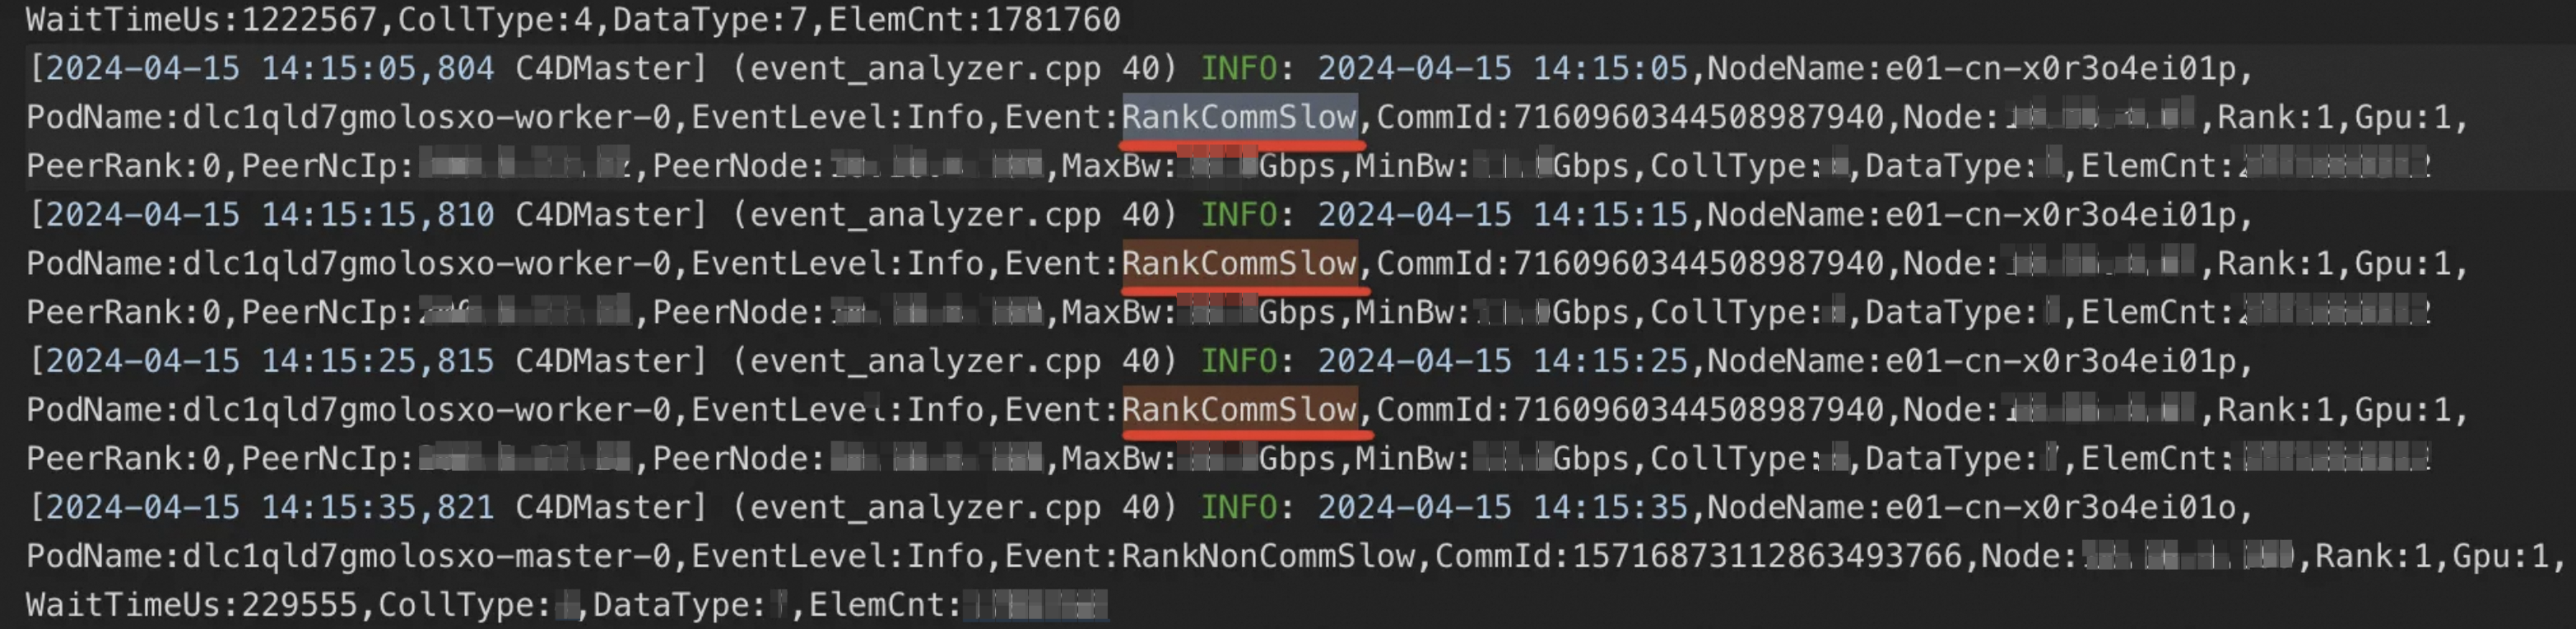
RankNonCommSlow: indica que um nó está lento fora da camada de comunicação.
Analisar snapshots da pilha de chamadas
Uma falha comum no treinamento de modelos grandes é o travamento do job. Um tipo frequente é o travamento NCCL, que geralmente gera uma entrada de log como "Watchdog caught collective operation timeout". Para ajudar você a identificar rapidamente a causa raiz dos travamentos de job, desenvolvemos a ferramenta de análise de snapshot da pilha de chamadas de função. Siga estas etapas para usá-la:
Etapa 1: Instalar pystack ou py-spy
Primeiro, confirme se o pystack ou py-spy está instalado na imagem do seu contêiner. Caso contrário, instale um deles. Por exemplo, use o seguinte comando para instalar o pystack:
pip install pystack -i https://mirrors.cloud.aliyuncs.com/pypi/simple/ --trusted-host mirrors.cloud.aliyuncs.comEtapa 2: Ativar a detecção de travamento
Para obter instruções sobre como ativar a detecção de travamento, consulte In the console. Para que a ferramenta de análise de snapshot da pilha de chamadas de função funcione corretamente, também é necessário definir um valor apropriado para o limiar de detecção de travamento. Primeiro, determine o valor de timeout para o seu job de modelo. Geralmente, você pode encontrar isso no log de erros após um travamento do job. Por exemplo:
Watchdog caught collective operation timeout: WorkNCCL(SeqNum=2143, OpType=ALLREDUCE, NumelIn=659, NumelOut=659, Timeout(ms)=600000) ran for 600535 milliseconds before timing outNo campo Timeout deste log de erro, é possível ver que o timeout do job é de 600.000 milissegundos (600 segundos ou 10 minutos). Nesse caso, recomendamos definir o limiar de detecção de travamento como 450 segundos. Se o valor de Timeout no seu log for 1.800 segundos, recomendamos definir o limiar como 1.500 segundos. Como regra geral, o limiar de detecção de travamento deve ser cerca de 150 a 200 segundos menor que o valor de timeout do job.
Após configurar corretamente a detecção de travamento, o AIMaster coleta e analisa automaticamente a pilha de chamadas de função do processo do job quando ocorre um travamento. Visualize o resultado da análise no log do nó AIMaster. Abaixo está um exemplo de resultado de análise da ferramenta após um travamento de job:

No resultado da análise, o campo stack mostra a pilha de chamadas de função, o campo threads lista as threads onde essa pilha ocorreu, e o campo count indica o número de threads com essa pilha. Pilhas com count igual a 1 têm alta probabilidade de serem a causa do travamento do job e devem ser investigadas primeiro.
Etapa 3: Visualizar motivos de reinício
-
Visualizar rodadas de reinício: As informações de reinício do job são organizadas por rodada. Na página de detalhes do job, expanda os detalhes de uma rodada para visualizar informações como o tempo gasto em cada etapa. Isso ajuda a entender o status de execução do job com mais precisão.

-
Visualizar histórico de reinícios: Clique em Restart records ou na aba Restart records para visualizar informações relevantes sobre o reinício, incluindo o motivo, o resultado e a duração.

Procedimento:
Na lista Restart records, clique em Description para visualizar informações detalhadas de um reinício específico, incluindo Restarts, Restart Time, Node Name, Instance Name, Error Code, Error Message e Error Source.
-
Clique em View Aggregation Fault Details para expandir a lista completa de detalhes de todos os registros de reinício.

Apêndice: Parâmetros de tolerância a falhas
Esta seção descreve todos os parâmetros do recurso de monitoramento de tolerância a falhas. Consulte os exemplos comuns de configuração de parâmetros para planejar suas definições. Ao ativar o monitoramento de tolerância a falhas, configure esses parâmetros na seção Other Cofiguration conforme necessário.
Todos os parâmetros
Configuração geral
Recurso | Parâmetro | Descrição | Padrão |
Modo de execução do job | --job-execution-mode | O modo de execução do job. Valores válidos:
O comportamento de tolerância a falhas difere por tipo de job para erros repetíveis:
| Sync |
Configurações de reinício do job | --enable-job-restart | Especifica se o job pode ser reiniciado quando as condições de tolerância a falhas forem atendidas ou uma exceção de runtime for detectada. Valores válidos:
| False |
--max-num-of-job-restart | O número máximo de vezes que o job pode ser reiniciado. Se esse número for excedido, o job falhará. | 3 |
Configuração de runtime
Aplica-se a cenários onde nenhuma instância falhou.
Recurso | Parâmetro | Descrição | Padrão |
Detecção de travamento de job | --enable-job-hang-detection | Especifica se a detecção de travamento em runtime deve ser ativada para o job. Este recurso suporta apenas jobs síncronos. Valores válidos:
| False |
--job-hang-interval | A duração em segundos que um job pode ficar suspenso. Deve ser um número inteiro positivo. Se a duração da suspensão exceder esse valor, o job será considerado anômalo e reiniciará. | 1800 | |
--enable-c4d-hang-detection | Especifica se a detecção C4D deve ser ativada para diagnosticar e localizar rapidamente nós lentos e nós defeituosos que causam travamento do job durante a execução. Nota Este parâmetro só entra em vigor quando o parâmetro --enable-job-hang-detection também estiver ativado. | False | |
Detecção de travamento na saída do job | --enable-job-exit-hang-detection | Especifica se a detecção de travamento durante a saída do job deve ser ativada. Este recurso suporta apenas jobs síncronos. Valores válidos:
| False |
--job-exit-hang-interval | A duração em segundos que um job pode ficar suspenso durante a saída. Deve ser um número inteiro positivo. Se a duração da saída exceder esse valor, o job será considerado anômalo e reiniciará. | 600 |
Configuração de tolerância a falhas
Aplica-se a cenários onde pelo menos uma instância falhou.
Recurso | Parâmetro | Descrição | Padrão |
Política de tolerância a falhas | --fault-tolerant-policy | A política de tolerância a falhas. Valores válidos:
| ExitCodeAndErrorMsg |
Ocorrências máximas do mesmo erro | --max-num-of-same-error | O número máximo de vezes que o mesmo erro pode ocorrer em uma única instância. Se a contagem de erros exceder esse valor, o job falhará. | 10 |
Taxa máxima de falhas tolerada | --max-tolerated-failure-rate | A taxa máxima de falhas tolerada. Se a proporção de instâncias com falha exceder esse valor, o job falhará. O valor padrão de -1 desativa este recurso. Por exemplo, um valor de 0,3 significa que o job falhará se mais de 30% dos workers encontrarem um erro. | -1 |
Exemplos de configuração de parâmetros
Os exemplos a seguir mostram configurações comuns de parâmetros para diferentes jobs de treinamento.
-
Job de treinamento síncrono (comum para jobs PyTorch)
Quando uma instância falha e atende às condições de tolerância a falhas, o job é reiniciado.
--job-execution-mode=Sync --enable-job-restart=True --max-num-of-job-restart=3 --fault-tolerant-policy=ExitCodeAndErrorMsg -
Job de treinamento assíncrono (comum para jobs TensorFlow)
Para erros repetíveis, as instâncias Worker com falha são reiniciadas. Se uma instância PS ou Chief falhar, o job não será reiniciado por padrão. Para ativar reinícios de job, defina --enable-job-restart=True.
--job-execution-mode=Async --fault-tolerant-policy=OnFailure -
Job de inferência offline (comum para jobs ElasticBatch)
As instâncias são independentes, semelhante a um job assíncrono. Quando uma instância falha, apenas essa instância é reiniciada.
--job-execution-mode=Async --fault-tolerant-policy=OnFailure
Perguntas frequentes
P: Como instalo o SDK do AIMaster?
Use o comando correspondente à sua versão do Python para instalar o pacote wheel.
# Python 3.6
pip install -U http://odps-release.cn-hangzhou.oss.aliyun-inc.com/aimaster/pai_aimaster-1.2.1-cp36-cp36m-linux_x86_64.whl

# Python 3.8
pip install -U http://odps-release.cn-hangzhou.oss.aliyun-inc.com/aimaster/pai_aimaster-1.2.1-cp38-cp38-linux_x86_64.whl

# Python 3.10
pip install -U http://odps-release.cn-hangzhou.oss.aliyun-inc.com/aimaster/pai_aimaster-1.2.1-cp310-cp310-linux_x86_64.whl