O recurso de model broadcasting do OSS Connector carrega dados do modelo do OSS em um único nó e os distribui aos demais nós por uma topologia em cadeia. Essa abordagem reduz o tráfego de retorno à origem e acelera a implantação de modelos em múltiplos nós.
Como funciona
Quando vários nós baixam arquivos de modelo do OSS simultaneamente, os downloads concorrentes podem saturar a largura de banda de saída da origem e causar atrasos ou falhas na inicialização. Esse gargalo é particularmente crítico em regiões com menor largura de banda de saída do OSS.
Com o model broadcasting, apenas um ou poucos nós carregam dados diretamente do OSS ao iniciar várias instâncias de inferência. A distribuição ocorre então por uma topologia em cadeia, que aproveita o armazenamento e os recursos de rede dos nós para reduzir o tráfego de retorno à origem e aumentar a eficiência da distribuição.
Os arquivos de modelo são transferidos serialmente de um nó para o próximo; cada nó recebe e encaminha os dados uma única vez. Um único fluxo de dados geralmente satura a largura de banda da rede da maioria dos tipos de instância. A topologia em cadeia evita os gargalos do transporte baseado em árvore, no qual um único nó precisa atender a vários nós downstream.
O OSS Connector pré-carrega os arquivos de modelo em um buffer de memória com downloads de alta concorrência. O mecanismo de inferência carrega o modelo na memória da GPU conforme necessário, e o buffer é liberado após um breve atraso assim que a inferência termina. O model broadcasting estende essa funcionalidade ao compartilhar o buffer entre os nós via DADI P2P, exigindo apenas um serviço Redis ou Tair para descoberta de nós e gerenciamento de metadados. Isso adiciona uma lógica leve de compartilhamento de buffer e aproveita totalmente a largura de banda ociosa dos nós durante o carregamento do modelo.

O model broadcasting extrai apenas um único fluxo de dados do OSS para cada modelo, o que reduz a carga na origem durante inicializações em lote. Se o desempenho da origem continuar sendo um gargalo, combine este recurso com o OSS Accelerator ou a versão de cache distribuído do DADI P2P.
Pré-requisitos
OSS Connector for AI/ML v1.2.0 ou posterior instalado. Melhore a eficiência da implantação de modelos com o OSS Connector for AI/ML.
Instância Redis ou Tair disponível para descoberta de nós e gerenciamento de metadados.
Configure o banco de dados
O model broadcasting requer um serviço Redis ou Tair para descoberta de nós e gerenciamento de metadados.
Opção 1: Adquirir e configurar o Tair (Recomendado)
O Tair é o serviço de banco de dados em nuvem totalmente gerenciado da Alibaba Cloud, compatível com o protocolo Redis.
Crie uma instância Tair (versão 6,0 ou posterior, especificações mínimas). Visão geral do início rápido.
Configure uma lista de permissões para que os nós de inferência possam acessar a instância Tair.
Anote o
Connection Address,Port Number,UsernameePasswordpara usar na configuração do model broadcasting.
Opção 2: Implantar um serviço Redis independente
Também é possível implantar o Redis em um cluster Kubernetes.
O YAML a seguir implanta o Redis com autenticação ACL.
-
Crie um arquivo de configuração ACL e gere um secret do Kubernetes.
# Create ACL content cat > users.acl << EOF user default off -@all user Username on >Password ~* &* +@all EOF # Create a secret kubectl create secret generic redis-acl-secret \ --from-file=users.acl \ --dry-run=client -o yaml | kubectl apply -f -NotaSubstitua
UsernameePasswordpelo nome de usuário e senha reais. -
Aplique o YAML a seguir para implantar o Redis.
# redis-service.yaml apiVersion: v1 kind: Service metadata: name: redis spec: selector: app: model-redis ports: - protocol: TCP port: 6379 targetPort: 6379 --- # redis-deployment.yaml apiVersion: apps/v1 kind: Deployment metadata: name: model-redis-deployment spec: replicas: 1 selector: matchLabels: app: model-redis template: metadata: labels: app: model-redis spec: containers: - name: redis image: mirrors-ssl.aliyuncs.com/redis:8.4.0 ports: - containerPort: 6379 command: ["redis-server"] args: - "--aclfile" - "/etc/redis/users.acl" - "--maxmemory" - "900mb" - "--maxmemory-policy" - "volatile-lru" - "--save" - "" - "--appendonly" - "no" - "--loglevel" - "notice" resources: requests: memory: "1Gi" cpu: "100m" limits: memory: "1Gi" cpu: "200m" volumeMounts: - name: acl-config mountPath: /etc/redis/users.acl subPath: users.acl volumes: - name: acl-config secret: secretName: redis-acl-secret -
Implante o serviço Redis.
kubectl apply -f redis-service.yaml
Ative o model broadcasting
Adicione a configuração de model broadcasting ao arquivo de configuração do OSS Connector em /etc/oss-connector/config.json.
{
  ...
  "broadcast": {
    "enableBroadcast": true,
    "tenant": "${P2P_KEY_PREFIX}",
    "db": {
      "host": "${P2P_REDIS_HOST}",
      "port": 6379,
      "username": "${P2P_REDIS_USERNAME}",
      "password": "${P2P_REDIS_PASSWD}"
    }
  },
  "bindPort": 19898
  ...
}
Parâmetros de configuração:
|
Parâmetro |
Descrição |
|
broadcast.enableBroadcast |
Ativa o model broadcasting. Defina como |
|
broadcast.tenant |
Nome do tenant. Nós com o mesmo tenant compartilham o model broadcasting. Use um tenant exclusivo por serviço. |
|
broadcast.db.host |
Endereço de conexão do serviço Redis ou Tair. |
|
broadcast.db.port |
Porta do serviço Redis ou Tair. Padrão: 6379. |
|
broadcast.db.username |
Nome de usuário do serviço Redis ou Tair. |
|
broadcast.db.password |
Senha do serviço Redis ou Tair. |
|
bindPort |
Porta para fornecer dados a outros nós. Padrão: 19898. |
O model broadcasting oferece suporte a implantações Kubernetes com múltiplas instâncias. Implante um serviço de model broadcasting com múltiplas instâncias.
Limite o tamanho do cache
Durante a transmissão, os nós armazenam dados do modelo em cache na memória para outros nós. Limite esse tamanho de cache das seguintes formas:
-
Método 1: Definir uma variável de ambiente
export CONNECTOR_MAX_CACHE_ADVISE_GB=100 -
Método 2: Definir no arquivo de configuração
Defina
prefetch.maxCacheAdviseGBem/etc/oss-connector/config.json:{ ... "prefetch": { "vcpus": 16, "workers": 24, "maxCacheAdviseGB": 100 }, ... }
O limite de memória é flexível (soft limit).
As variáveis de ambiente têm precedência sobre o arquivo de configuração.
Relatório de desempenho
Resultados dos testes de desempenho do model broadcasting com o modelo Qwen2.5-72B (135.437 GB) em diferentes regiões.
Teste na região de Pequim
Ambiente de teste
|
Item |
Configuração |
|
OSS |
China (Pequim), largura de banda de download pela intranet de 250 Gbps |
|
Configuração do nó |
ecs.g9i.24xlarge, rede de 32/48 Gbps (pico), 96 vCPUs, 384 GiB |
|
Modelo |
Qwen2.5-72B, 135.437 GB |
|
Métricas |
Tempo desde a inicialização do servidor de API vLLM até a disponibilidade do serviço, além do tráfego OSS e P2P. |
Tamanho de cache ilimitado
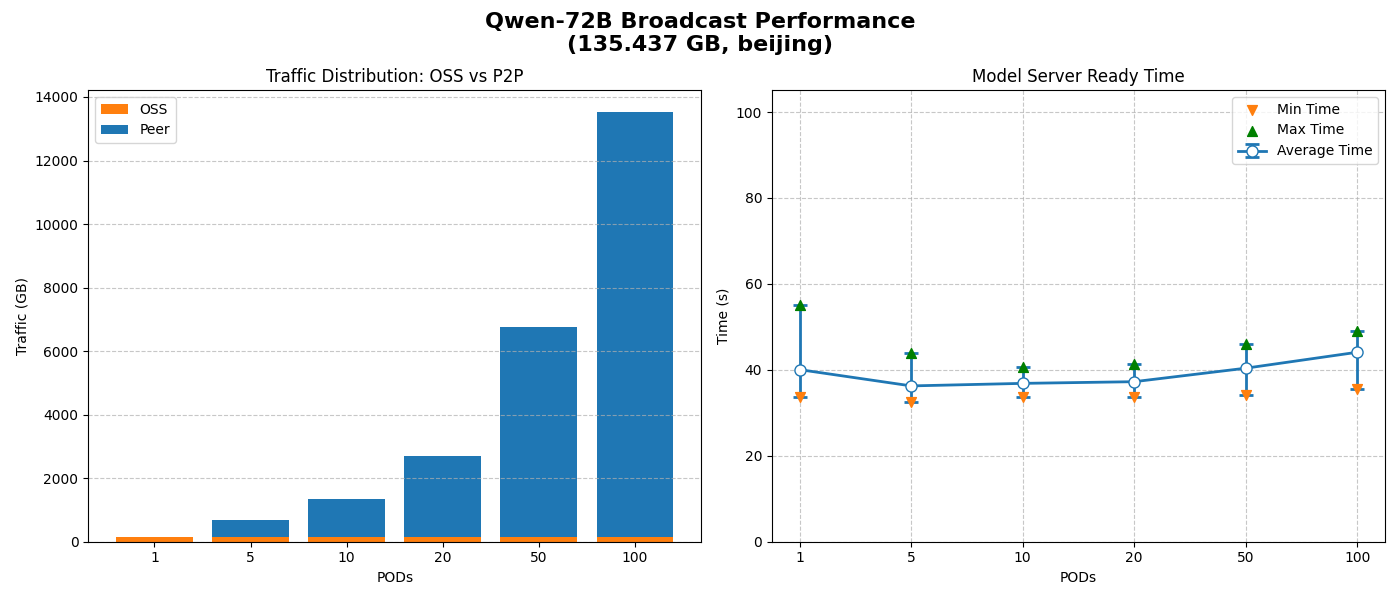
Apenas um fluxo de retorno à origem é utilizado; todos os outros dados são transferidos via P2P, minimizando a pressão sobre a largura de banda do OSS.
O tempo médio para disponibilização do modelo permanece próximo de O(1), independentemente do número de nós, demonstrando excelente escalabilidade horizontal.
Tamanho de cache limitado
O tempo de disponibilização do modelo foi testado para 1, 10, 50 e 100 nós iniciando simultaneamente, com o tamanho de cache ilimitado e limitado a 100, 60, 40, 20 e 0 GB.
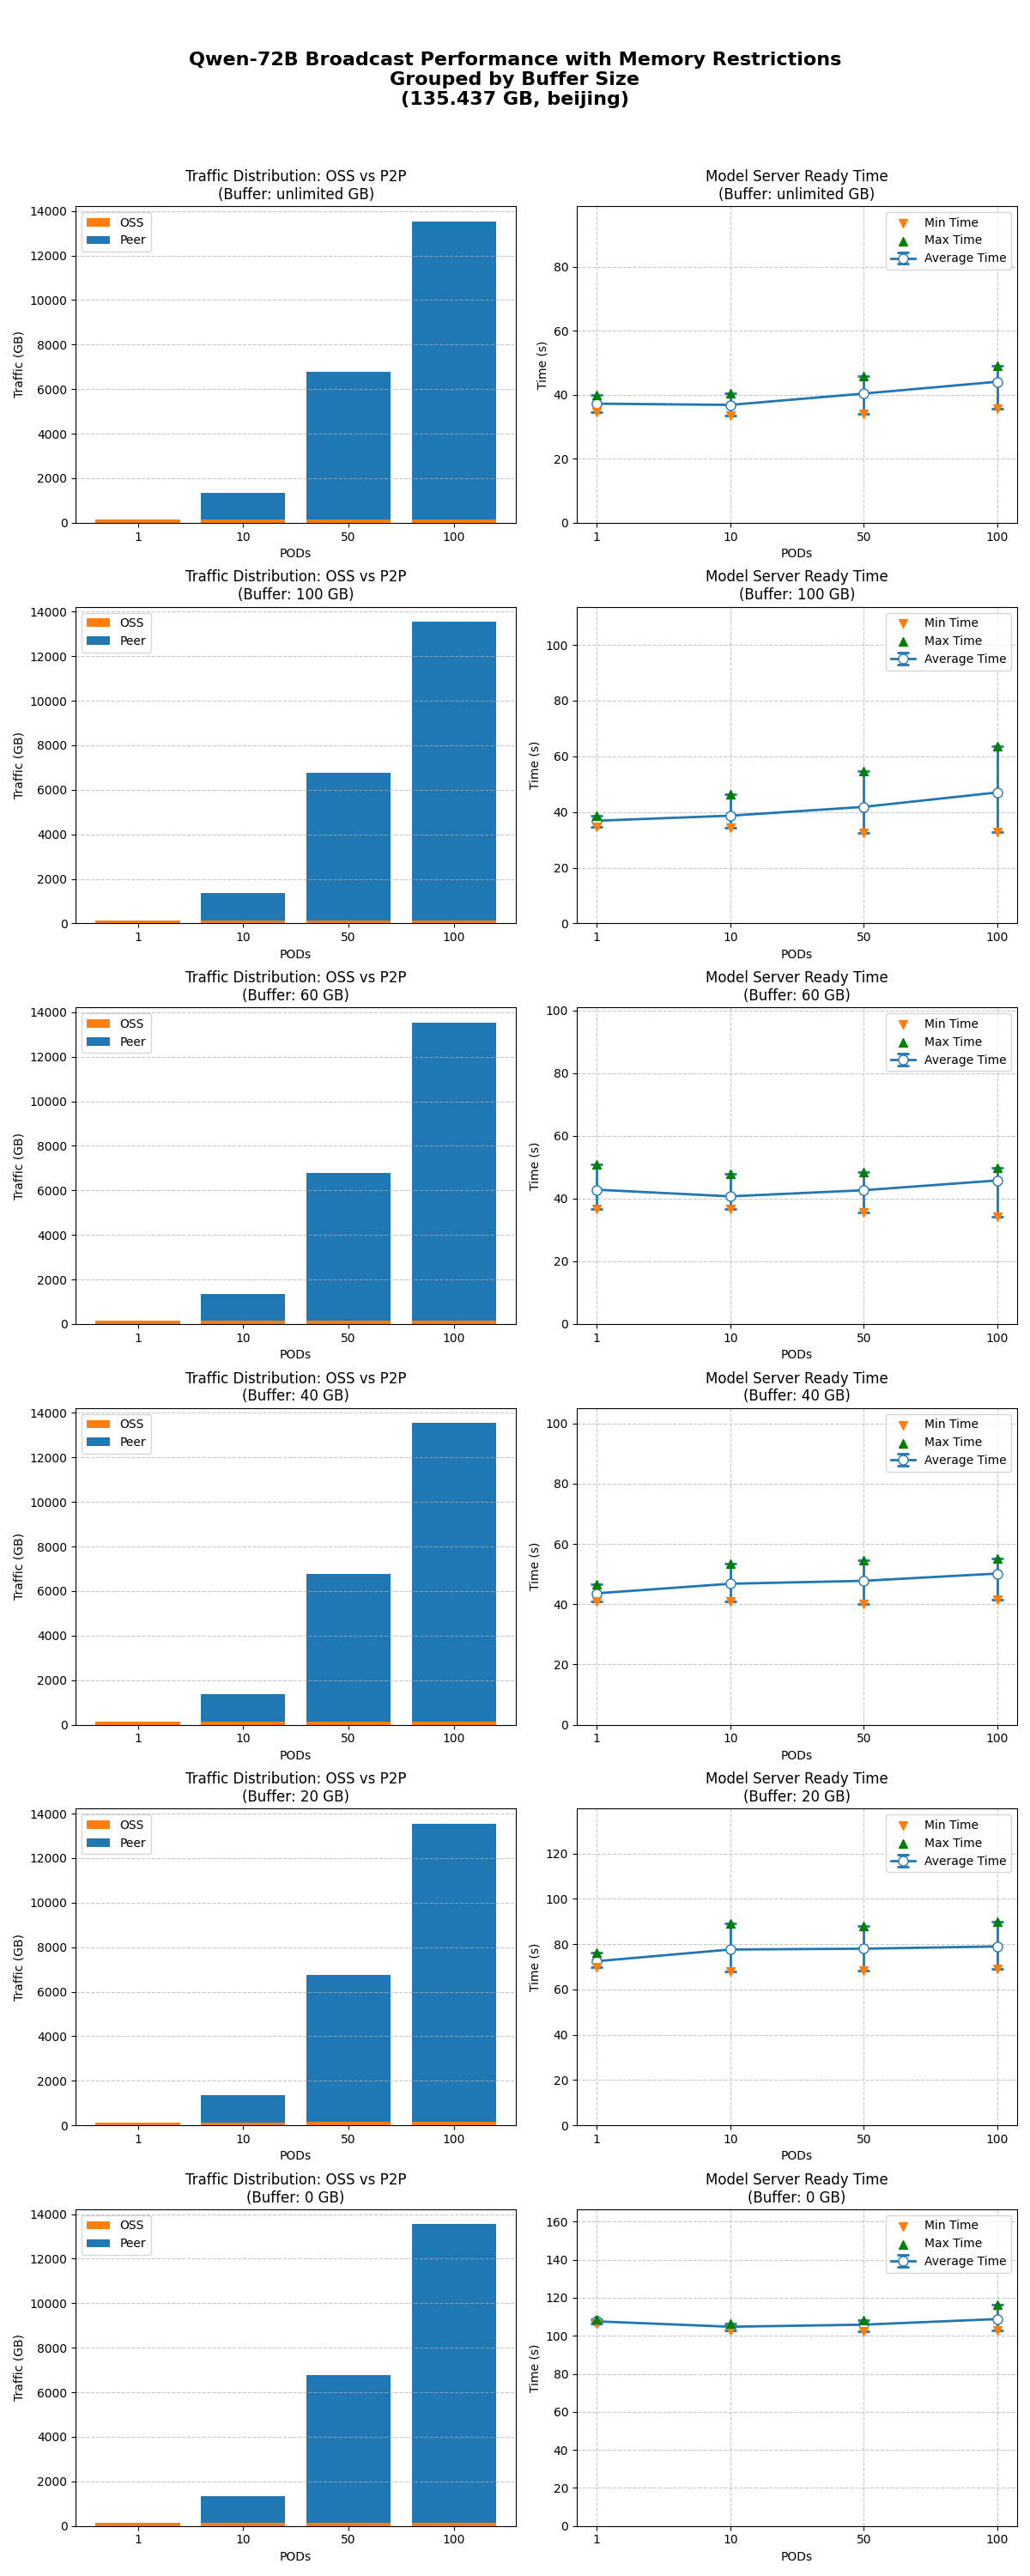
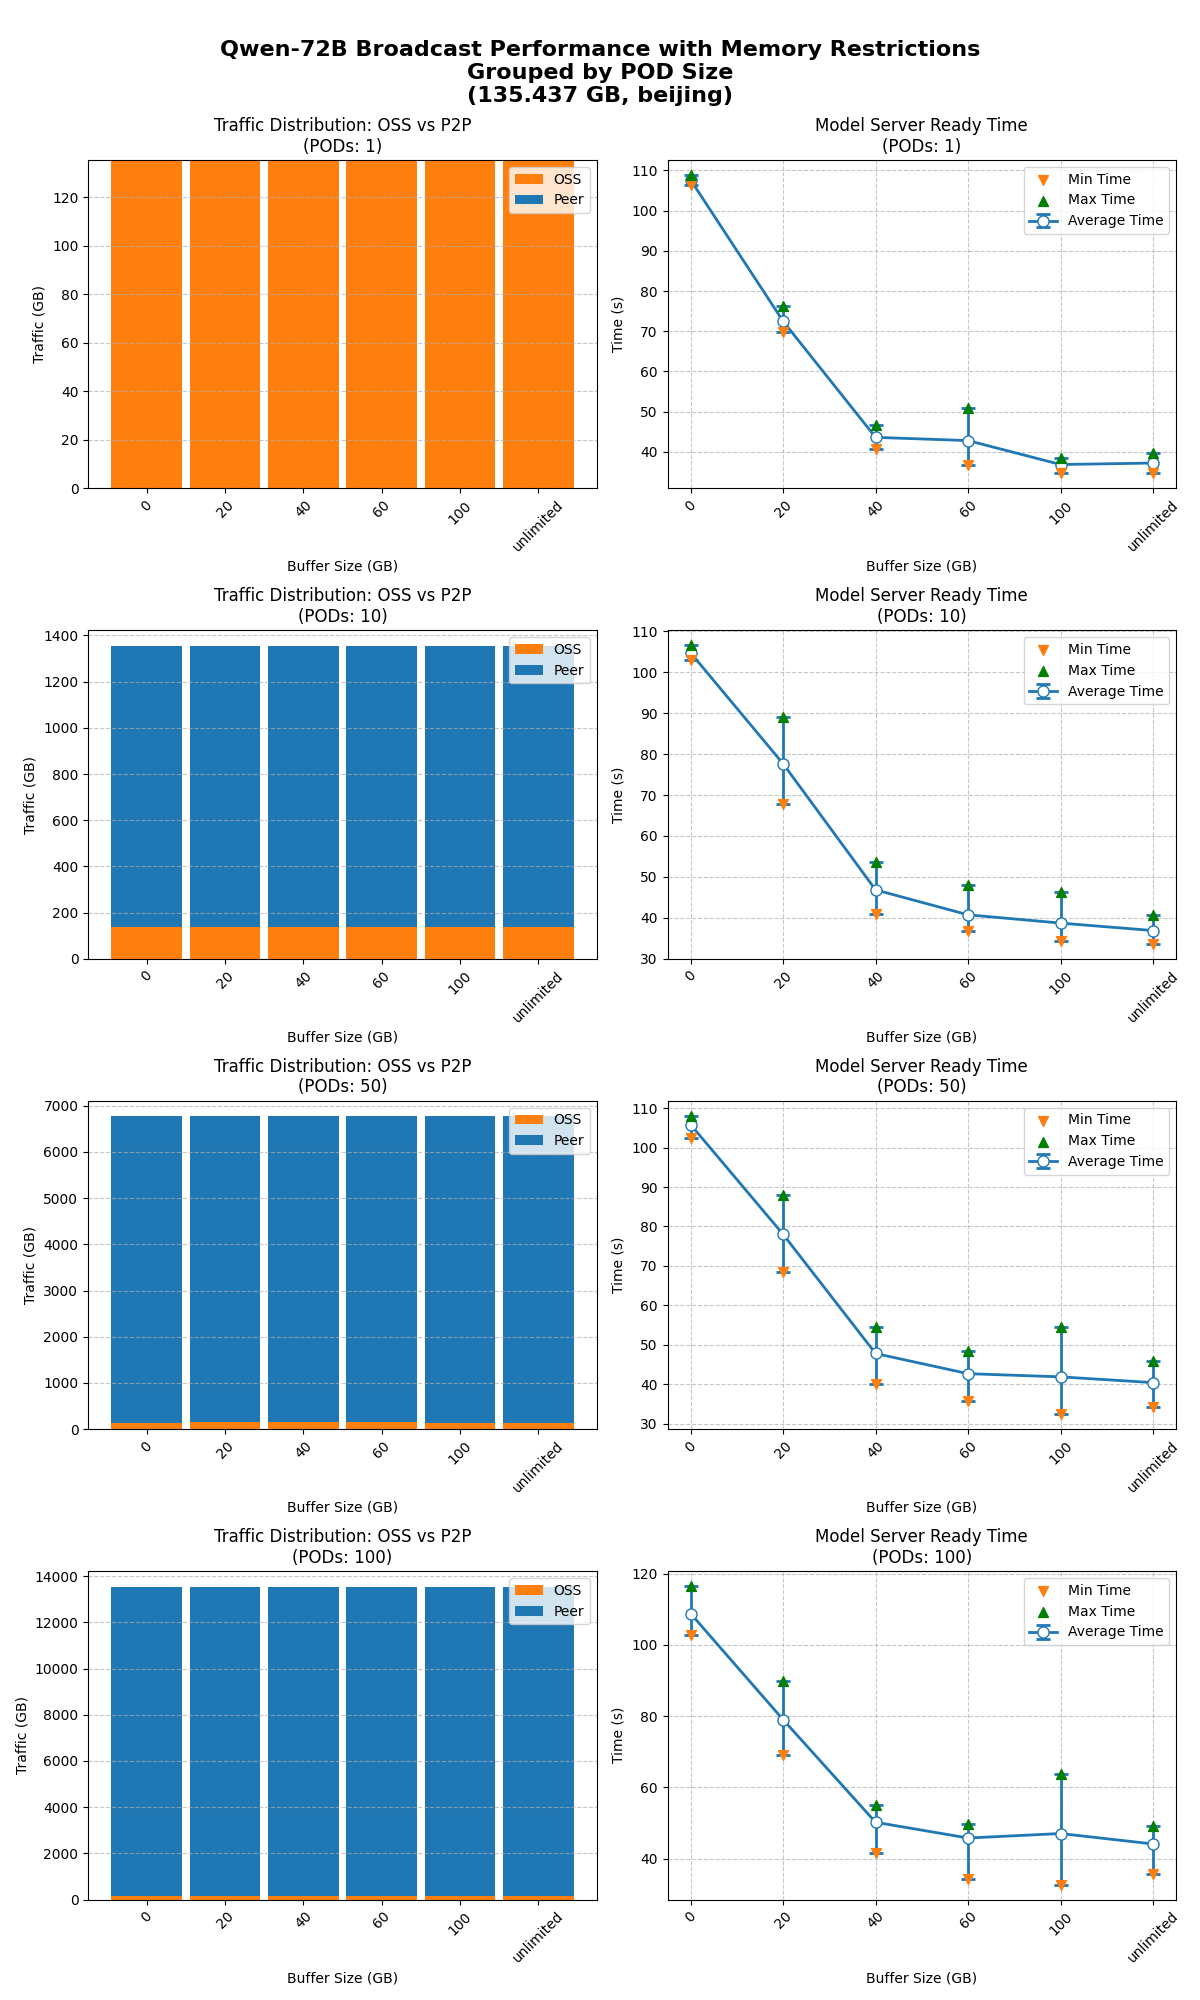
O model broadcasting funciona conforme o esperado em todos os limites de tamanho de cache.
O impacto do limite de cache é consistente em todos os níveis de concorrência. Um cache de 40 GB ou mais não afeta significativamente o tempo de disponibilização do modelo. O desempenho cai visivelmente com 20 GB ou menos.
Teste na região de Ulanqab
Ambiente de teste
|
Item |
Configuração |
|
OSS |
China (Ulanqab), largura de banda de download pela intranet de 10 Gbps |
|
Configuração do nó |
ecs.g9i.24xlarge, rede de 32/48 Gbps (pico), 96 vCPUs, 384 GiB |
|
Modelo |
Qwen2.5-72B, 135.437 GB |
O tempo de disponibilização do modelo foi testado para 1, 10, 50 e 100 nós iniciando simultaneamente, com o tamanho de cache ilimitado e limitado a 60 e 0 GB.
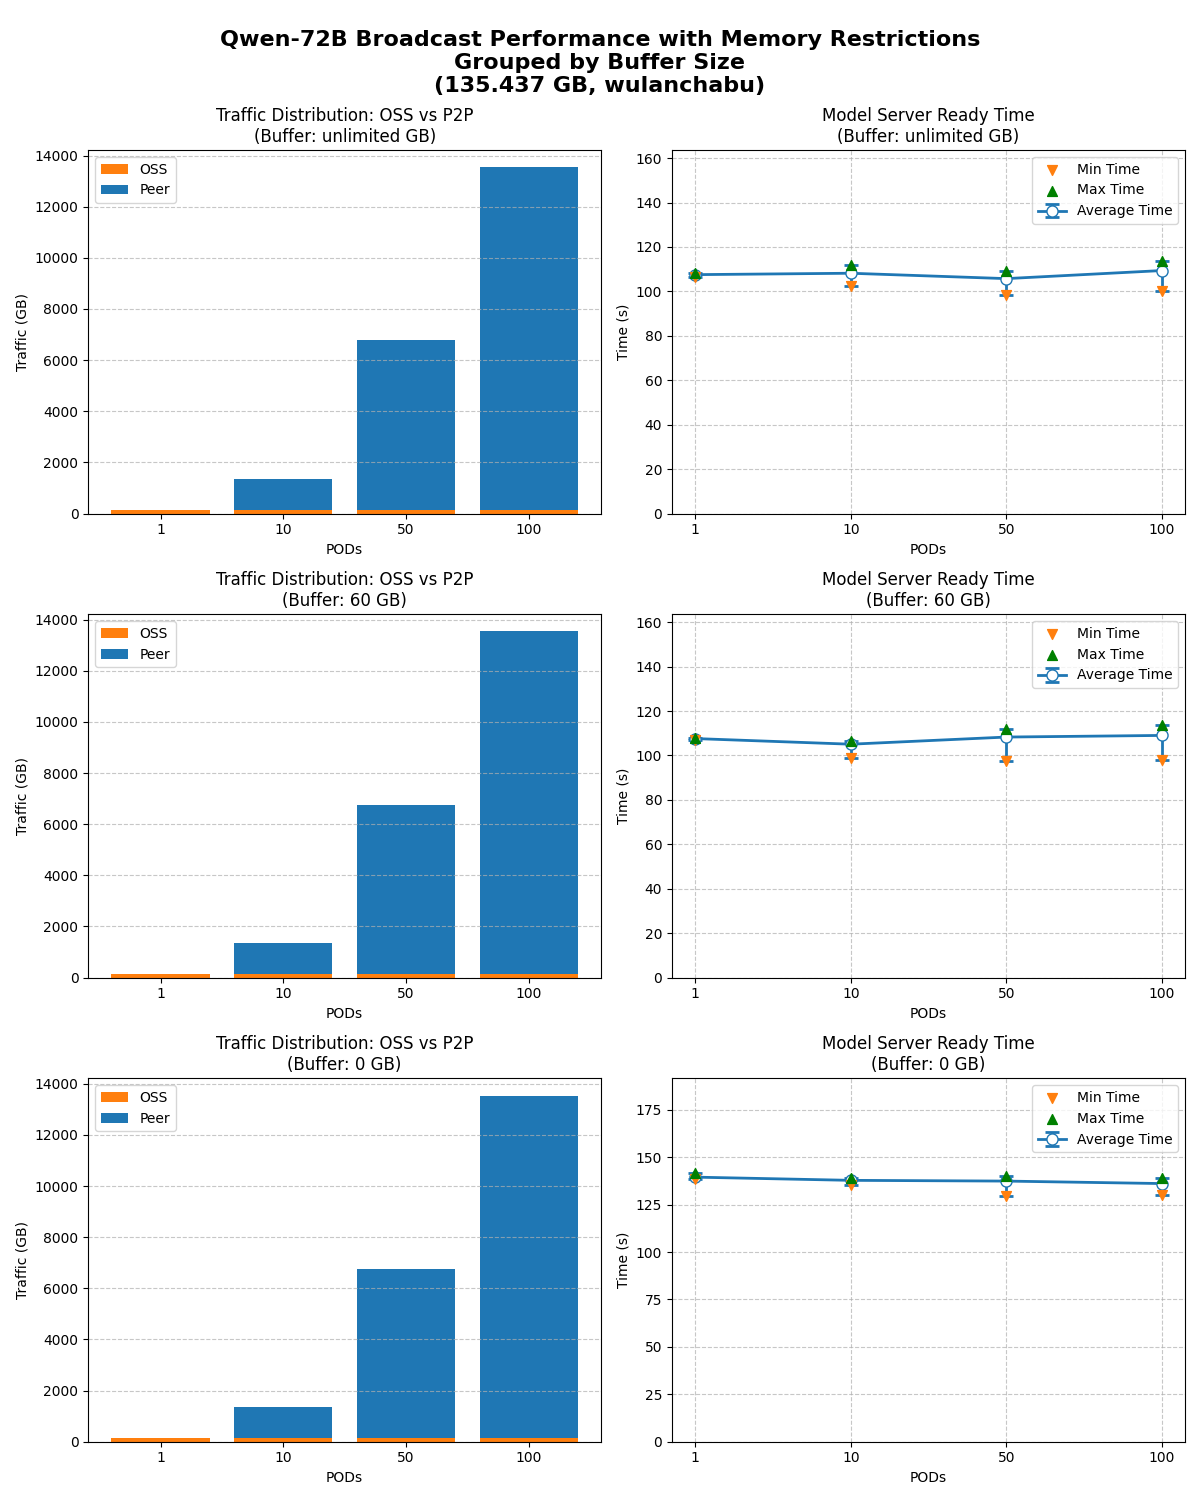
Mesmo com largura de banda de download do OSS limitada, o model broadcasting mantém excelente escalabilidade horizontal e minimiza a pressão sobre a largura de banda da origem.