O OpenSearch Retrieval Engine Edition é um mecanismo de busca distribuído em larga escala desenvolvido pela Alibaba. Ele alimenta os serviços de busca em todo o Grupo Alibaba, incluindo Taobao, Tmall, Cainiao, Youku e negócios de comércio eletrônico internacionais, além de servir como base para o serviço OpenSearch na Alibaba Cloud. Projetado para alta disponibilidade (HA), desempenho em tempo real e baixo custo, o produto inclui um sistema maduro de O&M automatizado que permite crie serviços de busca adaptados às necessidades do seu negócio.
Arquitetura do serviço
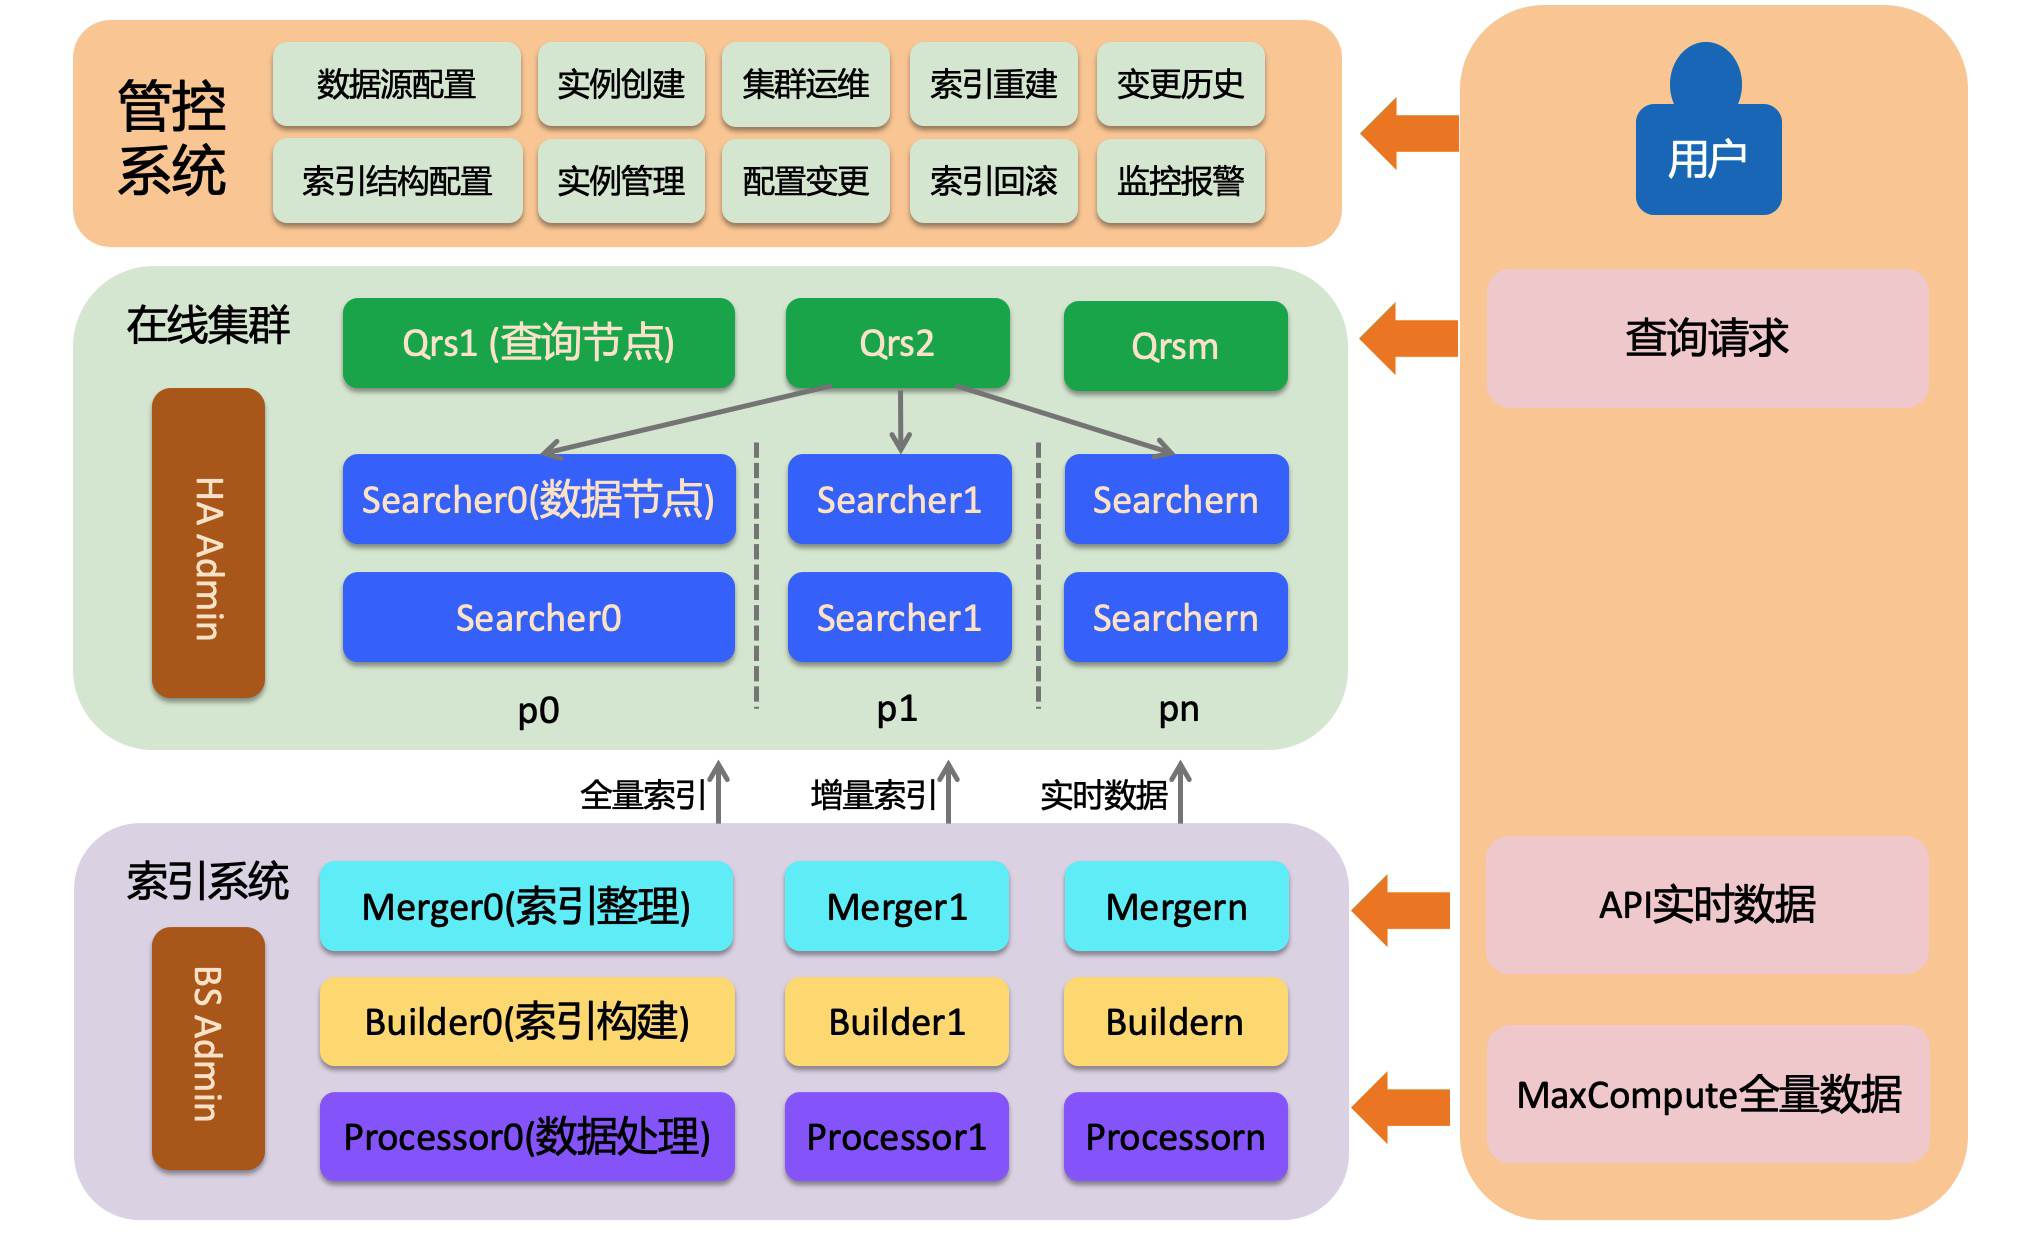
O OpenSearch Retrieval Engine Edition consiste em três partes: um sistema online, um sistema offline de construção de índices e um sistema de controle. O sistema online carrega índices e atende a solicitações de recuperação. O sistema offline constrói índices completos, incrementais em lote e em tempo real a partir dos dados do usuário. O sistema de controle oferece O&M automatizado e auxilia na criação e no gerencie de clusters.
Sistema online
O sistema online é um sistema distribuído de recuperação de informações com três funções: admin, qrs e searcher.
HA Admin
O HA Admin atua como o cérebro do sistema online. Cada cluster físico possui pelo menos um admin. Ele recebe comandos do sistema de controle e envia instruções de O&M para os nós Qrs e Searcher. Além disso, monitora esses nós em tempo real e substitui automaticamente qualquer nó cujo heartbeat apresente anomalias.
Qrs (QRS worker)
O Qrs (QRS worker) é um nó de processamento de consultas e resultados. Ele analisa, valida ou reescreve as consultas recebidas, encaminha-as para o Searcher e, em seguida, coleta, mescla e retorna os resultados. Os QRS workers são otimizados para computação e não carregam dados do usuário; portanto, geralmente exigem pouca memória. No entanto, o uso de memória pode aumentar quando há retorno de muitos documentos ou geração de diversas entradas estatísticas. Se a capacidade do QRS se tornar um gargalo, adicione nós de backup ou atualize as especificações do nó.
Searcher (nó de dados)
O Searcher carrega os dados de índice do usuário e recupera documentos com base nas consultas, executando filtragem, estatísticas e ordenação. É possível fragmentar os índices em um Searcher aplicando hash ao campo de sharding para obter um valor no intervalo [0, 65.535] e dividindo esse intervalo em um número específico de shards (definido durante a construção do índice). O sharding melhora o desempenho de solicitações únicas em clusters com grandes volumes de dados ou requisitos rigorosos de latência. Para aumentar o throughput geral — por exemplo, de 1.000 QPS para 10.000 QPS — escale horizontalmente adicionando nós Searcher de backup que hospedam todos os dados. Os shards devem cobrir todo o intervalo [0, 65.535].
Sistema offline de construção de índices
O OpenSearch Retrieval Engine Edition utiliza separação de leitura e escrita, de modo que as gravações de dados não afetam o serviço de recuperação online. Isso garante consultas estáveis e suporta gravações em tempo real em larga escala. O sistema de construção de índices possui dois fluxos — completo e incremental — e cada um envolve três funções para processamento de dados e construção de índices.
Fluxo completo
Os índices suportam várias versões, cada uma construída a partir de dados brutos (fontes de dados API são vazias por padrão). A primeira construção executa um job único de processamento completo de dados para gerar um índice completo, que é então alternado para o cluster online para recuperação. Atualizações incrementais subsequentes são aplicadas ao novo índice completo. Atualmente, jobs completos só conseguem ler dados de fontes MaxCompute ou Hadoop Distributed File System (HDFS).
Várias versões de índice garantem estabilidade durante modificações de dados. Quando o esquema do índice ou a estrutura de dados muda, uma construção completa gera um novo índice totalmente isolado da versão antiga, permitindo rollback rápido caso surjam problemas.
A geração de índices completos envolve múltiplos estágios: processamento de dados, construção de índices e mesclagem de índices. Defina a concorrência em cada estágio para aumentar a velocidade de geração.
Fluxo incremental
Após a geração de um índice completo, as atualizações subsequentes de dados são enviadas por meio de uma API e processadas por dois pipelines. Em um pipeline, um Processor envia dados diretamente para um nó de dados a fim de construir um índice em tempo real na memória. No outro, um Builder e um Merger criam um índice incremental aplicado ao nó de dados por meio de uma alternância incremental. Durante essa alternância, o índice em tempo real na memória é limpo, e os dados já presentes no índice incremental são removidos do índice em tempo real para reduzir a pressão sobre a memória.
Cada tabela de índice corresponde a um fluxo incremental, que é um job de longa duração. Melhore o processamento de dados em tempo real ajustando a concorrência de cada nó no fluxo.
Processor
O Processor lida com documentos brutos tokenizando ou reescrevendo o conteúdo dos campos com base na lógica de negócios. Em um fluxo incremental, o Processor opera como um serviço distribuído de longa duração cuja concorrência você pode ajustar para melhorar o throughput. O Processor também suporta vários plugins de processamento de dados. Esse recurso ainda não está disponível publicamente. Caso precise dele, entre em contato conosco.
Builder
O Builder constrói um índice a partir de documentos processados. Ele executa alternadamente com o Merger: após cada construção, uma tarefa do Merger organiza o índice, e somente o índice organizado é alternado para o nó de dados.
Merger
O Merger consolida e organiza os dados de índice do Builder em uma forma mais compacta. À medida que os dados são atualizados, índices legados acumulam registros marcados para exclusão. O Merger limpa e mescla esses dados de acordo com uma política de mesclagem especificada.
Estrutura de índice do Retrieval Engine Edition
|-- generation_0
        |-- partition_0_32767
        |-- index_format_version
        |-- index_partition_meta
        |-- schema.json
  |-- version.0
        |-- segment_0
            |-- segment_info
                        |-- attribute
                        |-- deletionmap
             |-- index
      |-- summary
    |-- segment_1
            |-- segment_info
                        |-- attribute
                        |-- deletionmap
             |-- index
      |-- summary
         |-- partition_32768_65535
        |-- index_format_version
        |-- index_partition_meta
        |-- schema.json
  |-- version.0
        |-- segment_0
            |-- segment_info
                        |-- attribute
                        |-- deletionmap
             |-- index
      |-- summary
    |-- segment_1
            |-- segment_info
                        |-- attribute
                        |-- deletionmap
             |-- index
|-- summary|
Nome da estrutura |
Descrição |
|
generation |
|
|
partition |
A partição é a unidade básica para um searcher carregar um índice. Dados excessivos em uma única partição podem degradar o desempenho do searcher. Dados online são normalmente divididos em várias partições para garantir a eficiência de recuperação de cada searcher. |
|
schema.json |
Arquivo de configuração de índice que registra informações de campos, índices, atributos e resumos. O mecanismo usa este arquivo para carregar o índice. |
|
version.0 |
Arquivo de versão que registra os segments a serem carregados na partição atual e o timestamp do documento mais recente. Durante uma construção em tempo real, o mecanismo filtra documentos brutos legados com base no timestamp da versão incremental. |
|
segment |
O segment é a unidade básica de um índice. Ele contém as estruturas de índice invertido e direto de um documento. O construtor de índices gera um segment a cada dump. Vários segments podem ser mesclados com base em uma política de mesclagem. Os segments disponíveis em uma partição são especificados no arquivo de versão. |
|
segment_info |
Metadados do segment que registram a contagem de documentos, status de mesclagem, informações de locator e timestamp do documento mais recente. |
|
index |
Diretório de índice invertido. |
|
attribute |
Diretório de índice direto. |
|
deletionmap |
Registros de documentos excluídos. |
|
summary |
Diretório de índice de resumo. |
Sistema de controle
O sistema de controle é uma plataforma de O&M para instâncias do Retrieval Engine Edition que reduz significativamente os custos operacionais. Para mais informações, consulte a documentação do produto Retrieval Engine Edition.
Recursos do produto
Estabilidade
Desenvolvido em C++ e refinado ao longo de mais de uma década, o Retrieval Engine Edition alimenta diversos negócios essenciais e comprovou ser altamente estável — ideal para cenários de busca críticos.
Eficiência
Como mecanismo de busca distribuído, o Retrieval Engine Edition recupera conjuntos massivos de dados com eficiência e suporta atualizações de dados em tempo real que entram em vigor em segundos — perfeito para cenários sensíveis à latência que exigem dados atualizados instantaneamente.
Baixo custo
O Retrieval Engine Edition suporta múltiplas políticas de compressão de índices e carregamento de índices multivalorados, ajudando você a atender aos requisitos de consulta com menor custo.
Recursos abrangentes
O Retrieval Engine Edition oferece suporte a vários tipos de analisadores, múltiplos tipos de índices e uma sintaxe de consulta poderosa. Também fornece um mecanismo de plugins que permite personalizar sua lógica de processamento de negócios.
Consulta SQL
O Retrieval Engine Edition suporta sintaxe de consulta SQL e junções de múltiplas tabelas online, com um rico conjunto de User-Defined Functions (UDFs) integradas e um mecanismo de personalização de UDFs. O SQL Studio será integrado em breve ao sistema de O&M para auxiliar no desenvolvimento e teste de consultas SQL.