Perguntas frequentes sobre inicialização e desligamento graceful no MSE Microservices Governance.
Recursos avançados
Esta seção não se aplica se você estiver conectando sua aplicação ao Microservices Governance pela primeira vez.
A versão anterior do console oferecia recursos avançados para inicialização e desligamento graceful. Como esses recursos envolvem conceitos complexos de microsserviços, a nova interface os oculta para simplificar o uso. Os recursos avançados anteriores incluíam dois sub-recursos:
-
Registro de service antes da prontidão
Este recurso ainda está disponível e ativado por padrão. Se ele foi desativado anteriormente, será ativado automaticamente quando você ativar a inicialização graceful na página Graceful Online/Offline no console. Caso já tenha ativado esse recurso, não recomendamos desativá-lo. Quando ativado por padrão, ele não causa impactos negativos e ajuda a evitar que o tráfego caia para zero durante as liberações. Para mais informações, consulte What does 55199/readiness do, and why is there a risk of traffic dropping to zero without it?.
-
Prefetching de service antes da prontidão
Este recurso não está mais disponível para novas configurações. Seu objetivo original era garantir que o prefetching de service atingisse o resultado esperado e evitar picos repentinos na curva de QPS. Ele funcionava atrasando a sonda de prontidão do Kubernetes para estender o tempo total de liberação. Isso dava aos novos nós tempo suficiente para executar o prefetching enquanto os nós antigos continuavam a lidar com o tráfego, garantindo um aumento gradual do QPS. Se os nós antigos ficarem offline enquanto os novos ainda estiverem em prefetching, os novos nós precisarão lidar com todo o tráfego recebido, o que anula o propósito do prefetching de service com baixo tráfego. As aplicações que ativaram esse recurso anteriormente não são afetadas, mas ele não pode ser ativado para novas aplicações. Se você ativou esse recurso no passado, não recomendamos desativá-lo, pois ele não causa impactos negativos. Para obter melhores resultados com o prefetching de service de baixo tráfego na nova versão, consulte Best practices for low-traffic service prefetching.
Princípios do prefetching de service de baixo tráfego
Quando um consumidor chama um service, ele seleciona um provedor. Se o provedor tiver o prefetching de service de baixo tráfego ativado, o Microservices Governance aprimora esse processo de seleção calculando um peso de 0% a 100% para cada provedor. Quanto maior o peso, maior a probabilidade de seleção. Quando um provedor com prefetching de service de baixo tráfego é iniciado, os consumidores atribuem a ele um peso baixo, reduzindo a probabilidade de o novo nó ser selecionado. Com o tempo, o peso aumenta até atingir 100%, momento em que o prefetching é concluído e o nó passa a receber tráfego normalmente. O provedor inclui seu horário de início nos metadados de registro do service, que os consumidores usam para calcular o peso. Tanto o provedor quanto o consumidor devem ter o Microservices Governance ativado para que esse processo funcione.
O prefetching de service de baixo tráfego começa após a aplicação receber sua primeira requisição. O processo termina após a duração configurada para o prefetching, que é de 120 segundos por padrão. Se a aplicação não receber tráfego externo, o processo de prefetching não será iniciado.
O prefetching de service de baixo tráfego requer tráfego externo de entrada, o que significa que o service já deve estar registrado. Se você observar que o prefetching começa antes do registro do service (ou seja, o evento de início do prefetching aparece no console antes do evento de registro do service), consulte Why do prefetching events appear before service registration events? para resolver o problema.
Curvas de QPS de prefetching inesperadas
Antes de ler esta seção, recomendamos que você compreenda how low-traffic service prefetching works.
Em circunstâncias normais, a curva de QPS de uma aplicação durante o prefetching de service de baixo tráfego se apresenta da seguinte forma:
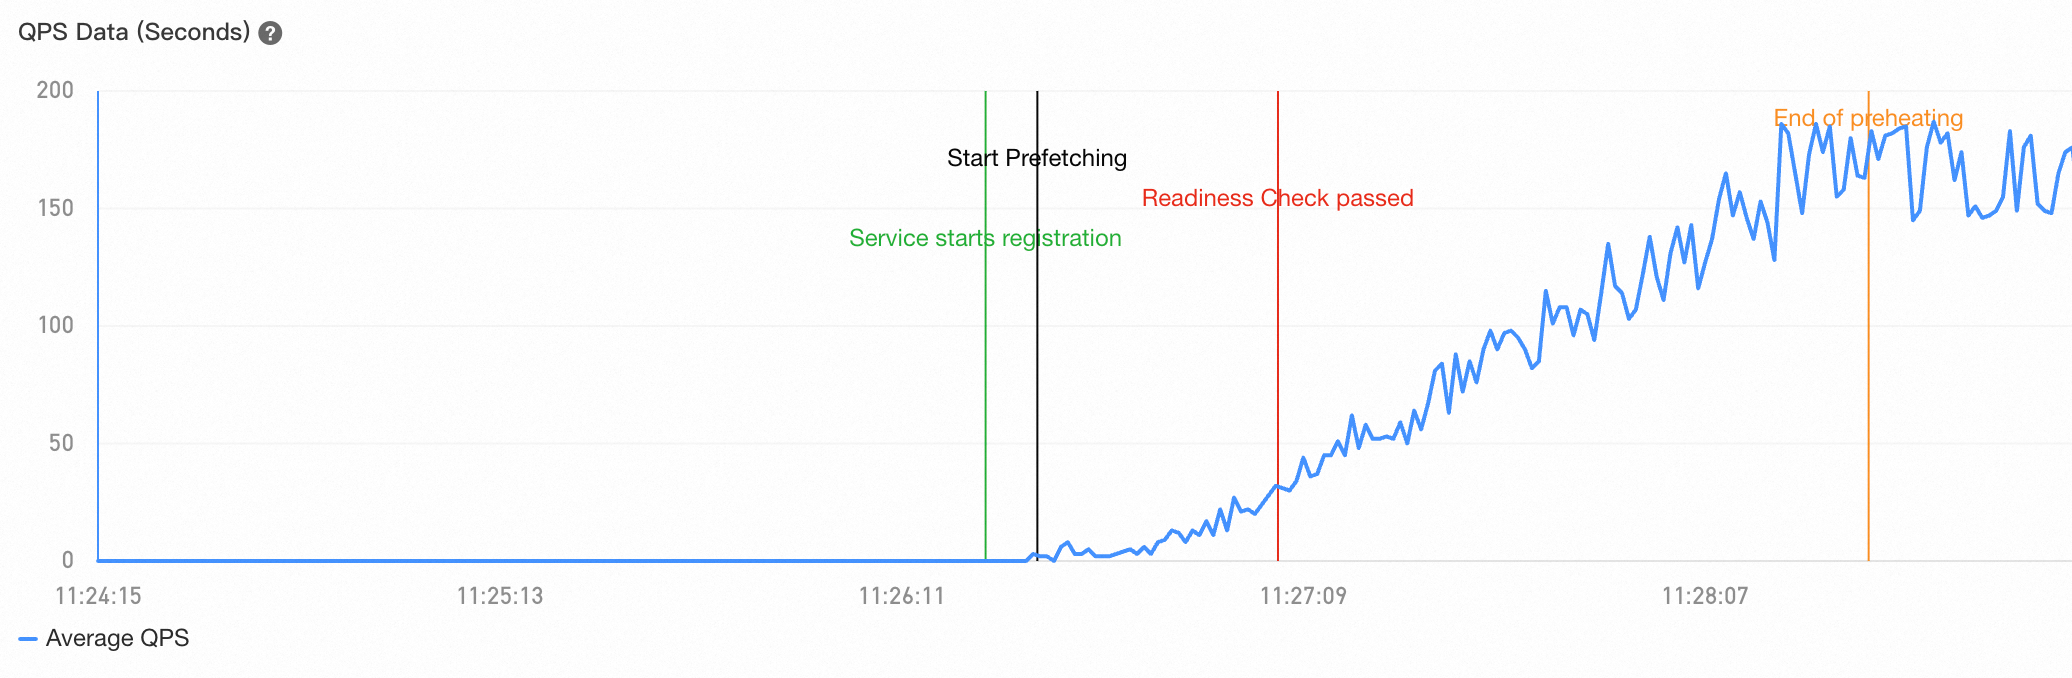
No entanto, em alguns casos de uso não suportados ou com configurações incorretas, a curva de QPS pode não mostrar um aumento gradual. A seguir, apresentamos dois padrões inesperados comuns:
-
Pico repentino na curva de QPS
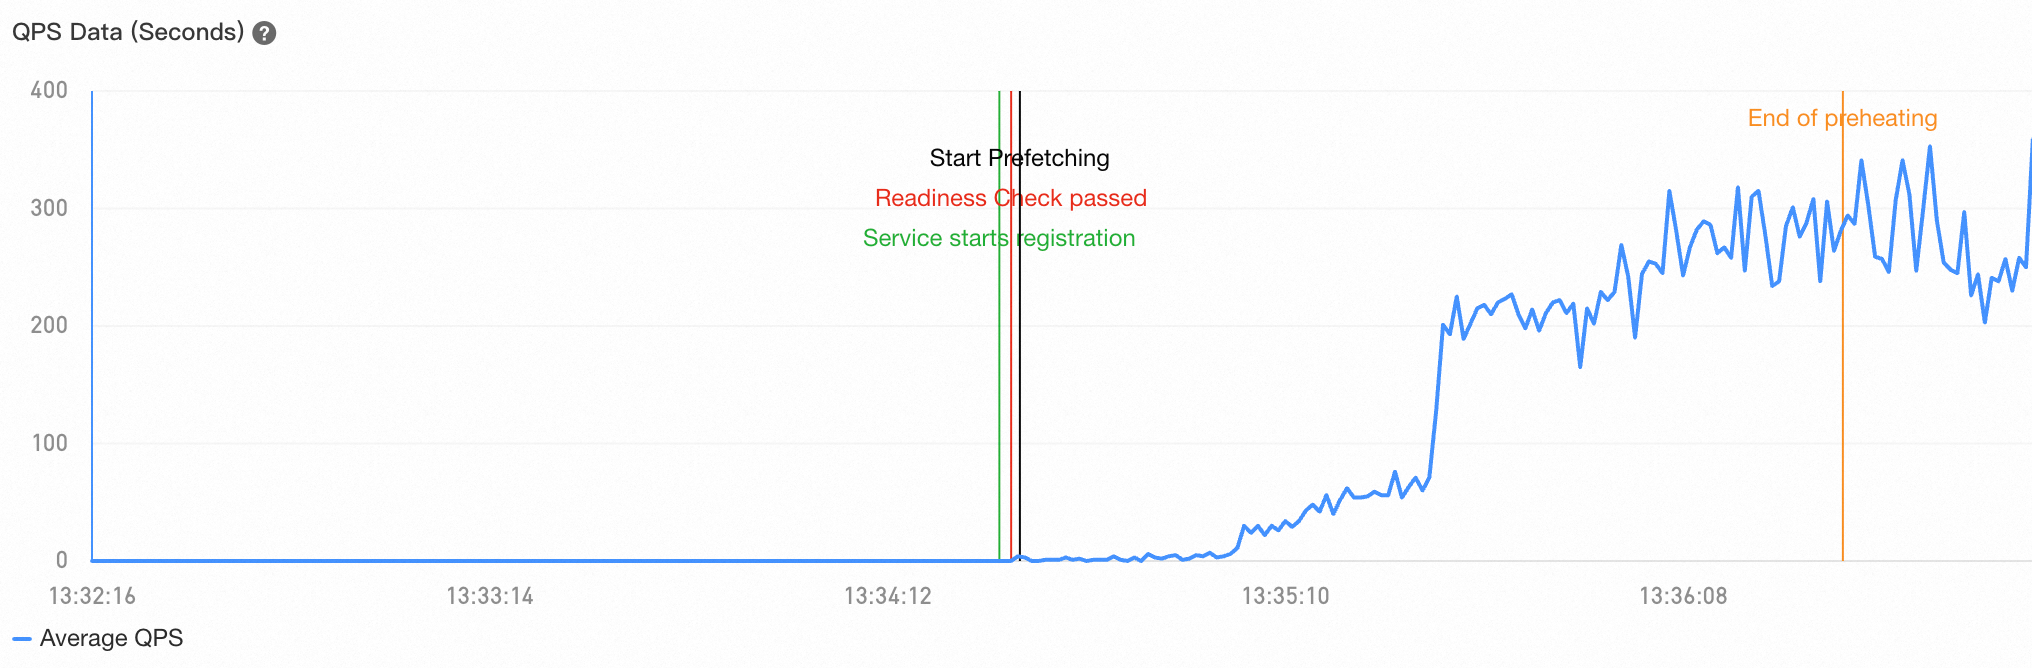
Isso geralmente ocorre durante a implantação de um service. Se os nós antigos ficarem offline antes que os novos nós concluam o prefetching, os consumidores não poderão mais aplicar roteamento de baixa probabilidade aos novos nós. Como resultado, a curva de QPS mostra inicialmente um aumento gradual, mas apresenta um pico depois que todos os nós antigos ficam offline. Para resolver esse problema, consulte Best practices for low-traffic service prefetching.
-
Ausência de aumento gradual do QPS
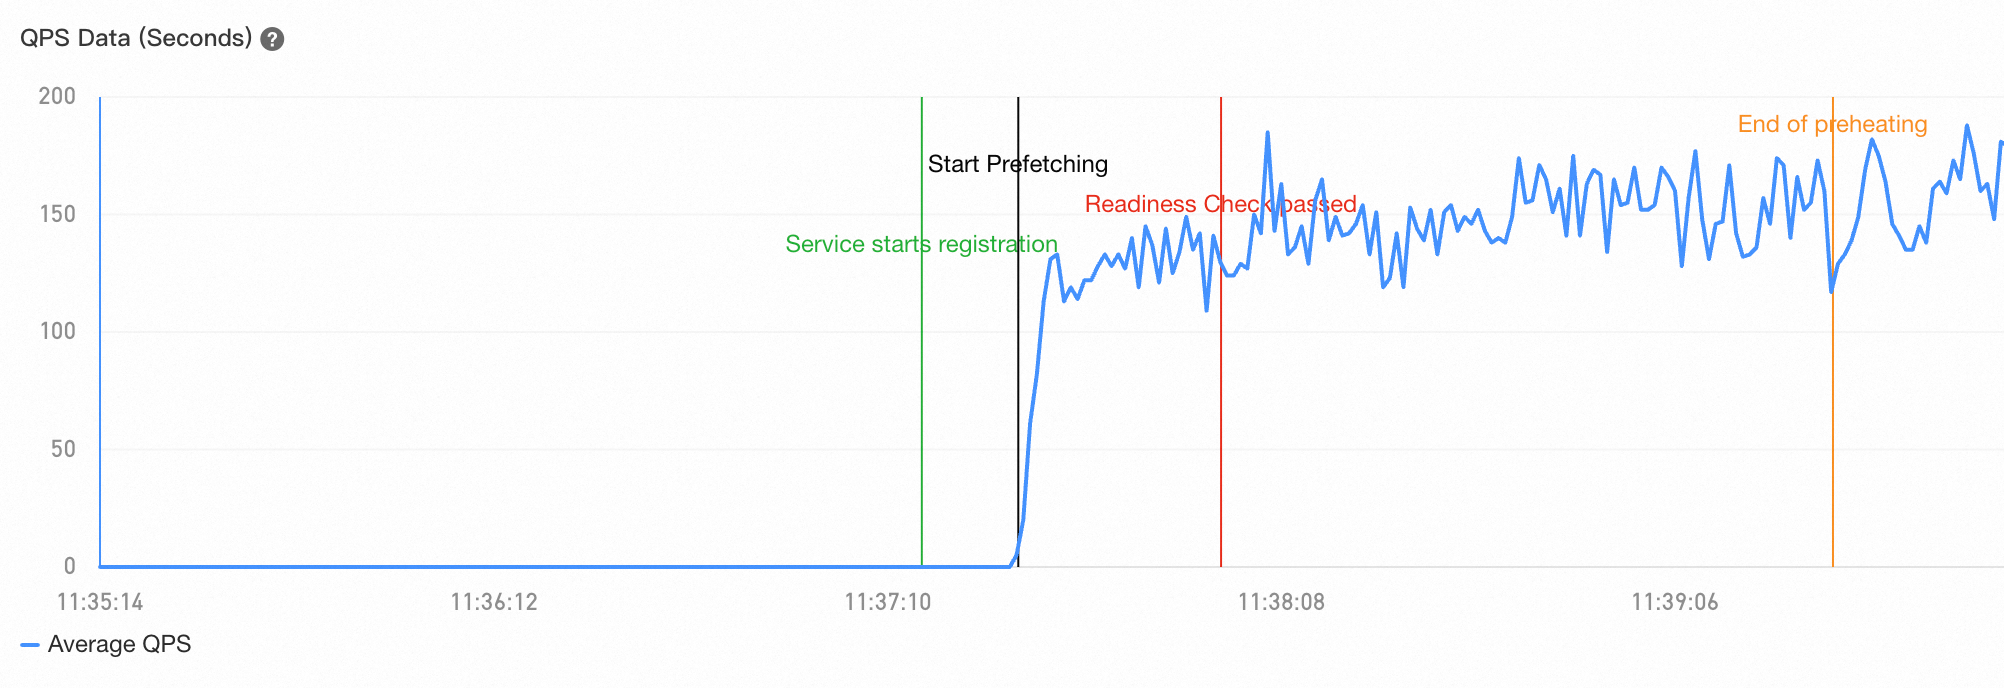
Esse problema indica que a aplicação consumidora não está conectada ao Microservices Governance. Conecte o consumidor para resolver essa situação. O prefetching de service de baixo tráfego não é suportado para tráfego proveniente de fontes externas, como gateways Java, pois eles não são consumidores conectados.
Melhores práticas para prefetching de service de baixo tráfego
Durante uma implantação contínua (rolling deployment), o prefetching de service frequentemente fica incompleto. Siga estas práticas para garantir que o prefetching atinja os resultados esperados:
Configure minReadySeconds (Recomendado): Defina o parâmetro .spec.minReadySeconds da sua carga de trabalho para controlar o intervalo entre o momento em que um pod fica pronto e o momento em que é considerado disponível. Configure este parâmetro com um valor maior que a duração do prefetching de service de baixo tráfego do pod. Isso garante que o Kubernetes aguarde a conclusão do prefetching pelo pod antes de prosseguir com a implantação contínua. Se você usar o ACK, defina esse parâmetro localizando sua aplicação na plataforma de contêineres e acessando More > Upgrade Policy > Rolling Upgrade > Minimum Ready Time (minReadySeconds). Configurar o minReadySeconds assegura que um novo pod permaneça no estado de prontidão pela duração especificada antes que o Kubernetes continue a implantação contínua.
Use implantação em lotes (Recomendado): Utilize ferramentas como o OpenKruise para implementar a implantação em lotes na sua carga de trabalho. Defina o intervalo entre cada lote para que seja maior que a duração do prefetching de service de baixo tráfego, garantindo que os novos nós de um lote realizem o prefetching completo antes que o próximo lote seja implantado.
Aumente o atraso inicial da sonda de prontidão (Não recomendado): Alternativamente, aumente o atraso inicial da sonda (initialDelaySeconds) da carga de trabalho para um valor maior que a soma da duração do prefetching de service de baixo tráfego, do atraso de registro e do tempo de inicialização da aplicação. Determine o tempo de inicialização da aplicação observando a saída dos logs. Esse valor pode mudar conforme seu negócio evolui. Além disso, atrasar a sonda de prontidão pode impedir que nós recém-iniciados sejam adicionados prontamente ao endpoint de service do Kubernetes. Portanto, não recomendamos este método.
Se a curva de QPS de prefetching ainda não atender às expectativas após seguir essas práticas, verifique se todo o tráfego vem de aplicações consumidoras conectadas ao Microservices Governance. Tráfego proveniente de consumidores não conectados ou balanceadores de carga externos fará com que a curva de QPS desvie do padrão esperado.
O endpoint 55199/readiness
O endpoint 55199/readiness é uma porta de sonda de prontidão HTTP integrada fornecida pelo MSE Microservices Governance. Quando a sonda de prontidão do Kubernetes de uma aplicação é configurada para usar 55199/readiness, a sonda retorna 500 se o novo nó não tiver concluído o registro do service e 200 se tiver concluído.
Na estratégia de implantação padrão do Kubernetes, os nós antigos não são encerrados até que os novos nós estejam prontos. Com a sonda de prontidão configurada para usar 55199/readiness, um novo nó fica pronto apenas após concluir o registro do service. Isso garante que os nós antigos sejam encerrados somente depois que os novos nós forem registrados, assegurando que sempre haja nós disponíveis no registro de services. Sem o 55199/readiness, os nós antigos podem ser encerrados antes que os novos nós se registrem durante uma implantação. Isso deixa o registro sem nós disponíveis e faz com que todas as chamadas dos consumidores falhem, com o tráfego caindo para zero. Por isso, recomendamos fortemente que você ative a inicialização graceful e configure a sonda de prontidão 55199/readiness para sua aplicação.
Se sua aplicação usar uma versão da sonda anterior à 4.1.10, configure o caminho da sonda de prontidão como /health em vez de /readiness. Para verificar a versão da sonda, acesse o console do MSE, navegue até Administration Center > Application Governance, clique em na aplicação desejada e, em seguida, clique em Node Details. A versão da sonda é exibida à direita.
Eventos de prefetching antes do registro do service
Na versão atual, o processo de prefetching é iniciado e um evento de início de prefetching é reportado quando o service recebe sua primeira requisição externa. No entanto, a primeira requisição pode não ser uma chamada de microsserviço e, portanto, pode não acionar o prefetching na lógica de negócios. Por exemplo, se uma carga de trabalho tiver uma sonda de atividade (liveness probe) do Kubernetes configurada, o processo de prefetching começará assim que o Kubernetes realizar uma verificação de atividade, mesmo que o registro do service ainda não tenha ocorrido.
Para evitar isso, configure o seguinte parâmetro nas variáveis de ambiente da carga de trabalho da aplicação provedora para fazer com que a lógica de prefetching ignore essas requisições:
# Exclude requests to paths /xxx and /yyy/zz from triggering the prefetching process
profile_micro_service_record_warmup_ignored_path="/xxx,/yyy/zz"Este parâmetro também pode ser configurado como um parâmetro de inicialização da JVM.
O valor do parâmetro não suporta expressões regulares.
Notificação proativa
A notificação proativa é um recurso avançado do módulo de desligamento graceful. Ela permite que um provedor Spring Cloud envie uma requisição de rede aos seus consumidores durante o desligamento, informando-os de que está ficando offline. Após receberem a notificação, os consumidores param de chamar esse nó. Normalmente, quando tanto o provedor quanto o consumidor usam o framework Spring Cloud, o consumidor armazena em cache uma lista de nós provedores localmente. Em alguns cenários, mesmo após receber uma notificação do registro de services, o consumidor pode não atualizar seu cache local a tempo, resultando em chamadas para nós offline. A notificação proativa resolve esse problema.
A notificação proativa vem desativada por padrão. Com o Microservices Governance ativado, a solução padrão de desligamento graceful faz com que o provedor em desligamento adicione um header especial às suas respostas. Quando um consumidor recebe uma resposta com esse header, ele para de chamar aquele nó provedor. Desde que o consumidor envie tráfego para o provedor em desligamento, ele detecta o desligamento e coloca o nó na lista de bloqueios automaticamente. No entanto, se o consumidor não enviar nenhuma requisição para o provedor durante o período de desligamento (geralmente cerca de 30 segundos), ele pode não detectar o desligamento. Uma requisição pode chegar exatamente quando o provedor estiver sendo desligado, causando um erro. Nesse cenário, ative a notificação proativa. Em outras palavras, se o tráfego do seu consumidor for muito esparso, recomendamos ativar a notificação proativa para o provedor.
Queda de tráfego atrasada após o desligamento
Normalmente, o tráfego cai para zero logo após um evento de desligamento graceful. Se isso não ocorrer, considere as seguintes causas e soluções possíveis:
-
Chamadas fora de microsserviços
A inicialização e o desligamento graceful gerenciam apenas o tráfego de chamadas internas de microsserviços. O tráfego que não é de microsserviços está fora do escopo deste recurso. Recomendamos criar soluções personalizadas com base nos recursos de desligamento graceful fornecidos pela sua infraestrutura e frameworks.
-
Notificação proativa não ativada
Recomendamos ativar a notificação proativa e, em seguida, verificar se a curva de desligamento atende às expectativas.
-
Versão do framework não suportada
Caso identifique que sua aplicação está usando uma versão do framework não suportada, considere atualizá-la.
Tempos de liberação longos
Siga estas etapas para verificar se a aplicação tem o recurso Concluir prefetching de service antes de passar na sonda de prontidão ativado.
Faça login no console do MSE e selecione uma região na barra de menu superior.
No painel de navegação à esquerda, escolha Microservices Governance > Application Governance.
Na página Applications, clique em na aplicação desejada e acesse a aba Traffic Governance > Graceful Start and Shutdown.
Na aba Graceful Online/Offline, pressione F12 para abrir as ferramentas de desenvolvedor do seu navegador. Na aba Network, pesquise pela requisição
GetLosslessRuleByApp. Se não a encontrar, atualize a página. No corpo da resposta, verifique se o valor do campo Related em Data é true. Se for, a aplicação tinha anteriormente o recurso Concluir prefetching de service antes de passar na sonda de prontidão ativado. Esse recurso agora está obsoleto e pode causar tempos de liberação mais longos. Recomendamos que você abra um ticket para desativar esse recurso.
O endpoint 55199/readiness e falhas na sonda
O Kubernetes fornece três sondas opcionais: a sonda de inicialização (startup probe), a sonda de atividade (liveness probe) e a sonda de prontidão (readiness probe).
startup probe: Verifica se uma aplicação foi iniciada com sucesso. Ela é executada apenas durante a fase de inicialização do pod. Se a sonda falhar várias vezes e atingir o limiar de falha configurado durante a inicialização, ela aciona uma reinicialização do pod.
liveness probe: Verifica se uma aplicação está ativa no momento. Ela começa a sondar após o sucesso da startup probe e continua durante todo o ciclo de vida do pod. Se a sonda falhar várias vezes e atingir o limiar de falha configurado, ela aciona uma reinicialização do pod.
readiness probe: Verifica se uma aplicação está pronta para aceitar tráfego. Ela começa a sondar após o sucesso da startup probe e continua durante todo o ciclo de vida do pod. Se a sonda falhar várias vezes e atingir o limiar de falha configurado, o Kubernetes define o status do pod como não pronto, mas não reinicia o pod. Durante uma implantação, a readiness probe também pode controlar o ritmo da implantação. De acordo com a estratégia de implantação padrão, se um novo pod não ficar pronto, o Kubernetes pausa o processo de implantação até que ele fique.
Depois que seu service for conectado ao MSE Microservices Governance, você poderá usar o endpoint integrado 55199/readiness para a configuração da sua sonda de prontidão. Com essa configuração, a sonda de prontidão do Kubernetes só é aprovada após a aplicação concluir o registro do service. Isso garante que, durante uma implantação, novos pods sejam registrados no registro de microsserviços antes que os pods antigos sejam encerrados e removidos do registro. Isso assegura que os chamadores sempre tenham nós disponíveis, prevenindo exceções de "nenhum service disponível". Para mais informações sobre por que você precisa configurar a sonda de prontidão do MSE, consulte Service registration status check.
Se sua sonda de prontidão do MSE falhar consistentemente, existem três motivos prováveis:
A inicialização graceful não está ativada para o service atual. Se a inicialização graceful estiver desativada, a API 55199/readiness do MSE não será exposta e a sonda de prontidão não será aprovada.
A aplicação não está conectada ao Microservices Governance. Verifique se existem logs da sonda no diretório de sondas de governança de microsserviços. Em um ambiente Kubernetes, o diretório padrão da sonda é
/home/admin/.opt/AliyunJavaAgentou/home/admin/.opt/ArmsAgent. Se o diretório de logs não existir, a aplicação falhou ao se conectar ao Microservices Governance. Abra um ticket para entrar em contato conosco.A aplicação está reiniciando continuamente porque a sonda de inicialização ou de atividade atingiu seu limiar de falha. Como a aplicação falha ao iniciar, a sonda de prontidão do MSE não é aprovada. Verifique os eventos do Kubernetes do pod em busca de falhas na sonda de inicialização ou de atividade.