A utilização de IOPS é uma métrica crítica para instâncias do MongoDB. Quando atinge ou se aproxima de 100%, as respostas da aplicação ficam lentas e os services podem ficar indisponíveis. Este guia aborda como verificar a utilização de IOPS, as causas comuns de alta utilização e as estratégias de otimização.
Informações básicas
Provedores de banco de dados em cloud geralmente usam tecnologias como cgroups (Control Groups) para impor isolamento de E/S e limites de IOPS (Operações de Entrada/Saída Por Segundo) por instância, evitando contenção de E/S em hosts compartilhados. Portanto, cada tipo de instância possui uma capacidade máxima específica de IOPS.
Observações importantes
As métricas IOPS Usage e utilização de IOPS não estão disponíveis para instâncias standalone nem para instâncias de replica set ou sharded cluster que executam o MongoDB 4.2 com discos em cloud.
Para essas instâncias, a página Monitoring Information no console do ApsaraDB for MongoDB sempre exibe 0 nas métricas IOPS Usage e IOPS Usage. Esse valor não reflete os dados reais de IOPS.
Verificar a utilização de IOPS
É possível verificar a utilização de IOPS por meio de gráficos de monitoramento ou pela execução de comandos.
Faça login no console do ApsaraDB for MongoDB. Na página Basic Information, na seção Specification Information, visualize o IOPS máximo da instância. Para consultar os limites de IOPS de diferentes tipos de instância, consulte Instance types.
Acesse o console do ApsaraDB for MongoDB. Na página Monitoring Information, verifique as métricas IOPS Usage e IOPS Usage para determinar se a instância está próxima do limite de IOPS. Para obter mais informações sobre métricas relacionadas a IOPS, consulte Metrics.
Causas comuns de problemas de E/S
A alta E/S de disco em uma instância do MongoDB geralmente decorre dos seguintes fatores:
Memória insuficiente: O desempenho de E/S depende fortemente do tamanho do cache do WiredTiger. Um cache maior retém mais dados quentes, reduzindo a E/S de disco e diminuindo o risco de gargalos. Um cache menor força o sistema a liberar páginas sujas para o disco com mais frequência, aumentando a pressão de E/S.
Configuração inadequada: Problemas de configuração que podem causar alta E/S incluem liberação frequente do journal ou logs de tempo de execução, um nível ineficiente de Write Concern ou erros de moveChunk em um sharded cluster.
Estratégias de otimização para problemas de E/S
Para resolver problemas de E/S em uma instância do ApsaraDB for MongoDB, selecione um tipo de instância adequado, otimize índices e refine os padrões de escrita da aplicação.
-
Selecione um tipo de instância adequado
Prever a proporção ideal entre dados quentes e tamanho de cache antes da implantação costuma ser difícil. Como regra geral, escolha um tipo de instância que atenda aos seus requisitos de negócios, mantendo a utilização diária de pico de CPU e a utilização de IOPS abaixo de 50%.
-
Otimize os índices
Varreduras completas de tabela e consultas com índices ineficientes consomem muita E/S. Por exemplo, exportar uma coleção inteira pode causar um pico de E/S. O excesso de indexação também aumenta o tamanho dos dados no disco, reduzindo a quantidade de dados quentes que o cache do WiredTiger consegue reter. Cada operação de escrita exige E/S adicional para atualizar os índices, degradando ainda mais o desempenho. Crie índices adequados para seus padrões de consulta a fim de mitigar esses problemas.
-
Otimize a arquitetura e as operações da sua aplicação
Para evitar que a E/S de disco se torne um gargalo no nível da aplicação, considere as seguintes otimizações:
-
Controle as threads concurrentes de escrita e leitura
O MongoDB é uma aplicação multithread. Um alto número de escritas concorrentes ou consultas complexas pode causar gargalos de E/S e atraso persistente de replicação nos nós secundários. Se o alto volume de escrita causar gargalos de E/S, considere fazer upgrade para um sharded cluster para escalar o desempenho de escrita linearmente, distribuindo os dados horizontalmente.
-
Evite picos de escrita sempre que possível
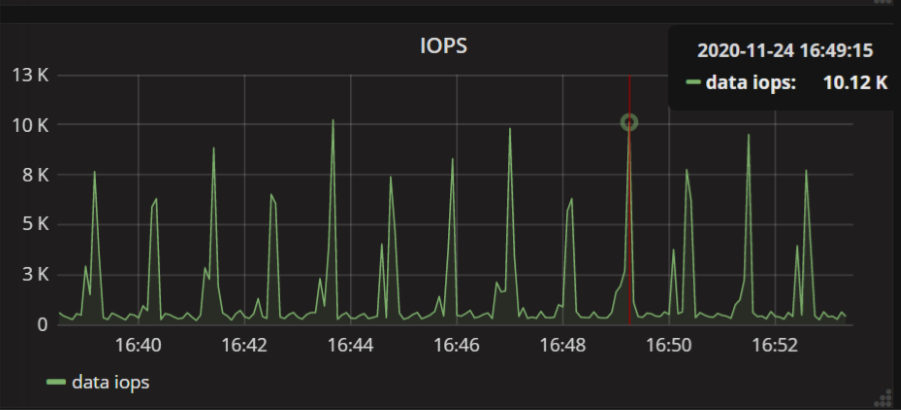
Algumas aplicações realizam escritas periódicas ou persistência de dados em massa, causando picos de IOPS. Se a instância atual não conseguir lidar com essas cargas de pico, distribua as operações de escrita de forma mais uniforme. Por exemplo, adicione um pequeno atraso aleatório a cada operação de escrita em lote.
-
Evite executar operações de manutenção durante horários de pico
Certas operações de manutenção podem impactar significativamente o desempenho e causar picos de IOPS. Sempre que possível, agende tais operações para horários de baixa demanda. Operações de alta E/S incluem modificações de dados em lote (escritas, atualizações e exclusões), criação de índices, compactação de coleções e exportação de dados em massa.
-