NimoShake (também conhecido como DynamoShake) é uma ferramenta de sincronização de dados desenvolvida pelo Alibaba Cloud para migrar bancos de dados Amazon DynamoDB para o ApsaraDB for MongoDB. Suporta migração completa, migração incremental ou ambas em uma única execução.
Suporte a recursos
|
Recurso |
Suportado |
|
Migração completa |
Sim |
|
Migração incremental |
Sim |
|
Transmissão retomável (incremental) |
Sim |
|
Transmissão retomável (completa) |
Não |
|
Migração de índices (somente fase completa) |
Sim |
|
Migração somente de schema |
Sim |
|
Filtragem de collections |
Sim |
|
Migração de índices (fase incremental) |
Não |
Pré-requisitos
Antes de começar, certifique-se de ter:
Uma instância de replica set ou de cluster sharded do ApsaraDB for MongoDB. Consulte Create a replica set instance ou Create a sharded cluster instance.
O AccessKey ID e o AccessKey secret do Amazon DynamoDB.
Espaço de armazenamento suficiente no ApsaraDB for MongoDB para todos os dados do banco de dados DynamoDB de origem. A capacidade de armazenamento do destino deve ser superior à da origem.
Como funciona
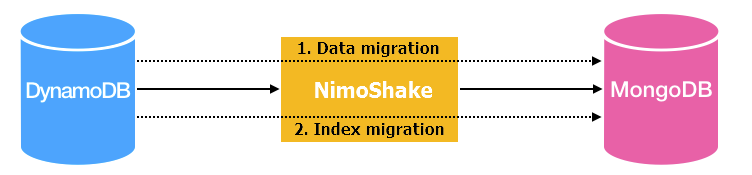
O NimoShake executa a migração completa e a migração incremental como fases separadas.
Migração completa
A migração completa é composta por duas partes: migração de dados seguida de migração de índices.
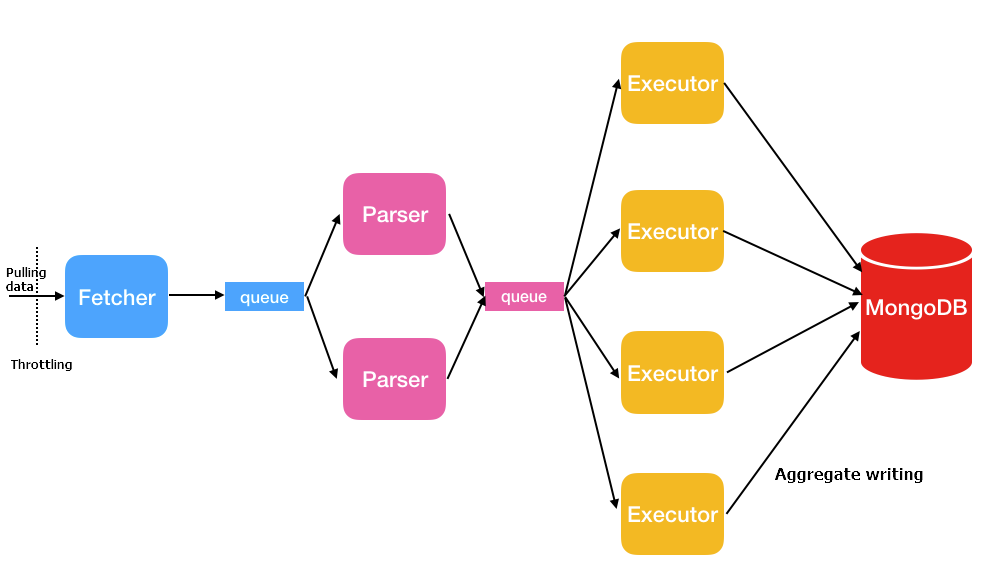
A migração de dados utiliza três tipos de threads em um pipeline:
|
Thread |
Descrição |
|
Fetcher |
Chama o driver de conversão de protocolo da Amazon para recuperar dados em lote da tabela de origem e os coloca em filas. Apenas um thread fetcher é executado por vez. |
|
Parser |
Lê os dados das filas, converte para o formato BSON e repassa aos executors. Padrão: 2 threads. Controlado por |
|
Executor |
Extrai dados das filas, agrega até 16 MB ou 1.024 entradas e grava no destino. Padrão: 4 threads. Controlado por |
A migração de índices ocorre após a conclusão da migração de dados e cria os seguintes índices:
-
Índices gerados automaticamente:
Se a tabela de origem tem uma partition key e uma sort key: um índice composto único em ambas as chaves, mais um índice hashed na partition key.
Se a tabela de origem tem apenas uma partition key: um índice hashed e um índice único na partition key.
Índices criados pelo usuário: Um índice hashed baseado na chave primária é criado para cada índice definido pelo usuário.
Migração incremental
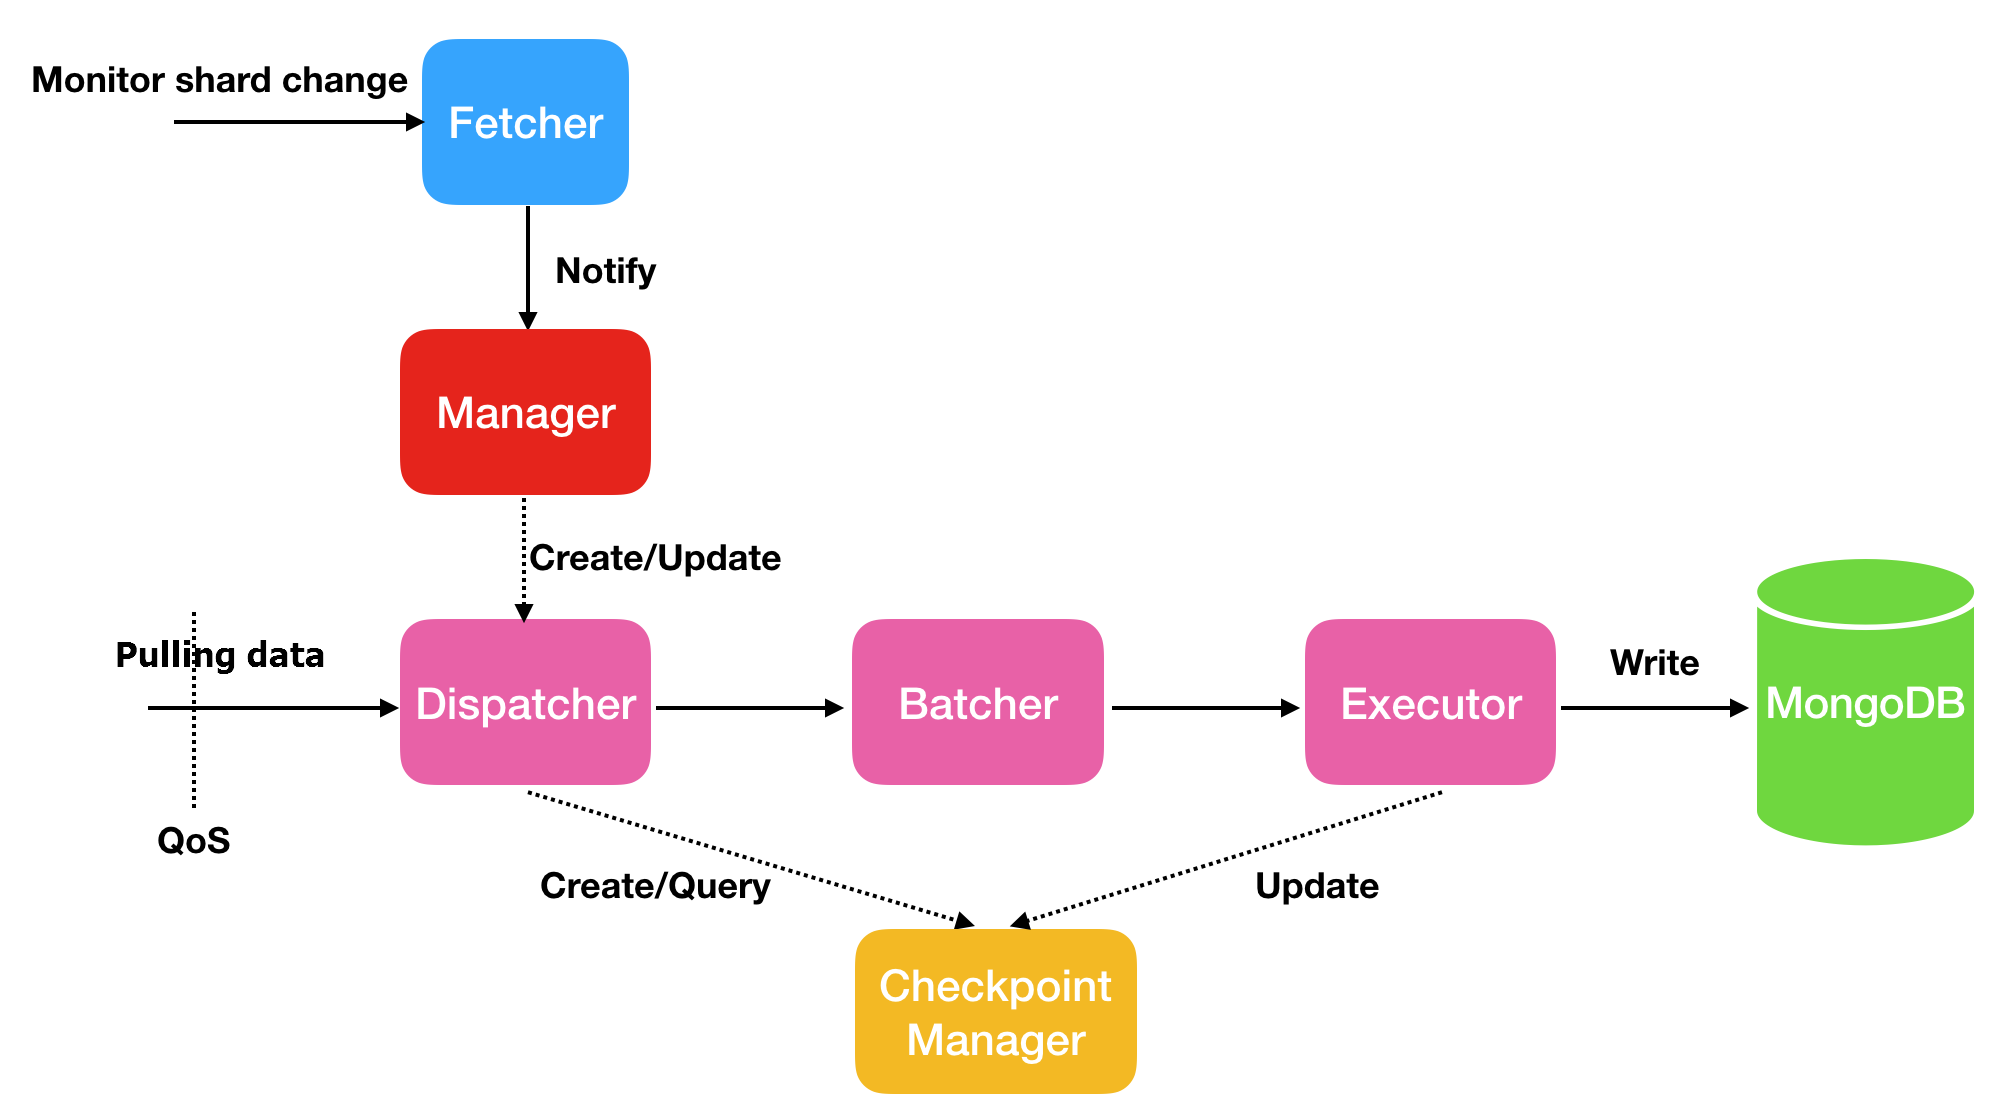
A migração incremental captura as alterações contínuas da origem e as grava no ApsaraDB for MongoDB. Índices criados durante a fase incremental não são migrados.
|
Thread |
Descrição |
|
Fetcher |
Monitora as alterações de shard no stream. |
|
Manager |
Gerencia as notificações de mensagens e cria um Dispatcher para cada shard. |
|
Dispatcher |
Recupera dados incrementais da origem, retomando a partir do último checkpoint quando a transmissão retomável está ativa. |
|
Batcher |
Analisa, empacota e agrega dados incrementais provenientes dos threads Dispatcher. |
|
Executor |
Grava os dados agregados na instância ApsaraDB for MongoDB de destino e atualiza o checkpoint. |
Transmissão retomável e checkpoints
A migração incremental suporta transmissão retomável por meio de checkpoints. Se a conexão for perdida e restaurada rapidamente, a migração retoma a partir do último checkpoint. Uma desconexão prolongada ou a perda do checkpoint pode acionar uma nova migração completa.
Por padrão, os checkpoints são armazenados no banco de dados ApsaraDB for MongoDB de destino, em um banco de dados chamado nimo-shake-checkpoint. Cada collection tem sua própria tabela de checkpoint, e uma tabela status_table registra se a sincronização atual é uma tarefa completa ou incremental.
A migração completa não suporta transmissão retomável. Se interrompida, reinicia do início.
Migrar do DynamoDB para o ApsaraDB for MongoDB
Os passos a seguir utilizam o Ubuntu como exemplo.
Etapa 1: Baixe o NimoShake
wget https://github.com/alibaba/NimoShake/releases/download/release-v1.0.14-20250704/nimo-shake-v1.0.14.tar.gzBaixe a versão mais recente na página de releases do NimoShake .
Etapa 2: Extraia o pacote
tar zxvf nimo-shake-v1.0.14.tar.gzEtapa 3: Acesse o diretório
cd nimo-shake-v1.0.14Etapa 4: Configure o NimoShake
Abra o arquivo de configuração:
vi nimo-shake.confAs tabelas abaixo descrevem todos os parâmetros de configuração, agrupados por categoria. Comece pelos parâmetros obrigatórios e ajuste os opcionais conforme necessário.
Parâmetros obrigatórios
| Parâmetro | Descrição | Exemplo |
|---|---|---|
source.access_key_id |
O AccessKey ID do banco de dados Amazon DynamoDB. | source.access_key_id = AKIAIOSFODNN7EXAMPLE |
source.secret_access_key |
O AccessKey secret do banco de dados Amazon DynamoDB. | source.secret_access_key = wJalrXUtnFEMI/K7MDENG |
source.region |
A região AWS do banco de dados DynamoDB. Opcional se a região for detectada automaticamente ou não se aplicar. | source.region = us-east-2 |
target.type |
O tipo do banco de dados de destino. Defina como mongodb para o ApsaraDB for MongoDB. Defina como aliyun_dynamo_proxy para uma instância ApsaraDB for MongoDB compatível com DynamoDB.Para mais endereços MongoDB, consulte Replica set instance connection ou Connect to a sharded cluster instance. |
target.type = mongodb |
target.address |
A string de conexão do banco de dados de destino. Consulte Connect to a replica set instance ou Connect to a sharded cluster instance. | target.address = mongodb://username:password@s-*****-pub.mongodb.rds.aliyuncs.com:3717 |
target.mongodb.type |
O tipo da instância ApsaraDB for MongoDB de destino. replica para uma instância de replica set. sharding para uma instância de cluster sharded. |
target.mongodb.type = sharding |
sync_mode |
O modo de migração. all: executa a migração completa seguida de migração incremental. full: executa somente a migração completa. Padrão: all. Nota
Somente |
sync_mode = all |
Configurações gerais
|
Parâmetro |
Padrão |
Obrigatório |
Descrição |
Exemplo |
|
|
— |
Opcional |
O ID da tarefa de migração. Usado para arquivos PID, nomes de log, o nome do banco de dados de checkpoint e o nome do banco de dados de destino. |
|
|
|
stdout |
Opcional |
O caminho do arquivo de log. Se não definido, os logs são impressos no stdout. |
|
|
|
|
Opcional |
O nível de log. Valores válidos: |
|
|
|
|
Opcional |
Se o buffering de log deve ser ativado. |
|
|
|
— |
Opcional |
A porta PPROF para depuração e visualização de informações de corrotinas com pilha. |
|
|
|
— |
Opcional |
A porta RESTful para a fase de migração completa. Use |
|
|
|
— |
Opcional |
A porta RESTful para a fase de migração incremental. Use |
|
Configurações de conexão com a origem
|
Parâmetro |
Padrão |
Obrigatório |
Descrição |
Exemplo |
|
|
— |
Opcional |
O token de sessão temporário para acesso ao DynamoDB. Necessário somente ao usar credenciais temporárias. |
|
|
|
— |
Opcional |
A URL do endpoint, caso a origem seja do tipo endpoint. **Defina este parâmetro substitui todos os demais parâmetros |
|
|
|
— |
Opcional |
O número máximo de tentativas após uma falha de sessão. |
|
|
|
— |
Opcional |
O timeout da sessão em milissegundos. Defina como |
|
Filtragem de collections
|
Parâmetro |
Padrão |
Obrigatório |
Descrição |
Exemplo |
|
|
— |
Opcional |
Lista de permissões de collections a migrar. Somente as collections listadas são migradas. |
|
|
|
— |
Opcional |
Lista de bloqueios de collections a excluir. Todas as demais collections são migradas. Não pode ser usado em conjunto com |
|
Configurações do destino
|
Parâmetro |
Padrão |
Obrigatório |
Descrição |
Exemplo |
|
|
Error |
Opcional |
Como tratar collections com o mesmo nome já existentes no destino. |
|
|
|
|
Opcional |
Se deve migrar apenas o schema da tabela, sem os dados. |
|
Desempenho da migração completa
|
Parâmetro |
Padrão |
Obrigatório |
Descrição |
Exemplo |
|
|
|
Opcional |
O número máximo de collections migradas simultaneamente. |
|
|
|
|
Opcional |
O número de threads simultâneos de leitura de uma única tabela de origem. Corresponde ao parâmetro |
|
|
|
|
Opcional |
O número de threads de gravação simultâneos por tabela. |
|
|
|
— |
Opcional |
O número de entradas agregadas por gravação. Quando o destino é um banco de dados compatível com DynamoDB, o valor máximo é 25. |
|
|
|
|
Opcional |
O número de threads de parser simultâneos para converter dados do DynamoDB para o protocolo de destino. |
|
|
|
|
Opcional |
Se deve migrar os índices definidos pelo usuário. |
|
|
|
|
Opcional |
Se deve converter um |
|
|
|
|
Opcional |
O número máximo de chamadas do comando |
|
|
|
|
Opcional |
O número de entradas de dados recuperadas por segundo durante a migração completa. |
|
|
|
— |
Opcional |
Uma expressão de filtro do DynamoDB para a migração completa. As variáveis começam com dois pontos, por exemplo |
|
|
|
— |
Opcional |
Os valores para as variáveis em |
|
Desempenho da migração incremental
Ignore esta seção se estiver executando apenas migração completa ( sync_mode = full ).
|
Parâmetro |
Padrão |
Obrigatório |
Descrição |
Exemplo |
|
|
|
Opcional |
Se deve ativar a migração incremental paralela. |
|
|
|
|
Opcional |
O número máximo de shards capturados simultaneamente. |
|
|
|
|
Opcional |
Se deve converter um |
|
|
|
|
Opcional |
Se deve converter um |
|
|
|
|
Opcional |
O número máximo de chamadas do comando |
|
|
|
|
Opcional |
O número de entradas de dados recuperadas por segundo durante a migração incremental. |
|
Configurações de checkpoint
Ignore esta seção se estiver executando apenas migração completa ( sync_mode = full ).
|
Parâmetro |
Padrão |
Obrigatório |
Descrição |
Exemplo |
|
|
— |
Opcional |
O tipo de armazenamento dos dados de checkpoint. |
|
|
|
Banco de dados de destino |
Opcional |
O endereço para armazenamento dos dados de checkpoint. Se |
|
|
|
|
Opcional |
O nome do banco de dados para armazenamento dos checkpoints. O padrão é |
|
Configurações avançadas
|
Parâmetro |
Padrão |
Obrigatório |
Descrição |
Exemplo |
|
|
— |
Opcional |
Um prefixo adicionado ao campo |
|
Etapa 5: Inicie a migração
./nimo-shake.linux -conf=nimo-shake.confAo concluir a migração completa, a saída exibe:
full sync done!Se a migração for interrompida por um erro, o NimoShake imprime a mensagem de erro e encerra. Verifique o arquivo de log ou a saída do stdout para diagnosticar o problema.
Observações de uso
Execute durante períodos de baixo tráfego. A migração completa consome recursos tanto no banco de dados DynamoDB de origem quanto na instância ApsaraDB for MongoDB de destino. Alto tráfego ou especificações de servidor insuficientes podem aumentar a carga sobre os bancos de dados. Agende as migrações em períodos de baixa utilização para minimizar o impacto.
Monitore a migração incremental continuamente. Se a migração incremental for interrompida por um período prolongado ou o checkpoint for perdido, pode ser necessária uma nova migração completa para ressincronizar todos os dados.
A migração incremental não sincroniza índices. Índices criados ou modificados durante a fase incremental não são migrados. Gerencie as alterações de índice no destino manualmente, se necessário.
Conflitos de nome de collection. Se uma collection com o mesmo nome já existir no destino, configure
target.db.existcomorenameoudrop. Sem essa configuração, a migração é interrompida com erro.