As APIs do Model Studio limitam o volume de requisições, o uso de tokens e a taxa de crescimento. Aplique estas estratégias para maximizar o throughput e manter a disponibilidade.
As APIs do Model Studio impõem limites a requisições, uso de tokens e taxa de crescimento ao longo do tempo — isso é a limitação de taxa. Modelos de linguagem grandes apresentam alta latência e possuem restrições em duas dimensões (quantidade de requisições e volume de tokens). Estratégias simples de "tentar novamente em caso de erro" falham nesse cenário; é necessário um controle de tráfego específico.
Três tipos de solução, ordenados do menor para o maior custo de implementação:
- Soluções de configuração da plataforma (alterações mínimas de código): Enfileiramento no servidor, Aumento dos limites de cota, PTU e Batch API.
- Estratégias de controle de tráfego no cliente (alterações no código do cliente): Quatro estratégias com complexidade de engenharia crescente, desde nova tentativa básica até controle de congestionamento adaptativo.
- Soluções de fallback arquitetônico (alterações na arquitetura do sistema): Fallback de modelo e Deslocamento de pico de carga usando filas de mensagens (MQ).
Se você estiver solucionando um erro 429 agora, acesse Diagnóstico de erros e recomendações de estratégia para identificar a causa. Para erros de pico de tráfego, tente primeiro o enfileiramento no servidor — ele requer apenas um cabeçalho de requisição.
Mecanismo de limitação de taxa da plataforma
A plataforma aplica limites de taxa a cada modelo independentemente no nível da conta raiz. Após o acionamento, o serviço geralmente é retomado em até um minuto. Para condições de limitação de taxa e uso atual por modelo, consulte Limitação de taxa e Monitoramento de modelos. Três tipos de regras de limitação se aplicam:
- Limites de cota por minuto (RPM / TPM): Número máximo de requisições por minuto (RPM) e uso máximo de tokens por minuto (TPM).
- Limites de frequência instantânea (RPS / TPS): Máximo de requisições por segundo (RPS) e máximo de uso de tokens por segundo (TPS). Chamadas densas à API ou consumo de tokens dentro de um único segundo podem acionar a limitação de taxa.
- Limites de taxa de crescimento (Pico de Tráfego): Um aumento repentino no volume de requisições ou no uso de tokens aciona a limitação de taxa. O limiar se ajusta dinamicamente. Aumente as requisições gradualmente para evitar o acionamento desse limite.
As seções a seguir abordam soluções em três níveis: configuração da plataforma, controle de tráfego no cliente e fallback arquitetônico.
Diagnóstico de erros e recomendações de estratégia
O mesmo código de erro pode ser acionado por diferentes dimensões de limitação de taxa. Alta concorrência também pode saturar o servidor e causar tempos limite. A estratégia de controle de congestionamento adaptativo ajuda a mitigar esse problema.
Código de erro (DashScope / OpenAI) | Dimensão de acionamento | Diagnóstico de características | Estratégia recomendada |
|---|---|---|---|
Throttling.RateQuota / limit_requests | Taxa de requisições excedida | Erros intermitentes. A taxa de sucesso diminui ao longo do tempo. | Token bucket: Controle a cota de requisições por unidade de tempo. |
Taxa de requisições excedida | Erros concentrados na inicialização ou durante picos de concorrência. | Semáforo de concorrência ou limitador de taxa com suavização: Aumente o intervalo entre requisições. | |
Throttling.AllocationQuota / insufficient_quota | Uso de tokens excedido | Erros intermitentes ao processar textos longos. | Token bucket duplo: Limite as cotas de RPM e TPM simultaneamente. |
Uso de tokens excedido | Consumo instantâneo de tokens muito alto durante o processamento concorrente de textos longos. | Semáforo de concorrência ou limitador de taxa com suavização. | |
Throttling.BurstRate / limit_burst_rate | Taxa de crescimento de tráfego excedida | Grande volume repentino de requisições após a inicialização ou recuperação de um estado ocioso. | Tente primeiro o enfileiramento no servidor. Alternativamente, use um token bucket com valor inicial baixo, como |
Soluções de configuração da plataforma
Estas soluções dependem das capacidades da plataforma e exigem alterações mínimas ou nulas no código do cliente.
Enfileiramento no servidor (recomendado)
Para limitação de taxa por pico de tráfego, o Model Studio aceita um tempo máximo de espera no cabeçalho da requisição. O servidor enfileira e tenta novamente a requisição dentro desse período até que ela comece a ser processada ou o tempo limite da fila expire. Isso melhora significativamente as taxas de sucesso durante picos de tráfego em comparação com uma resposta 429 imediata.
ObservaçãoEste recurso aplica-se apenas à limitação de taxa por taxa de crescimento / pico de tráfego (Throttling.BurstRate). Não se aplica à limitação de taxa por cota absoluta (RPM/TPM).
Adicione o campo X-DashScope-Wait-Timeout ao cabeçalho da requisição:
Campo do cabeçalho | Exemplo | Descrição |
|---|---|---|
X-DashScope-Wait-Timeout | 30 | Tempo máximo de espera em fila para requisições de pico, em segundos.
|
Após habilitar o enfileiramento, ajuste o tempo limite do cliente para considerar o tempo de espera adicionado:
- Requisições sem streaming (stream: false): Tempo limite = tempo limite base original + valor de Wait-Timeout.
- Requisições com streaming (stream: true): Tempo limite > valor de Wait-Timeout. Requisições com streaming iniciam a contagem de tempo após o primeiro chunk, portanto, o tempo limite de resposta inicial precisa apenas exceder o tempo de enfileiramento.
Exemplo: Se o tempo limite base original for 120 segundos e o Wait-Timeout estiver definido como 30 segundos, defina o tempo limite da requisição sem streaming como 150 segundos.
Exemplo de código
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    timeout=150.0,  # Original timeout 120s + queuing wait 30s
)

response = client.chat.completions.create(
    model="qwen-plus",
    messages=[{"role": "user", "content": "Hello"}],
    extra_headers={
        "X-DashScope-Wait-Timeout": "30"  # Maximum queuing wait: 30 seconds
    }
)
print(response.choices[0].message.content)
curl -X POST "https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions" \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
  -H "X-DashScope-Wait-Timeout: 30" \
  -d '{
    "model": "qwen-plus",
    "messages": [{"role": "user", "content": "Hello"}]
  }'
Aumento dos limites de cota
Se a cota padrão for insuficiente, aumente a cota temporária de limite de taxa no console do Model Studio. As alterações entram em vigor imediatamente. Disponível nas regiões China (Pequim) e Singapura.
Cenários: Cota padrão de RPM/TPM insuficiente devido ao crescimento do negócio ou necessidade de aumento temporário de throughput para eventos de curta duração. Consulte Limites de taxa.
Configuração simples. Avalie esta opção antes de tentar estratégias no lado do cliente.
Unidade de throughput provisionada (PTU)
O serviço PTU fornece poder de computação dedicado e reservado. Ele evita contenção no pool de recursos públicos e é a solução preferida para requisitos de alto throughput em tempo real.
Use PTU quando seu negócio tiver requisitos de throughput determinísticos (como compromissos de SLA) ou quando desejar um throughput alto e estável sem controle de tráfego no lado do cliente.
PTUs são recursos reservados cobrados continuamente, mesmo quando não totalmente utilizados. Avalie as especificações necessárias com base na carga de pico real para evitar desperdício.
Processamento em lote assíncrono (Batch API)
Para tarefas sem requisitos rígidos de tempo real (limpeza de dados, análises em lote), use a Batch API para enviá-las para processamento em lote. As tarefas são executadas fora dos horários de pico, retornam resultados de forma assíncrona e não estão sujeitas aos limites de taxa online.
Indicado para tarefas offline que toleram tempos de retorno de horas a dias: anotação de dados, análise de logs, resumo em lote. Os custos da Batch API são tipicamente menores que os das chamadas de API em tempo real.
O tempo de retorno não é garantido. Não adequado para serviços que exigem respostas imediatas. Recupere os resultados via polling ou callback após o envio.
Estratégias de controle de tráfego no cliente
Quando as soluções da plataforma (como enfileiramento no servidor e aumentos de cota) não forem suficientes, adicione controle de tráfego no lado do cliente. O princípio central: distribuir requisições uniformemente dentro de uma janela de tempo para evitar picos. Após a inicialização do sistema ou um longo período ocioso, aumente a concorrência gradualmente.
Quatro estratégias em ordem crescente de complexidade. Cada uma inclui a anterior e adiciona novos elementos:
- Nova tentativa básica oferece apenas defesa passiva.
- Limitação de taxa de requisições adiciona enfileiramento ativo.
- Modelagem de tráfego introduz ainda controle no nível de token e envio suave.
- Controle de congestionamento adaptativo ajusta dinamicamente a taxa de envio com base em feedback em tempo real.
Escolha a estratégia de menor custo que atenda às suas necessidades.
Comparação de desempenho de throughput de cada estratégia
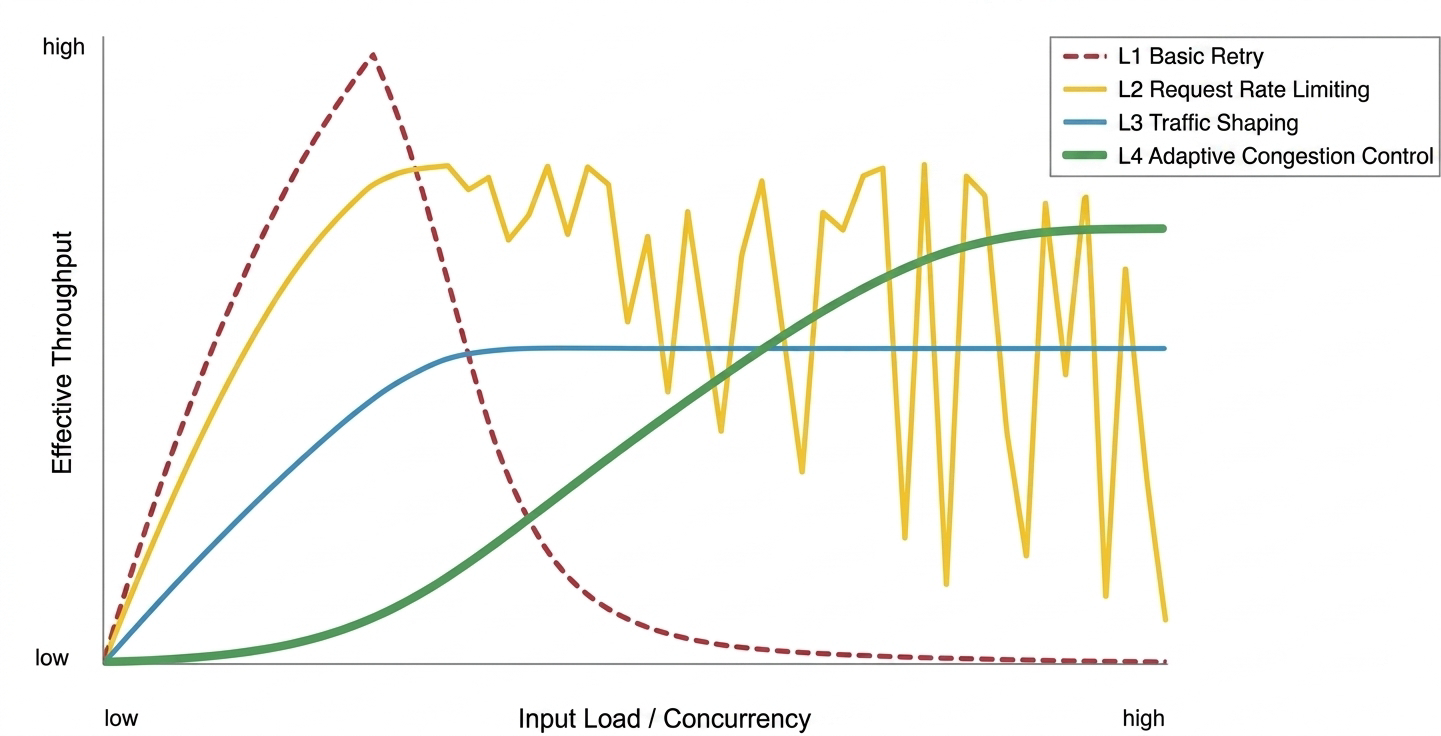
Comparação de throughput sob diferentes cargas:
- Estratégia de nova tentativa básica: Eficaz sob baixa carga. Propensa a colapso congestivo sob alta concorrência, causando uma queda acentuada no throughput.
- Estratégia de limitação de taxa de requisições: Forte proteção contra colapso. No entanto, sob cargas mistas com textos longos, o throughput apresenta flutuações semelhantes a dentes de serra devido à falta de controle de tokens.
- Estratégia de modelagem de tráfego: Alta estabilidade. Alcança uma saída suave sacrificando parte do throughput de pico.
- Estratégia de controle de congestionamento adaptativo: Converge dinamicamente para um ponto de throughput alto e estável sob carga elevada, mas possui sobrecarga de sondagem na inicialização a frio.
Estratégia de nova tentativa básica
Adequada para testes pessoais, scripts locais e tarefas em segundo plano de baixa frequência. Sem limite de taxa nas requisições de saída. Aciona apenas nova tentativa com backoff exponencial e variação aleatória (jitter) em erros 429 ou 5xx.
Sem controle proativo de tráfego. Sob concorrência multithread, isso aciona facilmente a limitação de taxa e causa acúmulo de requisições.
Exemplo de código
import openai
from openai import OpenAI
from tenacity import (
    retry,
    stop_after_attempt,
    wait_random_exponential,
    retry_if_exception_type
)

RETRYABLE_ERRORS = (
    openai.RateLimitError,
    openai.InternalServerError,
    openai.APIConnectionError,
)

@retry(
    wait=wait_random_exponential(min=1, max=60),
    stop=stop_after_attempt(6),
    retry=retry_if_exception_type(RETRYABLE_ERRORS)
)
def chat_with_retry(client, model, messages, max_tokens):
    return client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=messages
    )

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    api_key="YOUR_DASHSCOPE_API_KEY"
)

try:
    response = chat_with_retry(
        client=client,
        model="qwen-plus",
        messages=[{"role": "user", "content": "What is exponential backoff retry?"}],
        max_tokens=1024
    )
    print(response.choices[0].message.content)
except Exception as e:
    print(f"Request failed: {e}")
import time
import random
import openai
from openai import OpenAI

RETRYABLE_ERRORS = (
    openai.RateLimitError,
    openai.InternalServerError,
    openai.APIConnectionError,
)

def chat_with_retry(client, model, messages, max_tokens):
    attempt = 0
    max_retries = 5
    base_delay = 1
    max_delay = 60

    while attempt <= max_retries:
        try:
            return client.chat.completions.create(
                model=model,
                max_tokens=max_tokens,
                messages=messages
            )
        except RETRYABLE_ERRORS as e:
            attempt += 1
            if attempt > max_retries:
                raise e
            backoff = min(max_delay, base_delay * (2 ** (attempt - 1)))
            sleep_time = backoff + random.uniform(0, 1)
            print(f"Triggered {type(e).__name__}, retrying after {sleep_time:.2f}s...")
            time.sleep(sleep_time)

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    api_key="YOUR_DASHSCOPE_API_KEY"
)

try:
    response = chat_with_retry(
        client=client,
        model="qwen-plus",
        messages=[{"role": "user", "content": "What is exponential backoff retry?"}],
        max_tokens=1024
    )
    print(response.choices[0].message.content)
except Exception as e:
    print(f"Request failed: {e}")
O código usa backoff exponencial, não nova tentativa com intervalo fixo. Nova tentativa com intervalo fixo faz com que todas as requisições falhas sejam reenviadas simultaneamente, acionando a limitação de taxa novamente. Backoff exponencial com variação aleatória espalha as novas tentativas:
- Tempo de espera dobra progressivamente: Por exemplo,
1s, 2s, 4s.... Isso evita requisições repetidas em um curto período. - Adição de variação aleatória: Um valor aleatório (como
2s +/- 0.5s) espalha o tráfego de novas tentativas, prevenindo uma inundação secundária (efeito manada).
O sistema se recupera gradualmente em vez de ficar preso em um ciclo de "falha — nova tentativa em uníssono — falha novamente".
Estratégia de limitação de taxa de requisições
Novas tentativas passivas sozinhas não conseguem lidar com tráfego real. Tentativas frequentes aumentam a latência. Esta estratégia introduz controle ativo de tráfego: verifique e limite as requisições antes de enviá-las, organizando o tráfego desordenado em uma fila que respeita o limite de RPM. A suavização ativa adiciona um pequeno atraso de enfileiramento previsível — muito menor que o custo de um ciclo de "erro — espera — nova tentativa". Um pequeno custo conhecido é melhor que um grande custo desconhecido.
Ideal para chatbots e outros serviços leves de requisição-resposta sensíveis ao tempo até o primeiro token.
O enfileiramento ativo no lado do cliente usa dois níveis de controle:
- Token bucket de RPM: Limita o total de requisições por minuto. A capacidade do bucket é igual à cota de RPM; os tokens são reabastecidos a uma taxa constante. Suporta empréstimo: se os tokens forem insuficientes, uma requisição toma emprestado da cota futura, estritamente em ordem FIFO.
- Semáforo de concorrência: Limita requisições concorrentes para evitar que alta concorrência instantânea acione limites de RPS.
Execute esses dois níveis em ordem estrita: adquira o token de RPM primeiro, depois adquira o semáforo. Slots de concorrência são escassos — aloque-os apenas para requisições prontas para execução. Inverter a ordem causa bloqueio de cabeça de linha sob alta carga: requisições mantêm slots mas não têm tokens, todos os slots ficam cheios, nada é enviado. Princípio: não mantenha um recurso escasso enquanto espera.
O código abaixo inicializa o token bucket cheio (initial_tokens=rpm_limit), adequado para serviços online que precisam processar requisições imediatamente na inicialização. Se um bucket cheio acionar limitação de taxa, reduza o valor inicial (por exemplo, initial_tokens=0 para uma "inicialização com bucket vazio") para aumentar a carga mais gradualmente.
Esta estratégia não rastreia o uso de tokens. Tarefas de texto longo ainda podem esgotar a cota de TPM.
Exemplo de código
import time

class TokenBucket:
    """
    Token bucket implementation to control requests per minute (RPM).
    Supports a debt mechanism to ensure first-in, first-out (FIFO) order under high concurrency.
    """
    def __init__(self, quota_per_minute: float, initial_tokens: float = 0.0):
        self.capacity = quota_per_minute
        self.tokens = initial_tokens
        self.refill_rate = quota_per_minute / 60.0
        self.last_refill = time.monotonic()

    def reserve(self, cost: float = 1.0) -> float:
        """
        Acquires a token.
        If tokens are insufficient, returns the number of seconds to wait (supports debt).
        """
        self._refill()

        # 1. Sufficient tokens: Deduct directly
        if self.tokens >= cost:
            self.tokens -= cost
            return 0.0

        # 2. Insufficient tokens: Calculate wait time and incur debt
        # "Reserves" future tokens for the current request to ensure FIFO order
        deficit = cost - self.tokens
        wait_seconds = deficit / self.refill_rate
        self.tokens -= cost
        return wait_seconds

    def _refill(self):
        """Refills tokens based on elapsed time."""
        now = time.monotonic()
        elapsed = now - self.last_refill
        if elapsed > 0:
            self.tokens = min(self.capacity, self.tokens + elapsed * self.refill_rate)
            self.last_refill = now
import asyncio
import openai
from openai import AsyncOpenAI
from tenacity import retry, wait_random_exponential, stop_after_attempt, retry_if_exception_type

class RateLimitedClient:
    def __init__(
        self,
        api_key: str,
        base_url: str = "https://dashscope.aliyuncs.com/compatible-mode/v1",
        rpm_limit: float = 600.0,
        max_concurrency: int = 20
    ):
        self.client = AsyncOpenAI(api_key=api_key, base_url=base_url)
        # Component 1: RPM token bucket (controls total volume)
        self.rpm_bucket = TokenBucket(
            quota_per_minute=rpm_limit,
            initial_tokens=rpm_limit  # Start with a full bucket, suitable for lightweight online services
        )
        # Component 2: Concurrency semaphore (controls instantaneous concurrency)
        self.semaphore = asyncio.Semaphore(max_concurrency)

    async def _execute_request(self, model, messages, max_tokens):
        """Executes a single request, passing through RPM check and concurrency limit in order."""
        # 1. RPM check (acquire token first)
        wait_seconds = self.rpm_bucket.reserve(1.0)
        if wait_seconds > 0:
            await asyncio.sleep(wait_seconds)
        # 2. Concurrency check (acquire semaphore next)
        async with self.semaphore:
            # 3. Make the API call
            return await self.client.chat.completions.create(
                model=model,
                messages=messages,
                max_tokens=max_tokens
            )

    @retry(
        wait=wait_random_exponential(min=1, max=60),
        stop=stop_after_attempt(5),
        retry=retry_if_exception_type((
            openai.RateLimitError,
            openai.InternalServerError,
            openai.APIConnectionError
        ))
    )
    async def chat_with_limit(self, model, messages, max_tokens=1024):
        # Design consideration: Why do retries also need to re-acquire a token?
        # Ans: For safety. Without re-acquisition, the traffic pulse from retries
        # could instantly exceed the RPM limit.
        return await self._execute_request(model, messages, max_tokens)
Estratégia de modelagem de tráfego
Em cenários de lote que exigem throughput alto e estável (ingestão RAG em tempo real, análise em massa de documentos longos), a limitação de taxa de requisições tem um ponto cego de TPM. A modelagem de tráfego adiciona consciência dupla de recursos (RPM & TPM) e um mecanismo de modelagem que converte tráfego irregular em um fluxo suave.
Melhorias em relação à limitação de taxa de requisições:
- Controle duplo de recursos (RPM & TPM): Mantém buckets de tokens tanto para RPM quanto para TPM. Todas as requisições devem passar pelas verificações de cota de ambas as dimensões antes do envio.
- Pré-dedução para entrada, liquidação posterior para saída: O comprimento da saída é desconhecido antes da requisição. O bucket de TPM pré-deduz tokens de entrada no envio e liquida os tokens reais de saída após a conclusão. Mesmo que os tokens fiquem negativos, requisições subsequentes esperam até que a contagem se torne positiva, suavizando naturalmente o fluxo.
- Warm-up contínuo: Durante uma inicialização a frio, a taxa de emissão de tokens aumenta linearmente ao longo do tempo, eliminando o risco de picos iniciais.
- Limitador de taxa com suavização (Pacing): Suaviza a taxa de envio impondo um intervalo mínimo entre requisições (pacing), reduzindo o risco de acionar limites de taxa.
Alternativa: Se um pequeno atraso de enfileiramento na inicialização for aceitável, reutilize o token bucket padrão (defina initial_tokens=0) para uma inicialização segura com menor complexidade. O token bucket Python aqui serve para demonstração. Em produção, use bibliotecas maduras de limitação de taxa, como SmoothRateLimiter do Guava em Java.
No exemplo de código, a espera de suavização é colocada dentro do bloqueio de concorrência. Múltiplas requisições podem competir pelo semáforo simultaneamente após o término de sua espera, reagrupando o tráfego na saída. A suavização dentro do bloqueio reduz ligeiramente a eficiência da concorrência, mas garante intervalos de envio precisos.
O pipeline completo de modelagem de tráfego é: Estimar tokens de entrada → Admissão dupla (RPM & TPM) → Bloqueio de concorrência → Modelagem de tráfego → Enviar → Liquidar tokens de saída.
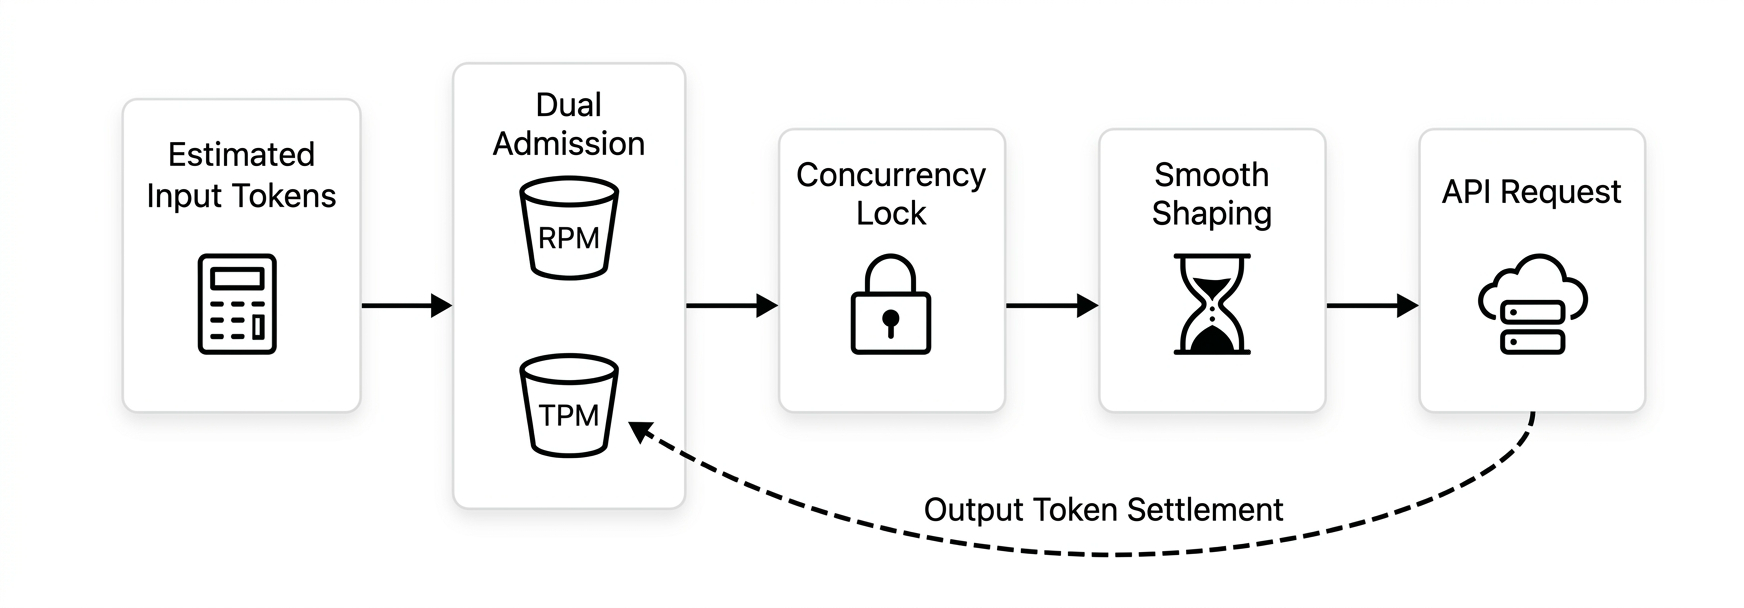
A suavização conservadora sacrifica alguma concorrência de pico. Não adequada para serviços que exigem latência extremamente baixa.
Exemplo de código
import time

class TokenBucket:
    """Advanced token bucket that supports a continuous warm-up mechanism."""
    def __init__(self, quota_per_minute: float, warmup_seconds: float = 0.0):
        self.capacity = quota_per_minute
        self.tokens = 0.0
        self.target_refill_rate = quota_per_minute / 60.0
        self.warmup_seconds = warmup_seconds
        self.start_time = time.monotonic()
        self.last_update_time = self.start_time
        self.cumulative_generated = 0.0

    def _get_cumulative_tokens(self, t: float) -> float:
        if t <= 0:
            return 0.0
        R = self.target_refill_rate
        T = self.warmup_seconds
        if T <= 0:
            return R * t
        if t <= T:
            return (R / (2 * T)) * (t ** 2)
        else:
            warmup_total = (R * T) / 2.0
            return warmup_total + R * (t - T)

    def _get_time_for_cumulative_tokens(self, target_cumulative: float) -> float:
        if target_cumulative <= 0:
            return 0.0
        R = self.target_refill_rate
        T = self.warmup_seconds
        if T <= 0:
            return target_cumulative / R
        warmup_total = (R * T) / 2.0
        if target_cumulative <= warmup_total:
            return ((2 * T * target_cumulative) / R) ** 0.5
        else:
            return (target_cumulative - warmup_total) / R + T

    def reserve(self, cost: float = 1.0) -> float:
        now = time.monotonic()
        relative_now = now - self.start_time
        current_cumulative = self._get_cumulative_tokens(relative_now)
        new_tokens = current_cumulative - self.cumulative_generated
        self.tokens = min(self.capacity, self.tokens + new_tokens)
        self.cumulative_generated = current_cumulative
        self.last_update_time = now
        if self.tokens >= cost:
            self.tokens -= cost
            return 0.0
        deficit = cost - self.tokens
        self.tokens -= cost
        target_cumulative = self.cumulative_generated + deficit
        target_time = self._get_time_for_cumulative_tokens(target_cumulative)
        wait_seconds = target_time - relative_now
        return max(0.0, wait_seconds)

    def adjust(self, amount: float):
        self.tokens = min(self.capacity, self.tokens + amount)
import time

class SmoothRateLimiter:
    def __init__(self, rate_per_minute: float):
        self._min_interval = 60.0 / rate_per_minute
        self._last_operation = time.monotonic()

    def reserve(self) -> float:
        now = time.monotonic()
        elapsed = now - self._last_operation
        wait_time = max(0.0, self._min_interval - elapsed)
        self._last_operation = now + wait_time
        return wait_time
import asyncio

class TrafficShapingClient:
    def __init__(self):
        self._rpm_bucket = TokenBucket(quota_per_minute=600)
        self._tpm_bucket = TokenBucket(quota_per_minute=1_000_000)
        self._smooth_limiter = SmoothRateLimiter(rate_per_minute=600)
        self._concurrency_semaphore = asyncio.Semaphore(20)

    async def _execute_throttled_request(self, model, prompt, max_tokens, input_tokens):
        # [Step 1] Dual admission control
        # Check both RPM and TPM, and take the longer wait time
        wait_rpm = self._rpm_bucket.reserve(1.0)
        # The TPM check only requests a quota for input tokens
        wait_tpm = self._tpm_bucket.reserve(input_tokens)
        admission_wait = max(wait_rpm, wait_tpm)
        if admission_wait > 0:
            await asyncio.sleep(admission_wait)

        # [Step 2] Acquire concurrency lock
        async with self._concurrency_semaphore:
            # [Step 3] Traffic shaping
            # Key: Perform smoothing wait inside the lock
            # Sacrifices some concurrency efficiency for precise control over send intervals
            smooth_wait = self._smooth_limiter.reserve()
            if smooth_wait > 0:
                await asyncio.sleep(smooth_wait)

            # [Step 4] Send request
            content, actual_usage = await self._send_chat_request(model, prompt, max_tokens)

            # [Step 5] Settle output tokens
            output_tokens = actual_usage.completion_tokens
            if output_tokens > 0:
                self._tpm_bucket.adjust(-output_tokens)
            return content
Estratégia de controle de congestionamento adaptativo
Adequada para cargas de trabalho dinâmicas e de grande escala: gateways de API, proxies complexos, sistemas multilocatários.
Observação
Dica de seleção: Esta estratégia não é uma solução universalEsta estratégia lida com ambientes altamente incertos e voláteis. Não é uma escolha universal:
- Paradoxo de desempenho: Se a carga for previsível (como processamento em lote), parâmetros estáticos ótimos superam a sondagem dinâmica que precisa de "tentativa e convergência".
- Sobrecarga de sondagem: Algoritmos dinâmicos envolvem inevitavelmente rampa de inicialização a frio e flutuações exploratórias — sobrecarga desnecessária em cenários conhecidos.
- Custo de manutenção: Feedback em malha fechada aumenta a complexidade do sistema e a dificuldade de solução de problemas.
A menos que seu negócio tenha escala muito grande, carga complexa e volatilidade significativa, escolha uma das três primeiras estratégias mais simples.
A limitação de taxa de requisições e a modelagem de tráfego são estratégias de cota estática — funcionam bem sob cargas estáveis e previsíveis. Mas no nível do gateway, as cargas downstream mudam constantemente (requisições curtas misturadas com inferência profunda), e os limiares da plataforma flutuam dinamicamente. Estratégias estáticas têm dificuldade em equilibrar eficiência e estabilidade.
Inspirada pelo BBR, esta estratégia constrói um sistema de controle em malha fechada baseado em EBP (Sondagem de Largura de Banda Elástica). Ela usa cotas de RPM/TPM como limite superior orientador e calcula dinamicamente a taxa ideal de envio a partir de feedback em tempo real (mudanças de latência, sinais de limite de taxa).
- EBP: Armazena a marca d'água histórica de maior sucesso. Calcula o ganho de sondagem simulando a tensão de uma mola com base na distância da concorrência atual até a marca d'água (mais longe = mais rápido, mais perto = mais lento). Adiciona um pequeno impulso linear para continuar explorando mesmo em alta saturação.
- Consciência de congestionamento TPT: O tempo de geração de LLM escala com o comprimento da saída — alta latência em textos longos não significa congestionamento. TPT (Tempo Por Token) filtra o ruído de comprimento de conteúdo. O congestionamento só é declarado quando o TPT degrada significativamente.
- Governador de taxa anti-pico: Independentemente do alvo EBP, o governador limita a aceleração do crescimento da concorrência para garantir uma rampa suave e evitar mudanças abruptas que acionem limites de taxa de crescimento.
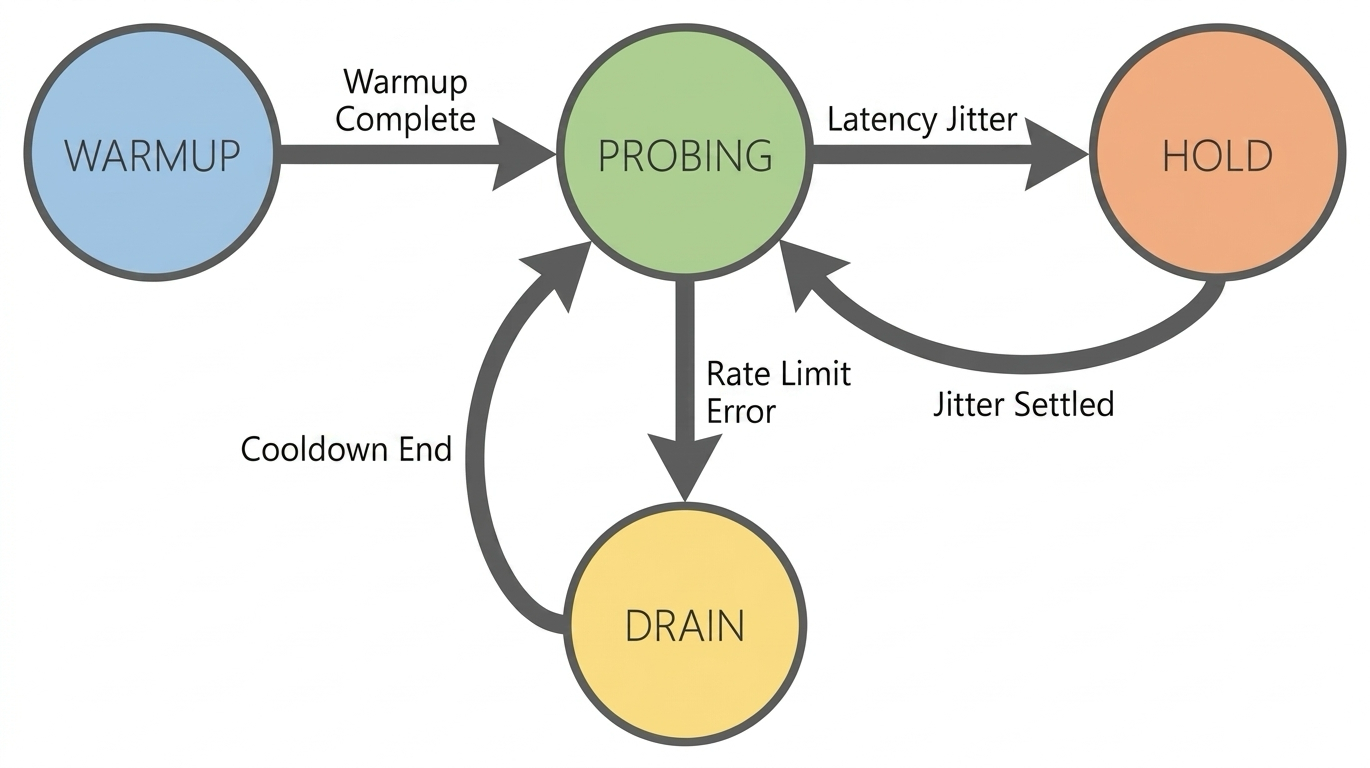
Principais modificações do BBR nativo para grandes modelos:
- Sondagem guiada: Introduz cotas conhecidas de RPM/TPM como um "limite superior orientador" para evitar colisões frequentes causadas por sondagem cega.
- Fonte de sinal (RTT → TPT): O BBR nativo usa RTT. Em cenários de LLM, a latência de comprimento de conteúdo ofusca o jitter de rede. O TPT elimina essa interferência.
- Aprimoramento do mecanismo de resposta (ProbeRTT → Hold): Diante de flutuações de latência, opta por manter o nível atual de concorrência em vez de recuar proativamente e reduzir o throughput.
- Resposta a limite rígido de taxa (Packet Loss → 429 Drain): Uma vez que um erro
429é acionado, entra em um estado agressivo de Drenagem e realiza uma recuperação rápida após um período de resfriamento.
Limitações:
- Ruído no TPT: O TPT é estimado como "latência total / total de tokens". A latência total inclui ida e volta de rede, enfileiramento e tempo até o primeiro token — suscetível a jitter ou entradas longas, o que pode acionar falsamente o estado Hold.
- Inanição de requisições grandes: Usa um despertar FIFO não estrito para desempenho de agendamento. Quando as cotas são escassas, requisições de poucos tokens podem preemptar recursos, fazendo com que requisições de muitos tokens esperem demais.
- Inicialização a frio: Requer um período de aquecimento para construir um modelo estatístico. Em tarefas de baixa carga ou curta duração, o throughput pode ser menor que nas três primeiras estratégias.
Exemplo de código
class ElasticCongestionController:
    async def acquire(self):
        """[Admission phase] Check before initiating a request"""
        # 1. SSR slow-start restart: If idle for too long, proactively decay the limit
        #    to prevent burst traffic caused by an outdated watermark.
        if self.is_idle_too_long():
            self.perform_slow_start_restart()

        # 2. Circuit breaker check: If in DRAIN (cooldown) state, force wait.
        if self.state == CongestionState.DRAIN:
            await self.wait_for_cooldown()

        # 3. Dual budget check: Check both concurrency slots and token budget.
        await self.wait_for_budget(request_tokens)

    async def release(self, latency, actual_tokens, error):
        """[Feedback phase] Decision after the request finishes"""
        if error:
            # [Fault response] On rate limit error (429/503): Immediately drain + multiplicative backoff
            self.state = CongestionState.DRAIN
            self.concurrency_limit *= self.backoff_factor  # e.g. 0.7
            return

        # [Normal response] Calculate TPT (Time-Per-Token)
        current_tpt = latency / actual_tokens

        # [Congestion awareness] TPT spike (generation slows down): Enter HOLD to observe
        # Maintain concurrency level, neither backing off nor increasing
        if current_tpt > self.metrics.ema_tpt * 2.0:
            self.state = CongestionState.HOLD
        else:
            # [Steady-state probing] Network is healthy: Perform EBP elastic probing
            self.state = CongestionState.PROBING
            self.update_limit_via_ebp()
def probe_next_limit(self, current_limit, max_known_capacity):
    """
    Calculate the next concurrency limit
    Core formula: Next = Max(Spring Tension, Additive Thrust) + Governor Smoothing
    """
    # 1. Calculate physical limit (Little's Law)
    # Theoretical limit = Throughput * Latency * Buffer Factor
    dynamic_ceiling = self.metrics.tps * self.metrics.avg_latency * 1.2

    # 2. Spring logic (Spring Tension)
    # The farther from the historical high watermark, the greater the tension (accelerate); the closer, the smaller (decelerate)
    tension = 1.0 - (current_limit / max_known_capacity)
    spring_target = current_limit * (1.0 + tension * gain)

    # 3. Additive thrust
    # Solves the "Zeno's Paradox": When tension approaches 0, forcibly add a small linear increment
    # to ensure the system can break out of local maxima and continue exploring the boundary.
    linear_target = current_limit + self.min_additive_step

    raw_target = max(spring_target, linear_target)

    # 4. Anti-burst rate governor
    # Limits the acceleration of concurrency growth to prevent step changes.
    final_limit = self.governor.smooth(raw_target)

    return min(final_limit, dynamic_ceiling)
class CongestionMetrics:
    def update_stats(self, latency, token_count):
        """
        [Sensor] Update statistical metrics in real time
        Use EMA (exponential moving average) to filter out noise from long-tail requests
        """
        alpha = 0.2  # Smoothing factor

        # 1. Estimate single request size (Token Size)
        self.ema_tokens = (1 - alpha) * self.ema_tokens + alpha * token_count

        # 2. Estimate TPT (Time Per Token)
        # Use TPT instead of Latency to eliminate errors caused by different LLM generation lengths
        instant_tpt = latency / token_count
        self.ema_tpt = (1 - alpha) * self.ema_tpt + alpha * instant_tpt

    def track_inflight(self, estimated_tokens):
        """
        [Blind spot filling] Correct the lag of "counting only after response"
        Pre-deduct the quota the moment a request is initiated
        """
        self.inflight_tokens += estimated_tokens
Soluções de fallback arquitetônico
Quando a configuração da plataforma e o controle de tráfego no cliente ainda não conseguem atender aos requisitos de disponibilidade ou throughput de pico, adicione mecanismos de fallback no nível da arquitetura.
Fallback de modelo
Quando o modelo primário não consegue responder devido a limitação de taxa ou problemas de serviço, faça fallback automaticamente para um modelo alternativo com cota mais generosa.
Princípios de design do caminho de fallback- Escolha modelos de séries diferentes: A limitação de taxa é por modelo. Use um modelo diferente como fallback — por exemplo, faça fallback de
qwen3.6-plusparaqwen3.6-flash. - Acione o fallback apenas em erros de limite de taxa: Faça fallback em erros
429, não em todas as exceções. Trocar modelos não corrigirá tempos limite de rede ou erros de parâmetro. - Valide o modelo de fallback antecipadamente: Garanta que ele suporte os recursos necessários (Function Calling, saída estruturada, etc.) para evitar problemas funcionais após o fallback.
Exemplo de código
O exemplo a seguir demonstra a lógica de fallback de modelo baseada no código de erro 429. Quando uma requisição ao modelo primário aciona a limitação de taxa, ela muda automaticamente para o modelo de fallback para uma nova tentativa.
import os
import asyncio
from openai import AsyncOpenAI, APIStatusError

# Primary and fallback models (different series, independent quotas)
PRIMARY_MODEL = "qwen3.6-plus"
FALLBACK_MODEL = "qwen3.6-flash"

client = AsyncOpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

async def chat_with_fallback(messages: list) -> str:
    """Request with fallback: Automatically switches to the fallback model when the primary model is rate-limited."""
    for model in [PRIMARY_MODEL, FALLBACK_MODEL]:
        try:
            response = await client.chat.completions.create(
                model=model,
                messages=messages
            )
            return response.choices[0].message.content
        except APIStatusError as e:
            if e.status_code == 429 and model == PRIMARY_MODEL:
                print(f"[Rate Limit Triggered] {model}, falling back to {FALLBACK_MODEL}")
                continue
            raise
    raise RuntimeError("All models are unavailable")

async def main():
    result = await chat_with_fallback(
        messages=[{"role": "user", "content": "Hello"}]
    )
    print(result)

if __name__ == "__main__":
    asyncio.run(main())
O fallback de modelo pode ser combinado com estratégias de controle de tráfego no cliente. Por exemplo, integre a lógica de fallback no mecanismo de nova tentativa da estratégia de limitação de taxa de requisições. Quando as novas tentativas se esgotarem e a limitação de taxa ainda for acionada, mude para o modelo de fallback.
Deslocamento de pico de carga usando filas de mensagens (MQ)
Para serviços de backend que não exigem respostas imediatas, introduza um middleware de mensagens (RabbitMQ, Kafka) para deslocamento de pico de carga. O tráfego de pico vai primeiro para o MQ; os consumidores puxam e processam a uma taxa constante correspondente à cota de limite de taxa. Isso desacopla os picos de frontend das chamadas de backend.
Indicado para negócios onde os usuários aceitam resultados assíncronos: processamento de tickets, moderação de conteúdo, anotação de dados em lote.
Pontos-chave de design:
- Controle de taxa do consumidor: O lado do consumidor deve usar a estratégia de limitação de taxa de requisições ou modelagem de tráfego para consumir mensagens a uma taxa constante com base na cota de RPM/TPM, em vez de puxar mensagens sem limites.
- Tratamento de mensagens mortas: Mova mensagens que falham após múltiplas tentativas para uma fila de mensagens mortas e acione um alerta. Evite que tentativas infinitas bloqueiem o consumo.
- Propagação de contrapressão: Quando o backlog do MQ excede um limiar, propague a pressão para montante (por exemplo, retorne um status de enfileiramento) para evitar crescimento ilimitado da fila.
Considerações para ambiente de produção
Os exemplos de código usam um loop de thread única asyncio do Python para demonstrar algoritmos principais. Antes do uso em produção em larga escala, considere o seguinte.
-
Adaptação para modelos não textuais
As estratégias acima usam modelos de texto como exemplos, mas os princípios centrais aplicam-se a serviços multimodais (geração de imagens, síntese de fala). As unidades diferem, mas a essência é a mesma: limitar a taxa de envio e a capacidade de processamento.
- Modelos como reconhecimento de fala são tipicamente restringidos tanto pelo número de requisições por unidade de tempo (como RPM) quanto pelo uso (como duração do áudio). As estratégias são basicamente as mesmas para modelos de texto.
- Modelos para imagens e vídeos são tipicamente restringidos pela taxa de envio de tarefas e pelo número de tarefas concorrentes. Use a mesma abordagem da estratégia de limitação de taxa de requisições: limite a taxa de envio de tarefas e use um semáforo para controlar a concorrência.
Independentemente de como as métricas mudam, o princípio de limitação no lado do cliente permanece o mesmo. Substitua o contador ou métrica de sondagem pelo da sua modalidade. Para regras específicas, consulte Limitação de taxa.
-
Atomicidade em modelos concorrentes
Exemplo:
asynciousa agendamento cooperativo de thread única, então modificações de estado são inerentemente atômicas dentro de um único processo.Produção: Em ambientes multithread ou multiprocesso, garanta a segurança de concorrência do token bucket e da janela de estatísticas. Condições de corrida quebrarão o controle de tráfego.
-
Limitação de taxa distribuída
Exemplo: Todos os componentes de controle de tráfego estão em memória.
Produção: Em implantações de múltiplas instâncias, cada instância limita independentemente. O uso total pode exceder o limite. Use um contador centralizado (como Redis) para gerenciar o uso em todos os nós.
-
Filas prioritárias e prevenção de inanição
Exemplo: Sem diferenciação de prioridade. A estratégia de controle de congestionamento adaptativo usa despertar FIFO não estrito para desempenho de agendamento.
Produção: Para requisições de alta/baixa prioridade, implemente uma fila prioritária ponderada para garantir largura de banda para tráfego de alta prioridade. Reserve uma cota mínima para filas de baixa prioridade para prevenir inanição.