Este tópico mostra como implantar um modelo Qwen no Alibaba Cloud Model Studio por meio de chamadas de API.
Pré-requisitos
- Você já leu a Visão geral da implantação de modelos e está familiarizado com os modelos suportados e as etapas básicas de implantação.
- Obtenha uma chave de API e exporte a chave de API como uma variável de ambiente.
1. Implante o modelo
O comando a seguir usa o modelo personalizado ajustado qwen3-8b-ft-202511132025-0260 para criar um serviço dedicado chamado qwen3-8b-ft-202511132025-0260.
Para obter o ID do modelo personalizado, acesse a página Console do Model Studio - ajuste fino de modelos. Clique no Task Name do modelo que deseja implantar, clique em Outputs e, em seguida, clique no nome azul do modelo. Isso abre a página My Models, na qual é possível encontrar o Model ID na seção de informações básicas.
Use o Model ID como entrada para o parâmetro model_name para implantar o modelo por meio da API.
Throughput provisionado (PTU)
ObservaçãoApós executar o comando de implantação, o faturamento começa assim que o serviço é implantado com sucesso, mesmo que você não o utilize. Antes de prosseguir, recomendamos revisar as regras de faturamento do serviço.
O método de faturamento por throughput provisionado cobra com base na duração do uso. Esse método é adequado para cenários que exigem throughput estável, alta concorrência, baixa latência e tráfego previsível. Nesse modo, a plataforma provisiona tanto o throughput/concorrência quanto a velocidade de geração, que não podem ser ajustados.
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "name": "my_qwen_flash",
    "model_name": "qwen-flash-2025-07-28",
    "plan": "ptu",
    "ptu_capacity": {
        "input_tpm": 10000,
        "output_tpm": 1000
    }
}'
Unidade de modelo
Observação
- Após executar o comando de implantação, o faturamento começa assim que o serviço é implantado com sucesso, mesmo que você não o utilize. Antes de prosseguir, recomendamos revisar as regras de faturamento do serviço.
- Os recursos de computação do plano pós-pago de unidade de modelo são alocados por ordem de chegada. Se a compra não for bem-sucedida, um reembolso integral será emitido.
O método de faturamento por unidade de modelo cobra com base na duração do uso. Esse método de faturamento é ideal para tarefas de inferência em larga escala após o ajuste fino do modelo, oferecendo recursos dedicados com ajustes flexíveis de desempenho e custo. É possível personalizar tanto o throughput/concorrência quanto a velocidade de geração.
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "name": "my_qwen_plus",
    "model_name": "qwen-plus-2025-12-01",
    "plan": "mu",
    "deploy_spec": "MU1",
    "enable_thinking": true,
    "capacity": 4,
    "max_context_length": 10000,
    "rpm_limit": 500,
    "tpm_limit": 1000
}'
O modo de implantação por unidade de modelo suporta as seguintes configurações adicionais:
Item de configuração | Detalhes da configuração |
Nome do serviço | Nome personalizado para o serviço de implantação. |
Seleção do modelo | Selecione o modelo a ser implantado, incluindo modelos integrados da plataforma e modelos ajustados. |
Tipo de unidade de modelo | Selecione a especificação de implantação. Especificações diferentes correspondem a diferentes capacidades de computação e desempenho. |
Contagem de réplicas de implantação | Defina o número inicial de réplicas de implantação, que afeta a capacidade de concorrência do serviço. |
Modelo de implantação | Selecione um modelo de implantação (como "single-node deployment"). Modelos diferentes correspondem a diferentes esquemas de configuração de recursos. Disponível apenas no modo de faturamento por unidade de modelo. |
Configuração do modo de inferência do modelo | Para alguns modelos implantados no modo Unidade de Modelo, é possível configurar o modo de inferência, o comprimento máximo do contexto e outras opções.
|
Comprimento máximo do contexto | O modo de implantação por Unidade de Modelo de alguns modelos suporta essa configuração. O comprimento máximo do contexto depende do tipo de modelo. |
Limitação de taxa do serviço | O modo de implantação por Unidade de Modelo de alguns modelos suporta essa configuração. É possível limitar as RPM e as TPM das chamadas do modelo. |
Para saber como definir essas configurações usando a API, consulte Criar uma tarefa de implantação de modelo usando uma API.
Uso de tokens
Com o faturamento por uso de tokens, a cobrança é baseada no consumo de tokens. Esse método é adequado para cenários sensíveis a custos, em que os requisitos de concorrência e latência não são críticos. Este modo oferece a melhor vantagem de preço; a plataforma provisiona o throughput/concorrência e a velocidade de geração, que não podem ser ajustados.
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model_name": "qwen3-8b-ft-202511132025-0260",
    "plan": "lora",
    "capacity": 1,
    "name": "qwen3-8b-ft"
}'
O parâmetro
capacityé obrigatório, mas atualmente não tem efeito. Para solicitar dimensionamento, acesse o Dedicated Deployment console e envie um formulário.
CLI dashscope
Chame por meio da linha de comando dashscope.
export DASHSCOPE_API_KEY="your-api-key"
# Replace {WorkspaceId} with your workspace ID, ap-southeast-1 with your region (e.g., us-east-1, eu-central-1)
export DASHSCOPE_HTTP_BASE_URL="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1"
# List deployed dedicated services
dashscope deployments list

# Create a dedicated service (--plan required)
# plan options: ptu (PTU reserved resources) / mu (model unit) / lora (LoRA deployment)
dashscope deployments create -m qwen2.5-7b-instruct -s tst -c 1 --plan ptu
-mespecifica o nome do modelo,-sespecifica o sufixo do serviço e-cespecifica a capacidade de implantação.
ImportanteO assistente interativo SDK Expert pode realizar o mesmo desenvolvimento e solução de problemas por meio de linguagem natural; consulte
DashScope SDK Expert.Para obter a tabela completa de regiões, consulte Visão geral da URL base.
Em caso de sucesso, o comando retorna o seguinte resultado (usando uma implantação LoRA como exemplo):
{
    "request_id": "83b173ab-2b2f-41aa-8c57-b173e8be934e",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:06:46.405",
        "gmt_modified": "2025-11-20T20:06:46.405",
        "status": "PENDING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "workspace_id": "llm-8v*****",
        "charge_type": "post_paid",
        "creator": "16542*****",
        "modifier": "16542*****",
        "plan": "***"
    }
}
Neste retorno, deployed_model é o ID exclusivo do serviço dedicado.
2. Consulte o status do serviço
Execute o comando a seguir para consultar os detalhes de um serviço dedicado específico:
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments/qwen3-8b-ft-202511132025-0260" \
    --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
    --header 'Content-Type: application/json'
Em caso de sucesso, o comando retorna o seguinte resultado:
{
    "request_id": "ca36952d-9136-426e-ab08-68a97ad72719",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:32:08",
        "gmt_modified": "2025-11-20T20:42:25",
        "status": "RUNNING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "base_capacity": 2,
        "capacity": 2,
        "ready_capacity": 2,
        "workspace_id": "llm-8v53etv3hwb8orx1",
        "charge_type": "post_paid",
        "creator": "1654290265984853",
        "modifier": "1654290265984853",
        "plan": "mu",
        "model_unit_spec": "MU1"
    }
}
Quando o status do serviço for RUNNING, a implantação do serviço estará concluída.
3. Faça requisições de inferência
ObservaçãoSe esta for sua primeira vez utilizando o DashScope SDK, consulte Instalar o SDK.
Certifique-se de que o workspace da chave de API corresponda ao workspace de implantação do modelo.
Ao chamar um serviço dedicado implantado, o parâmetro model deve ser definido como o code do modelo retornado após a implantação bem-sucedida. Obtenha-o no console de Dedicated Deployment.
import os
import dashscope

# A configuração abaixo refere-se à região Singapura (ap-southeast-1). O valor de region varia conforme a região.
# Se a variável de ambiente não estiver configurada, substitua a linha abaixo pela sua API Key do Model Studio: api_key="sk-xxx"
client = dashscope.Client(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    region="ap-southeast-1",
)

messages = [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "Who are you?"},
]
response = client.chat.completions.create(
    model="qwen3-max-xxx-xxx",  # Substitua pelo code retornado após a implantação bem-sucedida do modelo
    messages=messages,
    enable_thinking=False,
)
print(response)
import os
from openai import OpenAI

client = OpenAI(
    # If you have not configured environment variables, replace the next line with your Bailian API Key: api_key="sk-xxx",
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3-max-xxx-xxx",  # Please replace with the code returned after the model is successfully deployed
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Who are you?"},
    ],
    extra_body={"enable_thinking": False},
)
print(completion)
Alinhamento de parâmetros de inferência
Os valores padrão dos parâmetros do motor de inferência do Model Studio podem ser diferentes dos do seu framework de inferência local. Para alinhar-se aos valores padrão do vLLM, consulte a tabela abaixo ao chamar a API; se você usar SGLang ou outros frameworks, consulte a documentação correspondente.
Nome do parâmetro | Valor recomendado (corresponde aos valores padrão do vLLM) |
|---|---|
temperature | Intervalo: [0, 2). Defina como 1.0 para corresponder ao valor padrão do vLLM. |
top_p | Intervalo: (0, 1.0]. Defina como 1.0 para corresponder ao valor padrão do vLLM. |
top_k | Defina como None ou um valor maior que 100 para desativar a amostragem top_k (apenas top_p se aplica). Definir como 99 aproxima o valor padrão 0 do vLLM (amostragem completa). |
presence_penalty | Intervalo: [-2.0, 2.0]. Defina como 0 para corresponder ao valor padrão do vLLM. |
repetition_penalty (protocolo DashScope) | Aumentar repetition_penalty reduz a repetição no texto gerado. Um valor de 1.0 significa ausência de penalização. Intervalo: maior que 0. Defina como 1.0 para corresponder ao valor padrão do vLLM. |
4. Exclua o serviço dedicado
AvisoA execução do comando de exclusão retira o serviço de implantação do ar imediatamente. Esta ação é irreversível e tem os seguintes efeitos:
- Não será mais possível chamar o modelo.
- O faturamento do serviço é interrompido.
Caso não precise mais de um serviço dedicado, você pode excluí-lo usando o comando a seguir:
curl --request DELETE 'https://dashscope-intl.aliyuncs.com/api/v1/deployments/qwen3-8b-ft-202511132025-0260' \
    --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
    --header 'Content-Type: application/json'
Em caso de sucesso, o comando retorna o seguinte resultado:
{
    "request_id": "8f726017-6042-420e-a465-0d366a3aba59",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:32:08",
        "gmt_modified": "2025-11-27T16:35:31.591",
        "status": "DELETING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "base_capacity": 2,
        "capacity": 2,
        "ready_capacity": 2,
        "workspace_id": "llm-8v53etv3hwb8orx1",
        "charge_type": "post_paid",
        "creator": "1654290265984853",
        "modifier": "1654290265984853",
        "plan": "mu",
        "model_unit_spec": "MU1"
    }
}
Após excluir o serviço, não será mais possível consultar seu status pelo método descrito em 2. Consulte o status do serviço.
Solução de problemas de permissões
Se você encontrar erros de permissão durante a implantação do modelo, há dois caminhos de solução de problemas, dependendo do método de implantação:
Implantação pelo console
-
Se for exibida a mensagem "Permissão ausente para este módulo", certifique-se de que sua conta tenha a permissão Model Deployment - Operation na página de gerenciamento de permissões do espaço de negócios.
Se você não conseguir operar normalmente, entre em contato com a organização ou com o administrador de TI para adicionar as permissões relevantes ou verificar os problemas de permissão em seu nome.
-
Se o erro "o espaço de negócios xx não tem permissão para implantar o modelo xx" for relatado durante a implantação, acesse a página Gerenciamento de espaço de negócios do Model Studio para adicionar a permissão de implantação do modelo correspondente ao espaço de negócios correspondente.
Erro de chamada de API:
Workspace xxx does not have deployment privilege for model xxxx.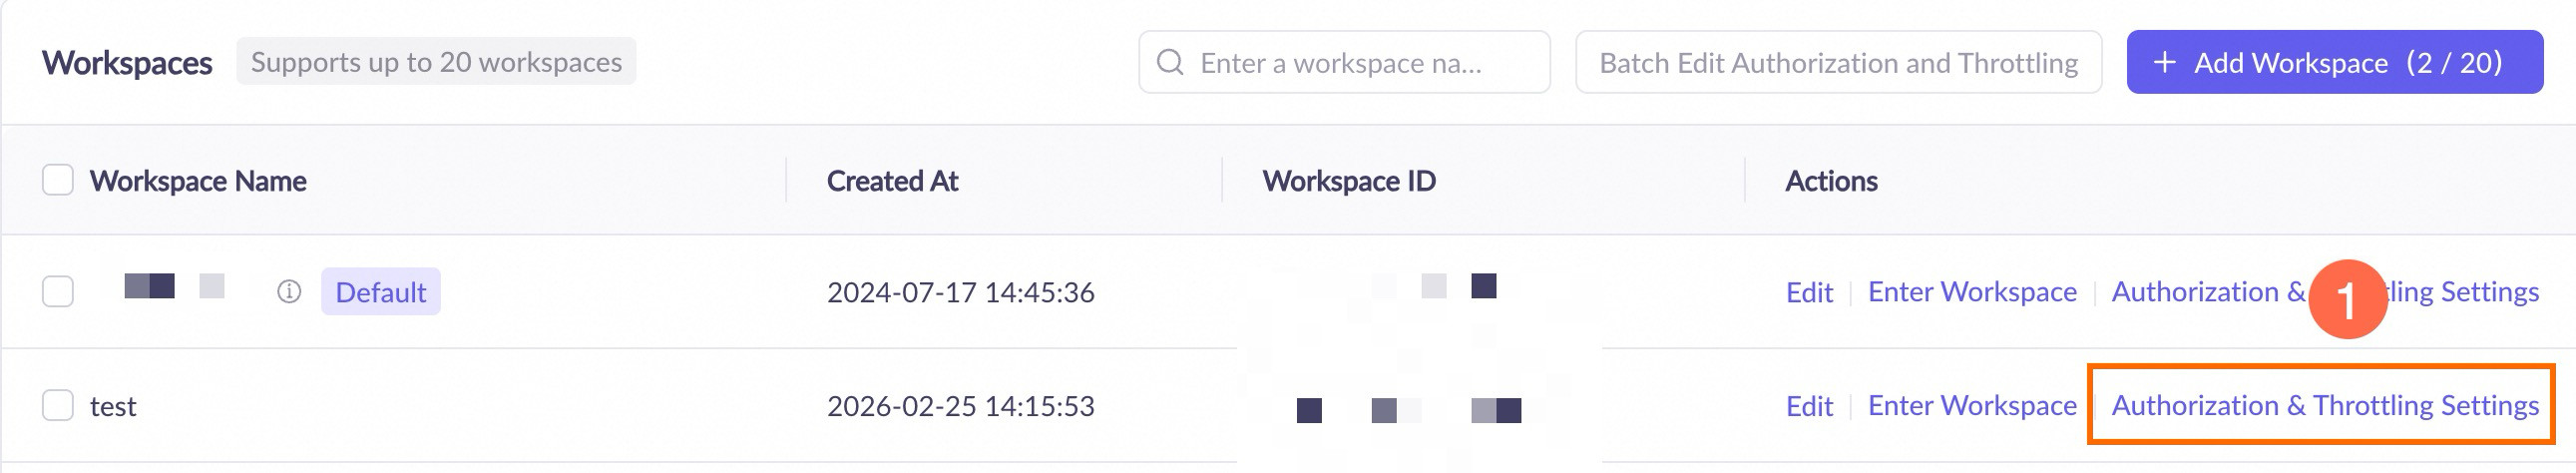
Se for solicitado que as permissões são insuficientes, entre em contato com a organização ou com o administrador de TI para adicionar as permissões relevantes ou realizar a operação em seu nome.
Implantação por API
Ao implantar um modelo usando uma API, certifique-se do seguinte:
-
O Workspace da chave de API deve ter permissão para gerenciar o modelo. Acesse a página Gerenciamento de espaço de negócios no Model Studio e verifique as configurações de permissão de implantação do modelo para o workspace correspondente.
Erro de chamada de API:
Workspace xxx does not have deployment privilege for model xxxx.Na coluna Actions do workspace correspondente, clique em Model Permission and Flow Control Settings.
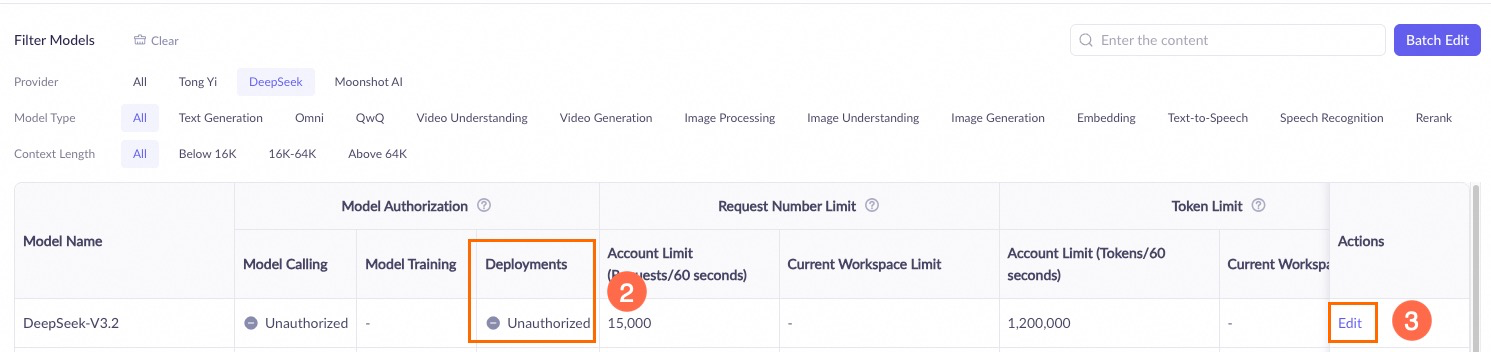
Na Model List, localize o modelo de destino e verifique o status de autorização na coluna Model Deployment. Se aparecer Not Authorized, clique em Edit na coluna Actions para conceder a permissão.
Se for solicitado que as permissões são insuficientes, entre em contato com a organização ou com o administrador de TI para adicionar as permissões relevantes ou realizar a operação em seu nome.
-
A Owner Account proprietária da chave de API precisa ter as permissões necessárias no Workspace. Acesse o console do Model Studio, clique no workspace no canto inferior esquerdo, alterne para o workspace correto e clique em
 para verificar as configurações de permissão de implantação do modelo.
Erro de chamada de API:
Workspace access denied.No painel de navegação à esquerda, clique em Permission Management e confirme se a lista de usuários inclui a conta proprietária da chave de API (com o tipo primary account).
Se for solicitado que as permissões são insuficientes, entre em contato com a organização ou com o administrador de TI para adicionar as permissões relevantes ou realizar a operação em seu nome.
Referência da API
Para obter detalhes sobre as chamadas de API, consulte Detalhes da API.