Este tópico descreve os parâmetros e as interfaces do SDK em Python para reconhecimento de fala não em tempo real Fun-ASR.
Para requisitos de entrada, como formatos de áudio suportados, limites de tamanho de arquivo e limites de duração, consulte Audio specifications.
Pré-requisitos
-
Você ativou o service e Obtain an API key. Utilize Configure API key as an environment variable em vez de codificá-la diretamente no seu código para evitar riscos de segurança causados por vazamento de código.
Início rápido
Os exemplos a seguir usam o DashScope Python SDK 2.0. O Recurso principal (client.audio.asr) fornece métodos para enviar, aguardar e consultar tarefas das duas maneiras a seguir:
- Envie a tarefa de forma assíncrona e aguarde sincronamente: após enviar a tarefa, bloqueie a thread atual até que a tarefa termine e retorne o resultado do reconhecimento.
- Envie a tarefa de forma assíncrona e consulte o resultado de forma assíncrona: após enviar a tarefa, chame a interface de consulta para recuperar o resultado sempre que necessário.
Enviar de forma assíncrona e aguardar sincronamente
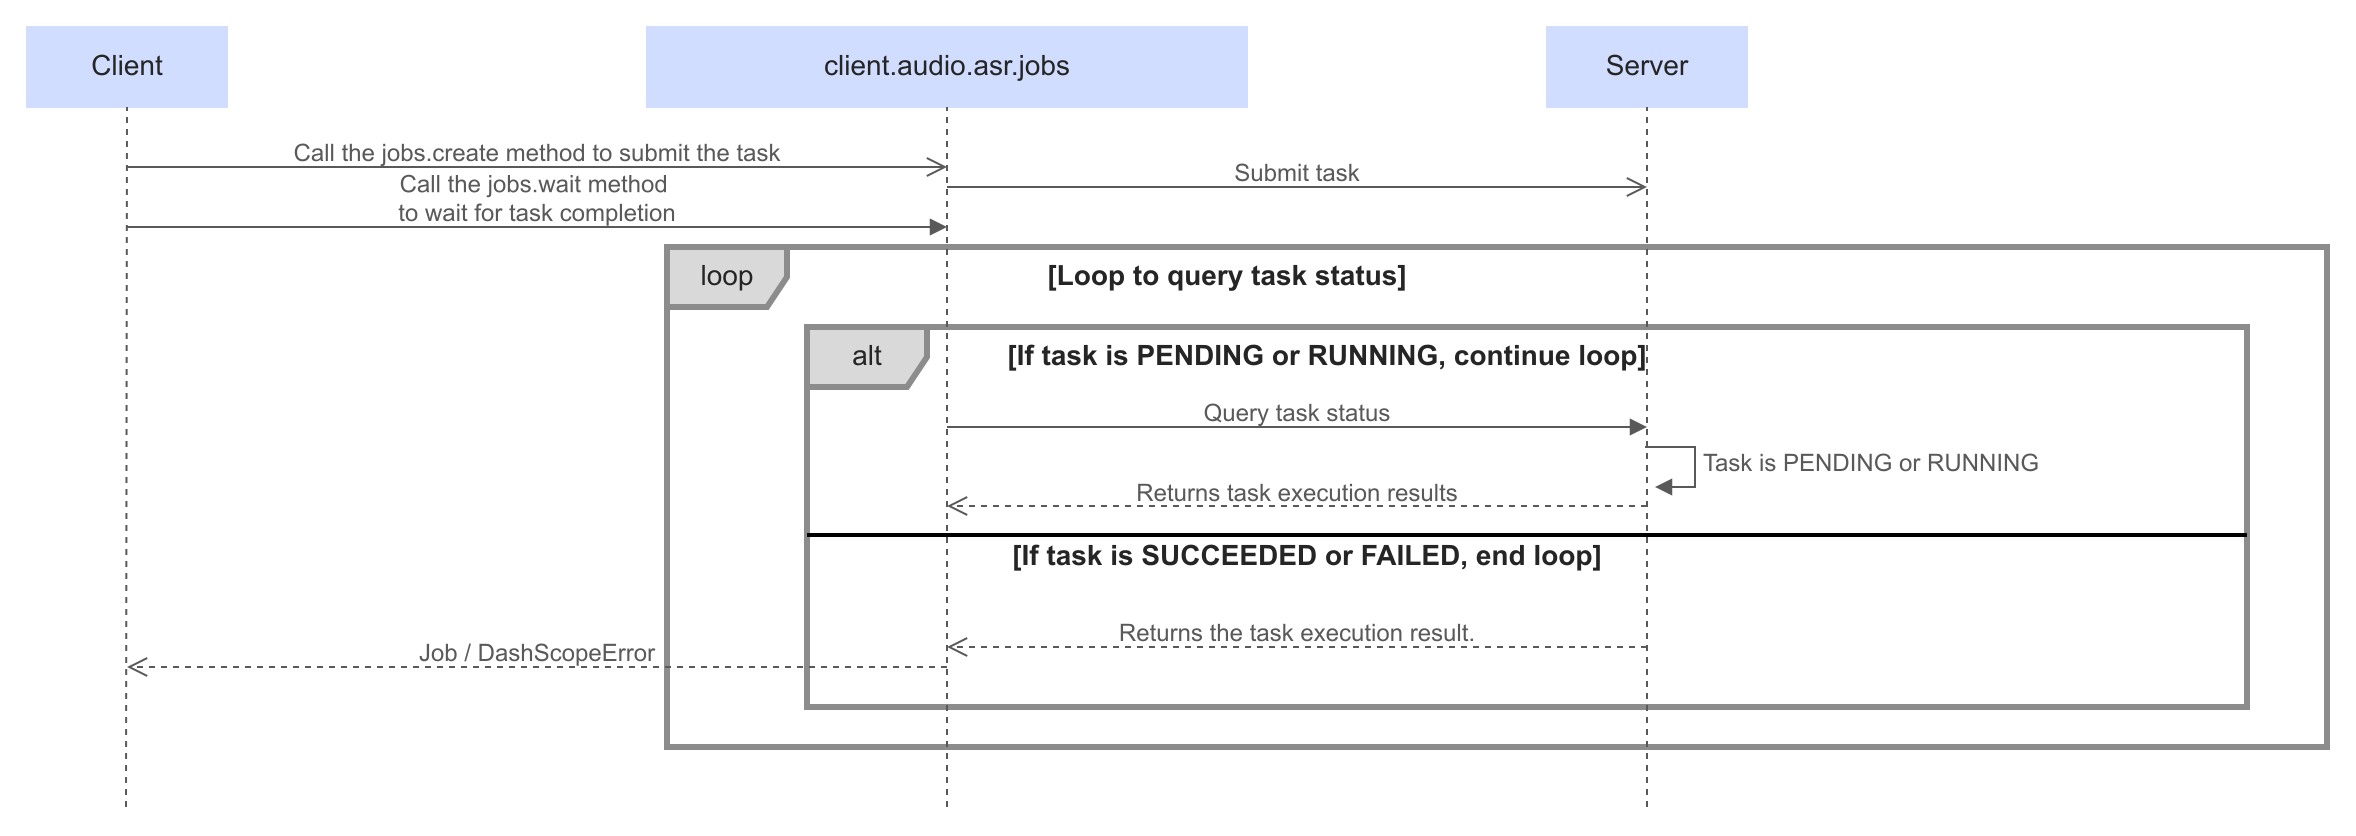
-
Chame
client.audio.asr.jobs.createpara enviar uma tarefa com os parâmetros da solicitação.Observação
- O service de transcrição de arquivos processa tarefas enviadas por meio da API com base no melhor esforço. Após o envio, a tarefa entra no estado de fila (
PENDING). O tempo de espera depende do tamanho da fila e da duração do arquivo, portanto não pode ser definido com precisão, mas geralmente fica dentro de alguns minutos. Assim que o processamento começa, o reconhecimento de fala é concluído a uma velocidade centenas de vezes superior ao tempo real. - Após a conclusão de cada tarefa, o resultado do reconhecimento e a URL de download permanecem válidos por 24 horas. Depois que expiram, não é mais possível consultar a tarefa ou baixar o resultado por meio da URL retornada em uma consulta anterior.
- O service de transcrição de arquivos processa tarefas enviadas por meio da API com base no melhor esforço. Após o envio, a tarefa entra no estado de fila (
-
Chame
client.audio.asr.jobs.wait(job=job)para aguardar a conclusão de forma síncrona.Enquanto a tarefa estiver em
PENDINGouRUNNING,jobs.waitcontinua aguardando. Retorna umJobquando a tarefa é bem-sucedida.Os métodos retornam um
Job. Leia a lista de resultados emjob.results; cadatranscription_urlaponta para um resultado de transcrição para download.
import json
import os

import dashscope

# Substitua {WorkspaceId} pelo ID real do workspace da região.
client = dashscope.Client(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    workspace="{WorkspaceId}",
    region="ap-southeast-1",
)

job = client.audio.asr.jobs.create(
    model="fun-asr",
    file_urls=["{YOUR_AUDIO_URL}"],
)

job = client.audio.asr.jobs.wait(job=job)

print(json.dumps(job.model_dump(), indent=4, ensure_ascii=False))
Enviar de forma assíncrona e consultar o resultado de forma assíncrona
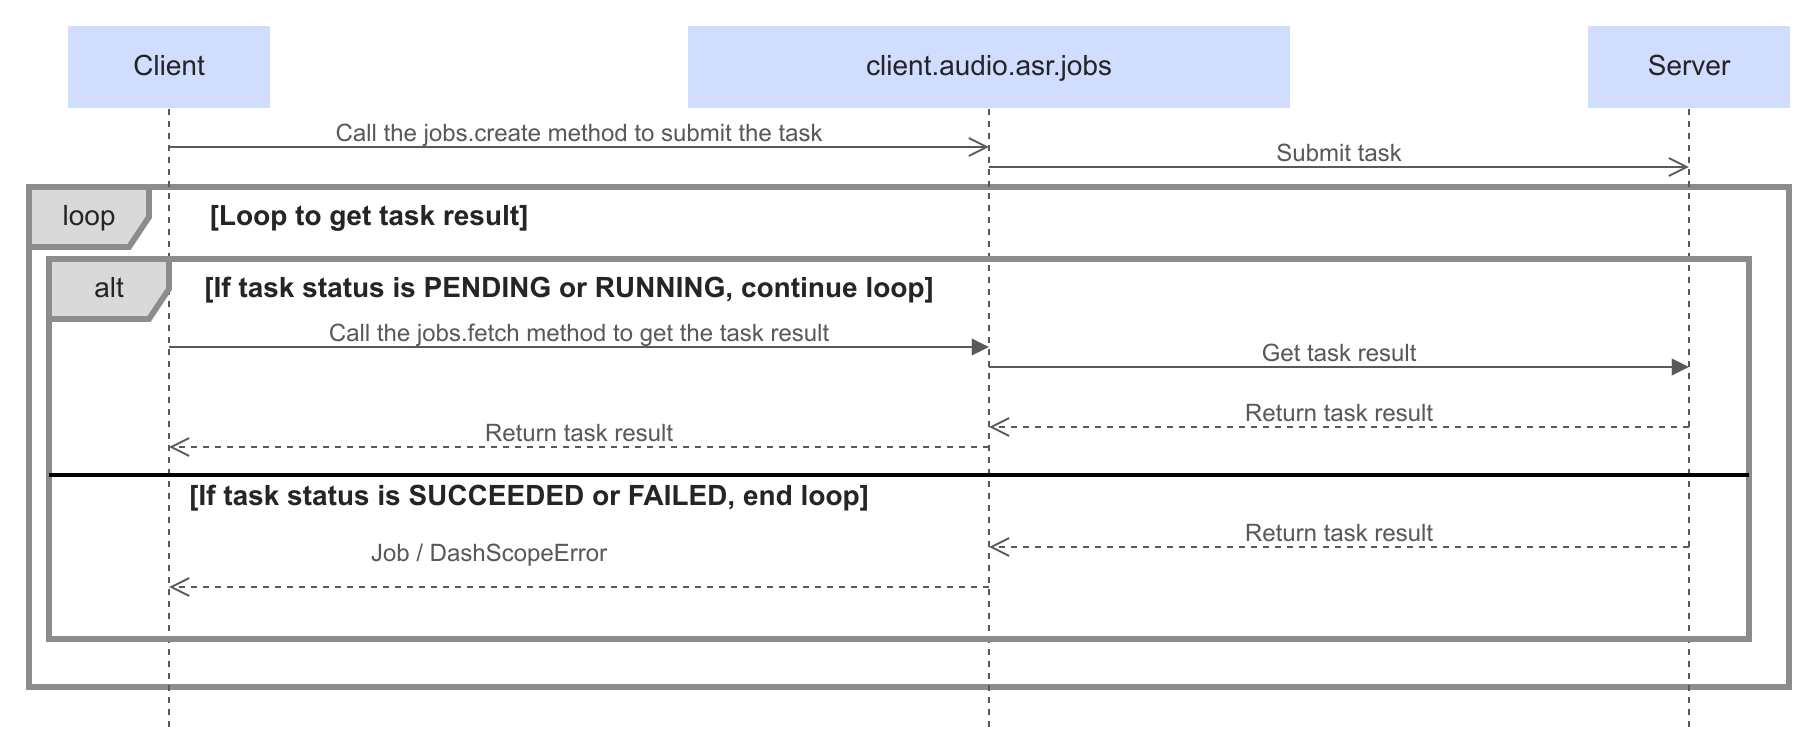
-
Chame
client.audio.asr.jobs.createpara enviar uma tarefa com os parâmetros da solicitação.Observação
- O service de transcrição de arquivos processa tarefas enviadas por meio da API com base no melhor esforço. Após o envio, a tarefa entra no estado de fila (
PENDING). O tempo de espera depende do tamanho da fila e da duração do arquivo, portanto não pode ser definido com precisão, mas geralmente fica dentro de alguns minutos. Assim que o processamento começa, o reconhecimento de fala é concluído a uma velocidade centenas de vezes superior ao tempo real. - Após a conclusão de cada tarefa, o resultado do reconhecimento e a URL de download permanecem válidos por 24 horas. Depois que expiram, não é mais possível consultar a tarefa ou baixar o resultado por meio da URL retornada em uma consulta anterior.
- O service de transcrição de arquivos processa tarefas enviadas por meio da API com base no melhor esforço. Após o envio, a tarefa entra no estado de fila (
-
Chame
client.audio.asr.jobs.fetch(task_id)em um loop e leia os resultados quando a tarefa for bem-sucedida.Leia o status da tarefa em
job.status. Este exemplo consulta a tarefa uma vez por segundo.Os métodos retornam um
Job. Leia a lista de resultados emjob.results; cadatranscription_urlaponta para um resultado de transcrição para download.
import json
import os
import time

import dashscope

# Substitua {WorkspaceId} pelo ID real do workspace da região.
client = dashscope.Client(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    workspace="{WorkspaceId}",
    region="ap-southeast-1",
)

job = client.audio.asr.jobs.create(
    model="fun-asr",
    file_urls=["{YOUR_AUDIO_URL}"],
)

while job.status in ("PENDING", "RUNNING"):
    time.sleep(1)
    job = client.audio.asr.jobs.fetch(task_id=job.task_id)

print(json.dumps(job.model_dump(), indent=4, ensure_ascii=False))
Endpoints do service
O SDK usa a região de Pequim por padrão. Ao criar dashscope.Client, defina a região em region e o ID do workspace em workspace. A configuração de região se aplica apenas a esse Client.
Singapore
https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1
Substitua {WorkspaceId} pelo seu Workspace ID real.
China (Beijing)
https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api/v1
Substitua {WorkspaceId} pelo seu Workspace ID real.
As chaves de API variam entre regiões. Use a chave de API da região correspondente.
Parâmetros de solicitação
Defina os parâmetros da solicitação por meio de client.audio.asr.transcribe ou client.audio.asr.jobs.create.
| Parâmetro | Tipo | Obrigatório | Descrição |
|---|---|---|---|
|
| Sim | O nome do modelo. |
|
| Sim | Uma lista de URLs dos arquivos de áudio ou vídeo a serem transcritos. HTTP e HTTPS são suportados. Uma única solicitação suporta apenas uma URL. Para requisitos de entrada, como formatos de áudio suportados, limites de tamanho de arquivo e limites de duração, consulte Audio specifications. Se a gravação estiver armazenada no Alibaba Cloud OSS, a API RESTful suporta URLs temporárias com o prefixo Importante
|
|
| Não | O ID de uma lista de palavras-chave pré-compilada. Gere esse ID antecipadamente chamando a API de criação de lista de palavras-chave. Passe o ID durante o reconhecimento para usar as palavras-chave da lista. Indicado para cenários onde o vocabulário é conhecido e relativamente estável, e onde você precisa reutilizar a mesma lista de palavras entre solicitações. Para detalhes de uso, consulte Precompiled hotwords. |
|
| Não | Hotwords instantâneas. Passe pares de chave-valor em que as chaves são os textos das hotwords ( Para saber como usar, consulte Hotwords instantâneas. Exemplo: O exemplo a seguir reutiliza o |
|
| Não | O índice das faixas de áudio a serem reconhecidas em um arquivo de áudio com múltiplas faixas. O índice começa em 0. Por exemplo, [0] reconhece a primeira faixa, e [0, 1] reconhece a primeira e a segunda faixas simultaneamente. Se você omitir este parâmetro, apenas a primeira faixa será processada. ImportanteCada faixa especificada é faturada independentemente. Por exemplo, solicitar [0, 1] para um único arquivo incorre em duas cobranças separadas. Valor padrão: [0]. |
|
| Não | As palavras sensíveis a serem processadas durante o reconhecimento de fala. Você pode definir um método de tratamento diferente para cada palavra sensível. Para detalhes, consulte Sensitive word filtering. |
|
| Não | Se deve ativar a diarização de falantes. Desativado por padrão. Aplica-se apenas a áudio mono. Áudio multicanal não suporta diarização de falantes. Quando ativado, o resultado do reconhecimento inclui um campo ObservaçãoQuando a diarização de falantes está ativada, mantenha a duração do áudio dentro de 2 horas. Caso contrário, o reconhecimento pode falhar ou atingir o tempo limite. Valor padrão: False. Para um exemplo de |
|
| Não | ImportanteEntra em vigor apenas quando a diarização de falantes está ativada ( Um valor de referência para o número de falantes. O intervalo válido é um número inteiro de 2 a 100 (inclusive). Por padrão, o número de falantes é detectado automaticamente. Se você definir este valor, ele apenas orientará o algoritmo a gerar a contagem especificada quando possível, sem garantir essa contagem exata. Sem valor padrão. |
|
| Não | Os códigos de idioma a serem reconhecidos. Se você não puder determinar o idioma antecipadamente, deixe-o indefinido e o modelo detectará o idioma automaticamente. Você pode definir até 1 valor. Se definir mais, apenas os 1 primeiros serão usados. Clique para visualizar os códigos de idioma suportados
|
Resposta
Job
Job contém informações da tarefa, saída bruta e uso.
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "PENDING",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": null,
    "finished_at": null,
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "PENDING",
        "submit_time": "2026-10-29 10:00:00.000"
    },
    "usage": null
}
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "RUNNING",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": "2026-10-29 10:00:00.100",
    "finished_at": null,
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "RUNNING",
        "submit_time": "2026-10-29 10:00:00.000",
        "scheduled_time": "2026-10-29 10:00:00.100"
    },
    "usage": null
}
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "SUCCEEDED",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": "2026-10-29 10:00:00.100",
    "finished_at": "2026-10-29 10:00:01.000",
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "SUCCEEDED",
        "submit_time": "2026-10-29 10:00:00.000",
        "scheduled_time": "2026-10-29 10:00:00.100",
        "end_time": "2026-10-29 10:00:01.000",
        "results": [
            {
                "file_url": "{YOUR_AUDIO_URL}",
                "transcription_url": "{TRANSCRIPTION_URL}",
                "subtask_status": "SUCCEEDED"
            }
        ]
    },
    "usage": {
        "duration": 1
    }
}
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "status": "FAILED",
    "submitted_at": "2026-10-29 10:00:00.000",
    "scheduled_at": "2026-10-29 10:00:00.100",
    "finished_at": "2026-10-29 10:00:01.000",
    "output": {
        "task_id": "00000000-0000-0000-0000-000000000001",
        "task_status": "FAILED",
        "submit_time": "2026-10-29 10:00:00.000",
        "scheduled_time": "2026-10-29 10:00:00.100",
        "end_time": "2026-10-29 10:00:01.000",
        "code": "SERVER_ERROR",
        "file_url": "{YOUR_AUDIO_URL}",
        "subtask_status": "FAILED",
        "results": [
            {
                "file_url": "{YOUR_AUDIO_URL}",
                "subtask_status": "FAILED",
                "results": []
            }
        ]
    },
    "usage": null
}
Campo | Descrição |
|---|---|
| O ID da tarefa. |
| O status da tarefa: |
| O horário de envio, correspondente a |
| O início do processamento, correspondente a |
| O horário de conclusão, correspondente a |
| O dicionário de saída bruta da tarefa. |
| A lista de resultados de subtarefas, acessível por |
| Informações de uso da tarefa. |
Job.output
job.output é o dicionário de saída bruta da tarefa retornado pelo serviço.
PENDING
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "PENDING",
    "submit_time": "2026-10-29 10:00:00.000"
}
RUNNING
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "RUNNING",
    "submit_time": "2026-10-29 10:00:00.000",
    "scheduled_time": "2026-10-29 10:00:00.100"
}
SUCCEEDED
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "SUCCEEDED",
    "submit_time": "2026-10-29 10:00:00.000",
    "scheduled_time": "2026-10-29 10:00:00.100",
    "end_time": "2026-10-29 10:00:01.000",
    "results": [
        {
            "file_url": "{YOUR_AUDIO_URL}",
            "transcription_url": "{TRANSCRIPTION_URL}",
            "subtask_status": "SUCCEEDED"
        }
    ]
}
FAILED (raise_on_error=False)
{
    "task_id": "00000000-0000-0000-0000-000000000001",
    "task_status": "FAILED",
    "submit_time": "2026-10-29 10:00:00.000",
    "scheduled_time": "2026-10-29 10:00:00.100",
    "end_time": "2026-10-29 10:00:01.000",
    "code": "SERVER_ERROR",
    "file_url": "{YOUR_AUDIO_URL}",
    "subtask_status": "FAILED",
    "results": [
        {
            "file_url": "{YOUR_AUDIO_URL}",
            "subtask_status": "FAILED",
            "results": []
        }
    ]
}
| Parâmetro | Descrição |
|---|---|
| O código de erro. Combine-o com o campo |
| A mensagem de erro. Combine-a com o campo |
| ID da tarefa. |
| Status da tarefa. Um dos quatro estados: Quando uma tarefa contém várias subtarefas, o status geral da tarefa é marcado como |
| Resultados do reconhecimento das subtarefas. |
| Status da subtarefa. Um dos quatro estados: |
| URL do áudio reconhecido. |
| URL do resultado do reconhecimento de áudio. O resultado do reconhecimento é salvo como um arquivo JSON. Você pode baixar o arquivo pelo link associado a |
Descrição do resultado do reconhecimento
O resultado do reconhecimento é salvo como um arquivo JSON.
{
    "file_url":"{YOUR_AUDIO_URL}",
    "properties":{
        "audio_format":"pcm_s16le",
        "channels":[
            0
        ],
        "original_sampling_rate":16000,
        "original_duration_in_milliseconds":3834
    },
    "transcripts":[
        {
            "channel_id":0,
            "content_duration_in_milliseconds":3720,
            "text":"Hello world, this is Alibaba Speech Lab.",
            "sentences":[
                {
                    "begin_time":100,
                    "end_time":3820,
                    "text":"Hello world, this is Alibaba Speech Lab.",
                    "sentence_id":1,
                    "speaker_id":0, //This field is displayed only when automatic speaker diarization is enabled
                    "words":[
                        {
                            "begin_time":100,
                            "end_time":596,
                            "text":"Hello ",
                            "punctuation":""
                        },
                        {
                            "begin_time":596,
                            "end_time":844,
                            "text":"world",
                            "punctuation":", "
                        }
                        // Other content is omitted here
                    ]
                }
            ]
        }
    ]
}
Os seguintes parâmetros merecem atenção:
| Parâmetro | Tipo | Descrição |
|---|---|---|
|
| O formato de áudio do arquivo de origem. |
| array[integer] | O índice da faixa de áudio no arquivo de origem. Para áudio de faixa única, [0] é retornado; para áudio de duas faixas, [0, 1] é retornado; e assim por diante. |
|
| A taxa de amostragem (Hz) do áudio no arquivo de origem. |
|
| A duração original do áudio (ms) no arquivo de origem. |
|
| O índice da faixa do resultado da transcrição, começando em 0. |
|
| A duração (ms) do conteúdo na faixa identificado como fala. O service de modelo de reconhecimento de fala transcreve apenas o conteúdo de uma faixa identificado como fala, medindo e faturando com base nessa duração. Conteúdo que não seja fala não é medido nem faturado. Normalmente, a duração do conteúdo de fala é menor que a duração original do áudio. Como a existência de conteúdo de fala é determinada por um modelo de IA, o resultado pode diferir ligeiramente da situação real. |
|
| O resultado da transcrição no nível de parágrafo. |
|
| O resultado da transcrição no nível de sentença. |
|
| O resultado da transcrição no nível de palavra. |
|
| O carimbo de data/hora inicial (ms). |
|
| O carimbo de data/hora final (ms). |
|
| O resultado da transcrição. |
|
| O índice do falante atual, começando em 0, usado para distinguir diferentes falantes. Este campo aparece no resultado do reconhecimento apenas quando a diarização de falantes está ativada. |
|
| A pontuação prevista após a palavra, se houver. |
Interfaces principais
Recurso principal (client.audio.asr)
Crie um cliente com dashscope.Client e use o recurso client.audio.asr. Todos os métodos abaixo retornam um Job.
Método | Assinatura do método | Descrição |
|---|---|---|
| | Envie uma tarefa e aguarde a conclusão de forma síncrona. O modelo padrão é |
| | Envie uma tarefa e retorne um |
| | Passe um |
| | Consulte o status e os resultados da tarefa uma vez por ID, sem aguardar a conclusão. |
Códigos de erro
Por padrão, uma tarefa com falha gera DashScopeError. Para receber um Job com falha, defina raise_on_error=False ao criar o Client e verifique job.status.
Se você encontrar um erro, consulte Error codes para solucionar o problema.
Quando uma tarefa contém várias subtarefas, o status geral da tarefa é marcado como SUCCEEDED desde que pelo menos uma subtarefa tenha sucesso. Verifique o campo subtask_status para determinar o resultado de cada subtarefa.
Exemplo de resposta de erro:
{
    "task_id": "7bac899c-06ec-4a79-8875-xxxxxxxxxxxx",
    "task_status": "SUCCEEDED",
    "submit_time": "2024-12-16 16:30:59.170",
    "scheduled_time": "2024-12-16 16:30:59.204",
    "end_time": "2024-12-16 16:31:02.375",
    "results": [
        {
            "file_url": "{YOUR_AUDIO_URL}",
            "code": "InvalidFile.DownloadFailed",
            "message": "The audio file cannot be downloaded.",
            "subtask_status": "FAILED"
        }
    ],
    "task_metrics": {
        "TOTAL": 1,
        "SUCCEEDED": 0,
        "FAILED": 1
    }
}
FAQ
Recursos
P: Áudio codificado em Base64 é suportado?
Áudio codificado em Base64 não é suportado. Apenas áudio em uma URL publicamente acessível pode ser reconhecido. Fluxos binários e arquivos locais não podem ser reconhecidos diretamente.
P: Como torno um arquivo de áudio disponível em uma URL publicamente acessível?
As etapas típicas são as seguintes. Esta é uma abordagem; o processo exato varia conforme o product de armazenamento. Recomendamos que você upload the audio to Alibaba Cloud OSS:
1. Escolha um método de armazenamento e hospedagem
Por exemplo:
-
Service de armazenamento de objetos (recomendado):
- Use o service de armazenamento de objetos de um provedor de cloud (como Alibaba Cloud OSS) para fazer upload do arquivo de áudio para um bucket e defini-lo como acesso público.
- Vantagens: alta disponibilidade, suporte a aceleração CDN e gerenciamento fácil.
-
Servidor web:
- Coloque o arquivo de áudio em um servidor web que suporte acesso HTTP/HTTPS (como Nginx ou Apache).
- Vantagens: adequado para pequenos projetos ou testes locais.
-
Rede de distribuição de conteúdo (CDN):
- Hospede o arquivo de áudio em uma CDN e acesse-o por meio da URL fornecida pela CDN.
- Vantagens: acelera a entrega de arquivos e atende a cenários de alta concorrência.
2. Faça upload do arquivo de áudio
Faça upload do áudio de acordo com o método de armazenamento ou hospedagem escolhido. Por exemplo:
-
Service de armazenamento de objetos:
- Faça login no console do provedor de cloud e crie um bucket.
- Faça upload do arquivo de áudio e defina sua permissão como leitura pública ou gere um link de acesso temporário.
-
Servidor web:
- Coloque o arquivo de áudio em um diretório designado no servidor (como
/var/www/html/audio/). - Certifique-se de que o arquivo esteja acessível via HTTP/HTTPS.
- Coloque o arquivo de áudio em um diretório designado no servidor (como
3. Gere uma URL publicamente acessível
Por exemplo:
-
Service de armazenamento de objetos:
- Após o upload do arquivo, o sistema gera automaticamente uma URL de acesso público (geralmente no formato
https://<bucket-name>.<region>.aliyuncs.com/<file-name>). - Para um nome de domínio mais amigável, vincule um domínio personalizado e ative HTTPS.
- Após o upload do arquivo, o sistema gera automaticamente uma URL de acesso público (geralmente no formato
-
Servidor web:
- A URL de acesso geralmente é o endereço do servidor mais o caminho do arquivo (como
https://your-domain.com/audio/file.mp3).
- A URL de acesso geralmente é o endereço do servidor mais o caminho do arquivo (como
-
CDN:
- Após configurar a aceleração CDN, use a URL fornecida pela CDN (como
https://cdn.your-domain.com/audio/file.mp3).
- Após configurar a aceleração CDN, use a URL fornecida pela CDN (como
4. Verifique se a URL funciona
Certifique-se de que a URL gerada esteja acessível pela rede pública. Por exemplo:
- Abra a URL em um navegador e verifique se o arquivo de áudio é reproduzido.
- Use uma ferramenta (como
curlou Postman) para verificar se a URL retorna a resposta HTTP correta (código de status 200).
Ao usar o SDK, se os arquivos de áudio estiverem armazenados no Alibaba Cloud OSS, URLs temporárias com o prefixo oss:// não são suportadas.
Ao usar a API RESTful, se os arquivos de áudio estiverem armazenados no Alibaba Cloud OSS, URLs temporárias com o prefixo oss:// são suportadas:
- A URL temporária é válida por 48 horas e não pode ser usada após a expiração. Não a utilize em ambiente de produção.
- A API para obtenção de credencial de upload tem limite de 100 QPS e não suporta scale out. Não a utilize em ambientes de produção, cenários de alta concorrência ou cenários de teste de estresse.
- Para ambientes de produção, use um service de armazenamento estável, como OSS, para garantir a disponibilidade de arquivos a longo prazo e evitar problemas de limitação de taxa.
P: Quanto tempo leva para obter o resultado do reconhecimento?
Após o envio de uma tarefa, ela entra no estado de fila (PENDING). O tempo de espera depende do tamanho da fila e da duração do áudio, portanto não pode ser afirmado com exatidão, mas geralmente fica dentro de alguns minutos. Em geral, quanto mais longo o áudio, mais tempo leva.
Solução de problemas
Se você encontrar um erro de código, solucione o problema com base nas informações em Error codes.
P: A sondagem nunca retorna um resultado?
Isso pode ser causado por limitação de taxa. Aguarde um momento e tente novamente.
P: Por que a fala não pode ser reconhecida (sem resultado de reconhecimento)?
Verifique se o formato de áudio e a taxa de amostragem estão corretos e atendem às restrições de parâmetros.
Use a ferramenta ffprobe para obter o contêiner de áudio, codec, taxa de amostragem, canais e outros detalhes:
ffprobe -v error -show_entries format=format_name -show_entries stream=codec_name,sample_rate,channels -of default=noprint_wrappers=1 input.xxx