Este tópico descreve os parâmetros e os detalhes da API do SDK Java para reconhecimento de fala não em tempo real Fun-ASR.
Para requisitos de entrada, como formatos de áudio suportados, limites de tamanho de arquivo e limites de duração, consulte Audio specifications.
Pré-requisitos
-
Você ativou o service e Obtain an API key. Utilize Configure API key as an environment variable em vez de codificá-la diretamente no seu código para evitar riscos de segurança causados por vazamento de código.
Início rápido
O Core class (Transcription) fornece interfaces para enviar uma tarefa de forma assíncrona, aguardar sincronamente a conclusão da tarefa e consultar o resultado da tarefa de forma assíncrona. Execute o reconhecimento de fala não em tempo real de uma das duas maneiras seguintes:
- Envie uma tarefa de forma assíncrona e aguarde sincronamente sua conclusão: após enviar a tarefa, a thread atual é bloqueada até que a tarefa termine e o resultado do reconhecimento seja retornado.
- Envie uma tarefa de forma assíncrona e consulte o resultado da tarefa de forma assíncrona: após enviar a tarefa, chame a interface de consulta para obter o resultado da tarefa sempre que necessário.
Enviar uma tarefa de forma assíncrona e aguardar sincronamente sua conclusão
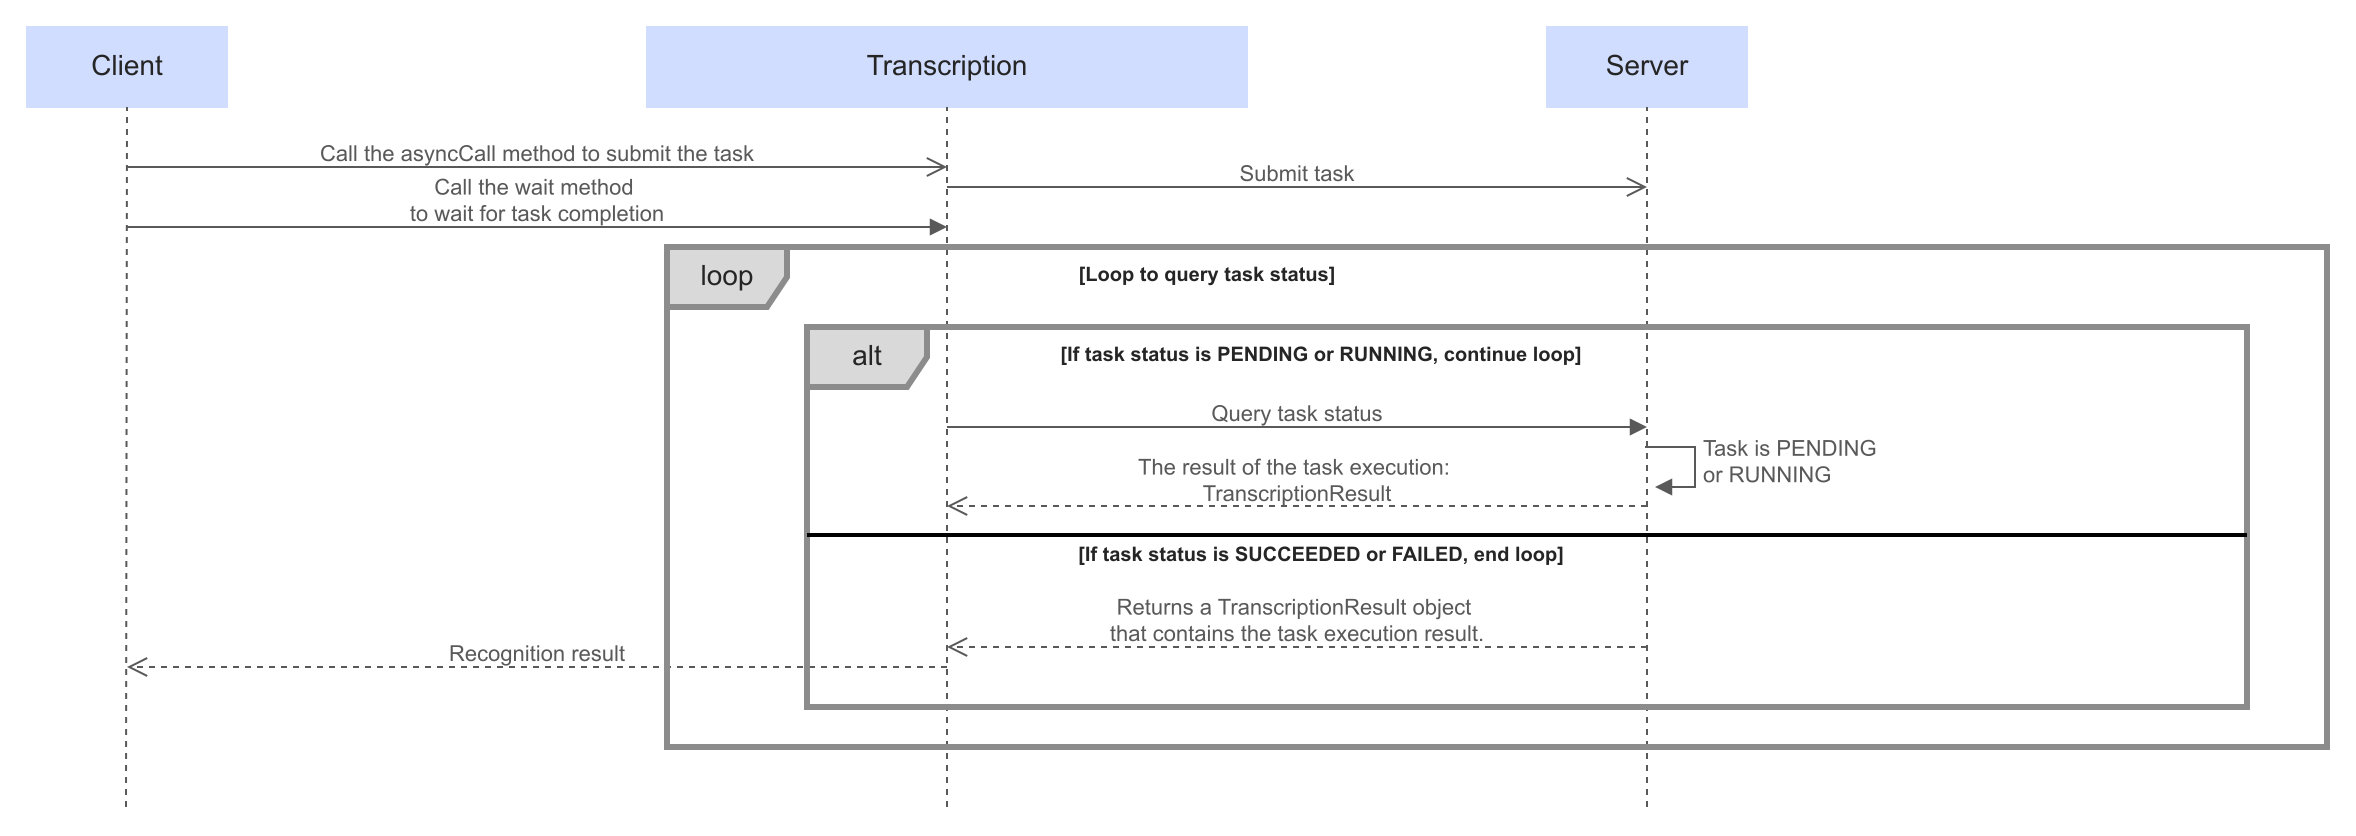
-
Configure o Request parameters.
-
Instancie um Core class (Transcription).
-
Chame o método
asyncCalldo Core class (Transcription) para enviar a tarefa de forma assíncrona.Observação
- O service de transcrição de arquivos processa tarefas enviadas por meio da API com base no melhor esforço. Após o envio, a tarefa entra no estado de fila (
PENDING). O tempo de espera depende do tamanho da fila e da duração do arquivo, portanto não pode ser definido com precisão, mas geralmente fica dentro de alguns minutos. Assim que o processamento começa, o reconhecimento de fala é concluído a uma velocidade centenas de vezes superior ao tempo real. - Após a conclusão de cada tarefa, o resultado do reconhecimento e a URL de download permanecem válidos por 24 horas. Depois que expiram, não é mais possível consultar a tarefa ou baixar o resultado pela URL retornada em uma consulta anterior.
- O service de transcrição de arquivos processa tarefas enviadas por meio da API com base no melhor esforço. Após o envio, a tarefa entra no estado de fila (
-
Chame o método
waitdo Core class (Transcription) para aguardar sincronamente a conclusão da tarefa.Uma tarefa pode estar no estado
PENDING,RUNNING,SUCCEEDEDouFAILED. Enquanto a tarefa estiver no estadoPENDINGouRUNNING, a interfacewaitpermanece bloqueada. Quando a tarefa atinge o estadoSUCCEEDEDouFAILED, a interfacewaitdesbloqueia e retorna o resultado da tarefa.O método
waitretorna um Task result (TranscriptionResult).
import com.alibaba.dashscope.audio.asr.transcription.*;
import com.alibaba.dashscope.utils.Constants;
import com.google.gson.*;

import java.util.Arrays;

public class Main {
    public static void main(String[] args) {
        // The following is the configuration for the Singapore region. When calling, replace "{WorkspaceId}" with your actual workspace ID. Configurations differ across regions.
        Constants.baseHttpApiUrl = "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
        // Create the transcription request parameters
        TranscriptionParam param =
                TranscriptionParam.builder()
                        // The API Key differs between the Singapore and Beijing regions. Get an API Key: https://www.alibabacloud.com/help/zh/model-studio/get-api-key
                        // If you have not configured the environment variable, replace the following line with your Model Studio API Key: .apiKey("sk-xxx")
                        //.apiKey("apikey")
                        .model("fun-asr") // This uses fun-asr as an example; change the model name as needed. Model list: https://www.alibabacloud.com/help/zh/model-studio/models
                        .fileUrls(
                                Arrays.asList(
                                        "{YOUR_AUDIO_URL}"))
                        .build();
        try {
            Transcription transcription = new Transcription();
            // Submit the transcription request
            TranscriptionResult result = transcription.asyncCall(param);
            System.out.println("RequestId: " + result.getRequestId());
            // Block and wait for the task to complete, then get the result
            result = transcription.wait(
                    TranscriptionQueryParam.FromTranscriptionParam(param, result.getTaskId()));
            // Print the result
            System.out.println(new GsonBuilder().setPrettyPrinting().create().toJson(result.getOutput()));
        } catch (Exception e) {
            System.out.println("error: " + e);
        }
        System.exit(0);
    }
}
Enviar uma tarefa de forma assíncrona e consultar o resultado da tarefa de forma assíncrona
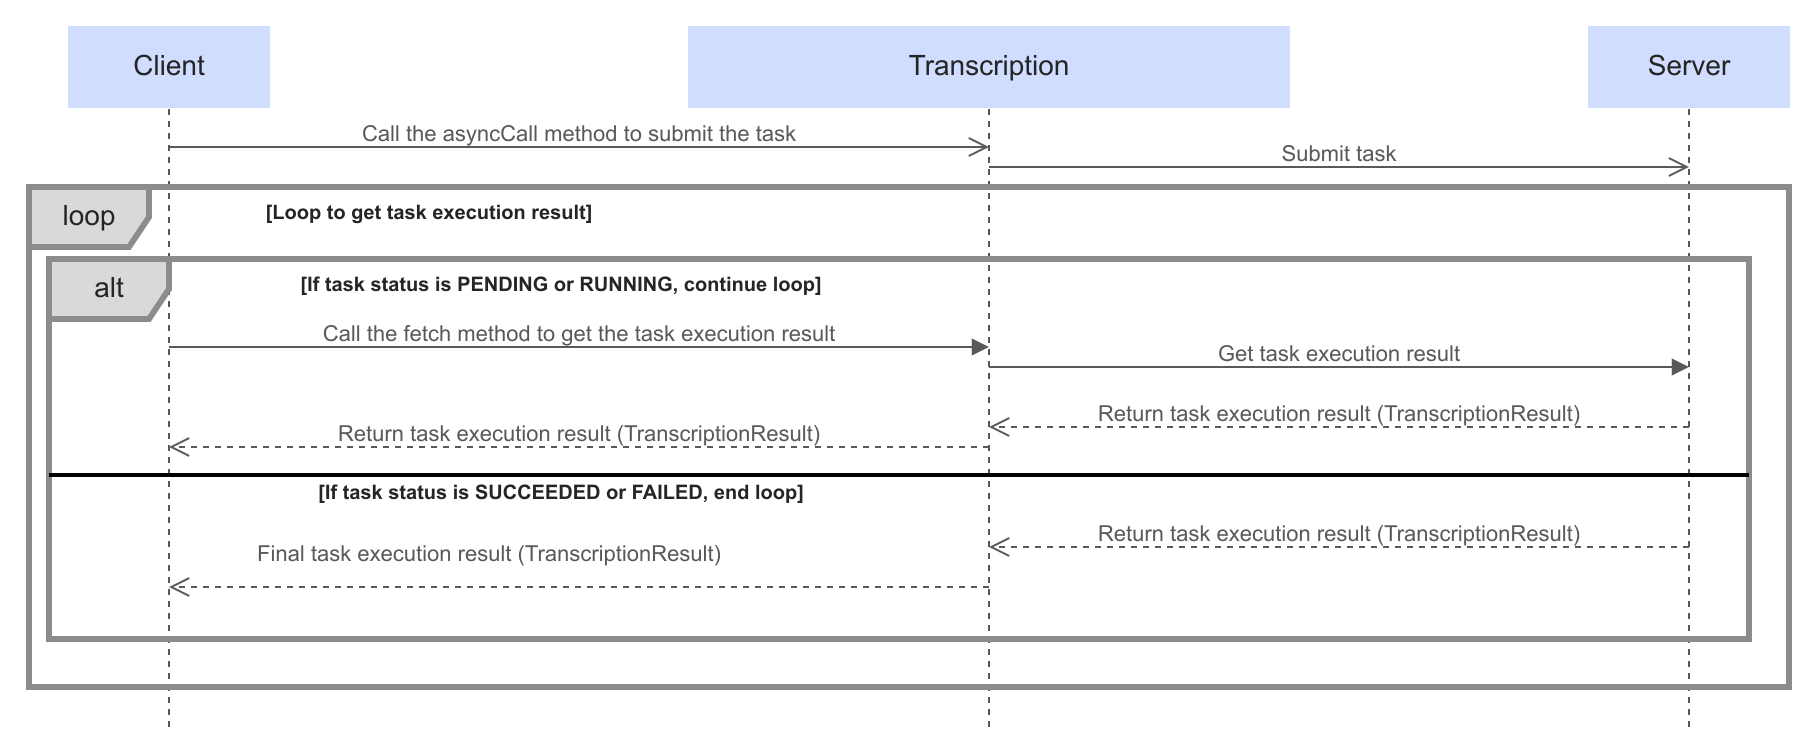
-
Configure o Request parameters.
-
Instancie um Core class (Transcription).
-
Chame o método
asyncCalldo Core class (Transcription) para enviar a tarefa de forma assíncrona.Observação
- O service de transcrição de arquivos processa tarefas enviadas por meio da API com base no melhor esforço. Após o envio, a tarefa entra no estado de fila (
PENDING). O tempo de espera depende do tamanho da fila e da duração do arquivo, portanto não pode ser definido com precisão, mas geralmente fica dentro de alguns minutos. Assim que o processamento começa, o reconhecimento de fala é concluído a uma velocidade centenas de vezes superior ao tempo real. - Após a conclusão de cada tarefa, o resultado do reconhecimento e a URL de download permanecem válidos por 24 horas. Depois que expiram, não é mais possível consultar a tarefa ou baixar o resultado pela URL retornada em uma consulta anterior.
- O service de transcrição de arquivos processa tarefas enviadas por meio da API com base no melhor esforço. Após o envio, a tarefa entra no estado de fila (
-
Chame o método
fetchdo Core class (Transcription) em um loop até obter o resultado final da tarefa.Quando o status da tarefa for
SUCCEEDEDouFAILED, interrompa a sondagem e processe o resultado.O método
fetchretorna um Task result (TranscriptionResult).
import com.alibaba.dashscope.audio.asr.transcription.*;
import com.alibaba.dashscope.common.TaskStatus;
import com.alibaba.dashscope.utils.Constants;
import com.google.gson.*;

import java.util.Arrays;

public class Main {
    public static void main(String[] args) {
        // The following is the configuration for the Singapore region. When calling, replace "{WorkspaceId}" with your actual workspace ID. Configurations differ across regions.
        Constants.baseHttpApiUrl = "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
        // Create the transcription request parameters
        TranscriptionParam param =
                TranscriptionParam.builder()
                        // The API Key differs between the Singapore and Beijing regions. Get an API Key: https://www.alibabacloud.com/help/zh/model-studio/get-api-key
                        // If you have not configured the environment variable, replace the following line with your Model Studio API Key: .apiKey("sk-xxx")
                        //.apiKey("apikey")
                        .model("fun-asr") // This uses fun-asr as an example; change the model name as needed. Model list: https://www.alibabacloud.com/help/zh/model-studio/models
                        .fileUrls(
                                Arrays.asList(
                                        "{YOUR_AUDIO_URL}"))
                        .build();
        try {
            Transcription transcription = new Transcription();
            // Submit the transcription request
            TranscriptionResult result = transcription.asyncCall(param);
            System.out.println("RequestId: " + result.getRequestId());
            // Poll for the task result in a loop until the task finishes
            while (true) {
                result = transcription.fetch(TranscriptionQueryParam.FromTranscriptionParam(param, result.getTaskId()));
                if (result.getTaskStatus() == TaskStatus.SUCCEEDED || result.getTaskStatus() == TaskStatus.FAILED) {
                    break;
                }
                Thread.sleep(1000);
            }
            // Print the result
            System.out.println(new GsonBuilder().setPrettyPrinting().create().toJson(result.getOutput()));
        } catch (Exception e) {
            System.out.println("error: " + e);
        }
        System.exit(0);
    }
}
Endpoints
Por padrão, o SDK usa o endpoint da região China (Beijing). Para mudar para outra região, modifique Constants.baseHttpApiUrl antes da inicialização.
Singapore
https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1
Ao fazer uma chamada, substitua {WorkspaceId} pelo seu Workspace ID real.
China (Beijing)
https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api/v1
Ao fazer uma chamada, substitua {WorkspaceId} pelo seu Workspace ID real.
ImportanteO Alibaba Cloud Model Studio lançou domínios específicos para workspaces nas regiões China (Beijing) e Singapore. Os novos domínios dedicados oferecem desempenho superior e maior estabilidade para solicitações de inferência. Recomendamos migrar para os novos domínios:
- China (Beijing): de
dashscope.aliyuncs.compara{WorkspaceId}.cn-beijing.maas.aliyuncs.com - Singapore: de
dashscope-intl.aliyuncs.compara{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com
Nota:
- As API keys diferem entre regiões. Certifique-se de usar a API key correspondente à região de destino.
- A configuração de região é global e afeta as chamadas de API de todos os SDKs DashScope.
Parâmetros de solicitação
Configure os parâmetros de solicitação usando os métodos encadeados de TranscriptionParam.
TranscriptionParam param = TranscriptionParam.builder()
  .model("fun-asr")
  .fileUrls(
          Arrays.asList(
                  "{YOUR_AUDIO_URL}"))
  .build();
| Parâmetro | Tipo | Obrigatório | Descrição |
|---|---|---|---|
|
| Sim | O nome do modelo. |
| List<String> | Sim | Lista de URLs dos arquivos de áudio ou vídeo a serem transcritos. HTTP e HTTPS são suportados. Uma única solicitação suporta apenas uma URL. Para requisitos de entrada, como formatos de áudio suportados, limites de tamanho de arquivo e limites de duração, consulte Audio specifications. Se a gravação estiver armazenada no Alibaba Cloud OSS, a API RESTful suporta URLs temporárias com o prefixo Importante
|
|
| Não | ID de uma lista de palavras-chave pré-compilada. Gere esse ID antecipadamente chamando a API de criação de lista de palavras-chave. Passe o ID durante o reconhecimento para usar as palavras-chave da lista. Indicado para cenários onde o vocabulário é conhecido e relativamente estável, e onde você precisa reutilizar a mesma lista de palavras entre solicitações. Para detalhes de uso, consulte Precompiled hotwords. |
| Map<String, Integer> | Não | Hotwords instantâneas. Passe pares de chave-valor em que as chaves são os textos das hotwords ( Para saber como usar, consulte Hotwords instantâneas. Defina |
| List<Integer> | Não | Índice das faixas de áudio a serem reconhecidas em um arquivo de áudio multifaixa. O índice começa em 0. Por exemplo, [0] reconhece a primeira faixa, e [0, 1] reconhece a primeira e a segunda faixas simultaneamente. Se você omitir este parâmetro, apenas a primeira faixa será processada. ImportanteCada faixa especificada é faturada independentemente. Por exemplo, solicitar [0, 1] para um único arquivo incorre em duas cobranças separadas. Valor padrão: [0]. |
|
| Não | Palavras sensíveis a serem processadas durante o reconhecimento de fala. Você pode definir um método de tratamento diferente para cada palavra sensível. Para detalhes, consulte Sensitive word filtering. |
|
| Não | Se deve ativar a diarização de falantes. Desativado por padrão. Aplica-se apenas a áudio mono. Áudio multicanal não suporta diarização de falantes. Quando ativado, o resultado do reconhecimento inclui um campo ObservaçãoQuando a diarização de falantes estiver ativada, mantenha a duração do áudio dentro de 2 horas. Caso contrário, o reconhecimento pode falhar ou atingir o tempo limite. Valor padrão: false. Para um exemplo de |
|
| Não | ImportanteEntra em vigor apenas quando a diarização de falantes está ativada ( Valor de referência para o número de falantes. O intervalo válido é um número inteiro de 2 a 100 (inclusive). Por padrão, o número de falantes é detectado automaticamente. Se você definir este valor, ele apenas orientará o algoritmo a gerar a contagem especificada quando possível, sem garantir essa contagem exata. Sem valor padrão. |
|
| Não | Códigos de idioma a serem reconhecidos. Se não for possível determinar o idioma antecipadamente, deixe sem definir e o modelo detectará o idioma automaticamente. Você pode definir até 1 valor. Se definir mais, apenas os 1 primeiros serão usados. Clique para visualizar os códigos de idioma suportados
Defina |
|
| Não | Sua API key. Se você configurou a API key como uma variável de ambiente, não precisa defini-la no seu código. Caso contrário, você deve defini-la no seu código. |
Resposta
Resultado da tarefa (TranscriptionResult)
O TranscriptionResult encapsula o resultado da tarefa atual.
| Interface/Método | Parâmetro | Valor de retorno | Descrição |
|---|---|---|---|
|
| requestId | Obtém o requestId. |
|
| taskId | Obtém o taskId. |
|
|
| Obtém o status da tarefa.
ObservaçãoQuando uma tarefa contém várias subtarefas, o status geral da tarefa é marcado como |
|
| Subtask result (TranscriptionTaskResult) | Obtém o Subtask result (TranscriptionTaskResult). Cada tarefa reconhece um ou mais arquivos de áudio. Arquivos de áudio diferentes são processados em subtarefas separadas, portanto cada tarefa corresponde a uma ou mais subtarefas. |
|
| O resultado da tarefa, em formato JSON | Obtém o resultado da tarefa. O resultado consiste em dados no formato JSON. Se quiser obter o resultado da tarefa através da interface Clique para visualizar o exemplo JSON Exemplo de sucesso
|
Resultado da subtarefa (TranscriptionTaskResult)
O TranscriptionTaskResult encapsula o resultado de uma subtarefa. Uma subtarefa reconhece um único arquivo de áudio.
| Interface/Método | Parâmetro | Valor de retorno | Descrição |
|---|---|---|---|
|
| URL do arquivo de áudio reconhecido | Obtém a URL do arquivo de áudio reconhecido. |
|
| URL do resultado do reconhecimento | Obtém a URL do resultado do reconhecimento. Esta URL é válida por 24 horas. Após a expiração, não é mais possível consultar a tarefa ou baixar o resultado pela URL retornada em uma consulta anterior. O resultado do reconhecimento é salvo como um arquivo JSON. Baixe o arquivo através da URL ou leia seu conteúdo diretamente através de uma solicitação HTTP. Para o significado de cada campo nos dados JSON, consulte Recognition result description. |
|
|
| Obtém o status da subtarefa.
|
|
| Informações importantes geradas durante a execução da tarefa, que podem estar vazias | Obtém as informações importantes geradas durante a execução da tarefa. Quando uma tarefa falha, verifique este conteúdo para analisar a causa. |
Descrição do resultado do reconhecimento
O resultado do reconhecimento é salvo como um arquivo JSON.
{
"file_url":"{YOUR_AUDIO_URL}",
"properties":{
"audio_format":"pcm_s16le",
"channels":[
0
],
"original_sampling_rate":16000,
"original_duration_in_milliseconds":3834
},
"transcripts":[
{
"channel_id":0,
"content_duration_in_milliseconds":3720,
"text":"Hello world, this is Alibaba Speech Lab.",
"sentences":[
{
"begin_time":100,
"end_time":3820,
"text":"Hello world, this is Alibaba Speech Lab.",
"sentence_id":1,
"speaker_id":0, //This field is displayed only when automatic speaker diarization is enabled
"words":[
{
"begin_time":100,
"end_time":596,
"text":"Hello ",
"punctuation":""
},
{
"begin_time":596,
"end_time":844,
"text":"world",
"punctuation":", "
}
// Other content is omitted here
]
}
]
}
]
}
Os seguintes parâmetros merecem atenção:
| Parâmetro | Tipo | Descrição |
|---|---|---|
|
| Formato de áudio do arquivo de origem. |
| array[integer] | Índice da faixa de áudio no arquivo de origem. Para áudio de faixa única, [0] é retornado; para áudio de duas faixas, [0, 1] é retornado; e assim por diante. |
|
| Taxa de amostragem (Hz) do áudio no arquivo de origem. |
|
| Duração original do áudio (ms) no arquivo de origem. |
|
| Índice da faixa do resultado da transcrição, começando em 0. |
|
| Duração (ms) do conteúdo na faixa identificado como fala. O service de modelo de reconhecimento de fala transcreve apenas o conteúdo de uma faixa identificado como fala, medindo e faturando com base nessa duração. Conteúdo que não seja fala não é medido nem faturado. Normalmente, a duração do conteúdo de fala é menor que a duração original do áudio. Como a existência de conteúdo de fala é determinada por um modelo de IA, o resultado pode diferir ligeiramente da situação real. |
|
| Resultado da transcrição no nível de parágrafo. |
|
| Resultado da transcrição no nível de sentença. |
|
| Resultado da transcrição no nível de palavra. |
|
| Carimbo de data/hora inicial (ms). |
|
| Carimbo de data/hora final (ms). |
|
| Resultado da transcrição. |
|
| Índice do falante atual, começando em 0, usado para distinguir entre diferentes falantes. Este campo aparece no resultado do reconhecimento apenas quando a diarização de falantes está ativada. |
|
| Pontuação prevista após a palavra, se houver. |
Interfaces principais
Classe de parâmetros de consulta de tarefa (TranscriptionQueryParam)
O TranscriptionQueryParam é usado ao aguardar a conclusão de uma tarefa (chamando o método wait de Transcription) ou ao consultar o resultado da tarefa (chamando o método fetch de Transcription).
Crie uma instância de TranscriptionQueryParam através do método estático FromTranscriptionParam.
// Build the transcription request parameters
TranscriptionParam param =
TranscriptionParam.builder()
// If you have not set the API key as an environment variable, replace apiKey with your own API key
//.apiKey("apikey")
.model("fun-asr")
.fileUrls(
Arrays.asList(
"{YOUR_AUDIO_URL}"))
.build();
try {
Transcription transcription = new Transcription();
// Submit the transcription request
TranscriptionResult result = transcription.asyncCall(param);
System.out.println("RequestId: " + result.getRequestId());
TranscriptionQueryParam queryParam = TranscriptionQueryParam.FromTranscriptionParam(param, result.getTaskId());
} catch (Exception e) {
System.out.println("error: " + e);
}
| Interface/método | Parâmetros | Valor de retorno | Descrição |
|---|---|---|---|
|
| uma instância de | Cria uma instância de |
Classe principal (Transcription)
Importe Transcription com import com.alibaba.dashscope.audio.asr.transcription.*;. Suas interfaces principais são as seguintes:
| Interface/método | Parâmetros | Valor de retorno | Descrição |
|---|---|---|---|
|
| Task result (TranscriptionResult) | Envia uma tarefa de reconhecimento de fala de forma assíncrona. |
|
| Task result (TranscriptionResult) | Bloqueia a thread atual até que a tarefa assíncrona termine (o status da tarefa é |
|
| Task result (TranscriptionResult) | Consulta o resultado da tarefa atual de forma assíncrona. |
Códigos de erro
Se encontrar um erro, consulte Error codes para solução de problemas.
Quando uma tarefa contém várias subtarefas, o status geral da tarefa é marcado como SUCCEEDED desde que pelo menos uma subtarefa tenha sucesso. Verifique o campo subtask_status para determinar o resultado de cada subtarefa.
Exemplo de resposta de erro:
{
              "task_id": "7bac899c-06ec-4a79-8875-xxxxxxxxxxxx",
              "task_status": "SUCCEEDED",
              "submit_time": "2024-12-16 16:30:59.170",
              "scheduled_time": "2024-12-16 16:30:59.204",
              "end_time": "2024-12-16 16:31:02.375",
              "results": [
                  {
                      "file_url": "{YOUR_AUDIO_URL}",
                      "code": "InvalidFile.DownloadFailed",
                      "message": "The audio file cannot be downloaded.",
                      "subtask_status": "FAILED"
                  }
              ],
              "task_metrics": {
                  "TOTAL": 1,
                  "SUCCEEDED": 0,
                  "FAILED": 1
              }
          }
FAQ
Recursos
P: Áudio codificado em Base64 é suportado?
Áudio codificado em Base64 não é suportado. Apenas áudio em uma URL acessível publicamente pode ser reconhecido. Fluxos binários e arquivos locais não podem ser reconhecidos diretamente.
P: Como torno um arquivo de áudio disponível em uma URL acessível publicamente?
As etapas típicas são as seguintes. Esta é uma abordagem; o processo exato varia conforme o product de armazenamento. Recomendamos que você upload the audio to Alibaba Cloud OSS:
1. Escolha um método de armazenamento e hospedagem
Por exemplo:
-
Object Storage Service (recomendado):
- Use o Object Storage Service de um provedor cloud (como Alibaba Cloud OSS) para carregar o arquivo de áudio em um bucket e configurá-lo para acesso público.
- Vantagens: alta disponibilidade, suporte a aceleração CDN e gerenciamento fácil.
-
Servidor web:
- Coloque o arquivo de áudio em um servidor web que suporte acesso HTTP/HTTPS (como Nginx ou Apache).
- Vantagens: adequado para pequenos projetos ou testes locais.
-
Rede de distribuição de conteúdo (CDN):
- Hospede o arquivo de áudio em uma CDN e acesse-o através da URL fornecida pela CDN.
- Vantagens: acelera a entrega de arquivos e é adequado para cenários de alta concorrência.
2. Carregue o arquivo de áudio
Carregue o áudio de acordo com o método de armazenamento ou hospedagem escolhido. Por exemplo:
-
Object Storage Service:
- Faça login no console do provedor cloud e crie um bucket.
- Carregue o arquivo de áudio e defina sua permissão como leitura pública ou gere um link de acesso temporário.
-
Servidor web:
- Coloque o arquivo de áudio em um diretório designado no servidor (como
/var/www/html/audio/). - Certifique-se de que o arquivo esteja acessível via HTTP/HTTPS.
- Coloque o arquivo de áudio em um diretório designado no servidor (como
3. Gere uma URL acessível publicamente
Por exemplo:
-
Object Storage Service:
- Após o carregamento do arquivo, o sistema gera automaticamente uma URL de acesso público (geralmente no formato
https://<bucket-name>.<region>.aliyuncs.com/<file-name>). - Para um nome de domínio mais amigável, vincule um domínio personalizado e ative HTTPS.
- Após o carregamento do arquivo, o sistema gera automaticamente uma URL de acesso público (geralmente no formato
-
Servidor web:
- A URL de acesso geralmente é o endereço do servidor mais o caminho do arquivo (como
https://your-domain.com/audio/file.mp3).
- A URL de acesso geralmente é o endereço do servidor mais o caminho do arquivo (como
-
CDN:
- Após configurar a aceleração CDN, use a URL fornecida pela CDN (como
https://cdn.your-domain.com/audio/file.mp3).
- Após configurar a aceleração CDN, use a URL fornecida pela CDN (como
4. Verifique se a URL funciona
Certifique-se de que a URL gerada seja acessível pela rede pública. Por exemplo:
- Abra a URL em um navegador e verifique se o arquivo de áudio é reproduzido.
- Use uma ferramenta (como
curlou Postman) para verificar se a URL retorna a resposta HTTP correta (código de status 200).
Ao usar o SDK, se os arquivos de áudio estiverem armazenados no Alibaba Cloud OSS, URLs temporárias com o prefixo oss:// não são suportadas.
Ao usar a API RESTful, se os arquivos de áudio estiverem armazenados no Alibaba Cloud OSS, URLs temporárias com o prefixo oss:// são suportadas:
- A URL temporária é válida por 48 horas e não pode ser usada após a expiração. Não utilize em ambiente de produção.
- A API para obtenção de credencial de upload tem limite de 100 QPS e não suporta scale out. Não utilize em ambientes de produção, cenários de alta concorrência ou cenários de teste de estresse.
- Para ambientes de produção, use um service de armazenamento estável, como OSS, para garantir a disponibilidade de arquivos a longo prazo e evitar problemas de limitação de taxa.
P: Quanto tempo leva para obter o resultado do reconhecimento?
Após o envio de uma tarefa, ela entra no estado de fila (PENDING). O tempo de espera depende do tamanho da fila e da duração do áudio, portanto não pode ser afirmado com exatidão, mas geralmente fica dentro de alguns minutos. Em geral, quanto mais longo o áudio, mais tempo leva.
Solução de problemas
Se o seu código retornar um erro, solucione-o com base nas informações em Error codes.
P: A sondagem nunca retorna um resultado?
Isso pode ser causado por limitação de taxa. Aguarde um momento e tente novamente.
P: Por que a fala não pode ser reconhecida (sem resultado de reconhecimento)?
Verifique se o formato de áudio e a taxa de amostragem estão corretos e atendem às restrições de parâmetros.
Use a ferramenta ffprobe para obter o container de áudio, codec, taxa de amostragem, canais e outros detalhes:
ffprobe -v error -show_entries format=format_name -show_entries stream=codec_name,sample_rate,channels -of default=noprint_wrappers=1 input.xxx