Alguns modelos compatíveis com o Token Plan (como qwen3.8-max, qwen3.7-plus) oferecem suporte nativo à compreensão visual e processam entradas de imagem diretamente. Para modelos exclusivos de texto, como glm-5.2 e deepseek-v4-pro, adicione recursos visuais configurando um Skill local.
ObservaçãoA execução do Skill de compreensão de imagens consome créditos do Token Plan. Não há cobranças adicionais.
Pré-requisitos
- Assine o Token Plan.
- Conclua a configuração de integração em uma ferramenta de IA e confirme que o chat funciona normalmente. Para mais detalhes, consulte Clients and Developer Tools.
Suporte a visão
Para saber se cada modelo oferece suporte à compreensão visual, consulte as tabelas de modelos com suporte na Visão geral do Token Plan Personal Edition e na Visão geral do Token Plan Team Edition.
Método 1: Usar um modelo de visão diretamente (recomendado)
O qwen3.7-plus e outros modelos possuem recursos de compreensão visual. Se você precisa processar imagens com frequência, mudar para um desses modelos é a abordagem mais simples e recomendada.
Ferramenta | Como trocar de modelo |
|---|---|
Claude Code |
|
OpenCode |
|
Qwen Code |
|
Para mais informações sobre como trocar modelos em outras ferramentas de codificação, consulte Clients and Developer Tools. Após a troca, referencie caminhos de imagem diretamente na conversa ou arraste e solte/cole imagens.
Método 2: Adicionar recursos visuais via Skill ou Agent
Caso precise usar modelos exclusivos de texto, como glm-5.2 ou deepseek-v4-pro, para processamento de imagens, configure um Skill ou Agent para ativar os recursos visuais.
Claude Code
-
Adicionar o Skill
Crie uma pasta
.claudeno diretório do projeto e crie um diretórioskills/image-analyzerdentro dela:
mkdir -p .claude/skills/image-analyzer
Crie um arquivo SKILL.md nesse diretório com o seguinte conteúdo:
---
name: image-analyzer
description: Helps models without vision capabilities understand images. Use this skill when you need to analyze image content, extract information, text, or UI elements from images, or understand screenshots, charts, architecture diagrams, or any visual content. Simply pass in the image path to get a description.
model: qwen3.7-plus
---
qwen3.7-plus has visual understanding capabilities. Use qwen3.7-plus directly for image understanding.
A estrutura de diretórios resultante é a seguinte:
.claude/
└── skills/
    └── image-analyzer/
        └── SKILL.md
-
Começar a usar
-
Execute
claudeno diretório do projeto para iniciar o Claude Code e execute/model deepseek-v4-propara mudar para o modelodeepseek-v4-pro. -
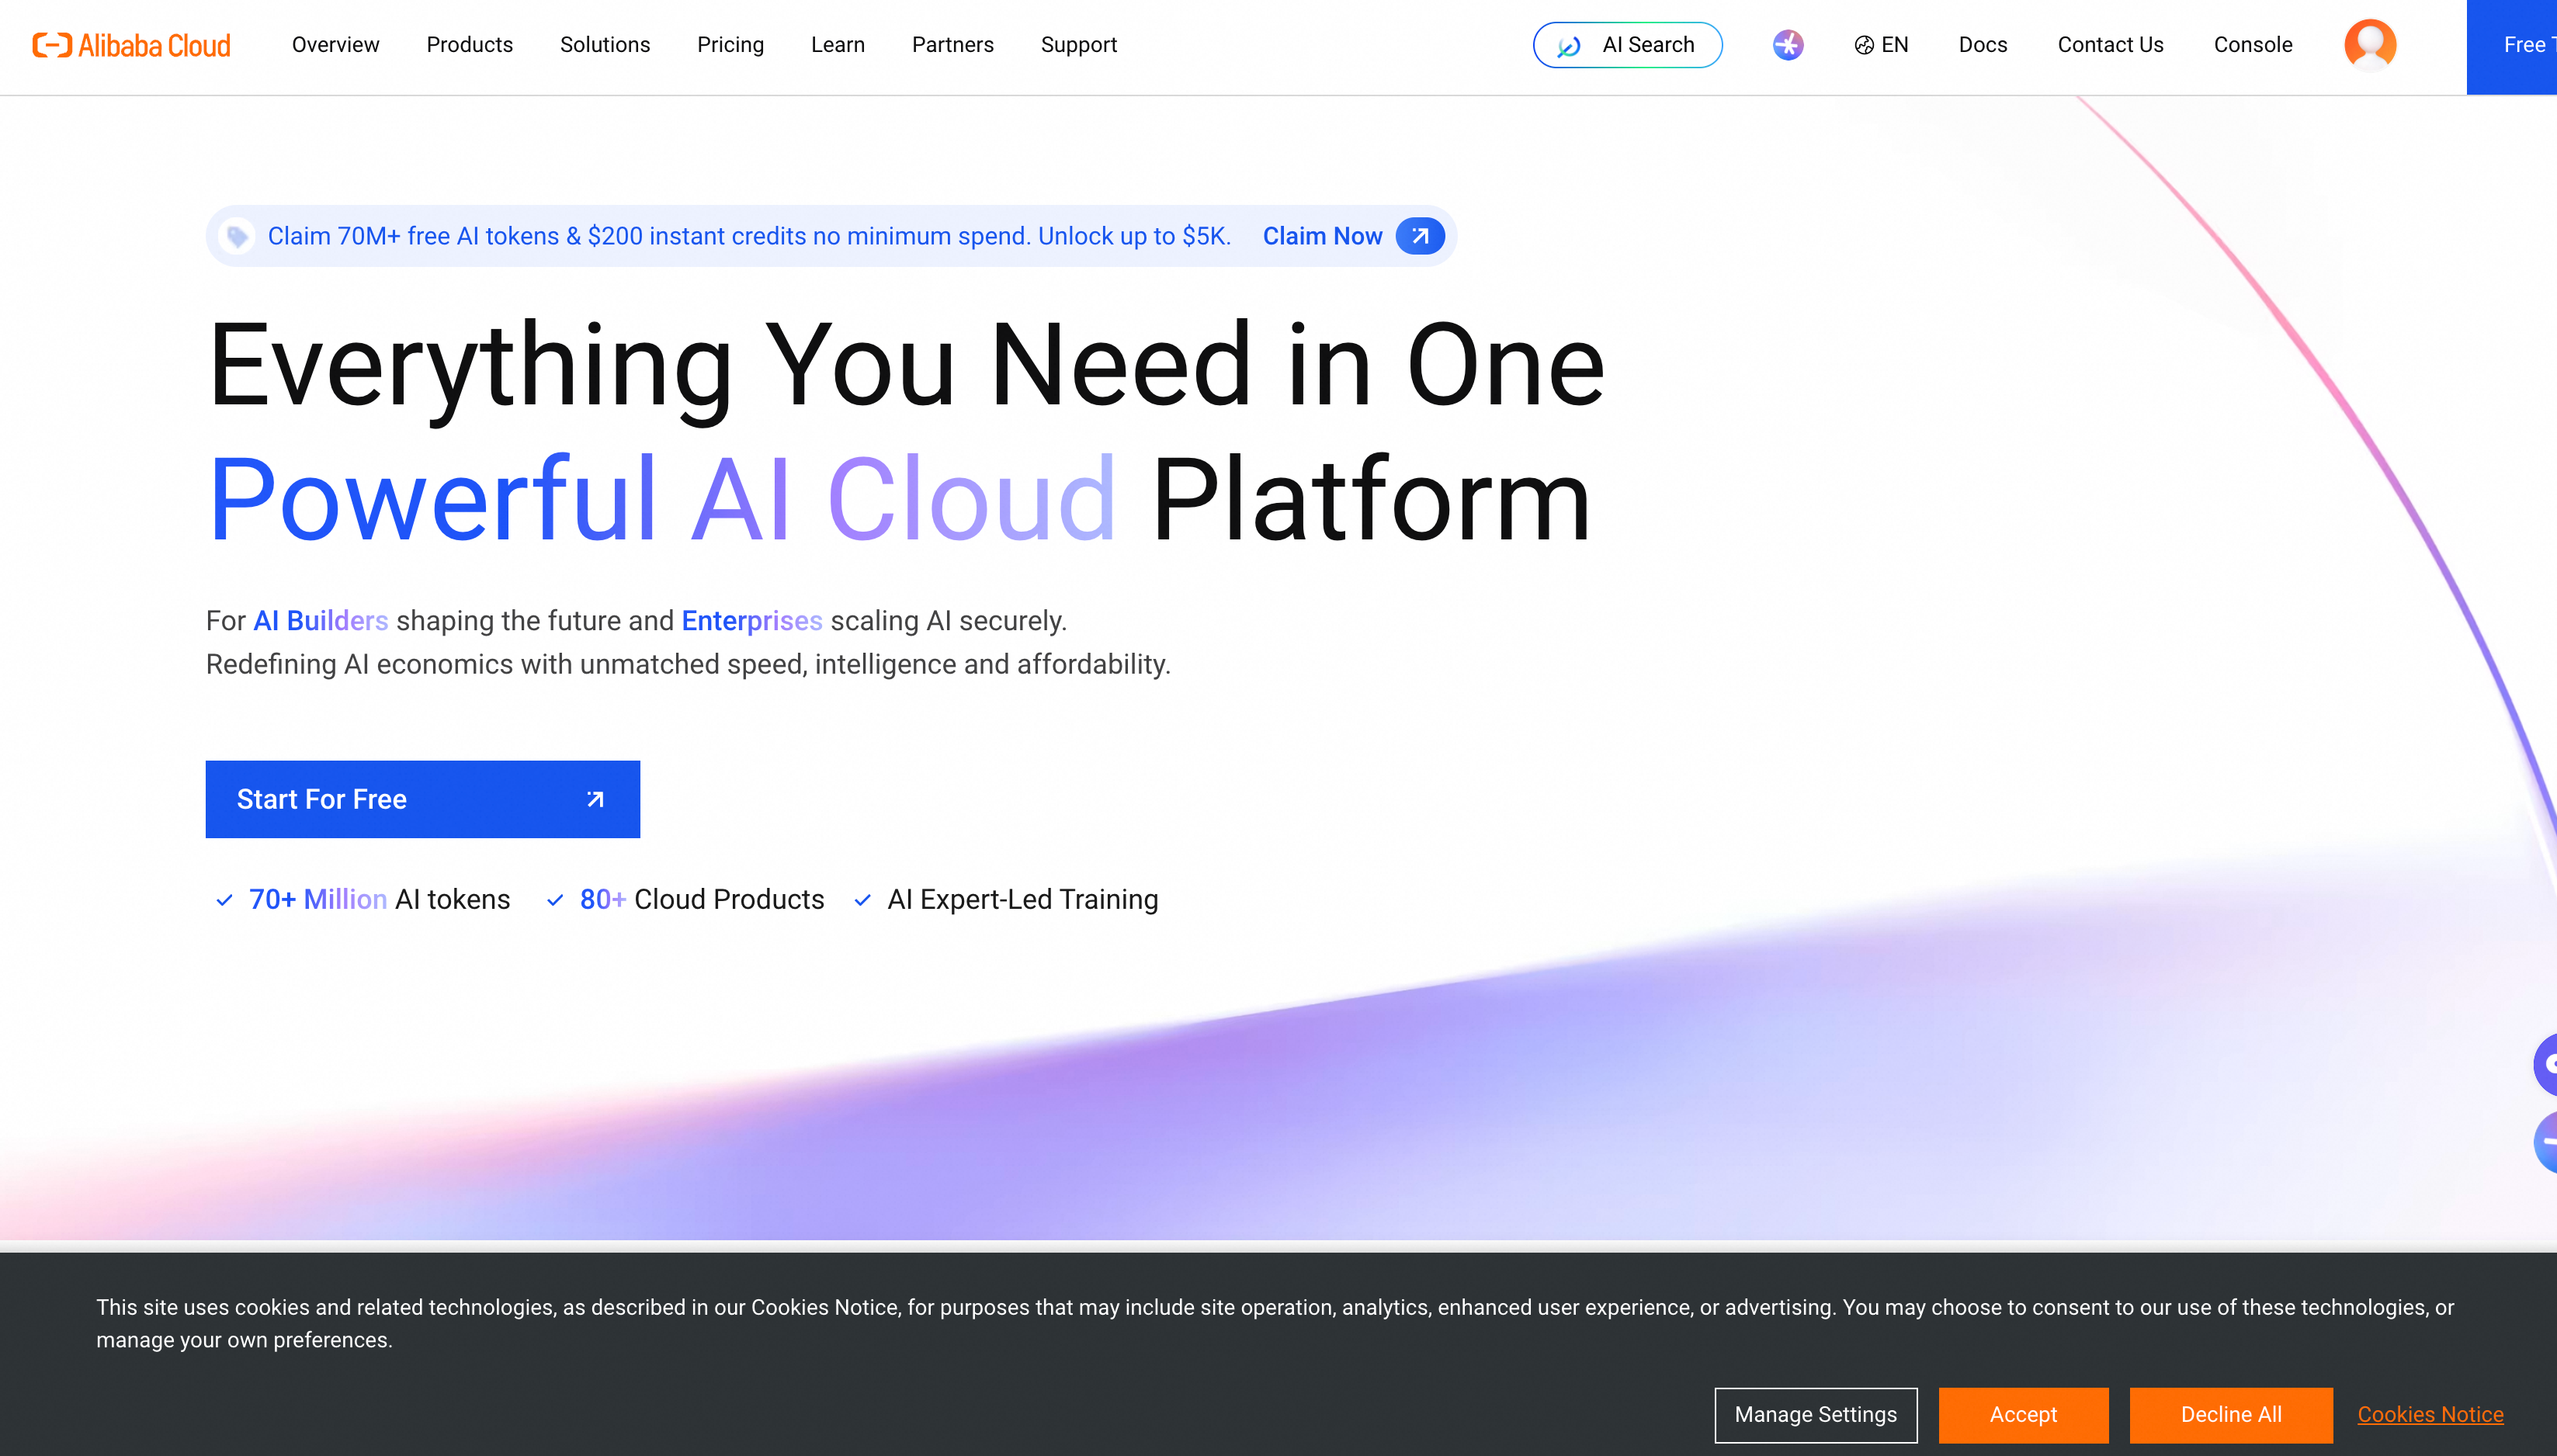
Baixe alibabacloud.png para o diretório do projeto e pergunte:
Load image-analyzer skill and describe the information displayed at the alibabacloud.png banner location.A resposta será semelhante à seguinte:O alibabacloud.png é uma captura de tela da página inicial do Alibaba Cloud. O título da área do banner é Coding Plan now supports Qwen3.5, e o texto informa que o Alibaba Cloud Model Studio oferece suporte a modelos como Qwen3.5, Kimi-k2.5 e GLM-4.7, com novos clientes obtendo o primeiro mês por apenas 7,9 yuans. A página fornece pontos de entrada para Subscribe now e Online consultation.
-
OpenCode
-
Adicionar o Agent
Crie uma pasta
.opencodeno diretório do projeto e crie um diretórioagentsdentro dela:
mkdir -p .opencode/agents
Crie um arquivo image-analyzer.md nesse diretório com o seguinte conteúdo:
ObservaçãoO campo model deve usar o provedor e o nome do modelo definidos no arquivo de configuração do OpenCode. Consulte o exemplo de configuração na documentação OpenCode. O valor deve ser bailian-token-plan/qwen3.7-plus.
---
description: Analyzes images using a vision-capable model. Use this agent when the user needs to understand image content, extract information from screenshots, diagrams, UI mockups, or any visual content. Invoke with @image-analyzer followed by the image path and your question.
mode: subagent
model: bailian-token-plan/qwen3.7-plus
tools:
  write: false
  edit: false
---
You have vision capabilities. Analyze the provided image and return a clear, structured description focused on what the user is asking about.
A estrutura de diretórios resultante é a seguinte:
.opencode/
└── agents/
    └── image-analyzer.md
-
Começar a usar
- Execute
opencodeno diretório do projeto para iniciar o OpenCode e mude para o modelodeepseek-v4-pro. - Baixe alibabacloud.png para o diretório do projeto, invoque
@``image-analyzere pergunte:@image-analyzer describe the information displayed at the alibabacloud.png banner location.A resposta será semelhante à seguinte:
- Execute
The banner area contains:
Left side:
- Hamburger menu icon
- Alibaba Cloud orange logo and text
- Navigation menu: Large Models, Products, Solutions, Benefits, Pricing, Marketplace, Partners, Services, About Alibaba Cloud
Right side:
- Search box (displaying "Large Models")
- Icons: blue circle, globe, headset
- Links: Documentation, ICP Filing, Console
Build · deepseek-v4-pro · 37.0s
FAQ
Por que o OpenCode + um modelo de visão não consegue entender imagens?
Causa: O OpenCode não ativa os recursos de visão de um modelo por padrão. Declare explicitamente o parâmetro modalities no arquivo de configuração.
Solução: Adicione um campo modalities à definição do modelo no arquivo de configuração do OpenCode e defina input como ["text", "image"], conforme mostrado abaixo:
Substitua sk-sp-xxx pela sua API Key do Token Plan.
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "bailian-token-plan": {
      "npm": "@ai-sdk/anthropic",
      "name": "Model Studio Token Plan",
      "options": {
        "baseURL": "https://token-plan.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
        "apiKey": "sk-sp-xxx"
      },
      "models": {
        "qwen3.7-plus": {
          "name": "Qwen3.6 Plus",
          "modalities": {
            "input": [
              "text",
              "image"
            ],
            "output": [
              "text"
            ]
          },
          "options": {
            "thinking": {
              "type": "enabled",
              "budgetTokens": 1024
            }
          }
        },
        "qwen3.8-flash": {
          "name": "Qwen3.8 Flash",
          "modalities": {
            "input": [
              "text",
              "image"
            ],
            "output": [
              "text"
            ]
          },
          "options": {
            "thinking": {
              "type": "enabled",
              "budgetTokens": 1024
            }
          }
        },
        "qwen3.8-max": {
          "name": "Kimi K2.5",
          "modalities": {
            "input": [
              "text",
              "image"
            ],
            "output": [
              "text"
            ]
          },
          "options": {
            "thinking": {
              "type": "enabled",
              "budgetTokens": 1024
            }
          }
        }
      }
    }
  }
}
Por que o OpenClaw + um modelo de visão não consegue entender imagens?
Causa: O OpenClaw exige o campo input no arquivo de configuração para determinar se um modelo oferece suporte a recursos de visão.
Solução:
- No arquivo de configuração
~/.openclaw/openclaw.json, verifique se a definição do modelo inclui o campo"input": ["text", "image"].
{
  "models": {
    "mode": "merge",
    "providers": {
      "bailian": {
        "baseUrl": "https://token-plan.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
        "apiKey": "YOUR_API_KEY",
        "api": "openai-completions",
        "models": [
          {
            "id": "qwen3.7-plus",
            "name": "qwen3.7-plus",
            "reasoning": false,
            "input": ["text", "image"],
            "cost": { "input": 0, "output": 0, "cacheRead": 0, "cacheWrite": 0 },
            "contextWindow": 1000000,
            "maxTokens": 65536
          },
          {
            "id": "qwen3.8-flash",
            "name": "qwen3.8-flash",
            "reasoning": false,
            "input": ["text", "image"],
            "cost": { "input": 0, "output": 0, "cacheRead": 0, "cacheWrite": 0 },
            "contextWindow": 1000000,
            "maxTokens": 65536
          },
          {
            "id": "qwen3.8-max",
            "name": "qwen3.8-max",
            "reasoning": false,
            "input": ["text", "image"],
            "cost": { "input": 0, "output": 0, "cacheRead": 0, "cacheWrite": 0 },
            "contextWindow": 262144,
            "maxTokens": 32768
          }
        ]
      }
    }
  },
  "agents": {
    "defaults": {
      "model": {
        "primary": "bailian/qwen3.7-plus"
      },
      "models": {
        "bailian/qwen3.7-plus": {},
        "bailian/qwen3.8-flash": {},
        "bailian/qwen3.8-max": {}
      }
    }
  },
  "gateway": {
    "mode": "local"
  }
}
- Após modificar a configuração, limpe o cache de modelos do OpenClaw e reinicie. Caso contrário, a configuração antiga permanecerá em vigor.
rm ~/.openclaw/agents/main/agent/models.json
openclaw gateway restart