O MaxCompute Spark acessa o Object Storage Service (OSS) da Alibaba Cloud por meio do kit de desenvolvimento de software (SDK) Jindo. O Jindo SDK é um cliente OSS de alto desempenho projetado para o ecossistema Hadoop e Spark. Ele fornece uma implementação do Hadoop FileSystem altamente otimizada para o Alibaba Cloud OSS.
Etapa 1: Configure a classe de implementação e o endpoint do OSS
No modo local, use o endpoint público da região correspondente. No modo cluster, use o endpoint interno. Para mais informações, consulte Regions and endpoints.
-
Spark 3.5+ (integra o JindoSDK 6.5 por padrão). Adicione as seguintes configurações:
spark.hadoop.fs.AbstractFileSystem.oss.impl=com.aliyun.jindodata.oss.JindoOSS spark.hadoop.fs.oss.impl=com.aliyun.jindodata.oss.JindoOssFileSystem spark.hadoop.fs.oss.endpoint=oss-${RegionId}-internal.aliyuncs.com -
Outras versões (se usar o JindoSDK 3.7). Adicione as seguintes configurações:
spark.hadoop.fs.AbstractFileSystem.oss.impl=com.aliyun.emr.fs.oss.OSS
spark.hadoop.fs.oss.impl=com.aliyun.emr.fs.oss.JindoOssFileSystem
spark.hadoop.fs.oss.endpoint=oss-${RegionId}-internal.aliyuncs.com
Etapa 2: Configure as informações de autenticação
Escolha um dos dois métodos de autenticação a seguir.
Método 1: Use um AccessKeyID e AccessKeySecret
Adicione as seguintes configurações ao arquivo spark-defaults.conf ou à sua configuração do DataWorks:
spark.hadoop.fs.oss.accessKeyId=${AccessId}
spark.hadoop.fs.oss.accessKeySecret=${AccessKey}
Método 2: Use um token do Security Token Service
Para mais informações, consulte Authorize access in STS mode. Em seguida, adicione as seguintes configurações.
Configuração do Spark 3.5+
## Add the following configuration items to the spark-defaults.conf file or your DataWorks configuration:
spark.hadoop.fs.oss.credentials.provider=com.aliyun.jindodata.oss.auth.CustomCredentialsProvider
spark.hadoop.aliyun.oss.provider.url=http://localhost:10011/sts-token-info?user_id=${AliyunUid}&role=${RoleName}
Configuração para outras versões
## Add the following configuration items to the spark-defaults.conf file or your DataWorks configuration:
spark.hadoop.odps.cupid.http.server.enable=true
spark.hadoop.fs.jfs.cache.oss.credentials.provider=com.aliyun.emr.fs.auth.CustomCredentialsProvider
spark.hadoop.aliyun.oss.provider.url=http://localhost:10011/sts-token-info?user_id=${AliyunUid}&role=${RoleName}
Etapa 3: Referencie a dependência do JindoSDK (ignore esta etapa para o Spark 3.5+)
-
Modo local
No modo local, baixe o JindoSDK e adicione-o ao classpath.
-
Acesse File > Project Structure.
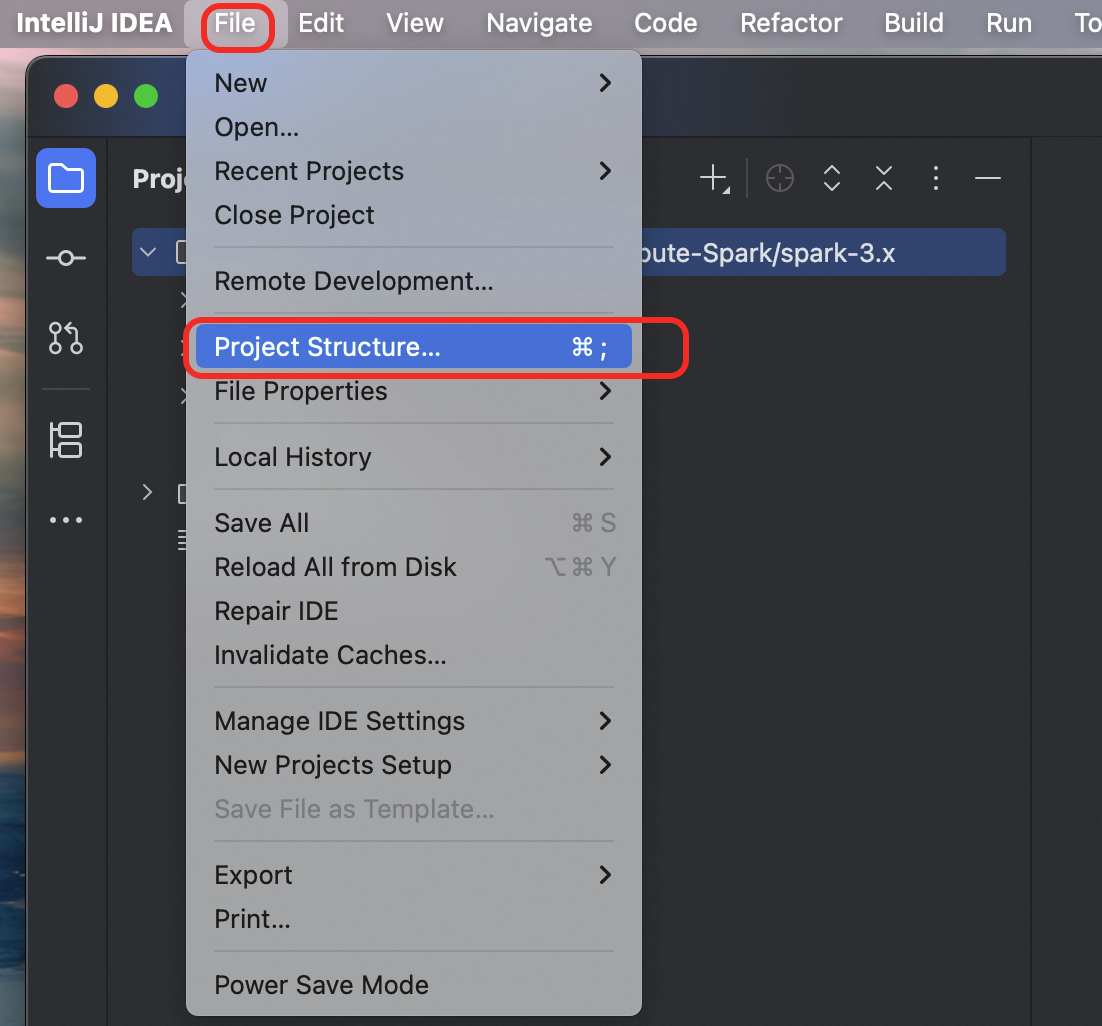
-
No painel de navegação à esquerda, selecione
Modules, clique no ícone+e selecioneJARs or Directories.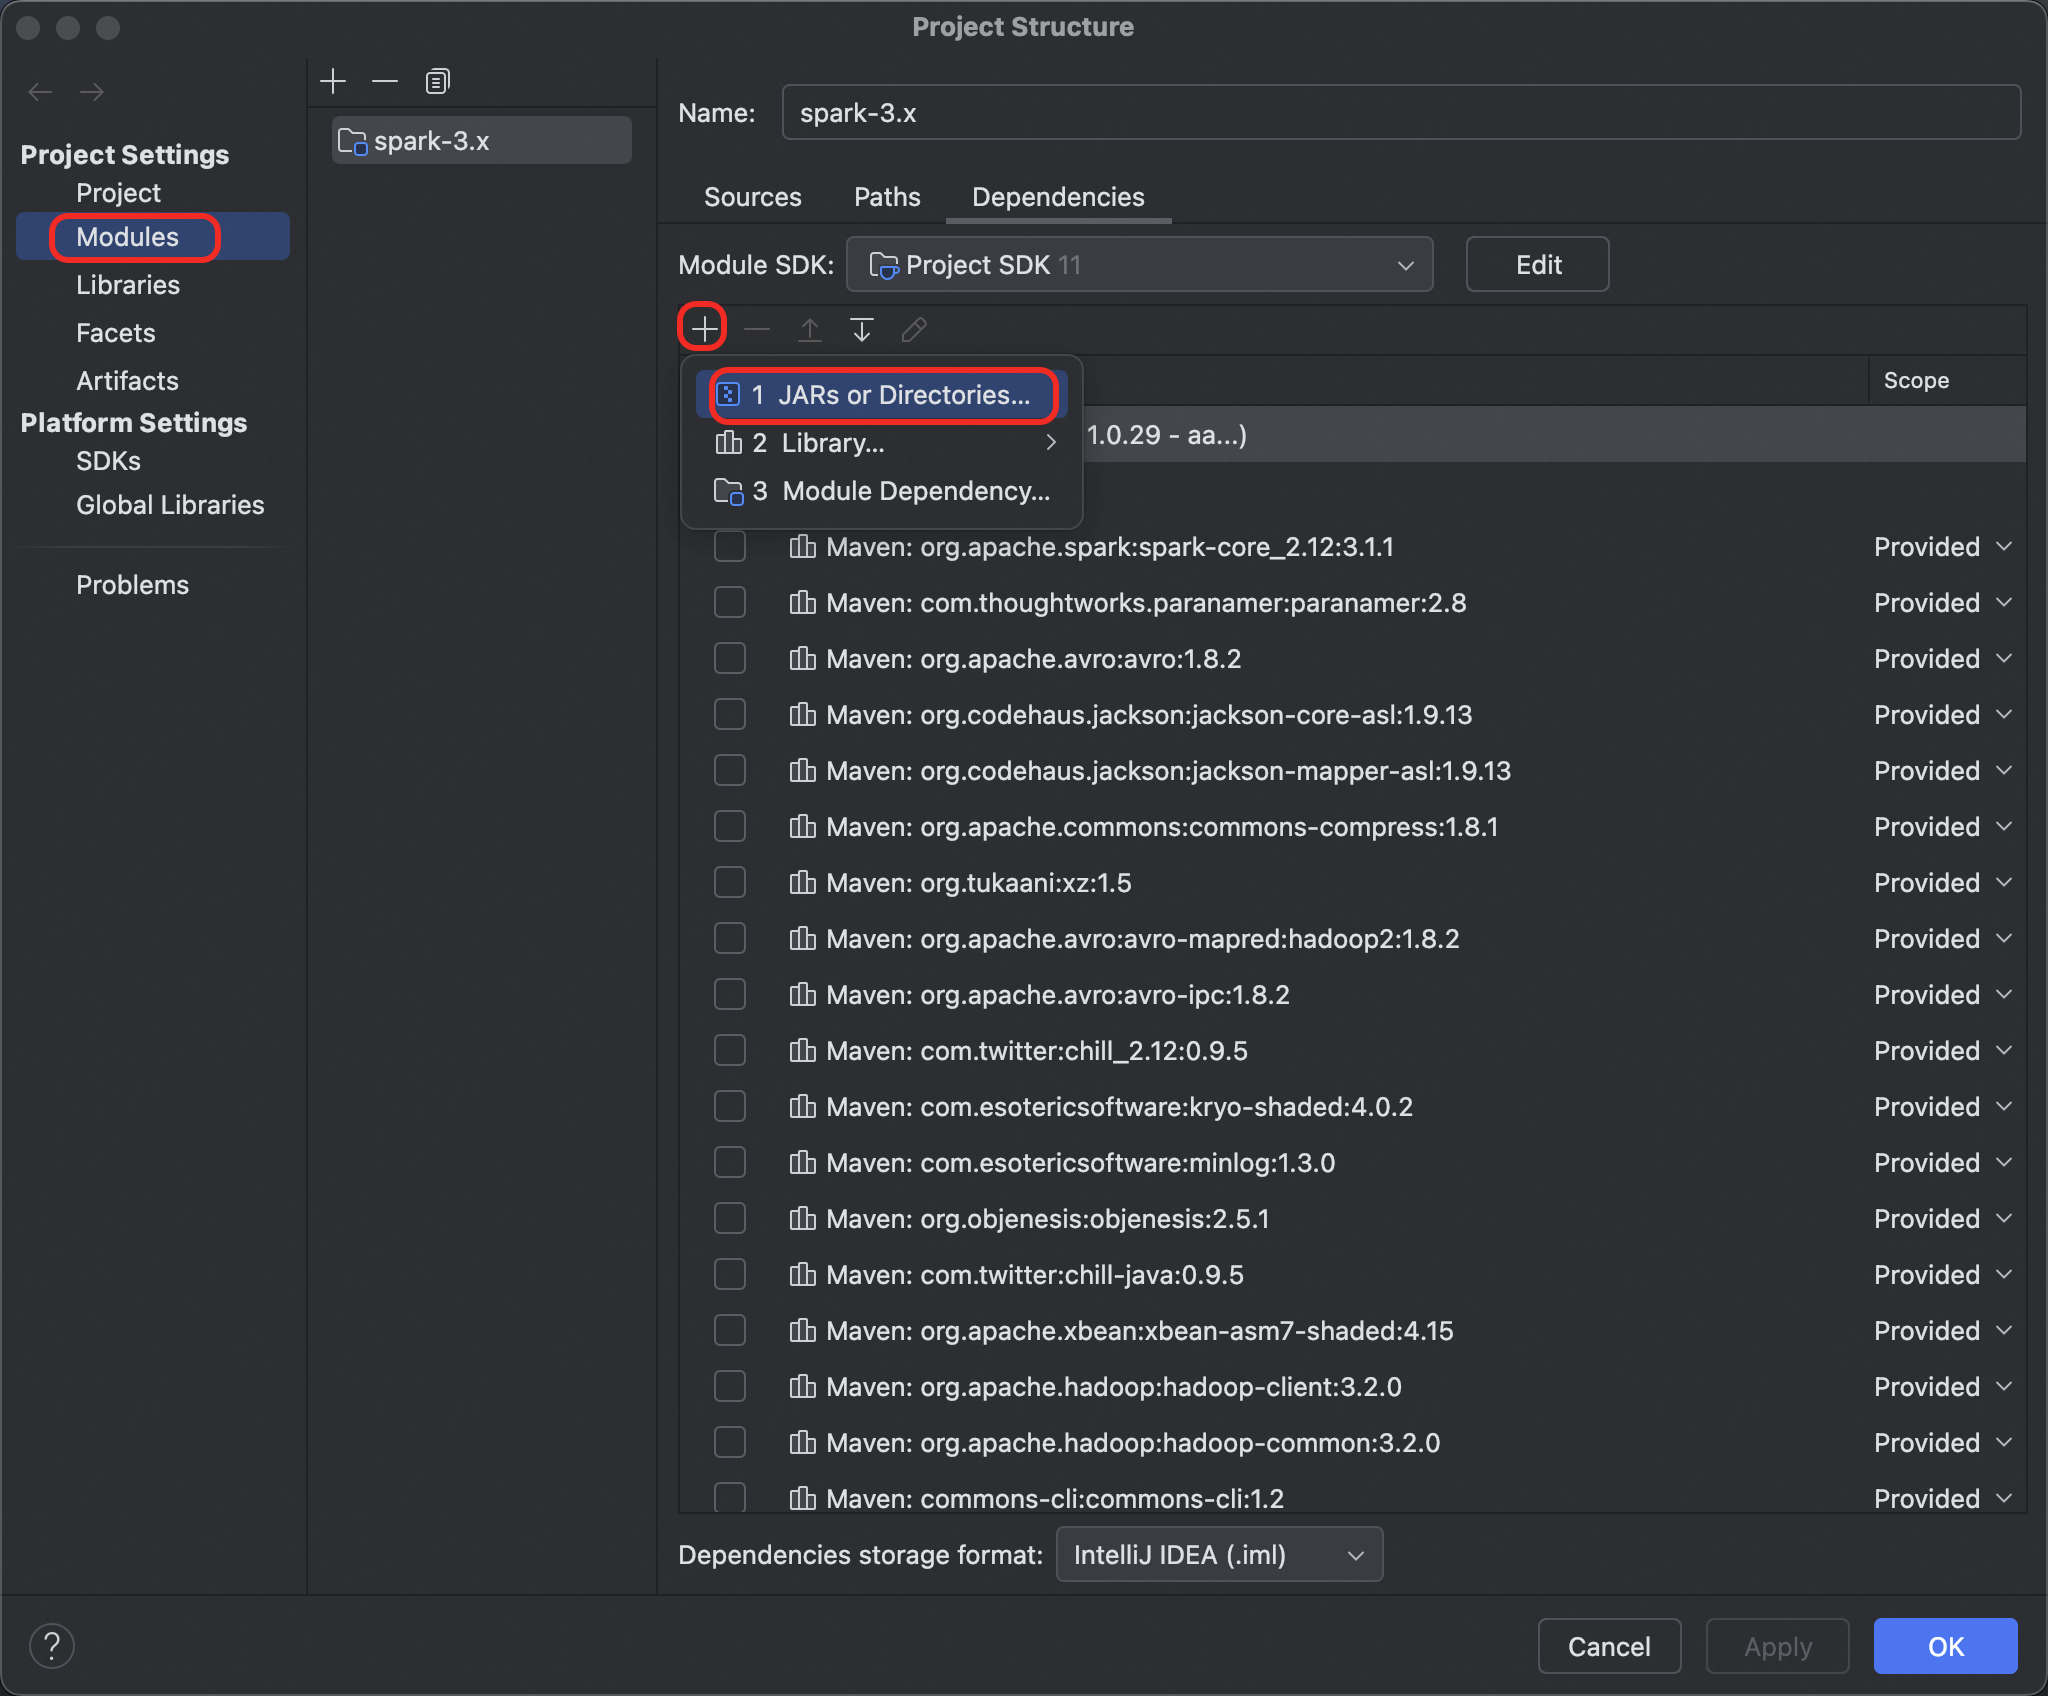
Adicione todos os arquivos JAR da pasta
libdo JindoSDK.No IDEA, clique em OK.
-
-
Modo cluster
Para o Spark 3.5, o servidor já inclui o Jindo SDK. Você não precisa realizar nenhuma ação.
-
Para outras versões, modifique o arquivo
spark-defaults.conf. Adicione a seguinte configuração para usar os recursos públicos:spark.hadoop.odps.cupid.resources = public.jindofs-sdk-3.7.2.jar ## Note: To use a different version of the JindoSDK, download the corresponding SDK version, upload it to your project, and then reference it using spark.hadoop.odps.cupid.resources.
Etapa 4: Configure a lista de permissões de rede
Por padrão, você pode acessar o OSS diretamente sem nenhuma configuração.
-
No modo cluster, se não conseguir acessar o OSS, adicione o nome de domínio do bucket de destino à lista de permissões do job. Para isso, adicione a seguinte configuração ao arquivo
spark-defaults.confou à sua configuração do DataWorks:spark.hadoop.odps.cupid.trusted.services.access.list=${BucketName}.oss-${RegionId}-internal.aliyuncs.com
Etapa 5: Envie o job
./bin/spark-submit --class xxx spark-app.jar