Os operadores nativos PIVOT e UNPIVOT do MaxCompute são a abordagem recomendada para reestruturar dados, pois oferecem sintaxe concisa e bom desempenho. Este tópico aborda os métodos manuais com SQL padrão e funções integradas específicas do MaxCompute, que proporcionam maior flexibilidade para lógicas de agregação complexas não suportadas pelos operadores nativos.
Como funcionam pivot e unpivot
O diagrama a seguir ilustra os conceitos de pivot e unpivot. 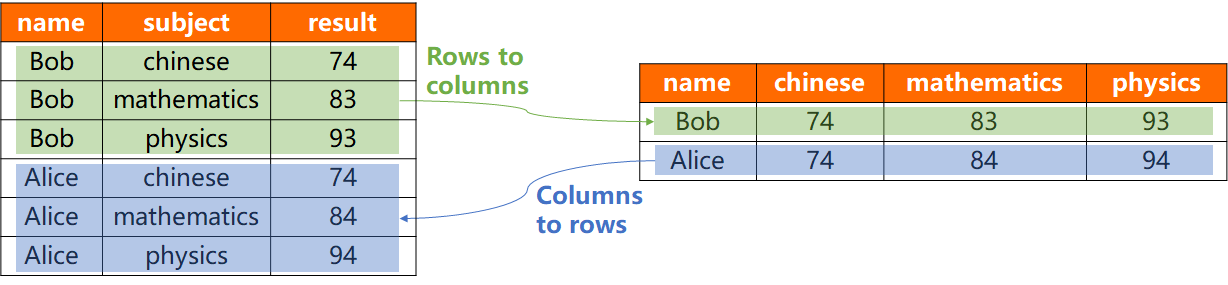
Pivot (linhas para colunas): Transforma uma tabela no formato longo em um formato amplo. Esse processo rotaciona valores de uma única coluna (por exemplo,
subject) para várias novas colunas.Unpivot (colunas para linhas): Converte uma tabela no formato amplo para o formato longo. Várias colunas (como
chineseemathematics) são consolidadas em uma única coluna de valores, enquanto uma nova coluna identifica a origem de cada dado.
Dados de amostra
Os exemplos deste tópico utilizam as duas tabelas a seguir.
-
Crie a tabela de source
rowtocolumne insira dados para os exemplos de pivot.CREATE TABLE rowtocolumn (name string, subject string, result bigint); INSERT INTO TABLE rowtocolumn VALUES ('Bob' , 'chinese' , 74), ('Bob' , 'mathematics' , 83), ('Bob' , 'physics' , 93), ('Alice' , 'chinese' , 74), ('Alice' , 'mathematics' , 84), ('Alice' , 'physics' , 94);Selecione a tabela
rowtocolumn:SELECT * FROM rowtocolumn; -- Result: +------------+-------------+------------+ | name | subject | result | +------------+-------------+------------+ | Alice | chinese | 74 | | Alice | mathematics | 83 | | Alice | physics | 93 | | Bob | chinese | 74 | | Bob | mathematics | 84 | | Bob | physics | 94 | +------------+-------------+------------+ -
Crie a tabela de source
columntorowe insira dados para os exemplos de unpivot.CREATE TABLE columntorow (name string, chinese bigint, mathematics bigint, physics bigint); INSERT INTO TABLE columntorow VALUES ('Bob' , 74, 83, 93), ('Alice', 74, 84, 94);Selecione a tabela
columntorow:SELECT * FROM columntorow; -- Result: +------------+------------+-------------+------------+ | name | chinese | mathematics | physics | +------------+------------+-------------+------------+ | Bob | 74 | 83 | 93 | | Alice | 74 | 84 | 94 | +------------+------------+-------------+------------+
Pivot com CASE WHEN ou funções integradas
Os métodos a seguir convertem dados de linhas para colunas (pivot).
|
Método |
Mais indicado para |
Desvantagem |
|
CASE WHEN (padrão SQL) |
Portabilidade, legibilidade e quantidade fixa de colunas |
Verbosidade excessiva com muitas colunas de pivot |
|
Funções integradas (específicas do MaxCompute) |
Concisão ao lidar com muitos valores de pivot |
Dependência da plataforma; sobrecarga na manipulação de strings |
-
Método 1: CASE WHEN (padrão SQL) Esta abordagem utiliza agregação condicional. Uma expressão
CASE WHENextrai a nota de cada matéria e uma função de agregação comoMAX()consolida os resultados em uma única linha por aluno.Quando usar:
A portabilidade é prioridade, já que a lógica SQL padrão funciona em praticamente qualquer sistema de banco de dados.
A legibilidade é essencial, pois a lógica é explícita e fácil de acompanhar para qualquer desenvolvedor SQL.
O número de colunas de pivot é fixo e gerenciável.
Desvantagens:
Torna-se verboso e difícil de manter quando o pivot envolve um grande número de colunas.
SELECT
    name,
    MAX(CASE subject WHEN 'chinese' THEN result END) AS chinese,
    MAX(CASE subject WHEN 'mathematics' THEN result END) AS mathematics,
    MAX(CASE subject WHEN 'physics' THEN result END) AS physics
FROM rowtocolumn
GROUP BY name;
Resultado:
+--------+------------+-------------+------------+ | name | chinese | mathematics | physics | +--------+------------+-------------+------------+ | Bob | 74 | 83 | 93 | | Alice | 74 | 84 | 94 | +--------+------------+-------------+------------+ -
Método 2: Funções integradas (específicas do MaxCompute) Este método usa primeiro CONCAT e WM_CONCAT para agregar matérias e notas em uma única string chave-valor por aluno. Em seguida, a função KEYVALUE analisa essa string para extrair a nota de cada matéria em uma coluna separada.
Quando usar:
A concisão do código é prioritária, especialmente quando há muitos valores de pivot.
Você trabalha dentro do ecossistema MaxCompute e não precisa de compatibilidade entre plataformas.
Desvantagens:
Dependência da plataforma, pois o código não é portável para outros bancos de dados SQL.
Possível gargalo de desempenho, já que a manipulação de strings em conjuntos de dados muito grandes pode ser menos eficiente do que a agregação direta.
SELECT
    name,
    KEYVALUE(key_value_string, 'chinese') AS chinese,
    KEYVALUE(key_value_string, 'mathematics') AS mathematics,
    KEYVALUE(key_value_string, 'physics') AS physics
FROM (
    SELECT
        name,
        WM_CONCAT(';', CONCAT(subject, ':', result)) AS key_value_string
    FROM rowtocolumn
    GROUP BY name
) AS source_with_concat;
Resultado:
+--------+------------+-------------+------------+
| name   | chinese    | mathematics | physics    |
+--------+------------+-------------+------------+
| Bob    | 74         | 83          | 93         |
| Alice  | 74         | 84          | 94         |
+--------+------------+-------------+------------+
Para transformações de dados que expandem uma única linha em várias linhas, use Lateral View com funções como EXPLODE , INLINE ou TRANS_ARRAY .
Unpivot com UNION ALL ou funções integradas
Os métodos abaixo convertem dados de colunas para linhas (unpivot).
|
Método |
Mais indicado para |
Desvantagem |
|
UNION ALL (padrão SQL) |
Correção, portabilidade e segurança com NULL |
Múltiplas varreduras na tabela; verbosidade aumenta conforme o número de colunas |
|
Funções integradas (específicas do MaxCompute) |
Desempenho em tabelas grandes |
Dependência da plataforma; sintaxe complexa; risco de perda de dados NULL |
-
Método 1: UNION ALL (padrão SQL) Esta técnica combina várias instruções
SELECTcomUNION ALL, onde cada instrução recupera uma coluna diferente de matéria. Isso transforma efetivamente as colunas de matérias (chinese,mathematics,physics) em uma única colunasubject.Quando usar:
Correção e portabilidade são fundamentais. Este é o método mais confiável e universalmente compatível, além de lidar com valores NULL naturalmente, sem lógica extra.
Clareza é mais importante que desempenho. A intenção do código fica imediatamente óbvia, mesmo que não seja a opção mais performática.
Desvantagens:
Penalidade de desempenho em tabelas grandes, pois varrer uma tabela extensa várias vezes pode ser muito ineficiente em um ambiente distribuído.
Verbosidade, já que o tamanho do código cresce linearmente conforme o número de colunas para unpivot.
SELECT name, subject, result
FROM (
    SELECT name, 'chinese' AS subject, chinese AS result FROM columntorow
    UNION ALL
    SELECT name, 'mathematics' AS subject, mathematics AS result FROM columntorow
    UNION ALL
    SELECT name, 'physics' AS subject, physics AS result FROM columntorow
) unpivoted_data
ORDER BY name;
Resultado:
+--------+-------------+------------+ | name | subject | result | +--------+-------------+------------+ | Bob | chinese | 74 | | Bob | mathematics | 83 | | Bob | physics | 93 | | Alice | chinese | 74 | | Alice | mathematics | 84 | | Alice | physics | 94 | +--------+-------------+------------+ -
Método 2: Funções integradas (específicas do MaxCompute) Este método utiliza CONCAT para criar uma string delimitada a partir das colunas de matérias. As funções TRANS_ARRAY e SPLIT_PART então explodem essa string em várias linhas e analisam a matéria e a nota correspondente.
Quando usar:
O desempenho é crítico em tabelas grandes, pois evita múltiplas varreduras na tabela.
Você tem familiaridade com a sintaxe e as funções específicas do MaxCompute.
Desvantagens:
Dependência da plataforma, visto que o código é altamente específico para MaxCompute e não é portável.
Sintaxe complexa. A combinação de
TRANS_ARRAYcom subconsultas aninhadas pode ser mais difícil de ler e depurar do queUNION ALL.
NotaEste método depende de
CONCAT. Se qualquer coluna de source (chinese,mathematicsouphysics) contiver NULL, toda a string concatenada se tornará NULL, causando perda silenciosa de dados naquela linha. Envolva as colunas comNVL()antes da concatenação — por exemplo,NVL(chinese, 0)— ou utilize o métodoUNION ALL. Para mais informações, consulte NVL.SELECT name, SPLIT_PART(subject,':',1) AS subject, SPLIT_PART(subject,':',2) AS result FROM ( SELECT TRANS_ARRAY(1,';',name,subject) AS (name,subject) FROM ( SELECT name, CONCAT('chinese',':',chinese,';','mathematics',':',mathematics,';','physics',':',physics) AS subject FROM columntorow ) );Resultado:
+--------+-------------+------------+
| name   | subject     | result     |
+--------+-------------+------------+
| Bob    | chinese     | 74         |
| Bob    | mathematics | 83         |
| Bob    | physics     | 93         |
| Alice  | chinese     | 74         |
| Alice  | mathematics | 84         |
| Alice  | physics     | 94         |
+--------+-------------+------------+
Próximos passos
O MaxCompute também fornece os operadores nativos PIVOT e UNPIVOT, que oferecem uma sintaxe mais concisa e frequentemente mais eficiente para essas transformações. Para mais informações, consulte PIVOT e UNPIVOT.