Este tópico aborda os conceitos básicos, o uso e as limitações do service Information Schema para MaxCompute.
O Information Schema do MaxCompute fornece metadados do projeto e histórico de uso. Ele estende o ANSI SQL-92 Information Schema com campos e visualizações específicas do service MaxCompute. Consulte as visualizações somente leitura no projeto público Information Schema para recuperar metadados e histórico de uso dos seus projetos.
Limitações
O Information Schema oferece uma visualização de metadados restrita ao projeto atual e não suporta acesso a metadados entre projetos. Para consultar e analisar metadados de vários projetos, recupere os metadados de cada projeto individualmente e consolide-os em seguida.
As tabelas de sistema de metadados fornecem uma visualização quase em tempo real. Caso suas aplicações exijam metadados altamente atualizados, utilize o SDK ou o CLI para recuperar diretamente os metadados de objetos específicos.
Metadados e histórico de jobs ficam armazenados no Information Schema. Para criar backups de snapshot ou reter o histórico de jobs por mais de 14 dias, faça backup periódico dos dados do Information Schema para um projeto.
Ativar o Information Schema
A partir de 1º de março de 2024, o MaxCompute deixou de instalar automaticamente o Information Schema no nível de projeto para novos projetos. Se precisar consultar metadados, consulte o Information Schema no nível de tenant para obter informações mais abrangentes. Para mais detalhes sobre como usar o Information Schema no nível de tenant, consulte Tenant-level Information Schema.
Para projetos MaxCompute existentes, um Project Owner ou um usuário RAM com a função Super_Administrator deve instalar o pacote de permissões do Information Schema para acessar os metadados do projeto. Para mais informações sobre como conceder uma função de gerenciamento a um usuário, consulte Grant a role to a user. Instale o pacote de uma das seguintes maneiras:
-
Faça login no MaxCompute client e execute o seguinte comando:
install package Information_Schema.systables; -
Faça login no DataWorks console e acesse a página Ad Hoc Query. Para mais informações, consulte Use an ad-hoc query to run SQL statements (optional). Execute o seguinte comando:
install package Information_Schema.systables;
A instalação do pacote concede ao projeto atual permissão para consultar seus próprios metadados usando o Information Schema. Esses dados ficam armazenados no projeto Information Schema e não há cobrança pelo armazenamento.
Execute o comando abaixo para listar as visualizações fornecidas pelo Information Schema.
odps@myproject1> describe package Information_Schema.systables;A figura a seguir mostra o resultado da consulta.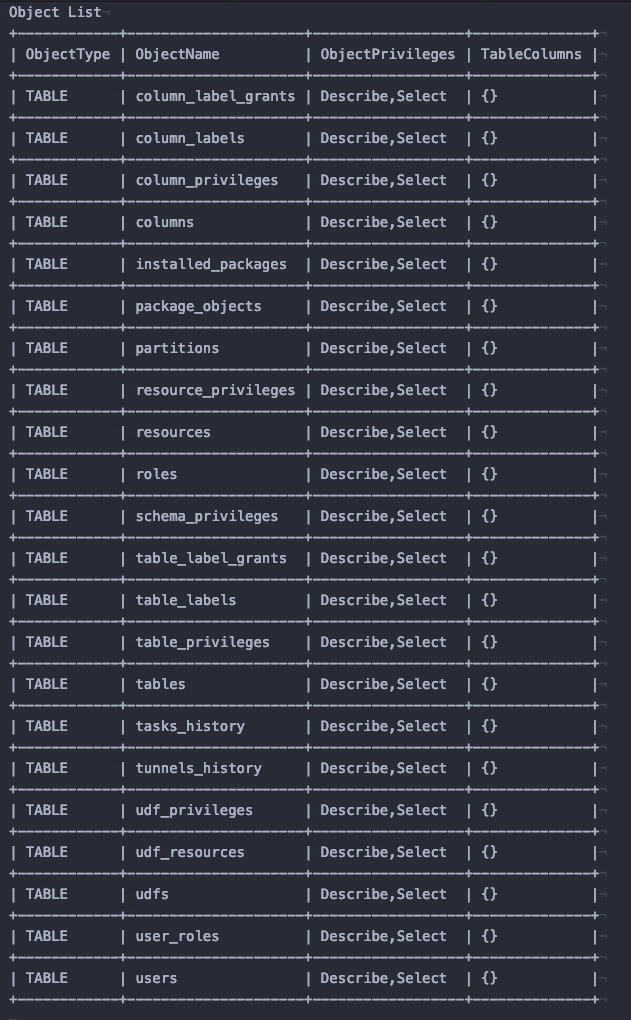
Consultar visualizações de metadados
Para consultar uma visualização de metadados, adicione o prefixo do Information Schema do projeto ao nome da visualização, por exemplo, Information_Schema.view_name.
Por exemplo, para consultar metadados de todas as tabelas no projeto myproject1, execute o comando a seguir.
odps@myproject1>select * from Information_Schema.tables;O Information Schema também inclui visualizações de histórico de jobs para consultar o histórico de execução no projeto atual. Adicione uma partição de data para filtrar os resultados.
odps@myproject1>select * from Information_Schema.tasks_history where ds='yyyymmdd' limit 100;Autorização
As visualizações no Information Schema contêm todos os dados do usuário no nível do projeto. Por padrão, o proprietário do projeto pode visualizar esses dados. Se outros usuários ou funções precisarem de acesso, será necessária autorização. Para mais informações, consulte Access resources across projects by using a Package.
A sintaxe para conceder autorização é a seguinte:
grant <actions> on package Information_Schema.systables to user <user_name>;
grant <actions> on package Information_Schema.systables to role <role_name>;actions: A permissão a ser concedida. O valor deve ser read.
-
user_name: Uma conta Alibaba Cloud ou um usuário RAM no projeto.
Execute o comando
list users;no MaxCompute client para listar as contas de usuário. -
role_name: Uma função no projeto.
Execute o comando
list roles;no MaxCompute client para listar os nomes das funções.
Exemplo:
grant read on package Information_Schema.systables to user RAM$Bob@aliyun.com:user01;Visualizações de metadados
Utilize as visualizações de metadados do Information_Schema para consultar metadados.
Use as visualizações de informações do Information_Schema para analisar métricas como consumo de recursos, duração da execução e volume de dados processados, visando otimizar jobs ou planejar a capacidade de recursos.
Cada visualização possui um período de retenção específico, após o qual seus dados se tornam inacessíveis. Para reter dados históricos por um período maior, exporte-os periodicamente de Information_Schema para uma tabela local.
As seguintes regras de faturamento se aplicam:
Em projetos que utilizam recursos de computação com pagamento conforme o uso, as consultas nas visualizações do Information Schema geram cobranças baseadas na quantidade de dados verificados. Para melhorar o desempenho da consulta, essas visualizações são otimizadas com
range clustered tablespara reduzir o volume de dados verificados. Ao consultar as visualizações TASKS_HISTORY e TUNNELS_HISTORY, minimize os dados verificados e reduza custos consultando os dados do dia anterior após as 06:00:00 e evitando consultar os dados do dia atual.Nos projetos que usam recursos de computação por assinatura, as consultas nas visualizações do Information Schema consomem as CUs adquiridas.
As visualizações do Information Schema não incorrem em taxas de armazenamento.
Ao exportar dados, selecione explicitamente os nomes das colunas da visualização. Evite usar insert into select * from information_schema.*** para evitar falhas de backup quando novas colunas forem adicionadas.
Esta tabela lista as visualizações de metadados.
Categoria | Visualização | Atualidade e retenção | Latência |
Informações de metadados | Visualização quase em tempo real | Os dados nestas visualizações têm um atraso de aproximadamente 3 horas em relação aos dados online. | |
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Visualização quase em tempo real | |||
Informações de uso | Um snapshot em tempo real de jobs em execução. | Esta visualização tem latência de segundos. Como recurso Preview, não é coberta por SLA e está sendo liberada gradualmente. | |
Uma tabela particionada quase em tempo real que retém detalhes dos últimos 14 dias. | Os dados nestas visualizações têm uma latência de aproximadamente 3 horas. | ||
Uma tabela particionada quase em tempo real que retém detalhes dos últimos 14 dias. |
Tables
Fornece detalhes sobre as tabelas em um projeto.
Coluna | Tipo de dado | Descrição |
table_catalog | STRING | O valor é fixo em |
table_schema | STRING | Nome do projeto. |
table_name | STRING | Nome da tabela. |
table_type | STRING | Tipo da tabela. Valores válidos:
|
is_partitioned | BOOLEAN | Indica se a tabela é particionada. |
owner_id | STRING | ID do proprietário da tabela. |
owner_name | STRING | Opcional. Nome da conta Alibaba Cloud do proprietário da tabela. |
create_time | DATETIME | Horário de criação da tabela. |
last_modified_time | DATETIME | Horário da última modificação dos dados da tabela. |
data_length | BIGINT | Para tabelas não particionadas, representa o tamanho dos dados da tabela. Para tabelas particionadas, este valor é NULL porque o MaxCompute não calcula o tamanho total da tabela. Encontre o tamanho dos dados de cada partição na visualização PARTITIONS. Unidade: byte. |
table_comment | STRING | Comentário da tabela. |
life_cycle | BIGINT | Opcional. Ciclo de vida da tabela. |
is_archived | BOOLEAN | Reservado para uso futuro. |
table_exstore_type | STRING | Reservado para uso futuro. |
cluster_type | STRING | Tipo de clustering da tabela MaxCompute. Valores válidos: HASH ou RANGE. |
number_buckets | BIGINT | Opcional. Número de buckets em uma tabela clusterizada. Um valor igual a 0 significa que o MaxCompute determina o número de buckets em tempo de execução. |
view_original_text | STRING | Para tabelas do tipo VIRTUAL_VIEW, esta coluna contém a instrução SQL que define a visualização. |
O console MaxCompute não suporta a ordenação de tabelas por tamanho. Para consultar e ordenar tabelas por tamanho ou gerenciar espaço de armazenamento, execute consultas SQL no Information Schema. Antes de executar as consultas, ative o suporte a schema com o seguinte comando:
SET odps.namespace.schema=true;-
Consulte o tamanho das tabelas não particionadas e ordene-as em ordem decrescente:
SELECT * FROM SYSTEM_CATALOG.INFORMATION_SCHEMA.Tables ORDER by data_length DESC; -
Consulte o tamanho das partições em tabelas particionadas e ordene-as em ordem decrescente:
SELECT * FROM SYSTEM_CATALOG.INFORMATION_SCHEMA.PARTITIONS ORDER by data_length DESC;
Utilize os resultados da consulta para identificar tabelas ou partições grandes e exclua dados desnecessários para liberar espaço de armazenamento.
Um erro de permissão ao executar essas instruções SQL indica que o Information Schema não está instalado no seu projeto ou que você não possui as permissões necessárias no nível do projeto. Para resolver isso, consulte a seção Enable the Information Schema service para obter instruções sobre instalação e concessão de permissões. Para obter metadados mais abrangentes ou evitar tais problemas de permissão, configure também o tenant-level Information Schema.
Partitions
Descreve as partições de tabela em um projeto.
|
Parâmetro |
Tipo |
Valor |
|
table_catalog |
STRING |
O valor é sempre |
|
table_schema |
STRING |
Nome do projeto. |
|
table_name |
STRING |
Nome da tabela. |
|
partition_name |
STRING |
Nome da partição. Por exemplo, |
|
create_time |
DATETIME |
Horário de criação da partição. |
|
last_modified_time |
DATETIME |
Horário da última modificação da partição. |
|
data_length |
BIGINT |
Tamanho dos dados da partição, em bytes. |
|
is_archived |
BOOLEAN |
Reservado para uso futuro. |
|
is_exstore |
BOOLEAN |
Reservado para uso futuro. |
|
cluster_type |
STRING |
Opcional. Tipo de bucketing de uma tabela MaxCompute. Valores válidos: HASH e RANGE. |
|
number_buckets |
BIGINT |
Opcional. Número de buckets em uma tabela clusterizada. Se este valor for 0, o número de buckets é determinado dinamicamente quando um job é executado. |
Columns
Descreve as colunas das tabelas em um espaço de projeto.
|
Parâmetro |
Tipo |
Valor |
|
table_catalog |
STRING |
Valor fixo de |
|
table_schema |
STRING |
Nome do projeto. |
|
table_name |
STRING |
Nome da tabela. |
|
column_name |
STRING |
Nome da coluna. |
|
ordinal_position |
BIGINT |
Posição ordinal da coluna. |
|
column_default |
STRING |
Valor padrão da coluna. |
|
is_nullable |
BOOLEAN |
Especifica se a coluna pode conter valores NULL; o valor é sempre YES. |
|
data_type |
STRING |
Tipo de dado da coluna. |
|
column_comment |
STRING |
Comentário da coluna. |
|
is_partition_key |
BOOLEAN |
Especifica se a coluna é uma chave de partição. |
UDFs
Informações sobre as UDFs no projeto.
|
Parâmetro |
Tipo |
Valor |
|
udf_catalog |
STRING |
O valor fixo é |
|
udf_schema |
STRING |
Nome do projeto. |
|
udf_name |
STRING |
Nome da UDF. |
|
owner_id |
STRING |
ID do proprietário da UDF. |
|
owner_name |
STRING |
Opcional. Nome da conta cloud do proprietário da UDF. |
|
create_time |
DATETIME |
Horário de criação da UDF. |
|
last_modified_time |
DATETIME |
Horário da última modificação da UDF. |
Resources
Descreve os atributos dos recursos no projeto.
|
Campo |
Tipo |
Valor |
|
resource_catalog |
STRING |
Sempre |
|
resource_schema |
STRING |
Nome do projeto. |
|
resource_name |
STRING |
Nome do recurso. |
|
resource_type |
STRING |
Valores possíveis: Py ou Jar. |
|
owner_id |
STRING |
ID do proprietário do recurso. |
|
owner_name |
STRING |
Opcional. Nome da conta cloud do proprietário do recurso. |
|
create_time |
DATETIME |
Horário de criação do recurso. |
|
last_modified_time |
DATETIME |
Horário da última modificação do recurso. |
|
size |
BIGINT |
Espaço de armazenamento usado pelo recurso. |
|
comment |
STRING |
Comentário sobre o recurso. |
|
is_temp_resource |
BOOLEAN |
Indica se o recurso é temporário. |
UDF_RESOURCES
Lista as dependências de recursos para UDFs em um projeto.
|
Parâmetro |
Tipo |
Valor |
|
udf_catalog |
STRING |
Sempre |
|
udf_schema |
STRING |
Nome do projeto. |
|
udf_name |
STRING |
Nome da UDF. |
|
resource_schema |
STRING |
Nome do projeto que contém o recurso. |
|
resource_name |
STRING |
Nome do recurso. |
Users
Lista de usuários no espaço de projeto.
|
Parâmetro |
Tipo |
Valor |
|
user_catalog |
STRING |
O valor pode ser Alibaba Cloud ou RAM. |
|
user_schema |
STRING |
Nome do projeto. |
|
user_name |
STRING |
Opcional. Nome de usuário. |
|
user_id |
STRING |
ID do usuário. |
|
user_label |
STRING |
Rótulo do usuário. |
Roles
Os campos a seguir definem uma função no projeto.
|
Parâmetro |
Tipo |
Valor |
|
role_catalog |
STRING |
Sempre |
|
role_schema |
STRING |
Nome do projeto. |
|
role_name |
STRING |
Nome da função. |
|
role_label |
STRING |
Rótulo da função. |
|
comment |
STRING |
Comentário da função. |
USER_ROLES
Descreve as funções atribuídas aos usuários no projeto.
|
Parâmetro |
Tipo |
Valor |
|
user_role_catalog |
STRING |
O valor fixo é |
|
user_role_schema |
STRING |
Nome do projeto. |
|
role_name |
STRING |
Nome da função. |
|
user_name |
STRING |
Nome do usuário. |
|
user_id |
STRING |
ID do usuário. |
PACKAGE_OBJECTS
Descreve os objetos em um Package dentro de um projeto.
|
Parâmetro |
Tipo |
Valor |
|
package_catalog |
STRING |
O valor é fixo em |
|
package_schema |
STRING |
Nome do projeto. |
|
package_name |
STRING |
Nome do Package. |
|
object_type |
STRING |
Tipo do objeto dentro do Package. |
|
object_name |
STRING |
Nome do objeto dentro do Package. |
|
column_name |
STRING |
Nome da coluna. Este campo se aplica apenas se o objeto for uma tabela. |
|
allowed_privileges |
VECTOR<STRING> |
Privilégios permitidos para o objeto. |
|
allowed_label |
STRING |
Rótulo de segurança permitido. |
INSTALLED_PACKAGES
Lista os pacotes instalados no projeto.
|
Campo |
Tipo |
Valor |
|
installed_package_catalog |
STRING |
O valor é sempre |
|
installed_package_schema |
STRING |
Nome do projeto onde o pacote está instalado. |
|
package_project |
STRING |
Nome do projeto onde o pacote foi criado. |
|
package_name |
STRING |
Nome do pacote. |
|
installed_time |
DATETIME |
Horário de instalação (campo reservado). |
|
allowed_label |
STRING |
Rótulo para compartilhamento. |
SCHEMA_PRIVILEGES
Lista os privilégios em schemas de um projeto.
|
Parâmetro |
Tipo |
Valor |
|
user_catalog |
STRING |
Valor fixo de |
|
user_schema |
STRING |
Nome do projeto. |
|
grantee |
STRING |
Nome do usuário. |
|
user_id |
STRING |
ID da conta. |
|
grantor |
STRING |
Conta do concedente. Atualmente, este valor é NULL. |
|
privilege_type |
STRING |
Tipo de privilégio. |
TABLE_PRIVILEGES
Descreve os privilégios em tabelas de um projeto.
|
Parâmetro |
Tipo |
Valor |
|
table_catalog |
STRING |
Valor fixo de |
|
table_schema |
STRING |
Nome do projeto que contém a tabela. |
|
table_name |
STRING |
Nome da tabela. |
|
grantee |
STRING |
Nome do usuário. |
|
user_id |
STRING |
ID da conta. |
|
grantor |
STRING |
Concedente. O valor atual é NULL. |
|
privilege_type |
STRING |
Tipo de privilégio. |
|
user_schema |
STRING |
Nome do projeto do usuário. |
COLUMN_PRIVILEGES
Lista privilégios no nível de coluna para tabelas em um projeto.
|
Parâmetro |
Tipo |
Valor |
|
table_catalog |
STRING |
Sempre |
|
table_schema |
STRING |
Nome do projeto que contém a tabela. |
|
table_name |
STRING |
Nome da tabela. |
|
column_name |
STRING |
Nome da coluna. |
|
grantee |
STRING |
Nome do usuário. |
|
user_id |
STRING |
ID da conta. |
|
grantor |
STRING |
Usuário que concedeu o privilégio. Este campo é opcional e atualmente é NULL. |
|
privilege_type |
STRING |
Tipo de privilégio. |
|
user_schema |
STRING |
Projeto ao qual o usuário pertence. |
UDF_PRIVILEGES
Fornece informações sobre os privilégios em UDFs de um projeto.
|
Parâmetro |
Tipo |
Valor |
|
udf_catalog |
STRING |
Valor fixo |
|
udf_schema |
STRING |
Nome do projeto. |
|
udf_name |
STRING |
Nome da UDF. |
|
user_schema |
STRING |
Nome do projeto do usuário. |
|
grantee |
STRING |
Nome de usuário. |
|
user_id |
STRING |
ID da conta. |
|
grantor |
STRING |
Concedente. O valor atualmente é NULL. |
|
privilege_type |
STRING |
Tipo de privilégio. |
Privilégios de recursos
Lista os privilégios para recursos no projeto.
|
Parâmetro |
Tipo |
Valor |
|
resource_catalog |
STRING |
O valor é sempre |
|
resource_schema |
STRING |
Nome do projeto. |
|
resource_name |
STRING |
Nome do recurso. |
|
user_schema |
STRING |
Projeto que contém o usuário. |
|
grantee |
STRING |
Nome do usuário. |
|
user_id |
STRING |
ID da conta. |
|
grantor |
STRING |
Conta do concedente. Seu valor atualmente é NULL. |
|
privilege_type |
STRING |
Tipo de privilégio. |
Rótulos de tabela
Lista os rótulos para tabelas no projeto.
|
Parâmetro |
Tipo |
Valor |
|
table_catalog |
STRING |
Sempre |
|
table_schema |
STRING |
Nome do projeto. |
|
table_name |
STRING |
Nome da tabela. |
|
label_type |
STRING |
Sempre NULL. |
|
label_level |
STRING |
Nível do rótulo. |
COLUMN_LABELS
Fornece informações sobre rótulos de coluna para tabelas em um projeto.
|
Coluna |
Tipo |
Valor |
|
table_catalog |
STRING |
O valor é sempre |
|
table_schema |
STRING |
Nome do projeto. |
|
table_name |
STRING |
Nome da tabela. |
|
column_name |
STRING |
Nome da coluna. |
|
label_type |
STRING |
Tipo de rótulo. Este valor é sempre NULL. |
|
label_level |
STRING |
Nível do rótulo. |
TABLE_LABEL_GRANTS
A visualização TABLE_LABEL_GRANTS descreve as autorizações de rótulo em tabelas do projeto.
|
Parâmetro |
Tipo |
Valor |
|
table_label_grant_catalog |
STRING |
Sempre |
|
table_label_grant_schema |
STRING |
Nome do projeto ao qual o usuário pertence. |
|
user |
STRING |
Nome do usuário. |
|
user_id |
STRING |
ID do usuário. |
|
table_schema |
STRING |
Nome do projeto que contém a tabela. |
|
table_name |
STRING |
Nome da tabela. |
|
grantor |
STRING |
Conta do concedente, que atualmente é NULL. |
|
label_level |
STRING |
Nível de rótulo concedido. |
|
expired |
DATETIME |
Horário de expiração. |
COLUMN_LABEL_GRANTS
Lista concessões de rótulo para colunas de tabela em um projeto.
|
Parâmetro |
Tipo |
Valor |
|
column_label_grant_catalog |
STRING |
O valor é sempre |
|
column_label_grant_schema |
STRING |
Nome do projeto do usuário. |
|
user |
STRING |
Nome do usuário. |
|
user_id |
STRING |
ID do usuário. |
|
table_schema |
STRING |
Nome do projeto da tabela. |
|
table_name |
STRING |
Nome da tabela. |
|
column_name |
STRING |
Nome da coluna. |
|
grantor |
STRING |
Conta do concedente. Este valor atualmente é sempre NULL. |
|
label_level |
STRING |
Nível de rótulo concedido. |
|
expired |
DATETIME |
Horário de expiração. |
Tasks
Esta visualização fornece snapshots em tempo real de jobs para monitoramento ao vivo.
A visualização TASKS está atualmente em private preview. Os campos e seu conteúdo estão sujeitos a alterações. Esta visualização não é coberta por um Service Level Agreement (SLA). Use com cautela. Para atualizações sobre seu status de lançamento, consulte o Announcements.
Campo | Tipo | Descrição |
project_name | STRING | Nome do projeto. |
task_name | STRING | Nome do job. |
task_type | STRING | Tipo do job. Valores válidos:
|
inst_id | STRING | ID da instância. |
status | STRING | Status do job no momento em que o snapshot foi tirado. Valores válidos são |
owner_id | STRING | ID da conta cloud que enviou o job. |
owner_name | STRING | Nome da conta cloud que enviou o job. |
start_time | DATETIME | Horário de início do job. |
priority | BIGINT | Prioridade do job. Aplica-se apenas a jobs que usam recursos por assinatura. |
signature | STRING | Assinatura do job. |
queue_name | STRING | Nome da fila de computação. |
cpu_usage | BIGINT | Uso atual de CPU. O valor é |
mem_usage | BIGINT | Uso atual de memória, em MB. |
gpu_usage | BIGINT | Uso atual de GPU. O valor é |
total_cpu_usage | BIGINT | Uso acumulado de CPU. O valor é |
total_mem_usage | BIGINT | Uso acumulado de memória. O valor é |
total_gpu_usage | BIGINT | Uso acumulado de GPU. O valor é |
cpu_min_ratio | BIGINT | Proporção do uso atual de CPU do job em relação ao nível de recursos garantidos da fila de computação. Aplica-se apenas a jobs que usam recursos por assinatura. |
mem_min_ratio | BIGINT | Proporção do uso atual de memória do job em relação ao nível de recursos garantidos da fila de computação. Aplica-se apenas a jobs que usam recursos por assinatura. |
gpu_min_ratio | BIGINT | Proporção do uso atual de GPU do job em relação ao nível de recursos garantidos da fila de computação. Aplica-se apenas a jobs que usam recursos por assinatura. |
cpu_max_ratio | BIGINT | Proporção do uso atual de CPU do job em relação ao nível máximo de recursos elásticos da fila de computação. Aplica-se apenas a jobs que usam recursos por assinatura. |
mem_max_ratio | BIGINT | Proporção do uso atual de memória do job em relação ao nível máximo de recursos elásticos da fila de computação. Aplica-se apenas a jobs que usam recursos por assinatura. |
gpu_max_ratio | BIGINT | Proporção do uso atual de GPU do job em relação ao nível máximo de recursos elásticos da fila de computação. Aplica-se apenas a jobs que usam recursos por assinatura. |
settings | STRING | Configurações personalizadas de agendamento de serviços de nível superior, como DataWorks. |
additional_info | STRING | Informações adicionais. Este é um campo reservado. |
TASKS_HISTORY
Contém um histórico de 14 dias de jobs concluídos em um projeto MaxCompute.
Campo | Tipo | Valor |
task_catalog | STRING | Valor fixo de |
task_schema | STRING | Nome do projeto. |
task_name | STRING | Nome do job. |
task_type | STRING | Tipo do job. Valores válidos:
|
inst_id | STRING | ID da instância. |
status | STRING | Status do job no momento da coleta de dados (não em tempo real). Valores possíveis:
|
owner_id | STRING | ID da conta. |
owner_name | STRING | Nome da conta cloud. |
result | STRING | Preenchido com a mensagem de erro apenas quando um job SQL falha. |
start_time | DATETIME | Horário de início do job. |
end_time | DATETIME | Horário de término do job. Este valor é NULL se o job ainda estava em execução durante a coleta de dados. |
input_records | BIGINT | Número de registros lidos pelo job. |
output_records | BIGINT | Número de registros gravados pelo job. |
input_bytes | BIGINT | Quantidade de dados verificados. Este valor corresponde ao mostrado no Logview. |
output_bytes | BIGINT | Quantidade de dados gravados. |
input_tables | STRING | Tabelas de entrada do job, no formato [projeto.tabela1, projeto.tabela2]. Esta informação pode estar indisponível para certos tipos de job, como SQLCost. |
output_tables | STRING | Tabelas de saída do job, no formato [projeto.tabela1, projeto.tabela2]. |
operation_text | STRING | O source_xml da instrução de consulta. Este campo é NULL se seu tamanho exceder 256 KB. |
signature | STRING | Opcional. Assinatura do job. |
complexity | DOUBLE | Opcional. Complexidade do job. Este campo está disponível apenas para jobs SQL. |
cost_cpu | DOUBLE | Custo de CPU do job, onde 100 representa 1 core-segundo. Por exemplo, se um job usa 10 cores por 5 segundos, o cost_cpu é 10 × 100 × 5 = 5000. |
cost_mem | DOUBLE | Custo de memória do job, em MB-segundos. |
settings | STRING | Configurações fornecidas pelo usuário ou passadas pelo agendador no formato JSON. Pode incluir campos como: USERAGENT, BIZID, SKYNET_ID e SKYNET_NODENAME. |
ds | STRING | Data da coleta de dados. Por exemplo, 20190101. |
TUNNELS_HISTORY
Esta visualização contém dados históricos de operações de upload e download em massa que utilizam Tunnel. Os dados são retidos por 14 dias.
Parâmetro | Tipo | Valor |
tunnel_catalog | STRING | Fixo em |
tunnel_schema | STRING | Nome do projeto. |
session_id | STRING | ID da sessão. O formato é |
operate_type | STRING | Tipo de operação. Valores válidos:
|
tunnel_type | STRING | Tipo de tunnel. Valores válidos são |
request_id | STRING | ID da solicitação. |
object_type | STRING | Tipo de objeto. Valores válidos são |
object_name | STRING | Nome da tabela ou ID da instância. |
partition_spec | STRING | Especificação da partição. Por exemplo, |
data_size | BIGINT | Tamanho dos dados em bytes. |
block_id | BIGINT | ID do bloco para um upload via Tunnel. Este campo é válido apenas quando o tipo de operação é |
offset | BIGINT | Offset baseado em zero indicando o registro inicial para um download. |
length | BIGINT | Número de registros enviados ou baixados (equivalente à contagem de registros). Para downloads, o usuário especifica este valor. |
owner_id | STRING | ID da conta Alibaba Cloud. |
owner_name | STRING | Nome da conta Alibaba Cloud. |
start_time | DATETIME | Horário de início da solicitação. |
end_time | DATETIME | Horário de término da solicitação. |
client_ip | STRING | Endereço IP do cliente que iniciou a solicitação Tunnel. |
user_agent | STRING | String User-Agent do cliente que iniciou a solicitação Tunnel. Por exemplo, esta string pode incluir a versão do Java e o sistema operacional. |
columns | STRING | Colunas especificadas para um download via Tunnel. |
ds | STRING | Data da coleta de dados. Por exemplo, |
FAQ
Contagem de acessos em TABLE_ACCESS_INFO
Não. A contagem de acessos em TABLE_ACCESS_INFO é a contagem total de operações de acesso de um job, como leituras e gravações. Essa contagem não distingue entre tipos específicos de operação, portanto, não é possível visualizar a contagem de consultas separadamente.