Quando vários jobs competem pelos mesmos recursos de computação, o MaxCompute usa a prioridade para definir quais recebem recursos primeiro. Jobs com prioridade mais alta obtêm recursos antes dos de menor prioridade e podem preemptar recursos de jobs em execução. Use a prioridade de jobs para proteger pipelines críticos — por exemplo, um job ETL que deve terminar antes das 06:00 — quando o cluster estiver ocupado com cargas de trabalho menos urgentes.
Como funciona
Cada job do MaxCompute tem um valor de prioridade de 0 a 9. Números menores indicam maior prioridade: 0 é a mais alta e 9 é a mais baixa.
Com recursos de computação limitados, o MaxCompute agenda os jobs por ordem de prioridade. Se um job de alta prioridade chegar enquanto os recursos estiverem totalmente ocupados por jobs de baixa prioridade, ele preemptará esses jobs para obter os recursos necessários.
Comportamento padrão com o recurso de prioridade desativado:
Todos os jobs: prioridade 9 (mais baixa)
Jobs de algoritmo PAI: prioridade 1 (quase a mais alta)
Uma prioridade NULL nos resultados da consulta geralmente indica uma tarefa DDL; ignore-a.
Pré-requisitos
Antes de ativar a prioridade de jobs, verifique se você tem:
Função de proprietário do projeto ou
Super_Administratorno projeto MaxCompute(Para ativação no nível de cota) Modelo de cota e plano de cota configurados. Consulte Configure quotas
Ativar a prioridade de jobs
Antes de ativar a prioridade de jobs, audite as prioridades existentes pelo Information Schema e redefina quaisquer valores diferentes de 9 para 9. Ignorar esta etapa pode fazer com que jobs com configurações de alta prioridade furem a fila inesperadamente.
Verificar prioridades de jobs existentes
Execute a seguinte consulta no Information Schema para visualizar a distribuição de prioridades em todos os jobs de uma partição de data:
SELECT  get_json_object(
            REPLACE(settings, '.', '_'),
            '$.odps_instance_priority'
        ) AS priority,
        task_type,
        COUNT(1) AS cnt
FROM    information_schema.tasks_history
WHERE   ds = '${bizdate}'  -- Replace with the date partition, for example 20200517.
GROUP BY get_json_object(
             REPLACE(settings, '.', '_'),
             '$.odps_instance_priority'
         ),
         task_type
ORDER BY cnt DESC
LIMIT   100;
Exemplo de saída:
+----------+-----------+-----+
| priority | task_type | cnt |
+----------+-----------+-----+
| 9        | SQL       | 4   |
| NULL     | SQL       | 1   |
| 2        | SQL       | 1   |
+----------+-----------+-----+
Jobs com prioridade NULL são tarefas DDL; ignore-os. Para jobs com valores de prioridade diferentes de 9 (como 2 neste exemplo), identifique os proprietários e redefina as prioridades antes de ativar o recurso.
Para encontrar detalhes de jobs com um valor de prioridade específico:
SELECT  inst_id,
        owner_name,
        task_name,
        task_type,
        settings
FROM    information_schema.tasks_history
WHERE   ds = '${bizdate}'  -- Replace with the date partition, for example 20200517.
AND     get_json_object(
            REPLACE(settings, '.', '_'),
            '$.odps_instance_priority'
        ) = '${priority}'  -- Replace with the priority value to filter, for example 2.
LIMIT   100;
Campos principais na saída:
|
Campo |
Descrição |
|
|
ID do nó de agendamento do DataWorks. Ausente se o job não foi enviado pelo DataWorks. |
|
|
Presente se o job for periódico. |
|
|
Proprietário do job. Use este campo para rastrear jobs fora do DataWorks. |
Após identificar jobs com prioridades diferentes de 9:
Jobs do DataWorks: Verifique se a linha de base associada é adequada. Caso contrário, exclua-a. Consulte Baseline management.
Jobs fora do DataWorks: Entre em contato com o proprietário usando
owner_nameeuser_agent. Remova a configuração de prioridade do código do job para restaurar a prioridade padrão 9.
Ativar a prioridade no nível do projeto
Somente o proprietário do projeto ou um usuário com a função Super_Administrator pode ativar a prioridade. Execute o seguinte comando no cliente MaxCompute:
setproject odps.instance.priority.enable=true;A prioridade entra em vigor imediatamente para todos os jobs no projeto.
Ativar a prioridade no nível da cota
Ativar a prioridade no nível da cota aplica o agendamento por prioridade a todos os jobs executados sob essa cota.
Faça login no console do MaxCompute e selecione uma região.console do MaxCompute
No painel de navegação, escolha Manage Configurations > Quotas.
Localize a cota desejada e clique em Quota Configuration na coluna Actions.
Na aba Basic Configurations, clique em Edit Basic Configurations.
-
Selecione a opção Enable Priority para a cota de nível 2 desejada.
Se o Type da cota de nível 2 for Interactive , a opção Enable Priority estará indisponível por padrão.
Clique em OK.
Definir a prioridade de jobs
Escolha o método adequado ao seu fluxo de trabalho:
|
Método |
Mais indicado para |
|
Cliente MaxCompute (comando SET) |
Consultas ad hoc |
|
Cliente MaxCompute (flag CLI) |
Consultas ad hoc via script |
|
Java SDK |
Aplicações com lógica de prioridade personalizada |
|
Gerenciamento de linha de base do DataWorks |
Pipelines periódicos com requisitos de SLA |
|
Configurações de nó do DataWorks |
Consultas ad hoc no DataWorks |
Método 1: Cliente MaxCompute — comando SET
Execute este comando antes da instrução SQL no cliente MaxCompute:
SET odps.instance.priority = <value>;
-- <value> is an integer from 0 (highest priority) to 9 (lowest priority).
Método 2: Cliente MaxCompute — flag CLI
Passe a prioridade como flag ao enviar uma instrução SQL:
bin/odpscmd --config=<config-file> --project=<project-name> --instance-priority=<value> -e "<sql>"Método 3: Java SDK
Use o método odps.instances().create(task, priority) para definir a prioridade ao enviar um job:
import com.aliyun.odps.Instance;
import com.aliyun.odps.LogView;
import com.aliyun.odps.Odps;
import com.aliyun.odps.OdpsException;
import com.aliyun.odps.account.Account;
import com.aliyun.odps.account.AliyunAccount;
import com.aliyun.odps.task.SQLTask;

public class OdpsPriorityDemo {
    public static void main(String[] args) throws OdpsException {
        // Load credentials from environment variables.
        // Never hardcode AccessKey credentials in your code.
        Account account = new AliyunAccount(
            System.getenv("ALIBABA_CLOUD_ACCESS_KEY_ID"),
            System.getenv("ALIBABA_CLOUD_ACCESS_KEY_SECRET")
        );

        Odps odps = new Odps(account);
        odps.setEndpoint("http://service.odps.aliyun.com/api");
        odps.setDefaultProject("<your-project-name>");

        SQLTask task = new SQLTask();
        task.setName("adhoc_sql_task_1");
        task.setQuery("select count(*) from aa;");

        // Submit the job with priority 5.
        // Priority values: 0 (highest) to 9 (lowest).
        Instance instance = odps.instances().create(task, 5);

        // Print the LogView URL to monitor job status (optional).
        LogView logView = new LogView(odps);
        System.out.println(logView.generateLogView(instance, 24));

        // Wait for the job to finish (optional).
        instance.waitForSuccess();
    }
}
Para mais detalhes, consulte Java SDK overview.
Método 4: Gerenciamento de linha de base do DataWorks
Use este método quando precisar concluir um pipeline periódico e todos os seus jobs upstream dentro de uma janela de SLA. O gerenciamento de linha de base define prioridades para todos os jobs de um pipeline simultaneamente, sem necessidade de configurar cada job individualmente.
Prioridades de linha de base do DataWorks e equivalentes no MaxCompute:
|
Prioridade de linha de base do DataWorks |
Prioridade de job do MaxCompute |
Observações |
|
8 (mais alta no DataWorks) |
1 |
Maior prioridade prática |
|
7 |
2 |
|
|
5 |
4 |
|
|
3 |
6 |
|
|
1 (padrão) |
8 |
Padrão para fluxos de trabalho do DataWorks |
|
Sem linha de base (ad hoc) |
9 |
Padrão para consultas ad hoc do DataWorks |
Fórmula de conversão: Prioridade do MaxCompute = 9 − Prioridade da linha de base do DataWorks
Para mais detalhes, consulte Baseline management.
Consultas ad hoc do DataWorks não possuem linha de base por padrão; portanto, os jobs do MaxCompute enviados usam a prioridade mais baixa (9). Fluxos de trabalho do DataWorks têm prioridade de linha de base padrão 1, logo, seus jobs usam a prioridade 8.
Método 5: Configurações de nó do DataWorks
Defina a prioridade diretamente em um nó do DataWorks para consultas ad hoc:
set odps.instance.priority = <value>;
-- <value> is the priority value from 0 (highest) to 9 (lowest).
Visualizar a prioridade de jobs
Para verificar a prioridade de um job específico, abra-o no Logview 2.0, acesse a aba Resumo JSON e localize o parâmetro odps.instance.priority.
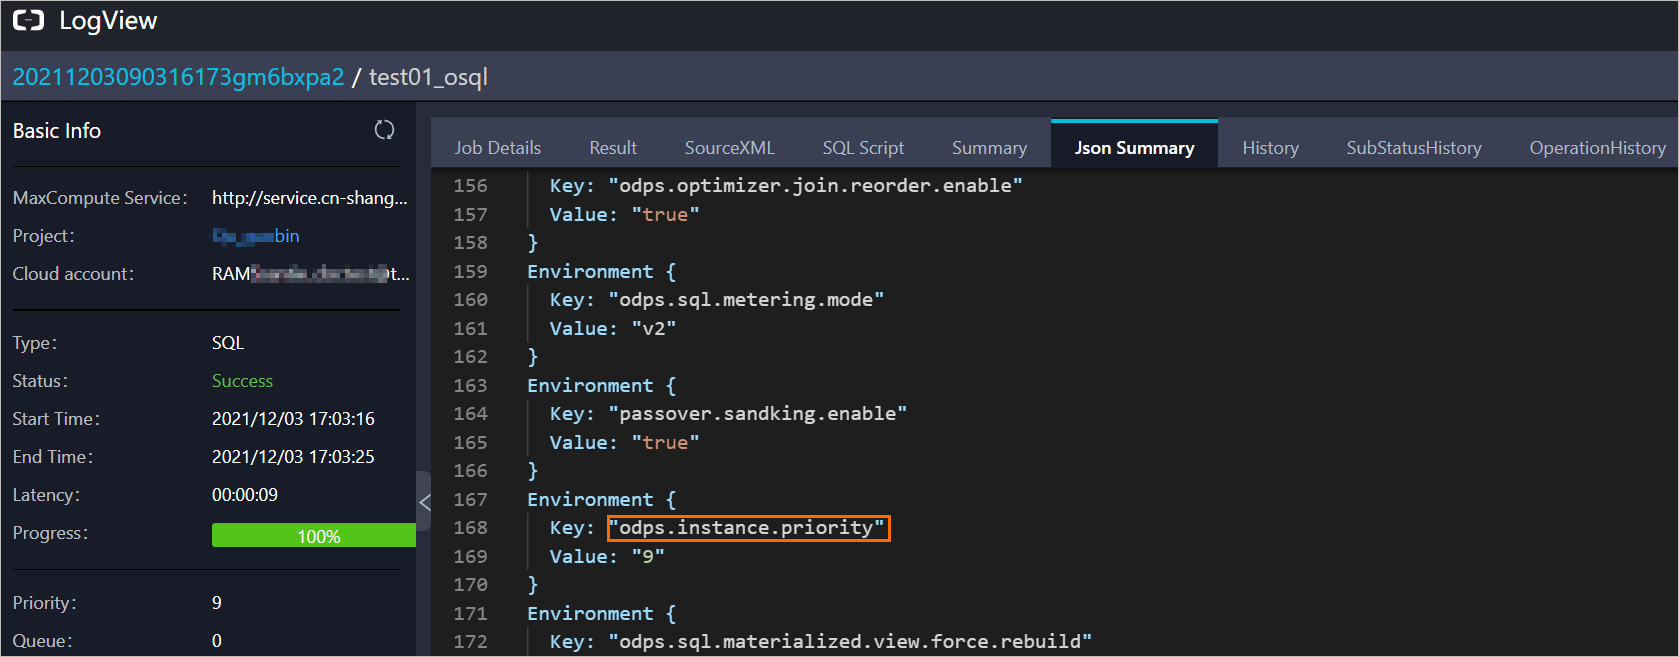
A prioridade exibida em XML na página do Logview não é precisa. Em projetos com prioridade desativada, o sistema converte qualquer valor diferente de 9 para 9 no XML, evitando saltos de fila não intencionais. Sempre use a aba Resumo JSON para obter informações precisas sobre a prioridade.