O MaxCompute permite usar as operações DELETE e UPDATE para excluir ou atualizar dados no nível de linha em tabelas Transactional e Delta Tables.
É possível executar os comandos deste tópico nas seguintes plataformas:
Pré-requisitos
Antes de executar operações DELETE ou UPDATE, é necessário ter as permissões Select e Update na tabela Transactional ou Delta Table de destino. Para mais informações sobre autorização, consulte MaxCompute permissions.
Introdução aos recursos
Assim como em bancos de dados tradicionais, os recursos DELETE e UPDATE no MaxCompute permitem excluir ou atualizar linhas específicas em uma tabela.
Ao usar o recurso DELETE ou UPDATE, o sistema gera automaticamente um arquivo Delta para cada operação de exclusão ou atualização. Esse arquivo não fica visível para os usuários e registra informações sobre os dados excluídos ou atualizados. A implementação funciona da seguinte forma:
-
DELETE: o arquivo Delta usa os campostxnid(BIGINT)erowid(BIGINT)para identificar o registro excluído no arquivo base de uma tabela Transactional e a respectiva operação de exclusão. Um arquivo base é o formato de armazenamento subjacente de uma tabela.Por exemplo, suponha que o arquivo base da tabela t1 seja f1 e seu conteúdo seja
a, b, c, a, b. Ao executar o comandoDELETE FROM t1 WHERE c1='a';, o sistema gera um arquivof1.deltaseparado. Se otxnidfort0, o conteúdo def1.deltaserá((0, t0), (3, t0)). Isso indica a exclusão da linha 0 e da linha 3 na transação t0. Se você executar outra operaçãoDELETE, o sistema gerará outro arquivo Delta, comof2.delta. Esse arquivo também referencia o arquivo base original f1. Ao consultar os dados, o sistema combina o arquivo base f1 com todos os arquivos Delta atuais para recuperar apenas os registros não excluídos. UPDATE: uma operaçãoUPDATEé implementada como uma operaçãoDELETEe uma operaçãoINSERT INTO.
Os recursos DELETE e UPDATE oferecem as seguintes vantagens:
-
Redução do volume de dados gravados
Anteriormente, o MaxCompute usava operações
INSERT INTOouINSERT OVERWRITEpara excluir ou atualizar dados de tabelas. Para mais informações, consulte INSERT INTO | INSERT OVERWRITE. Quando era necessário atualizar uma pequena quantidade de dados em uma tabela ou partição, o uso de uma operaçãoINSERTexigia primeiro a leitura de todos os dados da tabela, a atualização dos dados por meio de uma operaçãoSELECTe, por fim, a regravação de todos os dados na tabela com uma operaçãoINSERT. Esse método era ineficiente. Com o recursoDELETEouUPDATE, o sistema não precisa regravar todos os dados, o que reduz significativamente o volume de dados gravados.NotaNo método de faturamento pagamento conforme o uso, não há cobrança pelas operações de gravação de jobs
DELETE,UPDATEeINSERT OVERWRITE. No entanto, os jobsDELETEeUPDATEprecisam ler dados das partições para marcar registros para exclusão ou regravar os registros atualizados. Essas operações de leitura ainda são cobradas com base no modelo de faturamento pagamento conforme o uso para jobs SQL. Portanto, os jobsDELETEeUPDATEnão necessariamente reduzem custos em comparação com os jobsINSERT OVERWRITE, mesmo com um volume menor de dados gravados.No método de faturamento por assinatura,
DELETEeUPDATEconsomem menos recursos de gravação. Em comparação com oINSERT OVERWRITE, é possível executar mais jobs com os mesmos recursos.
-
Leitura direta do estado mais recente da tabela
Anteriormente, o MaxCompute usava tabelas zipper para atualizações de dados em lote. Esse método exigia a adição de colunas auxiliares, como
start_dateeend_date, à tabela para rastrear o ciclo de vida de um registro. Para consultar o estado mais recente da tabela, o sistema precisava filtrar uma grande quantidade de dados com base em carimbos de data/hora para encontrar o estado atual, o que era complexo. Com os recursosDELETEeUPDATE, é possível ler diretamente o estado mais recente da tabela. O sistema combina os arquivos base e os arquivos Delta para fornecer a visualização atual dos dados.
Executar operações DELETE e UPDATE várias vezes aumenta o armazenamento subjacente de uma tabela Transactional. Isso eleva os custos de armazenamento e degrada o desempenho de consultas subsequentes. Mescle (compacte) periodicamente os dados subjacentes. Para mais informações sobre operações de mesclagem, consulte Merge transactional table files.
Se vários jobs forem executados simultaneamente na mesma tabela de destino, poderão ocorrer conflitos de jobs. Para mais informações, consulte ACID semantics.
Casos de uso
Os recursos DELETE e UPDATE são adequados para exclusão ou atualização aleatória e de baixa frequência de uma pequena quantidade de dados em uma tabela ou partição. Por exemplo, é possível realizar periodicamente exclusões ou atualizações em lote em menos de 5% das linhas de uma tabela ou partição diariamente (T+1).
Os recursos DELETE e UPDATE não são adequados para atualizações, exclusões ou gravações em tempo real de alta frequência em uma tabela de destino.
Limitações
-
Os recursos
DELETEeUPDATEaplicam-se apenas a tabelas Transactional e Delta Tables e estão sujeitos aos seguintes limites:NotaPara mais informações sobre tabelas Transactional e Delta Tables, consulte Parameters for Transaction Table and Delta Table.
A sintaxe
UPDATEpara Delta Tables não oferece suporte à modificação de colunas de chave primária (PK).
Precauções
Considere os seguintes pontos ao usar operações DELETE ou UPDATE para excluir ou atualizar dados em uma tabela ou partição:
Para excluir ou atualizar uma pequena quantidade de dados em uma tabela, quando tanto a operação quanto as leituras subsequentes são pouco frequentes, use as operações
DELETEeUPDATE. Após realizar várias operações de exclusão ou atualização, mescle os arquivos base e os arquivos Delta da tabela para reduzir seu espaço de armazenamento. Para mais informações, consulte Merge transactional table files.-
Se a exclusão ou atualização abranger muitas linhas (mais de 5%) com pouca frequência, mas as operações de leitura subsequentes na tabela forem frequentes, use
INSERT OVERWRITEouINSERT INTO. Para mais informações, consulte INSERT INTO | INSERT OVERWRITE.Por exemplo, em um cenário de negócios com exclusão ou atualização de 10% dos dados 10 vezes ao dia, avalie se os custos e a degradação subsequente do desempenho de leitura das operações
DELETEeUPDATEsão menores do que os do uso deINSERT OVERWRITEouINSERT INTOpara cada operação. Compare a eficiência dos dois métodos no seu cenário específico para escolher a opção mais adequada. A exclusão de dados gera arquivos Delta, o que significa que a operação não reduz o armazenamento imediatamente. Para reduzir o armazenamento usando a operação
DELETE, é necessário mesclar os arquivos base e os arquivos Delta da tabela. Para mais informações, consulte Merge transactional table files.-
O MaxCompute executa jobs
DELETEeUPDATEcomo processos em lote. Cada instrução consome recursos e gera cobranças. Exclua ou atualize dados em lotes. Por exemplo, ao usar um script Python para gerar e enviar muitos jobs de atualização no nível de linha, em que cada instrução opera em apenas uma ou poucas linhas, cada instrução incorrerá em custos com base na quantidade de dados de entrada verificados pelo SQL. O custo acumulado de muitas dessas instruções aumenta significativamente as despesas e reduz a eficiência do sistema. Confira os exemplos de comandos a seguir.-
Método recomendado:
UPDATE table1 SET col1= (SELECT value1 FROM table2 WHERE table1.id = table2.id AND table1.region = table2.region); -
Método não recomendado:
UPDATE table1 SET col1=1 WHERE id='2021063001' AND region='beijing';
UPDATE table1 SET col1=2 WHERE id='2021063002' AND region='beijing';
-
Excluir dados
A operação DELETE exclui uma ou mais linhas que atendem a condições especificadas em uma tabela Transactional ou Delta Table.
-
Sintaxe
DELETE FROM <table_name> [[AS] alias] [WHERE <condition>]; -
Parâmetros
Parâmetro
Obrigatório
Descrição
table_name
Sim
O nome da tabela Transactional ou Delta Table na qual executar a operação
DELETE.alias
Não
O alias da tabela.
where_condition
Não
Uma cláusula WHERE para filtrar dados que atendem à condição. Para mais informações sobre a cláusula WHERE, consulte SELECT syntax. Se não for incluída uma cláusula WHERE, a operação excluirá todos os dados da tabela.
-
Exemplos
-
Exemplo 1: Crie uma tabela não particionada chamada acid_delete, importe dados e, em seguida, execute a operação
DELETEpara excluir linhas que atendam a uma condição especificada. Confira os comandos de exemplo a seguir:-- Create a Transactional table named acid_delete. CREATE TABLE IF NOT EXISTS acid_delete (id BIGINT) TBLPROPERTIES ("transactional"="true"); -- Insert data. INSERT OVERWRITE TABLE acid_delete VALUES (1), (2), (3), (2); -- View the inserted data. SELECT * FROM acid_delete; +------------+ | id | +------------+ | 1 | | 2 | | 3 | | 2 | +------------+ -- Delete rows where id is 2. If you run this command on the MaxCompute client (odpscmd), you must enter yes or no to confirm. DELETE FROM acid_delete WHERE id = 2; -- The following command is equivalent to the one above. DELETE FROM acid_delete ad WHERE ad.id = 2; -- View the result. The table now contains only data for 1 and 3. SELECT * FROM acid_delete; +------------+ | id | +------------+ | 1 | | 3 | +------------+ -
Exemplo 2: Crie uma tabela particionada chamada acid_delete_pt, importe dados e, em seguida, execute a operação
DELETEpara excluir linhas que atendam a uma condição especificada. Veja os comandos de exemplo:-- Create a Transactional table named acid_delete_pt. CREATE TABLE IF NOT EXISTS acid_delete_pt (id BIGINT) PARTITIONED BY (ds STRING) TBLPROPERTIES ("transactional"="true"); -- Add partitions. ALTER TABLE acid_delete_pt ADD IF NOT EXISTS PARTITION (ds = '2019'); ALTER TABLE acid_delete_pt ADD IF NOT EXISTS PARTITION (ds = '2018'); -- Insert data. INSERT OVERWRITE TABLE acid_delete_pt PARTITION (ds = '2019') VALUES (1), (2), (3); INSERT OVERWRITE TABLE acid_delete_pt PARTITION (ds = '2018') VALUES (1), (2), (3); -- View the inserted data. SELECT * FROM acid_delete_pt; +------------+------------+ | id | ds | +------------+------------+ | 1 | 2018 | | 2 | 2018 | | 3 | 2018 | | 1 | 2019 | | 2 | 2019 | | 3 | 2019 | +------------+------------+ -- Delete data where the partition is 2019 and id is 2. If you run this command on the MaxCompute client (odpscmd), you must enter yes or no to confirm. DELETE FROM acid_delete_pt WHERE ds = '2019' AND id = 2; -- View the result. The data where the partition is 2019 and id is 2 has been deleted. SELECT * FROM acid_delete_pt; +------------+------------+ | id | ds | +------------+------------+ | 1 | 2018 | | 2 | 2018 | | 3 | 2018 | | 1 | 2019 | | 3 | 2019 | +------------+------------+ -
Exemplo 3: Crie uma tabela de destino chamada acid_delete_t e uma tabela associada chamada acid_delete_s. Em seguida, exclua linhas que atendam a uma condição especificada por meio de uma operação de junção (join). Confira os exemplos de comandos:
-- Create a target Transactional table named acid_delete_t and an associated table named acid_delete_s. CREATE TABLE IF NOT EXISTS acid_delete_t (id INT, value1 INT, value2 INT) TBLPROPERTIES ("transactional"="true"); CREATE TABLE IF NOT EXISTS acid_delete_s (id INT, value1 INT, value2 INT); -- Insert data. INSERT OVERWRITE TABLE acid_delete_t VALUES (2, 20, 21), (3, 30, 31), (4, 40, 41); INSERT OVERWRITE TABLE acid_delete_s VALUES (1, 100, 101), (2, 200, 201), (3, 300, 301); -- Delete rows from the acid_delete_t table where the id does not match an id in the acid_delete_s table. If you run this command on the MaxCompute client (odpscmd), you must enter yes or no to confirm. DELETE FROM acid_delete_t WHERE NOT EXISTS (SELECT * FROM acid_delete_s WHERE acid_delete_t.id = acid_delete_s.id); -- The following command is equivalent to the one above. DELETE FROM acid_delete_t a WHERE NOT EXISTS (SELECT * FROM acid_delete_s b WHERE a.id = b.id); -- View the result. The table now contains only data for id 2 and 3. SELECT * FROM acid_delete_t; +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 2 | 20 | 21 | | 3 | 30 | 31 | +------------+------------+------------+ -
Exemplo 4: Crie uma Delta Table chamada mf_dt, importe dados e, em seguida, execute a operação DELETE para excluir linhas que atendam a uma condição especificada. Os comandos de exemplo são:
-- Create a target Delta Table named mf_dt.
CREATE TABLE IF  NOT EXISTS mf_dt (pk BIGINT  NOT NULL PRIMARY KEY,
                  val  BIGINT NOT NULL)
                  PARTITIONED BY(dd STRING, hh STRING)
                  tblproperties ("transactional"="true");

-- Insert data.
INSERT OVERWRITE TABLE mf_dt PARTITION (dd='01', hh='02') VALUES (1, 1), (2, 2), (3, 3);

-- View the inserted data.
SELECT * FROM mf_dt WHERE dd='01' AND hh='02';

-- The following result is returned:
+------------+------------+----+----+
| pk         | val        | dd | hh |
+------------+------------+----+----+
| 1          | 1          | 01 | 02 |
| 3          | 3          | 01 | 02 |
| 2          | 2          | 01 | 02 |
+------------+------------+----+----+

-- Delete data where the partition is 01 and 02, and val is 2.
DELETE FROM mf_dt WHERE val = 2  AND dd='01' AND hh='02';

-- View the result. The table now contains only data where val is 1 and 3.
SELECT * FROM mf_dt WHERE dd='01' AND hh='02';

-- The following result is returned:
+------------+------------+----+----+
| pk         | val        | dd | hh |
+------------+------------+----+----+
| 1          | 1          | 01 | 02 |
| 3          | 3          | 01 | 02 |
+------------+------------+----+----+
-
Limpar dados de colunas
Use o comando CLEAR COLUMN para limpar dados de colunas em uma tabela padrão. Essa operação exclui dados em desuso do disco e define os valores das colunas como NULL, o que ajuda a reduzir os custos de armazenamento.
-
Sintaxe
ALTER TABLE <table_name> [PARTITION ( <pt_spec>[, <pt_spec>....] )] CLEAR COLUMN column1[, column2, column3, ...] [WITHOUT TOUCH]; -
Parâmetros
Parâmetro
Descrição
table_name
O nome da tabela cujos dados de coluna são a limpar.
column1 , column2 ...Os nomes das colunas cujos dados são a limpar.
PARTITION
Especifica a partição. Se não for especificada, a operação se aplica a todas as partições.
pt_spec
A descrição da partição, no formato
(partition_col1 = PARTITION_col_value1, PARTITION_col2 = PARTITION_col_value2, ...).WITHOUT TOUCH
Se especificado,
LastDataModifiedTimenão será atualizado. Se não for especificado,LastDataModifiedTimeserá atualizado.NotaAtualmente,
WITHOUT TOUCHé especificado por padrão. Em uma versão futura, haverá suporte para o comportamento de limpar dados de colunas sem especificarWITHOUT TOUCH. Isso significa que, seWITHOUT TOUCHnão for especificado,LastDataModifiedTimeserá atualizado. -
Limites
-
Não é possível limpar colunas com a restrição NOT NULL. Remova manualmente a restrição NOT NULL:
ALTER TABLE <table_name> change COLUMN <old_col_name> NULL; Não há suporte para limpeza de colunas em tabelas ACID.
Não há suporte para limpeza de colunas em tabelas clusterizadas.
Não há suporte para limpeza de colunas em tipos aninhados.
Não há suporte para limpar todas as colunas. O comando
DROP TABLEatinge o mesmo efeito com melhor desempenho.
-
-
Precauções
A operação
CLEAR COLUMNnão altera a propriedade Archive da tabela.-
A operação
CLEAR COLUMNem uma coluna de tipo aninhado pode falhar.Essa falha ocorre ao executar a operação
CLEAR COLUMNem uma tabela que contém tipos aninhados colunares com o armazenamento colunar para tipos aninhados desativado. O comando
CLEAR COLUMNdepende do Storage Service online. A tarefa pode sofrer atrasos se entrar na fila durante períodos de alto volume de jobs.A operação
CLEAR COLUMNrequer recursos de computação para ler e gravar dados. Para usuários de assinatura, a operação consome recursos de computação. Para usuários de pagamento conforme o uso, a operação incorre nas mesmas taxas de um job SQL. (Este recurso está atualmente em preview por convite e é temporariamente gratuito.)
-
Exemplos
-
-- Create a table. CREATE TABLE IF NOT EXISTS mf_cc(key STRING, value STRING, a1 BIGINT , a2 BIGINT , a3 BIGINT , a4 BIGINT) PARTITIONED BY(ds STRING, hr STRING); -- Add a partition. ALTER TABLE mf_cc ADD IF NOT EXISTS PARTITION (ds='20230509', hr='1641'); -- Insert data. INSERT INTO mf_cc PARTITION (ds='20230509', hr='1641') VALUES("key","value",1,22,3,4); -- Query data. SELECT * FROM mf_cc WHERE ds='20230509' AND hr='1641'; -- The following result is returned: +-----+-------+------------+------------+--------+------+---------+-----+ | key | value | a1 | a2 | a3 | a4 | ds | hr | +-----+-------+------------+------------+--------+------+---------+-----+ | key | value | 1 | 22 | 3 | 4 | 20230509| 1641| +-----+-------+------------+------------+--------+------+---------+-----+ -- Clear column data. ALTER TABLE mf_cc PARTITION(ds='20230509', hr='1641') CLEAR COLUMN key,a1 WITHOUT TOUCH; -- Query data. SELECT * FROM mf_cc WHERE ds='20230509' AND hr='1641'; -- The following result is returned. The data in the key and a1 columns has become null. +-----+-------+------------+------------+--------+------+---------+-----+ | key | value | a1 | a2 | a3 | a4 | ds | hr | +-----+-------+------------+------------+--------+------+---------+-----+ | null| value | null | 22 | 3 | 4 | 20230509| 1641| +-----+-------+------------+------------+--------+------+---------+-----+ -
A figura a seguir mostra a alteração no tamanho total de armazenamento da tabela
lineitem(no formato AliORC) à medida que cada coluna é limpa usando o comandoCLEAR COLUMN. A tabelalineitempossui 16 colunas de vários tipos, incluindo BIGINT, DECIMAL, CHAR, DATE e VARCHAR.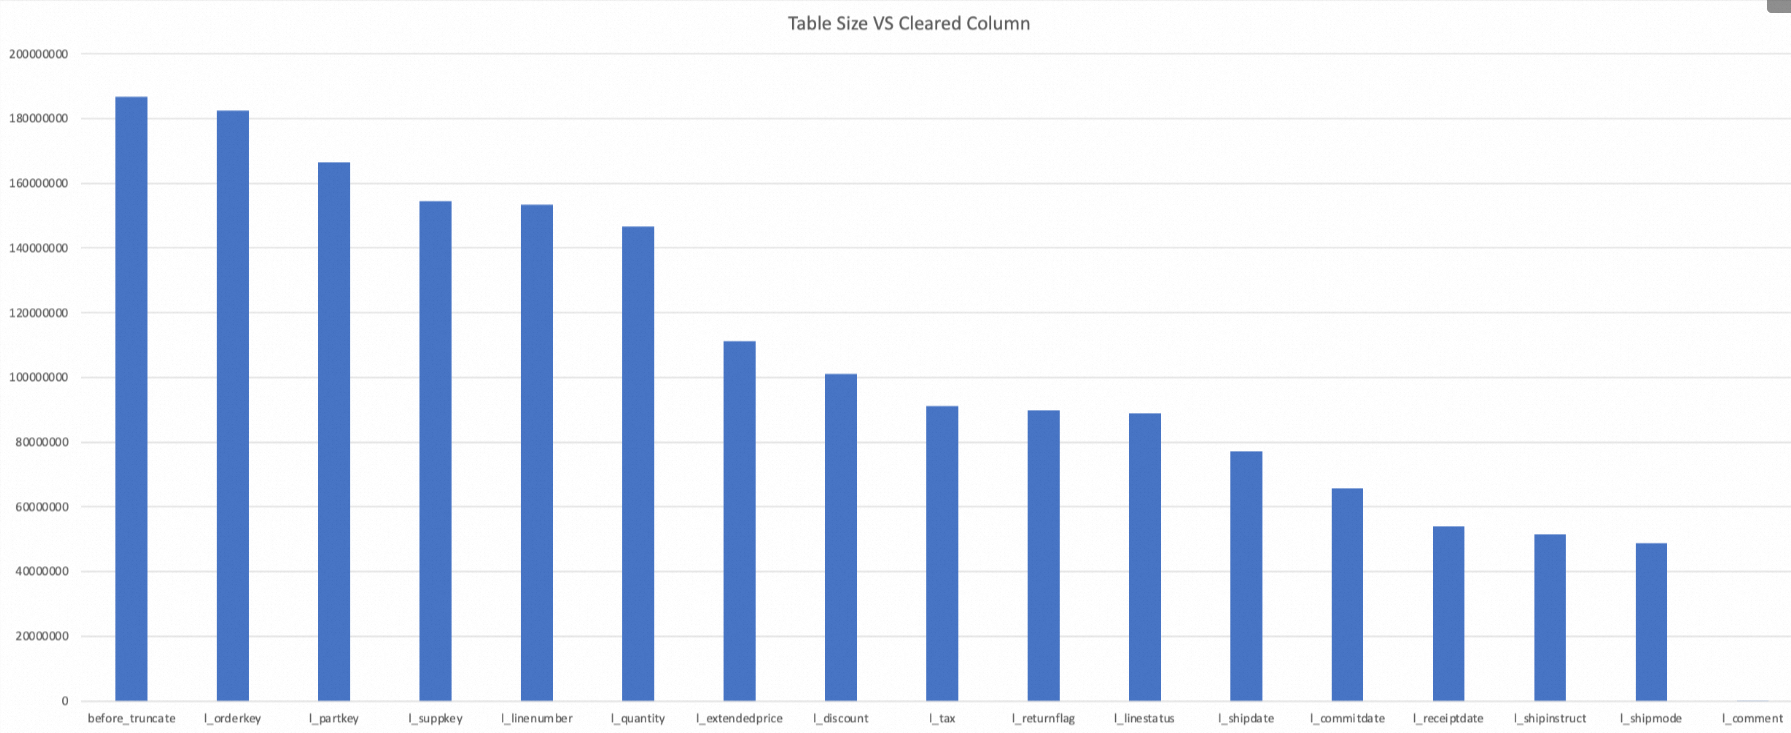
Como você pode ver, depois que as 16 colunas da tabela são sequencialmente definidas como NULL pelo comando
CLEAR COLUMN, o espaço total de armazenamento é reduzido em 99,97% (de 186.783.526 bytes iniciais para 236.715 bytes).NotaA quantidade de espaço economizada pela operação
CLEAR COLUMNdepende do tipo de dados e dos valores reais armazenados na coluna. Por exemplo, limpar a colunal_extendedprice, que é do tipo DECIMAL, economizou 24,2% do espaço (de 146.538.799 bytes para 111.138.117 bytes), o que é significativamente melhor do que a média.Quando todas as colunas são definidas como NULL, o tamanho da tabela é de 236.715 bytes, e não 0. Isso ocorre porque a estrutura de arquivos da tabela ainda existe. Campos NULL ocupam uma pequena quantidade de espaço de armazenamento, e o sistema também precisa reter as informações de rodapé do arquivo.
-
-
Atualizar dados
A operação
UPDATEatualiza os valores em uma ou mais colunas das linhas de uma tabela Transactional ou Delta Table.-
Sintaxe
-- Method 1 UPDATE <table_name> [[AS] alias] SET <col1_name> = <value1> [, <col2_name> = <value2> ...] [WHERE <where_condition>]; -- Method 2 UPDATE <table_name> [[AS] alias] SET (<col1_name> [, <col2_name> ...]) = (<value1> [, <value2> ...]) [WHERE <where_condition>]; -- Method 3 UPDATE <table_name> [[AS] alias] SET <col1_name> = <value1> [, <col2_name> = <value2>, ...] [FROM <additional_tables>] [WHERE <where_condition>]; -
Parâmetros
table_name: obrigatório. O nome da tabela Transactional ou Delta Table para a operação
UPDATE.alias: opcional. O alias da tabela.
col1_name, col2_name: obrigatório. Os nomes das colunas a serem modificadas. Atualize pelo menos uma coluna.
value1, value2: obrigatório. Os novos valores para as colunas. Atualize pelo menos um valor de coluna.
where_condition: opcional. Uma cláusula WHERE para filtrar dados. Para mais informações sobre a cláusula WHERE, consulte SELECT syntax. Se não for incluída uma cláusula WHERE, a operação atualizará todos os dados da tabela.
-
additional_tables: opcional. Uma cláusula FROM.
A instrução
UPDATEoferece suporte à cláusula FROM, o que pode simplificar a instruçãoUPDATE. A tabela a seguir compara uma instrução UPDATE com e sem a cláusula FROM.Cenário
Código de exemplo
Sem uma cláusula FROM
UPDATE target SET v =
  (SELECT MIN(v) FROM src GROUP BY k WHERE target.k = src.key)
  WHERE target.k IN (SELECT k FROM src);
Com uma cláusula FROM
UPDATE target SET v = b.v
  FROM (SELECT k, MIN(v) AS v FROM src GROUP BY k) b
  WHERE target.k = b.k;
Conforme mostrado nos exemplos de código:
Ao atualizar uma linha na tabela de destino com várias linhas da tabela de origem, use uma operação de agregação para garantir a unicidade dos dados de origem, pois o sistema não sabe qual linha de origem usar. A sintaxe sem a cláusula
FROMé menos concisa, enquanto a sintaxe com a cláusulaFROMé mais simples e fácil de entender.Em uma atualização com junção (join update), para atualizar apenas a interseção dos dados, a sintaxe sem a cláusula
FROMexige uma condiçãoWHEREextra e é menos concisa que a sintaxe com a cláusulaFROM.
-
Exemplos
-
Exemplo 1: Crie uma tabela não particionada chamada acid_update, importe dados e, em seguida, execute a operação
UPDATEpara atualizar as colunas das linhas que atendem a uma condição especificada. Confira os comandos de exemplo a seguir:-- Create a Transactional table named acid_update. CREATE TABLE IF NOT EXISTS acid_update(id BIGINT) tblproperties ("transactional"="true"); -- Insert data. INSERT OVERWRITE TABLE acid_update VALUES(1),(2),(3),(2); -- View the inserted data. SELECT * FROM acid_update; -- The following result is returned: +------------+ | id | +------------+ | 1 | | 2 | | 3 | | 2 | +------------+ -- Update the id value to 4 for all rows where id is 2. UPDATE acid_update SET id = 4 WHERE id = 2; -- View the update result. 2 has been updated to 4. SELECT * FROM acid_update; -- The following result is returned: +------------+ | id | +------------+ | 1 | | 3 | | 4 | | 4 | +------------+ -
Exemplo 2: Crie uma tabela particionada chamada acid_update_pt, importe dados e, em seguida, execute a operação
UPDATEpara atualizar as colunas das linhas que atendem a uma condição especificada. Veja os comandos de exemplo:-- Create a Transactional table named acid_update_pt. CREATE TABLE IF NOT EXISTS acid_update_pt(id BIGINT) PARTITIONED BY(ds STRING) tblproperties ("transactional"="true"); -- Add a partition. ALTER TABLE acid_update_pt ADD IF NOT EXISTS PARTITION (ds= '2019'); -- Insert data. INSERT OVERWRITE TABLE acid_update_pt PARTITION (ds='2019') VALUES(1),(2),(3); -- View the inserted data. SELECT * FROM acid_update_pt WHERE ds = '2019'; -- The following result is returned: +------------+------------+ | id | ds | +------------+------------+ | 1 | 2019 | | 2 | 2019 | | 3 | 2019 | +------------+------------+ -- Update a column in a specified row. Set the id value to 4 for all rows where the partition is 2019 and id is 2. UPDATE acid_update_pt SET id = 4 WHERE ds = '2019' AND id = 2; -- View the update result. 2 has been updated to 4. SELECT * FROM acid_update_pt WHERE ds = '2019'; -- The following result is returned: +------------+------------+ | id | ds | +------------+------------+ | 4 | 2019 | | 1 | 2019 | | 3 | 2019 | +------------+------------+ -
Exemplo 3: Crie uma tabela de destino chamada acid_update_t e uma tabela associada chamada acid_update_s para atualizar vários valores de coluna ao mesmo tempo. Confira os exemplos de comandos:
-- Create a target Transactional table to be updated, named acid_update_t, and an associated table named acid_update_s. CREATE TABLE IF NOT EXISTS acid_update_t(id INT,value1 INT,value2 INT) tblproperties ("transactional"="true"); CREATE TABLE IF NOT EXISTS acid_update_s(id INT,value1 INT,value2 INT); -- Insert data. INSERT OVERWRITE TABLE acid_update_t VALUES(2,20,21),(3,30,31),(4,40,41); INSERT OVERWRITE TABLE acid_update_s VALUES(1,100,101),(2,200,201),(3,300,301); -- Method 1: Update with constants. UPDATE acid_update_t SET (value1, value2) = (60,61); -- Query the result data in the target table for Method 1. SELECT * FROM acid_update_t; -- The following result is returned: +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 2 | 60 | 61 | | 3 | 60 | 61 | | 4 | 60 | 61 | +------------+------------+------------+ -- Method 2: Join update. The rule is a left join from acid_update_t to acid_update_s. UPDATE acid_update_t SET (value1, value2) = (SELECT value1, value2 FROM acid_update_s WHERE acid_update_t.id = acid_update_s.id); -- Query the result data in the target table for Method 2. SELECT * FROM acid_update_t; -- The following result is returned: +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 2 | 200 | 201 | | 3 | 300 | 301 | | 4 | NULL | NULL | +------------+------------+------------+ -- Method 3 (update based on the result of Method 2): Join update. The rule is to add a filter condition to update only the intersection. UPDATE acid_update_t SET (value1, value2) = (SELECT value1, value2 FROM acid_update_s WHERE acid_update_t.id = acid_update_s.id) WHERE acid_update_t.id IN (SELECT id FROM acid_update_s); -- Query the result data in the target table for Method 3. SELECT * FROM acid_update_t; -- The following result is returned: +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 2 | 200 | 201 | | 3 | 300 | 301 | | 4 | NULL | NULL | +------------+------------+------------+ -- Method 4 (update based on the result of Method 3): Join update with aggregate results. UPDATE acid_update_t SET (id, value1, value2) = (SELECT id, MAX(value1),MAX(value2) FROM acid_update_s WHERE acid_update_t.id = acid_update_s.id GROUP BY acid_update_s.id) WHERE acid_update_t.id IN (SELECT id FROM acid_update_s); -- Query the result data in the target table for Method 4. SELECT * FROM acid_update_t; -- The following result is returned: +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 2 | 200 | 201 | | 3 | 300 | 301 | | 4 | NULL | NULL | +------------+------------+------------+ -
Exemplo 4: Uma consulta de junção simples envolvendo duas tabelas. Os comandos de exemplo são:
-- Create a target table for update, acid_update_t, and an associated table, acid_update_s. CREATE TABLE IF NOT EXISTS acid_update_t(id BIGINT,value1 BIGINT,value2 BIGINT) tblproperties ("transactional"="true"); CREATE TABLE IF NOT EXISTS acid_update_s(id BIGINT,value1 BIGINT,value2 BIGINT); -- Insert data. INSERT OVERWRITE TABLE acid_update_t VALUES(2,20,21),(3,30,31),(4,40,41); INSERT OVERWRITE TABLE acid_update_s VALUES(1,100,101),(2,200,201),(3,300,301); -- Query data from the acid_update_t table. SELECT * FROM acid_update_t; -- The following result is returned: +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 2 | 20 | 21 | | 3 | 30 | 31 | | 4 | 40 | 41 | +------------+------------+------------+ -- Query data from the acid_update_s table. SELECT * FROM acid_update_s; -- The following result is returned: +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 1 | 100 | 101 | | 2 | 200 | 201 | | 3 | 300 | 301 | +------------+------------+------------+ -- Join update. Add a filter condition to the target table to update only the intersection. UPDATE acid_update_t SET value1 = b.value1, value2 = b.value2 FROM acid_update_s b WHERE acid_update_t.id = b.id; -- The following command is equivalent to the one above. UPDATE acid_update_t a SET a.value1 = b.value1, a.value2 = b.value2 FROM acid_update_s b WHERE a.id = b.id; -- View the update result. 20 is updated to 200, 21 to 201, 30 to 300, and 31 to 301. SELECT * FROM acid_update_t; -- The following result is returned: +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 4 | 40 | 41 | | 2 | 200 | 201 | | 3 | 300 | 301 | +------------+------------+------------+ -
Exemplo 5: Uma consulta de junção complexa envolvendo várias tabelas. Confira os comandos de exemplo a seguir:
-- Create a target table for update, acid_update_t, and an associated table, acid_update_s. CREATE TABLE IF NOT EXISTS acid_update_t(id BIGINT,value1 BIGINT,value2 BIGINT) tblproperties ("transactional"="true"); CREATE TABLE IF NOT EXISTS acid_update_s(id BIGINT,value1 BIGINT,value2 BIGINT); CREATE TABLE IF NOT EXISTS acid_update_m(id BIGINT,value1 BIGINT,value2 BIGINT); -- Insert data. INSERT OVERWRITE TABLE acid_update_t VALUES(2,20,21),(3,30,31),(4,40,41),(5,50,51); INSERT OVERWRITE TABLE acid_update_s VALUES (1,100,101),(2,200,201),(3,300,301),(4,400,401),(5,500,501); INSERT OVERWRITE TABLE acid_update_m VALUES(3,30,101),(4,400,201),(5,300,301); -- Query data from the acid_update_t table. SELECT * FROM acid_update_t; -- The following result is returned: +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 2 | 20 | 21 | | 3 | 30 | 31 | | 4 | 40 | 41 | | 5 | 50 | 51 | +------------+------------+------------+ -- Query data from the acid_update_s table. SELECT * FROM acid_update_s; -- The following result is returned: +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 1 | 100 | 101 | | 2 | 200 | 201 | | 3 | 300 | 301 | | 4 | 400 | 401 | | 5 | 500 | 501 | +------------+------------+------------+ -- Query data from the acid_update_m table. SELECT * FROM acid_update_m; -- The following result is returned: +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 3 | 30 | 101 | | 4 | 400 | 201 | | 5 | 300 | 301 | +------------+------------+------------+ -- Join update, and filter both the source and target tables in the WHERE clause. UPDATE acid_update_t SET value1 = acid_update_s.value1, value2 = acid_update_s.value2 FROM acid_update_s WHERE acid_update_t.id = acid_update_s.id AND acid_update_s.id > 2 AND acid_update_t.value1 NOT IN (SELECT value1 FROM acid_update_m WHERE id = acid_update_t.id) AND acid_update_s.value1 NOT IN (SELECT value1 FROM acid_update_m WHERE id = acid_update_s.id); -- View the update result. Only the data in the acid_update_t table with id 5 meets the condition. The corresponding value1 is updated to 500, and value2 is updated to 501. SELECT * FROM acid_update_t; -- The following result is returned: +------------+------------+------------+ | id | value1 | value2 | +------------+------------+------------+ | 5 | 500 | 501 | | 2 | 20 | 21 | | 3 | 30 | 31 | | 4 | 40 | 41 | +------------+------------+------------+ -
Exemplo 6: O comando a seguir é um exemplo de como criar uma Delta Table chamada mf_dt, importar dados e executar uma operação
UPDATEpara excluir linhas que atendam a uma condição especificada:-- Create a target Delta Table named mf_dt. CREATE TABLE IF NOT EXISTS mf_dt (pk BIGINT NOT NULL PRIMARY KEY, val BIGINT NOT NULL) PARTITIONED BY(dd STRING, hh STRING) tblproperties ("transactional"="true"); -- Insert data. INSERT OVERWRITE TABLE mf_dt PARTITION (dd='01', hh='02') VALUES (1, 1), (2, 2), (3, 3); -- View the inserted data. SELECT * FROM mf_dt WHERE dd='01' AND hh='02'; -- The following result is returned: +------------+------------+----+----+ | pk | val | dd | hh | +------------+------------+----+----+ | 1 | 1 | 01 | 02 | | 3 | 3 | 01 | 02 | | 2 | 2 | 01 | 02 | +------------+------------+----+----+ -- Update a column in a specified row. Set the val value to 30 for all rows where the partition is 01 and 02, and pk is 3. -- Method 1 UPDATE mf_dt SET val = 30 WHERE pk = 3 AND dd='01' AND hh='02'; -- Method 2 UPDATE mf_dt SET val = delta.val FROM (SELECT pk, val FROM VALUES (3, 30) t (pk, val)) delta WHERE delta.pk = mf_dt.pk AND mf_dt.dd='01' AND mf_dt.hh='02'; -- View the update result. SELECT * FROM mf_dt WHERE dd='01' AND hh='02'; -- The following result is returned. The val value for the row with pk=3 is updated to 30. +------------+------------+----+----+ | pk | val | dd | hh | +------------+------------+----+----+ | 1 | 1 | 01 | 02 | | 3 | 30 | 01 | 02 | | 2 | 2 | 01 | 02 | +------------+------------+----+----+
-
-
Sintaxe
ALTER TABLE <table_name> [PARTITION (<partition_key> = '<partition_value>' [, ...])] compact {minor|major}; -
Parâmetros
Parâmetro
Obrigatório
Descrição
table_name
Sim
O nome da tabela Transactional cujos arquivos você deseja mesclar.
partition_key
Não
Se a tabela Transactional for uma tabela particionada, especifique o nome da coluna da chave de partição.
partition_value
Não
Se a tabela Transactional for uma tabela particionada, especifique o valor para a coluna da chave de partição.
major|minor
Sim
Selecione uma das opções. As diferenças são:
minor: mescla apenas os arquivos base e todos os seus arquivos Delta subjacentes, eliminando os arquivos Delta.major: não apenas mescla os arquivos base e todos os seus arquivos Delta subjacentes para eliminar os arquivos Delta, mas também mescla arquivos pequenos dentro dos arquivos base correspondentes da tabela. Se um arquivo base for pequeno (menor que 32 MB) ou se existirem arquivos Delta, isso equivale a executar uma operaçãoINSERT OVERWRITEna tabela novamente. No entanto, se o arquivo base for grande o suficiente (maior ou igual a 32 MB) e não existirem arquivos Delta, ele não será regravado. -
Precauções
Os arquivos pequenos mesclados pela operação
compactsão excluídos após um dia. Ao usar o recurso local backup para restaurar um histórico que depende desses arquivos pequenos, a recuperação falhará porque os arquivos estarão ausentes. -
Exemplos
-
Exemplo 1: Mescle arquivos para a tabela Transactional acid_delete. Confira o comando de exemplo:
ALTER TABLE acid_delete compact minor;O seguinte resultado é retornado:
Summary: Nothing found to merge, set odps.merge.cross.paths=true if cross path merge is permitted. OK -
Exemplo 2: Mescle arquivos para a tabela Transactional acid_update_pt. Veja o comando de exemplo:
ALTER TABLE acid_update_pt PARTITION (ds = '2019') compact major;O seguinte resultado é retornado:
Summary:
table name: acid_update_pt /ds=2019  instance count: 2  run time: 6
  before merge, file count:        8  file size: 2613  file physical size: 7839
   after merge, file count:        2  file size: 679  file physical size: 2037

OK
-
-
Problema 1:
Descrição do problema: ao executar uma instrução
UPDATE, ocorre o erroODPS-0010000:System internal error - fuxi job failed, caused by: Data Set should contain exactly one row.-
Causa: as linhas a serem atualizadas não têm uma correspondência de um para um com os dados no resultado da subconsulta. O sistema não consegue determinar qual linha atualizar. Confira o comando de exemplo:
UPDATE store SET (s_county, s_manager) = (SELECT d_country, d_manager FROM store_delta sd WHERE sd.s_store_sk = store.s_store_sk) WHERE s_store_sk IN (SELECT s_store_sk FROM store_delta);A subconsulta
SELECT d_country, d_manager FROM store_delta sd WHERE sd.s_store_sk = store.s_store_skfaz a junção com store_delta, e os dados de store_delta atualizam store. Suponha que a coluna s_store_sk na tabela store contenha três linhas de dados:[1, 2, 3]. Se a coluna s_store_sk na tabela store_delta tiver duas linhas de dados,[1, 1], não existirá uma correspondência de um para um e a execução falhará. Solução: certifique-se de que as linhas a serem atualizadas tenham uma correspondência de um para um com os dados no resultado da subconsulta.
-
Problema 2:
Descrição do problema: ao executar o comando
compactno DataStudio do DataWorks, ocorre o erroODPS-0130161:[1,39] Parse exception - invalid token 'minor', expect one of 'StringLiteral','DoubleQuoteStringLiteral'.Causa: a versão do cliente MaxCompute no grupo de recursos exclusivo para DataWorks não oferece suporte ao comando
compact.Solução: entre em contato com a equipe de suporte técnico por meio do grupo DingTalk do DataWorks para atualizar a versão do cliente MaxCompute no grupo de recursos exclusivo.
Mesclar arquivos de tabela Transactional
O armazenamento físico subjacente de uma tabela Transactional consiste em arquivos base e arquivos Delta, que não são diretamente legíveis. Ao executar uma operação
UPDATEouDELETEem uma tabela Transactional, o sistema não modifica os arquivos base. Em vez disso, o sistema anexa arquivos Delta. Isso significa que, quanto maior o número de atualizações ou exclusões realizadas, mais armazenamento a tabela ocupará. O acúmulo de muitos arquivos Delta pode aumentar os custos de armazenamento e de consultas subsequentes.A execução de várias operações
UPDATEouDELETEna mesma tabela ou partição gera muitos arquivos Delta. Quando o sistema lê dados, ele precisa carregar esses arquivos Delta para determinar as linhas atualizadas ou excluídas. Muitos arquivos Delta podem degradar o desempenho de leitura de dados. Nesse caso, mescle os arquivos base e os arquivos Delta para reduzir o armazenamento e melhorar o desempenho de leitura de dados.Perguntas frequentes
-