O User-defined join (UDJ) estende o framework de funções definidas pelo usuário (UDF) do MaxCompute para aplicar lógica de junção personalizada entre duas tabelas. Baseado no mecanismo de computação MaxCompute V2.0, o UDJ permite expressar operações entre tabelas incompatíveis com os tipos padrão de JOIN e os frameworks UDF/UDTF/UDAF, sem exigir uma implementação MapReduce personalizada.
Quando usar o UDJ
O MaxCompute oferece seis tipos nativos de join: INNER JOIN, LEFT JOIN, RIGHT JOIN, FULL JOIN, SEMI JOIN e ANTI-SEMI JOIN. Os frameworks existentes de UDF, função com valor de tabela definida pelo usuário (UDTF) e função de agregação definida pelo usuário (UDAF) operam em apenas uma tabela por vez.
Para unir várias tabelas com lógica personalizada, existem atualmente duas opções, ambas com desvantagens significativas:
JOIN nativo com SQL complexo: combinar vários tipos de JOIN com UDFs em uma única instrução SQL cria uma caixa preta lógica que dificulta a geração de um plano de execução otimizado.
MapReduce personalizado: otimizar planos de execução é complexo. A maior parte do código MapReduce é escrita em Java e sua execução é menos eficiente que o código nativo do MaxCompute gerado pelo gerador de código Low Level Virtual Machine (LLVM).
O UDJ resolve ambas as limitações. A lógica de junção executa dentro do runtime nativo do MaxCompute, e a troca de dados entre o mecanismo de runtime do UDJ e seu código Java é otimizada. Isso torna a lógica de junção do UDJ mais eficiente que um reducer equivalente em MapReduce.
Com o UDJ, você pode:
Aplicar lógica de mesclagem personalizada a registros agrupados de duas tabelas
Tratar explicitamente casos assimétricos (grupo esquerdo vazio, grupo direito vazio)
Usar a pré-ordenação
SORT BYpara processar grupos grandes eficientemente, sem carregar todos os registros na memóriaSubstituir lógicas complexas de reducer do MapReduce por código Java chamável via SQL
Limitações
Não é possível usar UDFs, UDAFs ou UDTFs para ler dados dos seguintes tipos de tabela:
Tabelas com evolução de schema aplicada
Tabelas com tipos de dados complexos
Tabelas com tipos de dados JSON
Tabelas transacionais
Desempenho
Para validar o desempenho do UDJ, reescrevemos um job MapReduce real que executava um algoritmo complexo utilizando UDJ. Ambas as abordagens foram executadas no mesmo conjunto de dados e sob a mesma concorrência. A figura abaixo apresenta os resultados.
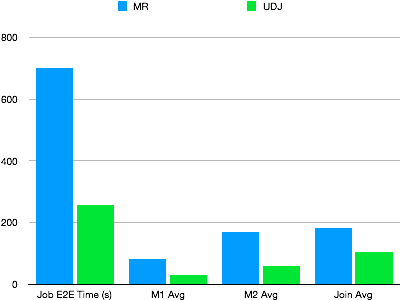
O UDJ supera significativamente a versão MapReduce. Toda a lógica do mapper roda no runtime nativo do MaxCompute. Além disso, a troca de dados entre o mecanismo de runtime do UDJ e as interfaces Java é otimizada no próprio código Java. Consequentemente, a lógica de junção é mais eficiente que o reducer equivalente.
Implementar UDJ: exemplo de junção entre tabelas
Esta seção apresenta um exemplo completo: para cada registro em um log de atividade do cliente, encontre o registro de pagamento com o timestamp mais próximo e mescle os dois.
Tabelas de exemplo
payment — armazena registros de pagamento do usuário
|
user_id |
time |
pay_info |
|
2656199 |
2018-02-13 22:30:00 |
gZhvdySOQb |
|
8881237 |
2018-02-13 08:30:00 |
pYvotuLDIT |
|
8881237 |
2018-02-13 10:32:00 |
KBuMzRpsko |
user_client_log — armazena logs de atividade do cliente
|
user_id |
time |
content |
|
8881237 |
2018-02-13 00:30:00 |
click MpkvilgWSmhUuPn |
|
8881237 |
2018-02-13 06:14:00 |
click OkTYNUHMqZzlDyL |
|
8881237 |
2018-02-13 10:30:00 |
click OkTYNUHMqZzlDyL |
Objetivo: para cada registro de user_client_log, localize o registro de payment com o valor de time mais próximo para o mesmo user_id e mescle os dois registros.
Um JOIN padrão não consegue realizar essa tarefa. A condição ABS(p.time - u.time) = MIN(ABS(p.time - u.time)) exige uma função de agregação dentro do predicado do JOIN, o que o SQL não permite.
Etapa 1: Configurar o SDK
Adicione o SDK de UDF ao seu projeto Maven:
<dependency>
  <groupId>com.aliyun.odps</groupId>
  <artifactId>odps-sdk-udf</artifactId>
  <version>0.29.10-public</version>
  <scope>provided</scope>
</dependency>
Etapa 2: Escrever a classe UDJ
A classe UDJ implementa três métodos de ciclo de vida:
setup(): chamado uma vez antes do início do processamento; use-o para inicializar o schema de saída e o estado compartilhadojoin(): chamado uma vez por chave de junção; recebe iteradores sobre os grupos de registros à esquerda e à direitaclose(): chamado após o processamento de todos os grupos; libere recursos neste método
O exemplo abaixo implementa a correspondência por tempo mais próximo. Todos os registros de pagamento de um determinado user_id são carregados em uma ArrayList, permitindo que o iterador do lado direito compare cada registro de log com todos eles.
package com.aliyun.odps.udf.example.udj;

import com.aliyun.odps.Column;
import com.aliyun.odps.OdpsType;
import com.aliyun.odps.Yieldable;
import com.aliyun.odps.data.ArrayRecord;
import com.aliyun.odps.data.Record;
import com.aliyun.odps.udf.DataAttributes;
import com.aliyun.odps.udf.ExecutionContext;
import com.aliyun.odps.udf.UDJ;
import com.aliyun.odps.udf.annotation.Resolve;
import java.util.ArrayList;
import java.util.Iterator;

// Output schema: (user_id STRING, time BIGINT, content STRING)
@Resolve("->string,bigint,string")
public class PayUserLogMergeJoin extends UDJ {

  private Record outputRecord;

  // Initialize the output record schema before processing starts.
  @Override
  public void setup(ExecutionContext executionContext, DataAttributes dataAttributes) {
    outputRecord = new ArrayRecord(new Column[]{
      new Column("user_id", OdpsType.STRING),
      new Column("time", OdpsType.BIGINT),
      new Column("content", OdpsType.STRING)
    });
  }

  // Called once per join key (user_id).
  // left  = payment records for this user_id
  // right = log records for this user_id
  @Override
  public void join(Record key, Iterator<Record> left, Iterator<Record> right, Yieldable<Record> output) {
    outputRecord.setString(0, key.getString(0));

    if (!right.hasNext()) {
      // No log records for this user — nothing to output.
      return;
    } else if (!left.hasNext()) {
      // No payment records — output log records unmerged.
      while (right.hasNext()) {
        Record logRecord = right.next();
        outputRecord.setBigint(1, logRecord.getDatetime(0).getTime());
        outputRecord.setString(2, logRecord.getString(1));
        output.yield(outputRecord);
      }
      return;
    }

    // Load all payment records into memory so each log record
    // can be compared against the full set.
    ArrayList<Record> pays = new ArrayList<>();
    left.forEachRemaining(pay -> pays.add(pay.clone()));

    while (right.hasNext()) {
      Record log = right.next();
      long logTime = log.getDatetime(0).getTime();
      long minDelta = Long.MAX_VALUE;
      Record nearestPay = null;

      // Find the payment record with the smallest time difference.
      for (Record pay : pays) {
        long delta = Math.abs(logTime - pay.getDatetime(0).getTime());
        if (delta < minDelta) {
          minDelta = delta;
          nearestPay = pay;
        }
      }

      // Merge the log record with its nearest payment record.
      outputRecord.setBigint(1, log.getDatetime(0).getTime());
      outputRecord.setString(2, mergeLog(nearestPay.getString(1), log.getString(1)));
      output.yield(outputRecord);
    }
  }

  String mergeLog(String payInfo, String logContent) {
    return logContent + ", pay " + payInfo;
  }

  @Override
  public void close() {}
}
Empacote esta classe como odps-udj-example.jar.
Etapa 3: Registrar a função UDJ
Faça upload do arquivo JAR e registre a função:
ADD jar odps-udj-example.jar;

CREATE FUNCTION pay_user_log_merge_join
  AS 'com.aliyun.odps.udf.example.udj.PayUserLogMergeJoin'
  USING 'odps-udj-example.jar';
Etapa 4: Preparar dados de exemplo
CREATE TABLE payment(user_id STRING, time DATETIME, pay_info STRING);
CREATE TABLE user_client_log(user_id STRING, time DATETIME, content STRING);

-- Insert payment records
INSERT OVERWRITE TABLE payment VALUES
('1335656', datetime '2018-02-13 19:54:00', 'PEqMSHyktn'),
('2656199', datetime '2018-02-13 12:21:00', 'pYvotuLDIT'),
('2656199', datetime '2018-02-13 20:50:00', 'PEqMSHyktn'),
('2656199', datetime '2018-02-13 22:30:00', 'gZhvdySOQb'),
('8881237', datetime '2018-02-13 08:30:00', 'pYvotuLDIT'),
('8881237', datetime '2018-02-13 10:32:00', 'KBuMzRpsko'),
('9890100', datetime '2018-02-13 16:01:00', 'gZhvdySOQb'),
('9890100', datetime '2018-02-13 16:26:00', 'MxONdLckwa');

-- Insert log records
INSERT OVERWRITE TABLE user_client_log VALUES
('1000235', datetime '2018-02-13 00:25:36', 'click FNOXAibRjkIaQPB'),
('1000235', datetime '2018-02-13 22:30:00', 'click GczrYaxvkiPultZ'),
('1335656', datetime '2018-02-13 18:30:00', 'click MxONdLckpAFUHRS'),
('1335656', datetime '2018-02-13 19:54:00', 'click mKRPGOciFDyzTgM'),
('2656199', datetime '2018-02-13 08:30:00', 'click CZwafHsbJOPNitL'),
('2656199', datetime '2018-02-13 09:14:00', 'click nYHJqIpjevkKToy'),
('2656199', datetime '2018-02-13 21:05:00', 'click gbAfPCwrGXvEjpI'),
('2656199', datetime '2018-02-13 21:08:00', 'click dhpZyWMuGjBOTJP'),
('2656199', datetime '2018-02-13 22:29:00', 'click bAsxnUdDhvfqaBr'),
('2656199', datetime '2018-02-13 22:30:00', 'click XIhZdLaOocQRmrY'),
('4356142', datetime '2018-02-13 18:30:00', 'click DYqShmGbIoWKier'),
('4356142', datetime '2018-02-13 19:54:00', 'click DYqShmGbIoWKier'),
('8881237', datetime '2018-02-13 00:30:00', 'click MpkvilgWSmhUuPn'),
('8881237', datetime '2018-02-13 06:14:00', 'click OkTYNUHMqZzlDyL'),
('8881237', datetime '2018-02-13 10:30:00', 'click OkTYNUHMqZzlDyL'),
('9890100', datetime '2018-02-13 16:01:00', 'click vOTQfBFjcgXisYU'),
('9890100', datetime '2018-02-13 16:20:00', 'click WxaLgOCcVEvhiFJ');
Etapa 5: Executar o UDJ em SQL
A cláusula USING identifica a função UDJ e mapeia as colunas de cada tabela:
SELECT r.user_id, FROM_UNIXTIME(time/1000) AS time, content
FROM (
  SELECT user_id, time AS time, pay_info FROM payment
) p
JOIN (
  SELECT user_id, time AS time, content FROM user_client_log
) u
ON p.user_id = u.user_id
USING pay_user_log_merge_join(p.time, p.pay_info, u.time, u.content)
r
AS (user_id, time, content);
**Parâmetros da cláusula USING:**
|
Parâmetro |
Descrição |
|
|
Nome da função UDJ registrada |
|
|
Colunas das tabelas esquerda e direita passadas para o UDJ |
|
|
Alias para o conjunto de resultados do UDJ, referenciável na consulta externa |
|
|
Nomes das colunas para a saída do UDJ |
Saída esperada:
+---------+---------------------+-----------------------------------------------+
| user_id | time                | content                                       |
+---------+---------------------+-----------------------------------------------+
| 1000235 | 2018-02-13 00:25:36 | click FNOXAibRjkIaQPB                         |
| 1000235 | 2018-02-13 22:30:00 | click GczrYaxvkiPultZ                         |
| 1335656 | 2018-02-13 18:30:00 | click MxONdLckpAFUHRS, pay PEqMSHyktn         |
| 1335656 | 2018-02-13 19:54:00 | click mKRPGOciFDyzTgM, pay PEqMSHyktn         |
| 2656199 | 2018-02-13 08:30:00 | click CZwafHsbJOPNitL, pay pYvotuLDIT         |
| 2656199 | 2018-02-13 09:14:00 | click nYHJqIpjevkKToy, pay pYvotuLDIT         |
| 2656199 | 2018-02-13 21:05:00 | click gbAfPCwrGXvEjpI, pay PEqMSHyktn         |
| 2656199 | 2018-02-13 21:08:00 | click dhpZyWMuGjBOTJP, pay PEqMSHyktn         |
| 2656199 | 2018-02-13 22:29:00 | click bAsxnUdDhvfqaBr, pay gZhvdySOQb         |
| 2656199 | 2018-02-13 22:30:00 | click XIhZdLaOocQRmrY, pay gZhvdySOQb         |
| 4356142 | 2018-02-13 18:30:00 | click DYqShmGbIoWKier                         |
| 4356142 | 2018-02-13 19:54:00 | click DYqShmGbIoWKier                         |
| 8881237 | 2018-02-13 00:30:00 | click MpkvilgWSmhUuPn, pay pYvotuLDIT         |
| 8881237 | 2018-02-13 06:14:00 | click OkTYNUHMqZzlDyL, pay pYvotuLDIT         |
| 8881237 | 2018-02-13 10:30:00 | click OkTYNUHMqZzlDyL, pay KBuMzRpsko         |
| 9890100 | 2018-02-13 16:01:00 | click vOTQfBFjcgXisYU, pay gZhvdySOQb         |
| 9890100 | 2018-02-13 16:20:00 | click WxaLgOCcVEvhiFJ, pay MxONdLckwa         |
+---------+---------------------+-----------------------------------------------+
Otimizar o uso de memória com pré-ordenação SORT BY
A implementação acima carrega todos os registros de pagamento de cada user_id em uma ArrayList. Essa abordagem funciona quando um usuário possui poucos registros de pagamento, mas falha quando o grupo é grande demais para caber na memória.
Se os dados estiverem ordenados por tempo, basta rastrear alguns registros por vez em vez de todo o grupo.
Alteração no SQL
Adicione uma cláusula SORT BY para ordenar ambas as tabelas dentro de cada grupo de junção:
SELECT r.user_id, from_unixtime(time/1000) AS time, content
FROM (
  SELECT user_id, time AS time, pay_info FROM payment
) p
JOIN (
  SELECT user_id, time AS time, content FROM user_client_log
) u
ON p.user_id = u.user_id
USING pay_user_log_merge_join(p.time, p.pay_info, u.time, u.content)
r
AS (user_id, time, content)
SORT BY p.time, u.time;
Método join() atualizado
Com ambos os lados ordenados por tempo, é possível encontrar o registro de pagamento mais próximo usando uma única varredura linear. Isso compara uma janela deslizante de, no máximo, três registros, em vez de iterar por todo o grupo esquerdo para cada registro direito. Atualize o método join() para implementar essa lógica:
@Override
public void join(Record key, Iterator<Record> left, Iterator<Record> right, Yieldable<Record> output) {
  outputRecord.setString(0, key.getString(0));

  if (!right.hasNext()) {
    return;
  } else if (!left.hasNext()) {
    while (right.hasNext()) {
      Record logRecord = right.next();
      outputRecord.setBigint(1, logRecord.getDatetime(0).getTime());
      outputRecord.setString(2, logRecord.getString(1));
      output.yield(outputRecord);
    }
    return;
  }

  long prevDelta = Long.MAX_VALUE;
  Record logRecord = right.next();
  Record payRecord = left.next();
  Record lastPayRecord = payRecord.clone();

  while (true) {
    long delta = logRecord.getDatetime(0).getTime() - payRecord.getDatetime(0).getTime();

    if (left.hasNext() && delta > 0) {
      // The time gap is still shrinking — advance the left iterator.
      lastPayRecord = payRecord.clone();
      prevDelta = delta;
      payRecord = left.next();
    } else {
      // Minimum delta reached. Output the merged record and advance the right iterator.
      Record nearestPay = Math.abs(delta) < prevDelta ? payRecord : lastPayRecord;
      outputRecord.setBigint(1, logRecord.getDatetime(0).getTime());
      outputRecord.setString(2, mergeLog(nearestPay.getString(1), logRecord.getString(1)));
      output.yield(outputRecord);

      if (right.hasNext()) {
        logRecord = right.next();
        prevDelta = Math.abs(
          logRecord.getDatetime(0).getTime() - lastPayRecord.getDatetime(0).getTime()
        );
      } else {
        break;
      }
    }
  }
}
Esta versão armazena em cache no máximo três registros por vez e produz a mesma saída que a abordagem com ArrayList.
Após modificar a classe UDJ em Java, recompile o arquivo JAR e adicione-o novamente ao MaxCompute para que as alterações tenham efeito.