Este tópico apresenta uma visão geral do mecanismo MaxQA (MaxCompute Query Accelerator 2.0), incluindo arquitetura, casos de uso, limitações e utilização.
O MaxQA está disponível geralmente. Em caso de dúvidas, abra um ticket para receber assistência da equipe técnica do MaxCompute.
Para obter detalhes operacionais, consulte Query Acceleration MaxQA.
Descrição do recurso
O MaxQA (MaxCompute Query Accelerator 2.0, anteriormente MCQA 2.0) é uma solução de aceleração de consultas para o MaxCompute que atende à crescente demanda por análises de dados em tempo real e quase em tempo real. Essa solução reduz significativamente os tempos de resposta das consultas ao utilizar pools de recursos de aceleração dedicados e otimizações abrangentes no caminho de controle, otimizador de consultas, mecanismo de execução, mecanismo de armazenamento e sistema de cache. O MaxQA é ideal para workloads sensíveis à latência que exigem alta estabilidade, como business intelligence (BI), análise interativa e cenários de data warehouse quase em tempo real.
O recurso MaxCompute MaxQA (anteriormente MCQA2.0) oferece as seguintes capacidades:
-
Consultas e inserções de alto desempenho
Acelera consultas e jobs de inserção de dados para conjuntos de dados na escala de terabytes, alcançando tempos de execução inferiores a um segundo.
-
Compatibilidade com SQL
Totalmente compatível com os recursos SQL do MaxCompute, incluindo funções definidas pelo usuário (UDFs), Delta Tables e visualizações materializadas incrementais.
-
Isolamento de recursos e gerenciamento elástico
Fornece pools de recursos de aceleração de consultas isolados e dedicados a um único tenant para maior estabilidade.
Suporta regras de alocação de recursos baseadas em tempo e dimensionamento automático para grupos de cota interativos e pools de recursos de processamento em lote, melhorando a utilização dos recursos.
Oferece cache de ponta a ponta, no qual os jobs armazenam automaticamente resultados intermediários e finais de múltiplos estágios de execução. Jobs subsequentes podem acessar esse cache em qualquer estágio, acelerando significativamente a execução da consulta.
Compatível com diversas ferramentas de BI (FineBI, Tableau, Quick BI).
Limitações
O MaxQA executa apenas instruções DDL/DML/DQL (como instruções de operação de permissões, instruções relacionadas ao Tunnel, upload/download de recursos, etc.).
O MaxQA suporta Funções Definidas pelo Usuário (UDFs). Para garantir a segurança, cada UDF é iniciada em um ambiente isolado. Para evitar flutuações drásticas de desempenho, no máximo 50% dos recursos de uma instância do MaxQA podem ser usados para executar UDFs.
Para instruções DQL, são retornadas no máximo 1 milhão de linhas de dados por padrão. É possível ultrapassar esse limite definindo o parâmetro
odps.sql.select.auto.limitcom um valor maior. Recomenda-se definir esse valor cuidadosamente conforme as necessidades reais do negócio, pois um volume de retorno muito grande pode afetar a eficiência da execução.Atualmente, não há suporte para jobs que exigem Workers residentes no plano de execução, como Distributed MapJoin.
Se um job do MaxQA falhar devido a essas limitações, tente novamente o job manualmente ou envie-o para um pool de recursos de processamento em lote.
Arquitetura do service
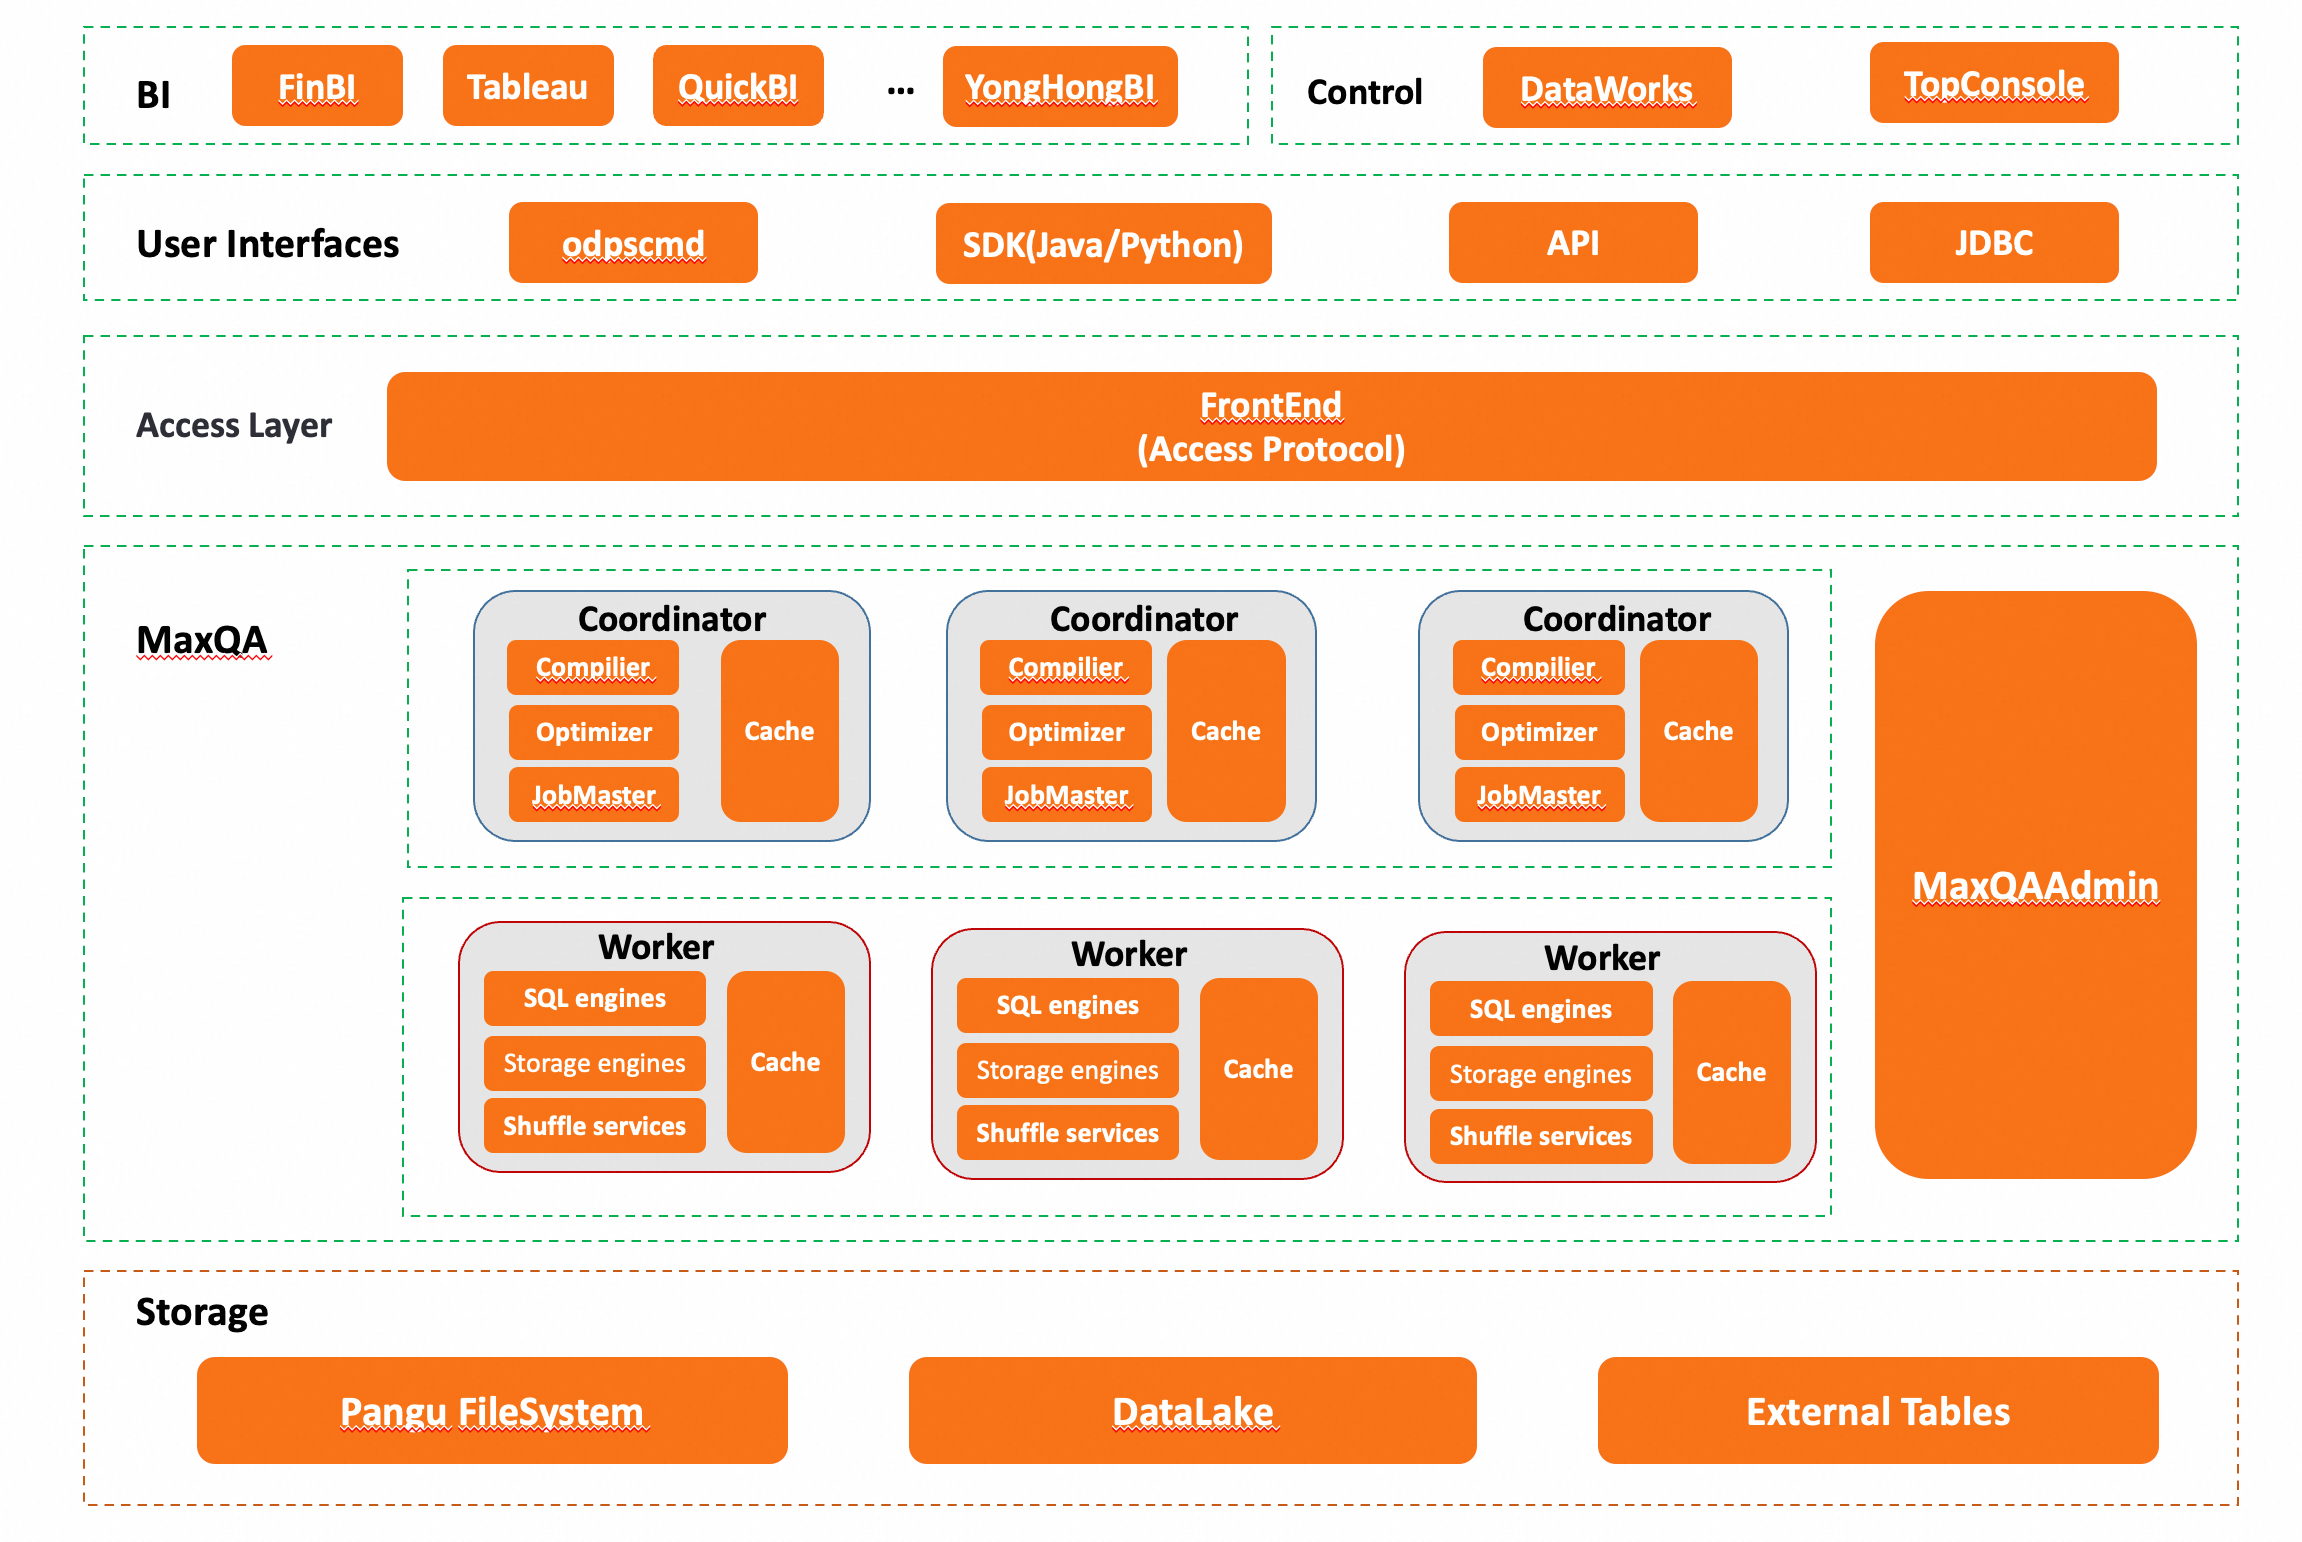
As principais vantagens técnicas do MaxQA incluem pools de recursos isolados dinamicamente e inteligentes, mecanismos de cache de ponta a ponta, I/O local, planos de execução otimizados para latência (QueryPlan) e um mecanismo de execução mais eficiente para melhorar a eficácia das consultas.
-
Pools de recursos inteligentes e dinamicamente isolados
Cada instância do MaxQA opera em um ambiente de computação completamente isolado. Um tenant pode criar várias instâncias, cada uma correspondendo a um grupo de cota interativo. Esse modelo evita o problema de "vizinho barulhento", comum em ambientes multitenant, e garante latência de consulta estável.
-
Mecanismo de cache de ponta a ponta
Dados como tabelas escaneadas, metadados, planos de execução, resultados intermediários e resultados finais da consulta são armazenados em cache automaticamente. Jobs subsequentes podem acessar esse cache em vários estágios, o que acelera a execução. Como o ambiente de computação é isolado no nível da instância, o cache tem vida útil mais longa e não sofre impacto de jobs de outras instâncias.
-
I/O Local
Maximiza o uso de armazenamento local para dados de I/O provenientes de operações como shuffle e spill. Isso reduz a dependência de sistemas externos e melhora a estabilidade da latência.
-
Plano de execução otimizado para latência
O otimizador de consultas prioriza a baixa latência em todos os aspectos do planejamento, incluindo seleção do plano de execução física, cálculo de concorrência e escolha do algoritmo de compressão.
-
Caminho de controle simplificado
O frontend conecta-se diretamente ao coordenador. A arquitetura do caminho de controle é otimizada e assíncrona para tornar a interação mais eficiente.
A arquitetura técnica do MaxQA é mostrada na figura a seguir.
Cenários
O recurso MaxQA abrange diversos cenários de aplicação, desde relatórios operacionais diários até análises avançadas de dados, sendo particularmente adequado para cenários de negócios com altos requisitos de tempo de resposta e estabilidade de consultas. Seja para suporte a decisões de curto prazo ou planejamento estratégico de longo prazo, o MaxQA fornece forte suporte técnico às empresas, aumentando a capacidade de criação de valor impulsionada por dados.
Cenário | Descrição | Características | Exemplos |
Consulta ad hoc | Selecione condições de consulta flexivelmente com base nas necessidades reais, obtenha resultados rapidamente e ajuste a lógica de consulta. Ideal para desenvolvedores ou analistas de dados que desejam realizar análises usando ferramentas cliente familiares. | • Exige latência de consulta de alguns segundos a dezenas de segundos. • Geralmente usado por desenvolvedores e analistas de dados com habilidades em SQL. • Permite condições de consulta flexíveis para adaptação rápida a mudanças nos negócios. | • Cientistas de dados realizando análise exploratória. • Engenheiros de dados depurando consultas temporárias em processos ETL. |
Business intelligence (BI) | Use o MaxCompute para construir data warehouses corporativos e processe dados via ETL em dados agregados consumíveis pelos negócios. Aproveite a baixa latência, isolamento de recursos, concorrência elástica, cache de dados e outros recursos do MaxQA para atender aos requisitos de geração de relatórios com alta concorrência, resposta rápida, análise estatística e análise de relatórios fixos. | • Consultas geralmente executadas em dados de resultados agregados. • Melhor para cenários com volumes menores de dados, consultas multidimensionais, consultas fixas e alta frequência. • Exige alto desempenho, com respostas em segundos (por exemplo, maioria das consultas concluídas em menos de 5 segundos). | • Geração de relatórios diários de vendas. • Monitoramento de indicadores-chave de negócios em tempo real. • Geração periódica de relatórios financeiros. |
Análise interativa de dados | Ferramentas de BI self-service e plataformas de exploração interativa facilitam a análise complexa de dados por usuários não técnicos. Essas ferramentas normalmente implementam filtragem dinâmica, classificação, agregação e outras funções por meio de uma série de consultas curtas, proporcionando uma experiência operacional flexível e intuitiva. | • Suporta operações de arrastar e soltar, eliminando a necessidade de escrever instruções SQL complexas. • Fornece feedback rápido de consulta para ajudar os usuários a iterarem suas análises. • Adequado para analistas de dados de todos os níveis, de iniciantes a especialistas. | • Uso de Tableau ou Fine BI para análise visual. • Exploração de dados em plataformas de análise online. |
Consultas detalhadas e análise de grandes volumes de dados | O MaxQA identifica automaticamente as características dos jobs de consulta, responde e processa rapidamente jobs de pequena escala e ajusta automaticamente os requisitos de recursos para jobs de grande escala, atendendo às necessidades dos analistas de consultar diferentes escalas e complexidades. | Exploração de grandes conjuntos de dados históricos, geralmente exigindo apenas um pequeno subconjunto dos dados. • Requisitos moderados de latência, equilibrando velocidades de processamento em tempo real e em lote. • Normalmente usado por analistas de negócios para descobrir padrões, identificar oportunidades e validar hipóteses a partir de dados detalhados. | • Análise de caminhos de comportamento do usuário. • Criação de segmentos e perfis de clientes. • Mineração de padrões de uso de products. |
Descrição de parâmetros do sistema para diferentes especificações de CU
|
Número de CUs |
Número máximo de jobs paralelos |
Timeout do job (min) |
Concorrência máxima por job |
|
25CU |
25CU |
120min |
Número de CUs × 30 |
|
50CU |
50CU |
120min |
Número de CUs × 30 |
|
75CU |
75CU |
120min |
Número de CUs × 30 |
|
100CU |
100CU |
120min |
Número de CUs × 30 |
|
125CU |
125CU |
120min |
Número de CUs × 30 |
|
150CU |
150CU |
120min |
Número de CUs × 30 |
|
200CU |
200CU |
120min |
Número de CUs × 30 |
|
[200, 600)CU |
Igual ao número de CUs |
120min |
Número de CUs × 30 |
|
[600, 1000)CU |
Igual ao número de CUs |
120min |
Número de CUs × 30 |
|
[1000, 2000)CU |
Igual ao número de CUs |
240min |
Número de CUs × 30 |
|
[2000, 3000)CU |
Igual ao número de CUs |
360min |
Número de CUs × 30 |
|
[3000, 4000)CU |
Igual ao número de CUs |
480min |
Número de CUs × 30 |
|
[4000, 5000)CU |
Igual ao número de CUs |
600min |
Número de CUs × 30 |
|
[5000, 6000)CU |
Igual ao número de CUs |
720min |
Número de CUs × 30 |
Resultados de testes de desempenho TPC-DS
Os resultados podem variar ligeiramente por região. O desempenho real no seu ambiente pode ser diferente.
|
Especificação |
10GB |
100GB |
1TB |
|
25CU |
550s |
498s |
3634s |
|
50CU |
203s |
295s |
1531s |
|
100CU |
198s |
260s |
692s |
O relatório de teste de desempenho acima foi obtido no ambiente de testes na região China (Beijing).
Para planos e conteúdo detalhados dos testes, consulte TPC-DS Performance Testing.
MaxQA vs. MCQA (não disponível para novas ativações)
|
Item de comparação |
MCQA |
MaxQA (MCQA2.0) |
|
Arquitetura |
Baseado em pools de recursos Serverless. |
Ambiente de computação isolado para tenant único. |
|
Estabilidade de latência |
Média. |
Boa. |
|
Desempenho de computação |
Significativamente superior ao modo offline, mas com estabilidade insuficiente. |
Incorpora múltiplas otimizações, oferecendo melhor desempenho. |
|
Tipos de jobs suportados |
Suporta apenas DQL. |
Todos os tipos de capacidades SQL, incluindo DDL, DQL e DML. |
|
Método de uso |
Ative o modo interativo. |
Especifique o nome do grupo de Quota interativo ao enviar um job ou selecione-o diretamente na página de execução ou configuração de agendamento de um nó SQL do DataWorks. Para mais informações, consulte Query Acceleration MaxQA. |
|
Roteamento de cota |
Suportado. |
Suportado. |
|
Pagamento conforme o uso |
Suportado. |
Não suportado atualmente. |
|
Conceito de sessão |
Sim. Jobs enviados do mesmo cliente em períodos adjacentes podem pertencer a uma sessão, com cada sessão correspondendo a um Instance ID. |
Não. Cada job SQL corresponde a um Instance ID. |
|
Mecanismo de fallback |
Possui capacidade de retornar automaticamente ao modo de processamento em lote. |
Suportado. Também é possível configurar regras de fallback na página de configuração de agendamento do DataWorks. Para mais informações, consulte Using DataWorks DataStudio. |
Método de uso
Para métodos específicos de uso do MaxQA, consulte Query Acceleration MaxQA.