Ao usar o PyODPS DataFrame, o código é executado em dois ambientes distintos: sua máquina local (ambiente on-premises) e um executor do MaxCompute na nuvem. As funções passadas para map, apply, map_reduce ou operações de agregação personalizadas são executadas dentro do executor do MaxCompute, e não localmente. Compreender essa separação evita erros de importação, conflitos de pacotes e falhas no acesso a dados.
Modelo de execução
O PyODPS é um pacote Python, não uma implementação da linguagem. Ele roda em ambientes Python padrão e se comporta como qualquer interpretador Python comum.
Considere o exemplo a seguir:
from odps import ODPS, options
import numpy as np

o = ODPS(...)
df = o.get_table('pyodps_iris').to_df()

coeffs = [0.1, 0.2, 0.4]

def handle(v):
    import numpy as np
    return float(np.cosh(v)) * sum(coeffs)

options.df.supersede_libraries = True
val = df.sepal_length.map(handle).sum().execute(libraries=['numpy.zip', 'other.zip'])
print(np.sinh(val))
O diagrama abaixo ilustra os sistemas envolvidos durante a execução deste código. Tudo o que está fora do MaxCompute corresponde ao ambiente on-premises.
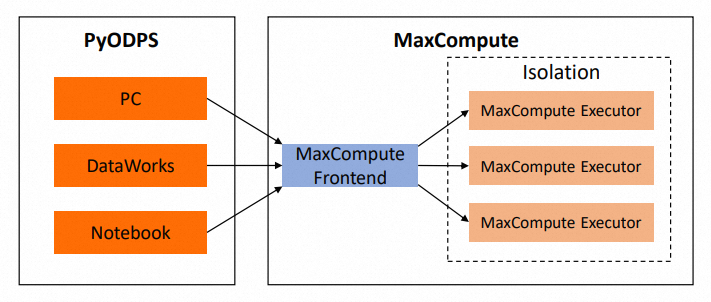
Todo o código, exceto o corpo da função handle, roda no ambiente on-premises. A função handle é passada para map, mas não é chamada nesse local; ela é enviada ao MaxCompute e executada remotamente.
Quando você passa a função handle para map com o backend do MaxCompute, o PyODPS a processa em três fases:
O módulo cloudpickle extrai o closure e o bytecode da função.
O PyODPS DataFrame usa o closure e o bytecode para gerar uma função definida pelo usuário (UDF) em Python e a envia ao MaxCompute.
Se você executar jobs no MaxCompute usando instruções SQL, a UDF Python gerada será chamada, o bytecode e o closure serão desserializados (unpickled) e a UDF será executada em um executor do MaxCompute.
Limite de execução
|
Localização do código |
Executado em |
|
Importações e instruções de nível superior |
Ambiente on-premises |
|
Corpo da função passado para |
Executor do MaxCompute |
|
Todo o código ao usar o backend pandas |
Ambiente on-premises |
Restrições em um executor do MaxCompute
As restrições a seguir se aplicam a qualquer corpo de função passado para map, apply, map_reduce ou funções de agregação personalizadas quando o backend do MaxCompute estiver ativo.
Pacotes locais indisponíveis. Apenas pacotes disponíveis nos executores do MaxCompute podem ser referenciados dentro do corpo da função. No exemplo acima, o arquivo other.zip listado em libraries=['numpy.zip', 'other.zip'] deve existir como um resource do MaxCompute. Fazer o upload para o MaxCompute não é suficiente se ele estiver ausente no ambiente on-premises.
Importe pacotes dentro do corpo da função. Se você importar um pacote fora da função e referenciá-lo internamente, poderá ocorrer um erro. O cloudpickle envia a referência ao pacote on-premises, mas a estrutura do pacote pode ser incompatível com o executor do MaxCompute. Em vez disso, importe o pacote dentro do corpo da função, conforme demonstrado na função handle do exemplo.
Variáveis externas capturadas por valor. Caso você referencie uma variável definida fora da função (como coeffs no exemplo) e a modifique dentro do corpo da função, o valor on-premises será mantido. A modificação não se propaga de volta para o ambiente on-premises.
Códigos de outros arquivos devem existir no executor. Se o corpo da função referenciar código de outro arquivo, o pacote que contém esse arquivo precisa estar disponível no executor do MaxCompute. Se preferir não empacotá-lo como um resource de terceiros, armazene todo o código pessoal referenciado no mesmo arquivo.
Integração de pacotes de terceiros com Python 2.7 (UCS-2). O pacote de terceiros enviado deve ser integrado ao Python 2.7, que utiliza UCS-2, em um executor do MaxCompute.
Sem acesso direto a outras tabelas do MaxCompute. Os executores do MaxCompute não suportam conexões a endpoints ou Tunnel endpoints, e nenhum pacote PyODPS está disponível dentro do executor. Não é possível usar objetos de entrada ODPS ou PyODPS DataFrame para acessar outras tabelas do MaxCompute de dentro do corpo de uma função, nem passar esses objetos externamente.
Para tabelas pequenas: passe a tabela como um resource de DataFrame.
Para tabelas grandes: use uma junção de tabelas (join).
Uso de pacotes de terceiros
A forma de usar pacotes de terceiros depende do local onde seu código é executado.
Computador pessoal ou servidor on-premises. Instale o pacote para a versão necessária do Python usando pip ou seu gerenciador de pacotes.
Notebook. Entre em contato com o provedor da plataforma para obter instruções sobre a instalação de pacotes.
DataWorks. O DataWorks não suporta a instalação direta de pacotes no sistema on-premises. Em vez disso, referencie pacotes de terceiros lendo o arquivo e executando o comando exec. Para mais detalhes, consulte Usar um nó PyODPS para referenciar um pacote de terceiros.
A estrutura de diretórios exibida no DataStudio não corresponde à estrutura real no sistema de arquivos. Tentar importar ou abrir um caminho mostrado no DataStudio resultará em falha.
Após fazer o upload de resources no DataWorks, clique em Submit para garantir que os resources sejam carregados no MaxCompute.
Para usar uma versão personalizada do NumPy, defina
odps.df.supersede_libraries = Trueno seu código e especifique o nome do pacote NumPy como a primeira entrada no parâmetrolibrariesao enviar o pacote wheel necessário.
Acesso a dados em outras tabelas do MaxCompute
O método de acesso a outras tabelas do MaxCompute varia conforme o ambiente de execução do código.
Ambiente on-premises (computador pessoal, servidor on-premises, Notebook ou DataWorks). Use o código on-premises para acessar a tabela. Se houver conectividade com o endpoint, use PyODPS ou PyODPS DataFrame. Caso contrário, contate o provedor da plataforma.
Dentro das funções map, apply, map_reduce ou de agregação personalizada. Os executores do MaxCompute não permitem conexões a endpoints ou Tunnel endpoints, e o pacote PyODPS não está disponível. É impossível usar objetos de entrada ODPS ou PyODPS DataFrame para acessar outras tabelas, bem como passar esses objetos externamente.
Para tabelas pequenas: passe a tabela como um resource de DataFrame.
Para tabelas grandes: use uma junção de tabelas (join).
Comportamento do backend pandas
Ao usar o backend pandas, todo o código roda no ambiente on-premises. Instale localmente todos os pacotes necessários.
Na transição do backend pandas para o MaxCompute em produção, siga as regras do backend MaxCompute para a instalação de pacotes.