O PyODPS é o kit de desenvolvimento de software (SDK) do MaxCompute para Python. Ele oferece uma interface de programação simples para escrever jobs do MaxCompute, consultar tabelas e visualizações e gerenciar recursos com Python. O PyODPS disponibiliza funcionalidades semelhantes às da interface de linha de comando do ODPS, como upload e download de arquivos, criação de tabelas e execução de consultas ODPS SQL. Também inclui recursos avançados, como envio de jobs MapReduce e uso de funções definidas pelo usuário (UDFs) do MaxCompute. Este tópico descreve os cenários de uso, as ferramentas compatíveis e considerações importantes sobre o PyODPS.
Introdução às funcionalidades
O PyODPS é usado nos seguintes cenários:
Ferramentas compatíveis
O PyODPS executa em ambientes locais, no DataWorks e em PAI Notebooks.
Independentemente da ferramenta usada, evite baixar todos os dados para sua máquina local ao executar jobs do PyODPS. Essa prática pode consumir muita memória e causar erros de falta de memória (OOM). Em vez disso, envie os jobs para o MaxCompute para execução distribuída. Para obter uma comparação, consulte Notes: Do not baixe full data to a local machine and execute PyODPS.
Ambiente local: instale e use o PyODPS no seu ambiente local. Para mais informações, consulte Use PyODPS in a local environment.
DataWorks: o PyODPS vem pré-instalado nos nós PyODPS do DataWorks. Nesses nós, desenvolva e execute periodicamente jobs do PyODPS diretamente. Para mais informações, consulte Use PyODPS in DataWorks.
PAI Notebooks: instale e execute o PyODPS no ambiente Python do PAI. O PyODPS já vem pré-instalado nas imagens integradas do PAI, como o componente Python personalizado do PAI-Designer, pronto para uso. O uso do PyODPS em PAI Notebooks segue o padrão convencional. Para mais informações, consulte Basic operations overview e DataFrame (not recommended).
Observações: não baixe todos os dados para a máquina local ao usar o PyODPS
O PyODPS é um SDK que roda em diversos clientes, incluindo PCs, nós PyODPS do DataWorks no Data Studio e ambientes de PAI Notebook.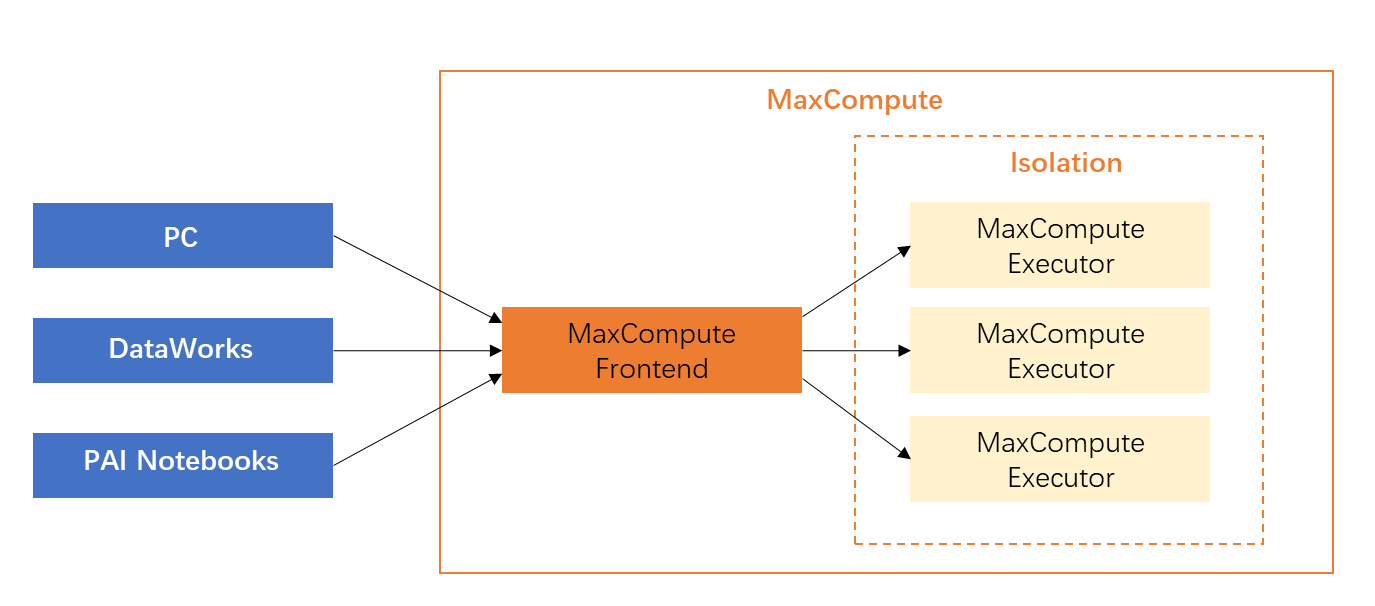 O PyODPS fornece várias operações práticas para trazer dados para a máquina local, como as operações de download via tunnel, execução e to_pandas. Por isso, muitos novos usuários tentam puxar os dados localmente, processá-los e depois fazer o upload de volta para o MaxCompute. No entanto, esse método costuma ser altamente ineficiente. Trazer os dados localmente impede o aproveitamento das capacidades de computação paralela em larga escala do MaxCompute.
|
Método de processamento de dados |
Descrição |
Cenário de exemplo |
|
Trazer dados para a máquina local para processamento (não recomendado; pode causar erros de OOM) |
Por exemplo, um nó PyODPS no DataWorks inclui um pacote PyODPS integrado e o ambiente Python necessário. Esse nó é um contêiner de runtime de cliente com recursos limitados. Ele não usa recursos de computação do MaxCompute e possui limites rigorosos de memória. |
O PyODPS oferece a interface |
|
Enviar jobs para o MaxCompute para execução distribuída (recomendado) |
Use o recurso de DataFrame distribuído do PyODPS. Envie as principais computações para o MaxCompute para execução distribuída, em vez de baixar e processar dados no nó cliente do PyODPS. Essa é a chave para usar o PyODPS corretamente. Nota
Para converter resultados de execução SQL em um DataFrame, use primeiro a instrução
|
Use a interface DataFrame do PyODPS para processamento de dados. Para tarefas comuns, como processar cada linha e gravá-la de volta em uma tabela ou dividir uma linha em várias, use os métodos Essas interfaces traduzem seu código em SQL para execução distribuída no cluster de computação do MaxCompute. Isso consome quase nenhuma memória local e melhora significativamente o desempenho em comparação à computação em máquina única. |
O exemplo de tokenização a seguir compara o código dos dois métodos.
-
Cenário de exemplo
Você precisa extrair informações analisando strings de log diárias. Existe uma tabela com uma única coluna do tipo string. Use a biblioteca jieba para tokenizar o texto em chinês, encontrar as palavras-chave desejadas e armazená-las em uma tabela de informações.
-
Demonstração de código de processamento ineficiente
import jieba
t = o.get_table('word_split')
out = []
with t.open_reader() as reader:
    for r in reader:
        words = list(jieba.cut(r[0]))
        #
        # Processing logic to generate processed_data
        #
        out.append(processed_data)
out_t = o.get_table('words')
with out_t.open_writer() as writer:
    writer.write(out)
Essa abordagem segue uma mentalidade de processamento em máquina única: lê os dados linha por linha, processa linha por linha e grava na tabela de destino linha por linha. Todo o processo consome muito tempo com download e upload de dados. A máquina que executa o script também precisa de grande quantidade de memória para processar todos os dados. Para usuários de nós do DataWorks, essa abordagem pode causar facilmente um erro de OOM ao exceder a memória alocada por padrão.
-
Demonstração de código de processamento eficiente
from odps.df import output
out_table = o.get_table('words')
df = o.get_table('word_split').to_df()

# Assume the following fields and types need to be returned
out_names = ["word", "count"]
out_types = ["string", "int"]

@output(out_names, out_types)
def handle(row):
    import jieba
    words = list(jieba.cut(row[0]))
    #
    # Processing logic to generate processed_data
    #
    yield processed_data
df.apply(handle, axis=1).persist(out_table.name)
Use o método apply para execução distribuída:
A lógica complexa fica na função handle. O sistema serializa automaticamente essa função para o lado do servidor para uso como UDF, onde ela é invocada e executada. Como a função handle também processa dados linha por linha durante a execução no servidor, a lógica permanece idêntica. A diferença é que, quando esse programa é enviado ao MaxCompute para execução, várias máquinas processam os dados simultaneamente, economizando muito tempo.
Chamar a interface persist grava os dados gerados diretamente em outra tabela do MaxCompute. Toda a geração e consumo de dados ocorrem dentro do cluster do MaxCompute, poupando recursos locais de rede e memória.
Este exemplo também usa um pacote de terceiros. O MaxCompute suporta pacotes de terceiros, como
jiebaneste caso, em UDFs. Portanto, não é preciso se preocupar com o custo de alterações no código. É possível aproveitar as capacidades de computação em larga escala do MaxCompute sem praticamente nenhuma mudança na lógica principal.
Limites
Devido a restrições de sandbox, alguns programas depurados localmente com o backend de computação pandas não podem ser depurados no MaxCompute.