Este tópico descreve as interfaces de programação do MapReduce compatíveis com o MaxCompute e seus limites.
O que é o MapReduce
O MapReduce é uma estrutura de computação distribuída clássica. Ele utiliza a abordagem de dividir para conquistar para fragmentar problemas grandes ou complexos em subproblemas menores e mais gerenciáveis. Após resolver esses subproblemas, o framework mescla os resultados para obter a solução final. Em comparação com as estruturas de programação paralela tradicionais, o MapReduce oferece vantagens como alta tolerância a falhas, facilidade de uso e boa extensibilidade. Ao implementar programas paralelos no MapReduce, você não precisa se preocupar com os detalhes subjacentes de um cluster distribuído, como armazenamento de dados ou mecanismos de comunicação entre nós. Isso simplifica a programação distribuída.
O fluxograma a seguir ilustra o fluxo de trabalho do MapReduce.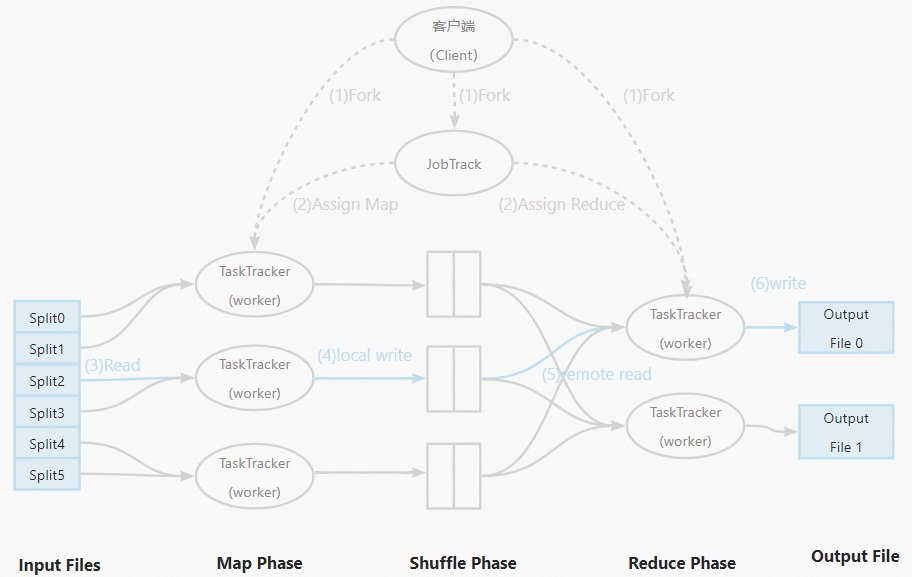
O MaxCompute oferece duas interfaces de programação para o MapReduce:
MaxCompute MapReduce: esta é a API nativa do MaxCompute. Esta versão apresenta execução rápida e simplifica o desenvolvimento, pois não expõe o sistema de arquivos.
MaxCompute extended MapReduce (MR2): esta versão aceita lógicas de agendamento de tarefas mais complexas, e sua implementação é consistente com a interface nativa do MaxCompute. Em comparação com o MapReduce tradicional, este modelo estendido altera os modelos subjacentes de agendamento e E/S para evitar operações de E/S redundantes durante a execução da tarefa.
Essas versões são praticamente consistentes em termos de Terms, Job Submission, Input and Output e Resource Usage, mas seus SDKs Java são diferentes. Para obter mais informações, consulte o Tutorial de Map/Reduce do Hadoop.
Não é possível usar o MapReduce para ler ou gravar dados em um foreign table.
MapReduce
Cenários
O MapReduce é compatível com os seguintes cenários:
Pesquisa: rastreamento web, índices invertidos e PageRank.
-
Análise de logs de acesso à web:
Análise e mineração do comportamento do usuário, como navegação e compras, para oferecer recomendações personalizadas.
Análise dos padrões de acesso dos usuários.
-
Análise estatística de textos:
Contagem de palavras e análise de frequência do termo e frequência inversa do documento (TF-IDF) em livros populares.
Análise estatística e de citações de artigos acadêmicos e documentos de patentes.
Análise de dados da Wikipédia.
Mineração de grandes volumes de dados, como dados não estruturados, espaço-temporais e de imagens.
Aprendizado de máquina: aprendizado supervisionado, não supervisionado e algoritmos de classificação, como árvores de decisão e máquinas de vetores de suporte (SVMs).
-
Processamento de linguagem natural (PLN):
Treinamento e previsão baseados em big data.
Construção de matrizes de coocorrência de palavras, mineração de conjuntos de itens frequentes e detecção de documentos duplicados com base em um corpus.
Recomendação de anúncios: previsão de taxas de cliques (CTRs) e taxas de conversão (CVRs).
Descrição do processo do MapReduce
Um programa MapReduce processa dados em dois estágios principais: o estágio de map, seguido pelo estágio de reduce. É possível definir a lógica de processamento para essas etapas, desde que respeitem as convenções do framework MapReduce. O fluxo completo de processamento de dados do MapReduce ocorre da seguinte forma:
Dados de entrada: antes da operação de map, os dados são particionados em blocos de tamanhos iguais. Cada bloco serve como entrada para um worker de map, o que permite a execução simultânea de vários workers.
-
Estágio de map: cada worker de map lê e processa o bloco de dados atribuído a ele e, em seguida, associa uma chave a cada registro de saída. Essa chave define qual worker de reduce receberá o registro.
NotaOs registros de dados com a mesma chave são enviados ao mesmo worker de reduce. Um único worker de reduce pode receber registros com chaves diferentes.
Fase de Shuffle: antes da fase de Reduce, o framework MapReduce classifica os dados por Key, agrupando aqueles que compartilham a mesma Key. Para usar o Combiner, especifique uma Combine Operation (Combiner), e o framework o acionará para agregar os dados com a mesma Key. A lógica do Combiner pode ser personalizada. No MaxCompute, diferentemente do protocolo clássico do MapReduce, os parâmetros de entrada e saída do Combiner devem ser idênticos aos da fase de Reduce. Esta etapa do processo também é conhecida como Shuffle.
Estágio de reduce: os registros com a mesma chave são encaminhados ao mesmo worker de reduce, que pode receber dados de múltiplos workers de map. Cada worker de reduce executa a operação de reduce nesses registros, convertendo-os em um único valor.
Dados de saída: os resultados finais são gerados.
Esta seção apresenta uma breve introdução ao framework MapReduce. Para mais detalhes, consulte Function Introduction.
A seção a seguir utiliza o exemplo WordCount para explicar os conceitos de cada estágio no MaxCompute MapReduce.
Considere um arquivo chamado a.txt em que cada linha contenha um único dígito. O objetivo é contar quantas vezes cada dígito aparece. Nesse contexto, cada dígito representa uma "palavra" (word), e a quantidade de ocorrências representa a "contagem" (count). Para atingir esse objetivo, o MaxCompute MapReduce segue o processo ilustrado na figura a seguir.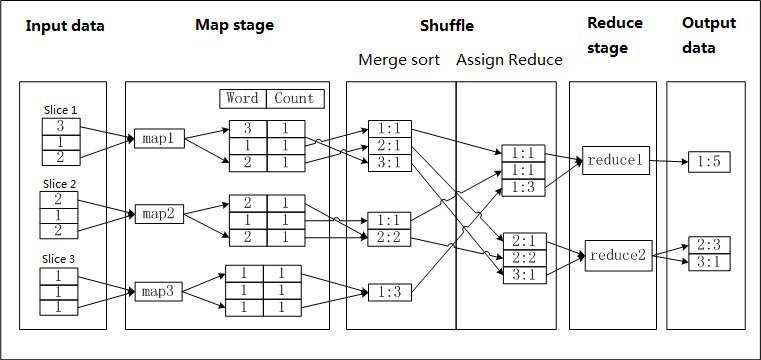
Procedure
Dados de entrada: o arquivo de texto é particionado, e os dados de cada partição servem como entrada para um worker de map.
Estágio de map: o worker de map processa a entrada. Para cada dígito recebido, ele define a contagem como 1 e gera um par <Word, Count>. A palavra atua como chave para os dados de saída.
Shuffle > Combine and sort: no estágio inicial do shuffle, a saída de cada worker de map é primeiro ordenada pela chave (a palavra). Após a ordenação, a operação de combiner é executada. As contagens da mesma chave (palavra) são agregadas para formar um novo par <Word, Count>. Esse processo é chamado de combine and sort.
Shuffle > Assign to reducers: no estágio tardio do shuffle, os dados são enviados aos reducers. Ao receber os dados, o worker de reduce os ordena novamente pela chave.
Estágio de reduce: cada worker de reduce processa os dados com a mesma lógica do combiner, agregando as contagens da mesma chave (palavra) para obter o resultado final.
Dados de saída.
Todos os dados do MaxCompute são armazenados em tabelas. Portanto, as entradas e saídas do MaxCompute MapReduce devem ser tabelas. Não é possível especificar o formato de saída, e não há interfaces semelhantes às de um sistema de arquivos.
Limites
Para consultar os limites do MapReduce, veja Limits summary.
Para verificar os limites da execução local do MapReduce, consulte Differences between running locally and in a distributed environment.
Extended MapReduce (MR2)
Em comparação com o MapReduce nativo do MaxCompute, a escrita de funções como Map e Reduce no MR2 é praticamente idêntica. A principal diferença reside na execução das tarefas. Para ver um exemplo, consulte Pipeline Example.
Contexto do modelo MR2
O modelo tradicional do MapReduce exige que os dados resultantes de cada rodada de operações sejam armazenados em um sistema de arquivos distribuído, como o Hadoop Distributed File System (HDFS) ou uma tabela do MaxCompute. Um fluxo de trabalho do MapReduce geralmente engloba múltiplas tarefas. Após a conclusão de cada uma, os dados intermediários precisam ser gravados em disco. Contudo, uma tarefa de map subsequente pode precisar ler esses dados apenas uma vez antes da próxima fase de shuffle, o que gera operações de E/S de disco redundantes.
As lógicas de computação e agendamento do MaxCompute aceitam modelos de programação mais complexos. Para resolver esse problema, o MaxCompute permite executar uma operação de reduce diretamente após outra, sem a necessidade de uma operação de map intermediária. Assim, o MaxCompute disponibiliza um modelo estendido de MapReduce que aceita o encadeamento de múltiplas operações de reduce após uma operação de map, no formato Map > Reduce > Reduce.
Comparação com o Chain Mapper e ChainReducer do Hadoop
O Chain Mapper e o ChainReducer do Hadoop também aceitam operações serializadas de map ou reduce semelhantes. No entanto, diferem fundamentalmente do modelo estendido de MapReduce (MR2) do MaxCompute.
O Chain Mapper e o ChainReducer baseiam-se no modelo tradicional do MapReduce e permitem apenas a adição de uma ou mais operações de map após a operação original de map ou reduce, sem a possibilidade de incluir uma operação de reduce. A vantagem dessa abordagem é a reutilização da lógica de negócios do mapper existente para dividir uma operação de map ou reduce em vários estágios de mapper. Entretanto, isso não altera de forma estrutural os modelos subjacentes de agendamento e E/S.