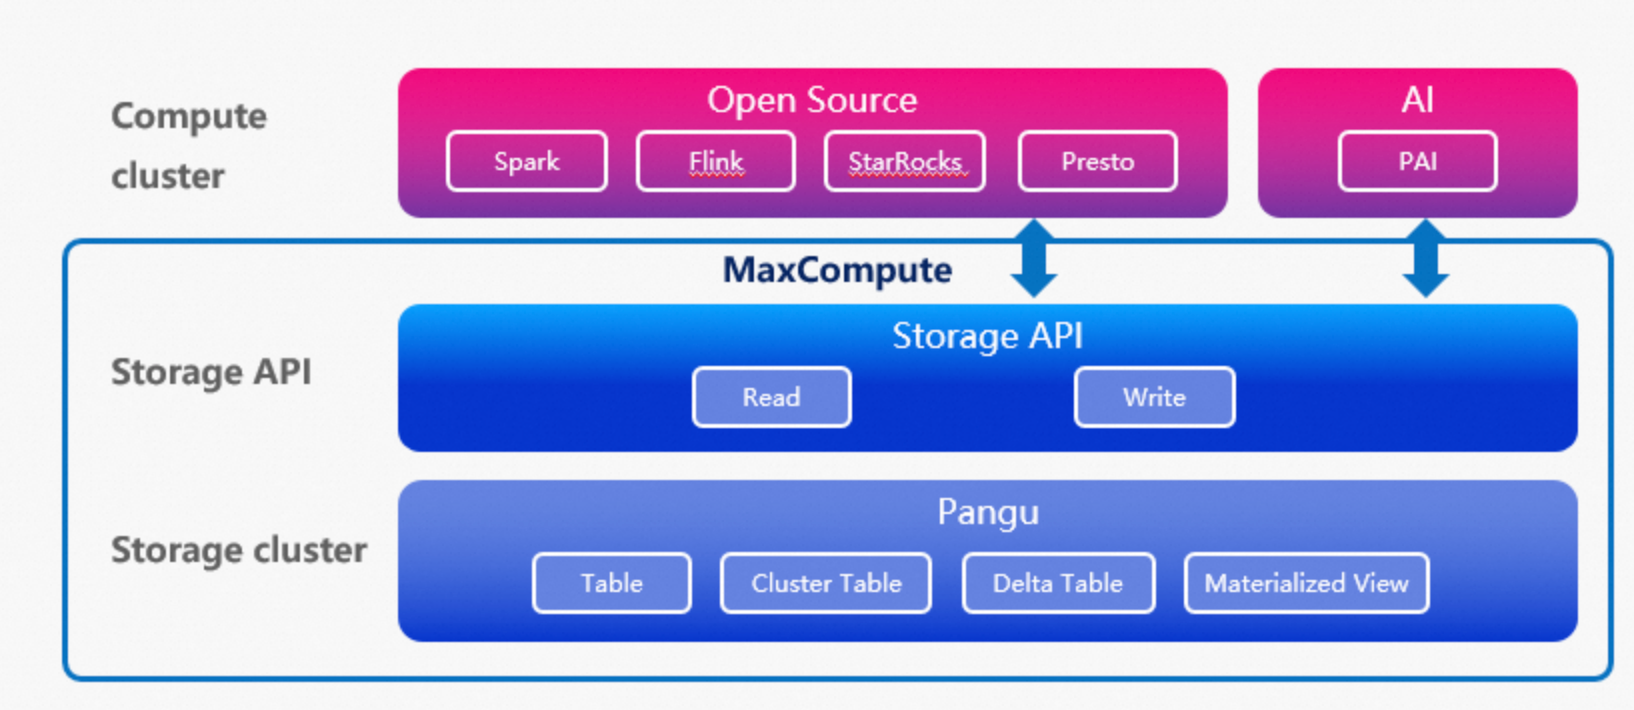
A Storage API (também chamada de Open Storage) concede a mecanismos de computação de terceiros acesso direto de leitura ao armazenamento subjacente do MaxCompute. Essa API oferece um método eficiente, seguro e de baixa latência para acesso a dados. Mecanismos como Apache Spark, StarRocks, Presto e Apache Flink conectam-se por meio de um conector, eliminando a necessidade de exportar dados e reduzindo a latência de acesso.
Como funciona
Um mecanismo de computação de terceiros conecta-se ao MaxCompute por meio de um conector que chama a Storage API. A API expõe as tabelas do MaxCompute com semântica padrão, permitindo que os mecanismos leiam dados colunares diretamente do armazenamento sem mover dados para fora do MaxCompute.
Principais recursos:
Alto throughput: Suporta leituras colunares eficientes, pushdown de predicados e o formato de dados Apache Arrow.
Segurança e facilidade de uso: Aplica isolamento de projeto, controle de acesso e criptografia de dados na camada de armazenamento, sem expor detalhes internos do armazenamento ao chamador.
Integração com ecossistema: O Spark on EMR e o StarRocks oferecem conectores dedicados para acesso direto ao MaxCompute.
Casos de uso
A Storage API é ideal para cargas de trabalho que exigem acesso de múltiplos mecanismos aos mesmos dados, sem duplicação:
Análise entre mecanismos: Execute consultas Spark, StarRocks ou Presto diretamente em tabelas do MaxCompute, sem precisar exportar os dados previamente.
Flexible framework switching: Alterne entre frameworks de computação conforme as necessidades de processamento, mantendo os dados centralizados em um único local.
Limitações
Tipos de tabela suportados e não suportados
Mecanismos de terceiros podem ler os seguintes tipos de tabela por meio da Storage API:
Tabelas padrão
Tabelas particionadas
Tabelas clusterizadas
Delta Tables
Visualizações materializadas
Os seguintes tipos de tabela não são suportados:
Tabelas externas
Visualizações lógicas
Tipos de dados não suportados
A leitura de dados do tipo JSON não é suportada.
Limites de throughput (pagamento conforme o uso)
|
Limite |
Valor |
|
Solicitações simultâneas por tenant |
1.000 |
|
Taxa de transmissão por solicitação simultânea |
10 MB/s |
Recursos de transmissão de dados
Para executar tarefas de transmissão de dados, utilize grupos de recursos exclusivos do Data Transmission Service (DTS). Os grupos de recursos do DTS utilizam o modelo de faturamento por assinatura, em que as cobranças são baseadas no número de instâncias simultâneas adquiridas.
Recurso | Faturamento | Regiões suportadas | Guia de configuração |
Taxas de assinatura para recursos exclusivos de transmissão de dados | Assinatura — cobrança por instância simultânea |
| Adquirir e usar um grupo de recursos exclusivo para o Data Transmission Service |
Para monitorar o uso, acesse a página Resource Observation. Para mais informações, consulte Resource Observation.
Mapeamento de tipos de dados Arrow
A Storage API utiliza o Apache Arrow como formato de dados em memória para transmissão. Os dados gravados por meio da Storage API não passam por processamento adicional — chaves duplicadas em colunas MAP são mantidas exatamente como foram inseridas.
Os tipos TIMESTAMP e INTERVAL_DAY_TIME estão sujeitos a perda de precisão. Valores TIMESTAMP fora do intervalo do TimestampType do Arrow têm a parte de alta precisão truncada. O tipo INTERVAL_DAY_TIME (precisão de nanossegundos) é truncado para milissegundos.
A tabela a seguir mapeia os tipos do MaxCompute para seus equivalentes no Arrow.
|
Tipo MaxCompute |
Tipo Arrow |
Observações |
|
TINYINT |
Int8Type |
|
|
SMALLINT |
Int16Type |
|
|
INT |
Int32Type |
|
|
BIGINT |
Int64Type |
|
|
FLOAT |
FloatType |
|
|
DOUBLE |
DoubleType |
|
|
BOOLEAN |
BooleanType |
|
|
DECIMAL |
Decimal128Type |
Leitura: convertido para |
|
DECIMAL(precision, scale) |
Decimal128Type |
|
|
STRING |
StringType |
|
|
BINARY |
BinaryType |
|
|
VARCHAR |
StringType |
|
|
CHAR |
StringType |
|
|
DATETIME |
TimestampType |
Unidade de tempo: milissegundos. Fuso horário: UTC. |
|
TIMESTAMP |
TimestampType |
Unidade de tempo: nanossegundos. Fuso horário: UTC. Suporta um intervalo de valores mais amplo; dados além da faixa de precisão do Arrow são truncados. |
|
DATE |
Date32Type |
|
|
INTERVAL_DAY_TIME |
DayTimeIntervalType |
Precisão do MaxCompute: nanossegundos. Precisão do Arrow: milissegundos. A parte em nanossegundos é truncada na leitura e na gravação. |
|
INTERVAL_YEAR_MONTH |
MonthIntervalType |
|
|
ARRAY |
ListType |
|
|
MAP |
MapType |
Chaves duplicadas são mantidas na gravação. Na consulta, o mecanismo SQL aplica a regra "última gravação vence" (exemplo: gravar |
|
STRUCT |
StructType |
|
|
JSON |
StringType |
Não suportado: A leitura de dados JSON por meio da Storage API não é suportada. |
Próximos passos
Acesse o MaxCompute usando um conector:
Acesse o MaxCompute usando um SDK: