O MaxCompute fornece a Storage API para melhorar a integração com o ecossistema de big data e permitir que mecanismos externos acessem dados no MaxCompute. Os principais mecanismos de computação de terceiros podem chamar a Storage API para acessar diretamente o armazenamento subjacente do MaxCompute. Isso melhora significativamente a eficiência do acesso e da interação com os dados.
Visão geral
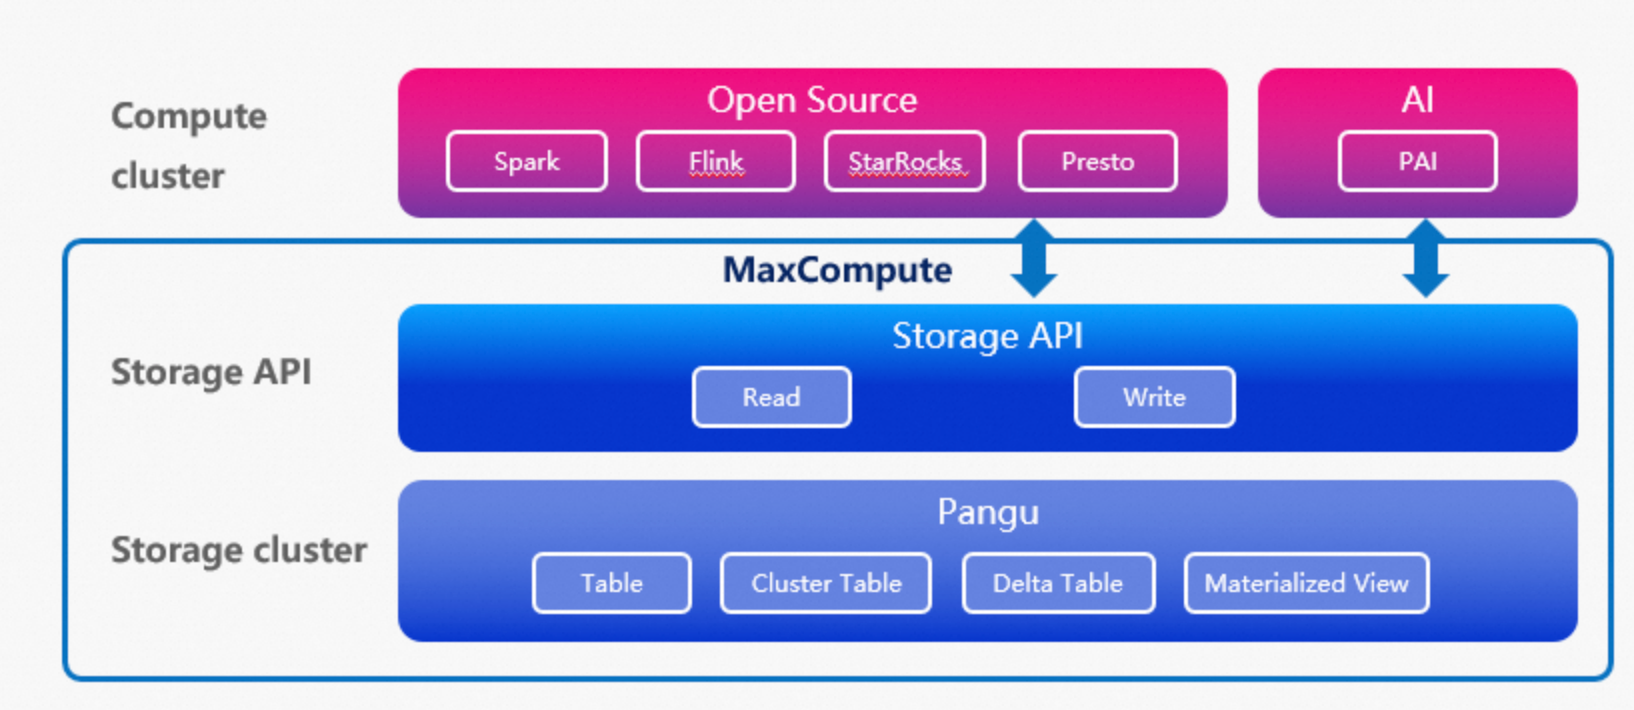
A Storage API é uma interface de service de dados que fornece um método eficiente, de baixa latência e seguro para acesso de dados. Ela permite que mecanismos de computação de terceiros populares acessem o sistema de armazenamento do MaxCompute. Isso melhora a integração e a eficiência do processamento de dados entre o MaxCompute e mecanismos de computação de open source ou de machine learning. Mecanismos como Spark, StarRocks, Presto e Flink podem usar um conector para acessar diretamente os dados armazenados no MaxCompute. Isso simplifica o uso dos dados e melhora o desempenho de acesso. A arquitetura é ilustrada na figura a seguir.
Casos de uso
A Storage API é ideal para cenários que exigem acesso a dados e computação com múltiplos mecanismos. Caso empresas ou desenvolvedores precisem alternar com flexibilidade entre frameworks de computação ou usar recursos específicos de mecanismos para processar dados no MaxCompute, a Storage API atua como uma ponte para facilitar a troca de dados e viabilizar o processamento diversificado.
Principais recursos
Alto throughput: a Storage API suporta leitura eficiente de dados colunares, pushdown de predicados para filtragem de dados antes da transmissão e o formato de dados Arrow.
Segura e fácil de usar: oferece acesso direto de leitura ao armazenamento subjacente com semântica de tabela. Isso abstrai as complexidades do armazenamento e, ao mesmo tempo, respeita políticas de segurança como isolamento de projeto, controle de acesso e criptografia de dados.
Integração com o ecossistema: o Spark on EMR e o StarRocks podem usar um conector para acessar diretamente os dados no MaxCompute. Isso simplifica a integração dos mecanismos de computação.
Notas de uso
Mecanismos de terceiros que acessam o MaxCompute podem ler tabelas padrão, tabelas particionadas, tabelas clusterizadas, Delta Tables e materialized views. No entanto, não podem ler tabelas externas ou logical views no MaxCompute.
Não há suporte para leitura de dados do tipo JSON.
Para a Storage API com pagamento conforme o uso, o limite é de 1.000 requisições simultâneas por tenant, e a taxa de transmissão é de 10 MB/s por requisição simultânea.
Recursos de transmissão de dados
Ao usar um mecanismo de terceiros com a Storage API do MaxCompute para tarefas de transmissão de dados, utilize grupos de recursos exclusivos do Data Transmission Service (assinatura). A tabela a seguir descreve os recursos.
|
Nome do grupo de recursos |
Descrição do faturamento |
Regiões com suporte |
Instruções de uso |
|
Este grupo de recursos utiliza o método de faturamento por assinatura. A cobrança ocorre com base no número de instâncias simultâneas adquiridas. |
|
Purchase and use an exclusive resource group for Data Transmission Service |
Na página Resource Observation, visualize os detalhes de uso dos grupos de recursos exclusivos para o Data Transmission Service (assinatura). Para mais informações, consulte Resource Observation.
Exemplos
-
Acesse o MaxCompute por meio de um conector. Para mais informações, consulte os tópicos a seguir:
-
Acesse o MaxCompute por meio de um SDK. Para mais informações, consulte os tópicos a seguir:
Mapeamento de tipos de dados Arrow
A Storage API do MaxCompute utiliza tipos de dados Apache Arrow para garantir uma representação eficiente e estruturada dos dados durante o armazenamento e a transmissão. Ao gravar dados com a Storage API do MaxCompute, o sistema não computa nem processa as informações. Por exemplo, o sistema não remove chaves duplicadas dos dados do tipo Map. A estrutura de dados original é mantida, a menos que o mecanismo de armazenamento possua restrições específicas.
A tabela a seguir descreve os mapeamentos entre os tipos de dados do MaxCompute e do Apache Arrow.
|
Tipo de dados do MaxCompute |
Tipo de dados do Arrow |
|
TINYINT |
Int8Type |
|
SMALLINT |
Int16Type |
|
INT |
Int32Type |
|
BIGINT |
Int64Type |
|
FLOAT |
FloatType |
|
DOUBLE |
DoubleType |
|
BOOLEAN |
BooleanType |
|
DECIMAL |
Decimal128Type Nota
A precisão do tipo DECIMAL do MaxCompute é maior que a do Decimal128Type da Storage API.
|
|
DECIMAL(precision, scale) |
Decimal128Type |
|
STRING |
StringType |
|
BINARY |
BinaryType |
|
VARCHAR |
StringType |
|
CHAR |
StringType |
|
DATETIME |
TimestampType[1] A unidade de tempo é milissegundos, e o fuso horário é UTC. |
|
TIMESTAMP |
TimestampType[2] A unidade de tempo é nanossegundos, e o fuso horário é UTC. Nota
O tipo TIMESTAMP suporta um intervalo de valores mais amplo. Se você usar a Storage API para ler ou gravar dados TIMESTAMP fora do intervalo de precisão do TimestampType, o sistema truncará a parte de alta precisão do valor, causando perda de precisão. |
|
DATE |
Date32Type |
|
INTERVAL_DAY_TIME |
DayTimeIntervalType Nota
O tipo INTERVAL_DAY_TIME tem precisão de nanossegundos, enquanto o tipo DayTimeIntervalType da Storage API tem precisão de milissegundos. Se você usar a Storage API para ler ou gravar dados INTERVAL_DAY_TIME, o sistema truncará a parte dos nanossegundos, causando perda de precisão. |
|
INTERVAL_YEAR_MONTH |
MonthIntervalType |
|
ARRAY |
ListType |
|
MAP |
MapType Nota
Se um MAP contiver chaves duplicadas:
Por exemplo, se você gravar os dados brutos |
|
STRUCT |
StructType |
|
JSON |
StringType |