Este documento descreve como utilizar a função de IA do MaxFrame no Alibaba Cloud MaxCompute e apresenta casos de uso para iniciar aplicações de inferência offline com modelos de linguagem de grande porte.
Visão geral
A função de IA do MaxFrame é uma solução ponta a ponta para inferência offline de modelos de linguagem de grande porte (LLM) na plataforma Alibaba Cloud MaxCompute. Ela integra perfeitamente o processamento de dados às capacidades de IA, simplificando a adoção de modelos de linguagem corporativos.
Filosofia de design: "Dados entram, resultados saem." Esse conceito permite usar o framework Python MaxFrame e APIs no estilo pandas para concluir todo o fluxo de trabalho — desde a preparação e o processamento de dados até a inferência do modelo e o armazenamento dos resultados — inteiramente dentro do ecossistema MaxCompute.
Casos de uso: Esta função é ideal para processar grandes volumes de dados estruturados, como em análises de logs e registros de comportamento de usuários, além de dados não estruturados para tarefas como tradução de texto, resumo de documentos e vetorização. É possível processar dados na escala de petabytes em um único job, obtendo baixa latência e escalabilidade linear por meio da arquitetura de computação distribuída. Utilize-a para extrair informações estruturadas de textos, organizar e resumir conteúdos, gerar resumos, traduzir idiomas, avaliar a qualidade textual e classificar sentimentos. Isso simplifica significativamente o processamento de dados para modelos de linguagem e melhora a qualidade dos resultados.
-
Arquitetura
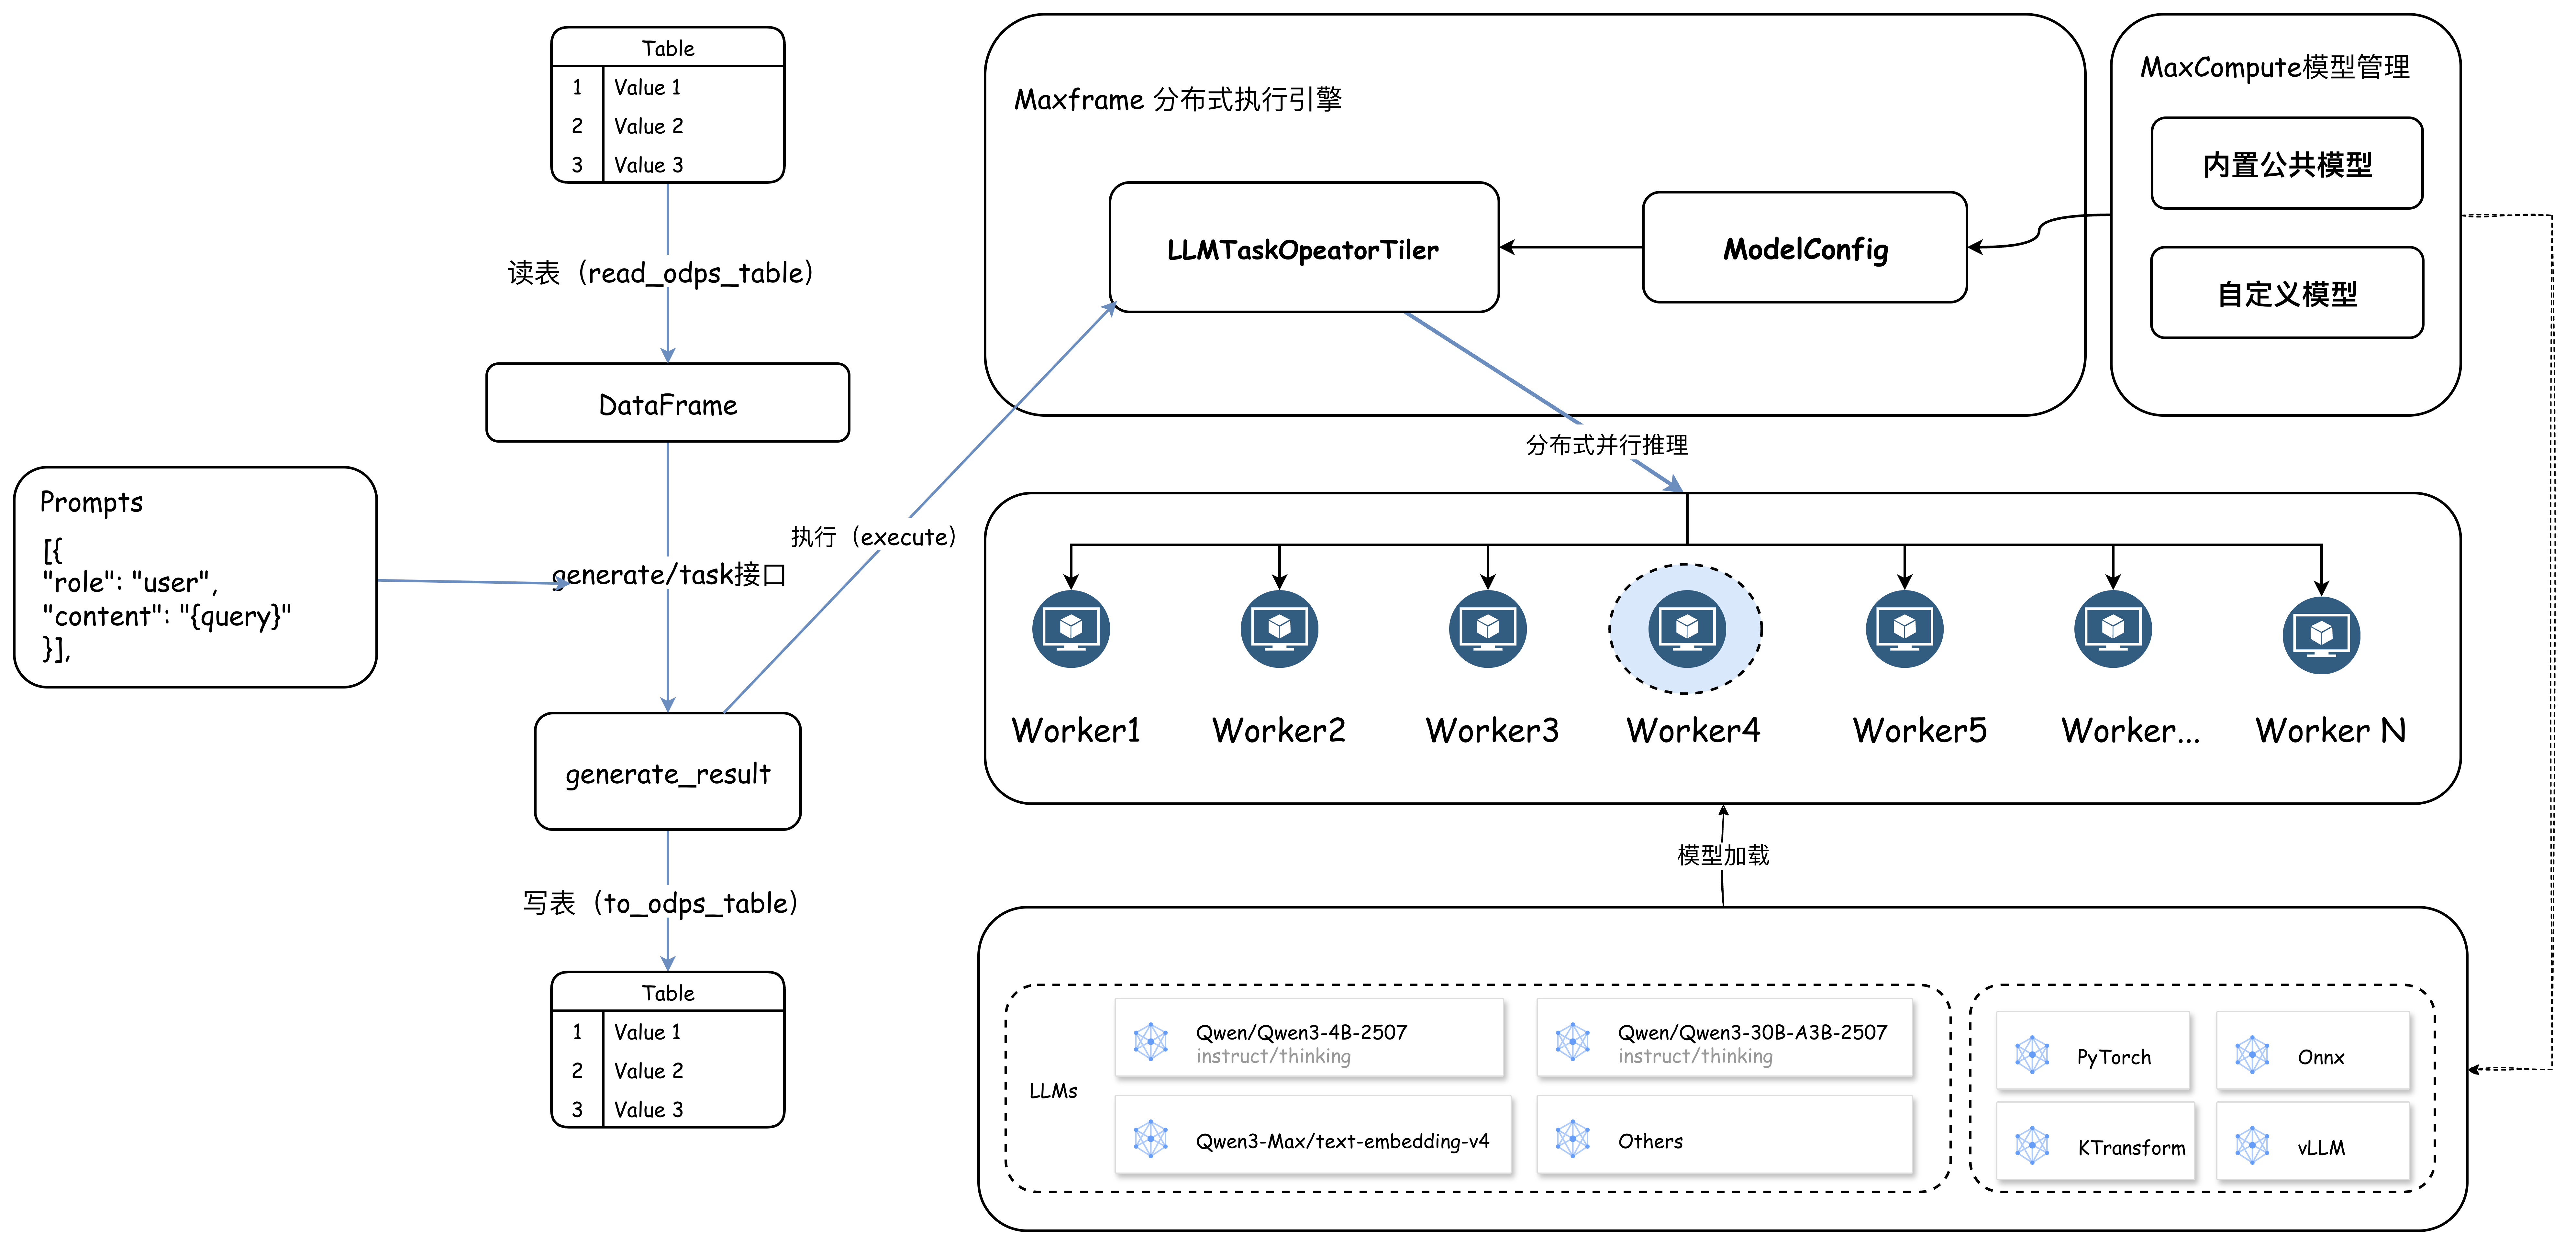
A função de IA do MaxFrame oferece uma interface
generateflexível e de uso geral, além de interfacestaskconcisas e específicas para cenários como tradução de texto, extração de dados estruturados e vetorização. Selecione um modelo e forneça uma tabela do MaxCompute e prompts como entrada.Ao chamar uma interface, o MaxFrame executa primeiro o particionamento dos dados na tabela de entrada. Defina um nível adequado de concorrência com base no volume de dados e inicie um grupo de workers para executar o job de computação. Cada worker utiliza o modelo de prompt fornecido para renderizar e construir as entradas do modelo a partir das linhas de dados, executa o job de inferência e grava os resultados e o status de sucesso de volta no MaxCompute.
A figura a seguir ilustra a arquitetura e o fluxo de trabalho.
-
Principais vantagens:
Facilidade de uso: APIs Python familiares, biblioteca de modelos pronta para uso e custo zero de implantação.
Escalabilidade: Aproveita recursos de cota CU, cota GU e Inference Quota do MaxCompute para suportar processamento paralelo em larga escala e aumentar o throughput geral de tokens.
Integração de dados e IA: Conclua todo o fluxo de trabalho, desde a leitura e o processamento de dados até a inferência de IA e o armazenamento de resultados, em uma única plataforma. Essa abordagem reduz custos de migração de dados e aumenta a eficiência do desenvolvimento.
Ampla cobertura de cenários: Abrange mais de 10 casos de uso comuns, incluindo tradução, extração de dados estruturados e vetorização.
Requisitos
-
Regiões suportadas:
China (Hangzhou), China (Shanghai), China (Beijing), China (Ulanqab), China (Shenzhen), China (Chengdu), China (Hong Kong), China (Hangzhou) Finance Cloud e China (Shanghai) Finance Cloud.
Versão do Python suportada: 3.11.
-
Versão do SDK suportada: Certifique-se de que sua versão do MaxFrame SDK seja 2.7.1 ou posterior. Verifique a versão executando um dos seguintes comandos:
// For Windows
pip list | findstr maxframe

// For Linux
pip list | grep maxframe
Caso sua versão esteja desatualizada, execute
pip install --upgrade maxframepara atualizar para a versão mais recente.
Modelos suportados
O MaxFrame oferece suporte pronto para uso a uma série de modelos de linguagem de grande porte integrados, incluindo Qwen 3, DeepSeek-R1-Distill-Qwen e Qwen3-embedding. Também permite chamar modelos comerciais principais do Model Studio, como os modelos multimodais qwen3.7-max, qwen3.6-plus, qwen3.6-flash, deepseek-v4-pro, deepseek-v4-flash e qwen3-vl-embedding, além do modelo de texto text-embedding-v4. Todos os modelos são hospedados offline na plataforma MaxCompute. Isso elimina a necessidade de gerenciar downloads de modelos, distribuição ou limites de concorrência de API. Utilize os modelos por meio de chamadas de API simples, aproveitando os vastos recursos de computação do MaxCompute para concluir tarefas de inferência offline com alto throughput geral de tokens e concorrência.
Modelos suportados
Tipo de modelo | Nome do modelo | Cota |
Modelos comerciais do Model Studio |
|
|
Modelos open-source da série Qwen 3 |
|
|
Modelos open-source Qwen Embedding |
|
|
Modelos open-source da série Deepseek-R1-Distill-Qwen |
|
|
Modelos open-source Deepseek-R1-0528-Qwen3 |
|
|
Tipos de recursos de cota
O MaxFrame suporta três tipos de recursos, permitindo que você escolha a opção mais adequada ao tamanho do seu modelo e aos requisitos do negócio.
Recursos de cota CU
Uma Unidade de Computação (CU) é um recurso de computação CPU de uso geral (1 vCPU e 4 GB de memória), adequado para modelos pequenos e tarefas de inferência em pequena escala.
Configuração:
# Use CU quota compute resources.
options.session.quota_name = "mf_cpu_quota"
Recursos de cota GU
Uma Unidade de GPU (GU) é um recurso de computação GPU otimizado para inferência de LLM. Suporta modelos maiores e é adequada para tarefas de inferência com modelos de 8B parâmetros ou mais.
Configuração:
# Use GU quota compute resources.
options.session.gu_quota_name = "mf_gpu_quota"
Recursos de Inference Quota (faturamento baseado em tokens)
Esta opção permite chamar modelos de linguagem de grande porte comerciais do Model Studio, como qwen3-max e text-embedding-v4. O faturamento baseia-se no consumo real de tokens. Essa abordagem elimina a necessidade de provisionar recursos CU ou GU e gerenciar a infraestrutura subjacente, oferecendo uma solução flexível, prática e econômica.
Referência da API
A função de IA do MaxFrame fornece duas interfaces para equilibrar flexibilidade e facilidade de uso: a interface generate de uso geral e as interfaces task específicas para tarefas.
Geral: generate
A interface generate
Parâmetros principais
|
Parâmetro |
Obrigatório |
Descrição |
|
model_name |
Sim |
Nome do modelo a ser utilizado. |
|
df |
Sim |
Texto ou dados a serem analisados, encapsulados em um DataFrame. |
|
prompt_template |
Sim |
Lista de mensagens compatíveis com o formato de mensagem de chat da OpenAI. Use a sintaxe |
Específico para tarefas: task
Interface específica para cenários: Task
Interfaces de tarefas predefinidas e padronizadas simplificam o desenvolvimento para casos de uso comuns. As interfaces task suportadas atualmente incluem translate, extract e embed.
-
Parâmetros principais
Parâmetro
Obrigatório
Descrição
model_name
Sim
Nome do modelo a ser utilizado.
df
Sim
Texto ou dados a serem analisados, encapsulados em um DataFrame.
task interface
Sim
translate: realiza tradução de idiomas.extract: executa extração de dados estruturados.embed: efetua vetorização.
-
Exemplo de uso
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="<model_name>")

# Translate text.
translated_df = llm.translate(
    df["english_column"],
    source_language="english",
    target_language="Chinese",
    examples=[("Hello", "你好"), ("Goodbye", "再见")],
)

translated_df.execute()
Casos de uso
Cota GU
Cenários de cota GU
Tradução de idiomas
Cenário: Uma multinacional precisa traduzir 100.000 contratos do inglês para o chinês e anotar cláusulas principais.
import os
import maxframe.dataframe as md
from maxframe import new_session
from maxframe.config import options
from maxframe.udf import with_running_options
from odps import ODPS

options.dag.settings = {
    "engine_order": ["DPE", "MCSQL"]
}

o = ODPS(
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_ID'),
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_SECRET'),
    project='your-default-project',
    endpoint='your-end-point',
)

# Initialize the MaxFrame session.
session = new_session(o)

# Print the Logview URL for the job.
print(session.get_logview_address())

# 1. Use GU quota compute resources.
options.session.gu_quota_name = "mf_gu_quota"

# 2. Use the Qwen3-1.7B model.
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="Qwen3-1.7B")

# 3. Prepare the data. You can skip this step if you already have data.
# o.execute_sql("""
#   CREATE TABLE IF NOT EXISTS raw_contracts (
#       en STRING
#   );
#   """)
#
# o.execute_sql("""
#   INSERT INTO raw_contracts VALUES
#   ('This agreement is governed by the laws of the State of California.'),
#   ('The tenant shall pay rent on the first day of each month.'),
#   ('Either party may terminate this contract with 30 days written notice.'),
#   ('All intellectual property rights shall remain with the original owner.'),
#   ('The warranty period for this product is twelve months from the date of purchase.');
#   """)

df = md.read_odps_table("raw_contracts")

# 4. Define the prompt template.
messages = [
    {
        "role": "system",
        "content": "You are a document translation expert who can fluently translate English text into Chinese.",
    },
    {
        "role": "user",
        "content": "Translate the following English text into Chinese. Output only the translated text, with no other content.\n\n Example:\nInput: Hi\nOutput: 你好。\n\n Text to translate:\n\n{en}",
    },
]

# 5. Call the `generate` interface, define the prompt, and reference the corresponding data column.
result_df = llm.generate(
    df,
    prompt_template=messages,
    params={
        "temperature": 0.7,
        "top_p": 0.8,
    },
).execute()

# 6. Write the results to a MaxCompute table.
result_df.to_odps_table("raw_contracts_result")
Extração de palavras-chave
Cenário: Este caso de uso demonstra como a função de IA do MaxFrame processa dados não estruturados. Grande parte desses dados consiste em texto e imagens, o que representa desafios significativos para a análise de big data. O exemplo a seguir mostra como usar a função de IA para simplificar esse processo.
O código abaixo demonstra como utilizar a função de IA para extrair a experiência profissional de um candidato a partir de um currículo. O exemplo usa texto de currículo gerado aleatoriamente como entrada. Para práticas detalhadas de desenvolvimento e demonstrações, consulte AI Function on GU Development Practices.
import maxframe.dataframe as md
from maxframe import new_session
from maxframe.config import options
from maxframe.udf import with_running_options
from odps import ODPS

options.dag.settings = {
    "engine_order": ["DPE", "MCSQL"]
}

o = ODPS(
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_ID'),
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_SECRET'),
    project='your-default-project',
    endpoint='your-end-point',
)

# Initialize the MaxFrame session.
session = new_session(o)

# Print the Logview URL for the job.
print(session.get_logview_address())

# 1. Use GU quota compute resources.
options.session.gu_quota_name = "mf_gu_quota"

# 2. Use the Qwen3-4B model.
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="Qwen3-4B-Instruct-2507-FP8")

df = md.read_odps_table("traditional_chinese_medicine", index_col="index")

# Specify four concurrent partitions.
parallel_partitions = 4
df = df.mf.rebalance(num_partitions=parallel_partitions)

# 3. Use the preset `extract` task interface.
result_df = llm.extract(
    df["text"],
    description="Please extract structured data from the following medical record in order. Return the final output in strict JSON format according to the schema.",
    schema=MedicalRecord,
    examples=[(example_input, example_output)],
)
result_df.execute()
Cota de inferência
Cenários de cota de inferência
Vetorização de texto: text-embedding-v4
Cenário: Utilize o modelo comercial text-embedding-v4 do Model Studio para realizar tarefas de vetorização. O faturamento baseia-se no consumo de tokens, eliminando a necessidade de gerenciar recursos de computação subjacentes. Este cenário é adequado para análise complexa de texto e tarefas de inferência de alta qualidade que exigem modelos grandes ou modelos de linguagem comerciais do Model Studio.
Compreensão de imagem: qwen3.6-plus
Cenário: Indicado para inferência de alta qualidade, análise complexa de texto ou tarefas de processamento de dados multimodais que exigem modelos grandes ou modelos de linguagem comerciais do Model Studio. Os recursos são consumidos sob demanda, ajudando no controle de custos.
Otimização de desempenho
Inferência paralela
O MaxFrame utiliza computação paralela para executar inferência offline em escala:
Particionamento de dados: A interface
rebalancedistribui a tabela de dados de entrada uniformemente entre vários nós workers com base no número especificado de partições (num_partitions).Carregamento paralelo de modelos: Cada worker carrega e pré-aquece o modelo independentemente. Isso evita latência de inicialização a frio causada pelo carregamento do modelo.
Agregação de resultados: Os resultados de saída são gravados em uma tabela do MaxCompute por partição, o que suporta análises de dados subsequentes.
Recomendações de ajuste
-
Alternância de recursos de computação heterogênea
Para modelos grandes (8B parâmetros ou mais), a inferência via CPU é ineficiente. Recomendamos alternar para recursos de cota GU ou Inference Quota para realizar a inferência.
-
Processamento paralelo de partições de dados
Em jobs de inferência em larga escala, utilize a interface
rebalancepara particionar os dados e permitir o processamento paralelo com base na sua distribuição de dados.