Este tópico descreve como escrever uma função de agregação definida pelo usuário (UDAF) em Java.
Estrutura do código UDAF
Escreva uma UDAF Java no IntelliJ IDEA com Maven ou MaxCompute Studio. O código deve incluir os seguintes componentes:
-
Pacote Java: Opcional.
Agrupe as classes Java definidas para facilitar a localização e a reutilização.
-
Classes e anotações obrigatórias: Obrigatório.
Importe a classe
com.aliyun.odps.udf.Aggregatore use a anotação@Resolve(com.aliyun.odps.udf.annotation.Resolve). A classecom.aliyun.odps.udf.UDFExceptioné opcional e serve para tratamento de erros. Caso precise usar outras classes relacionadas à UDAF ou tipos de dados complexos, importe as classes necessárias conforme descrito em Overview of MaxCompute UDFs. -
Anotação
@Resolve: Obrigatória.O formato é
@Resolve(<signature>), em quesignaturerepresenta a assinatura da função e define os tipos de dados dos parâmetros de entrada e do valor de retorno. A assinatura de uma UDAF não pode ser determinada por reflexão; obtenha-a apenas por meio da anotação@Resolve, como em@Resolve("smallint->varchar(10)"). Para mais informações sobre a anotação@Resolve, consulte @Resolve annotation. -
Classe Java personalizada: Obrigatória.
Esta classe atua como unidade organizacional do código da UDAF e define as variáveis e os métodos que implementam a lógica de negócio.
-
Métodos da classe Java: Obrigatórios.
Estenda a classe
com.aliyun.odps.udf.Aggregatorna sua classe Java e implemente os seguintes métodos.import com.aliyun.odps.udf.ContextFunction; import com.aliyun.odps.udf.ExecutionContext; import com.aliyun.odps.udf.UDFException; public abstract class Aggregator implements ContextFunction { // The initialization method. @Override public void setup(ExecutionContext ctx) throws UDFException { } // The termination method. @Override public void close() throws UDFException { } // Creates an aggregation buffer. abstract public Writable newBuffer(); // The iterate method. // buffer is an aggregation buffer that holds intermediate, summarized data. In map tasks, it aggregates data for a group, and this method is executed once for each row. // Writable[] represents a row of data, which refers to the input columns in the code. For example, writable[0] refers to the first column, and writable[1] refers to the second column. // args are the parameters specified when calling the UDAF in SQL. The args array itself cannot be null, but its elements can be null, which indicates that the corresponding input data is null. abstract public void iterate(Writable buffer, Writable[] args) throws UDFException; // The terminate method. abstract public Writable terminate(Writable buffer) throws UDFException; // The merge method. abstract public void merge(Writable buffer, Writable partial) throws UDFException; }Os métodos
iterate,mergeeterminateconstituem o núcleo da lógica principal de uma UDAF. Implemente também um buffer gravável personalizado.Um buffer gravável converte objetos em memória em uma sequência de bytes (ou outro protocolo de transferência de dados) para viabilizar a persistência em disco e a transmissão pela rede. Como o MaxCompute usa computação distribuída para processar funções de agregação, ele precisa serializar e desserializar dados para transferi-los entre workers.
Ao escrever uma UDAF Java, use tipos Java ou tipos Java Writable. Para obter detalhes sobre o mapeamento entre os tipos de dados suportados pelo MaxCompute e os tipos Java, consulte Data types.
O código abaixo apresenta um exemplo de UDAF.
// Package the defined Java class in org.alidata.odps.udaf.examples.
package org.alidata.odps.udaf.examples;
// Import the required base classes.
import java.io.DataInput;
import java.io.DataOutput;
import java.io.IOException;
import com.aliyun.odps.io.DoubleWritable;
import com.aliyun.odps.io.Writable;
import com.aliyun.odps.udf.Aggregator;
import com.aliyun.odps.udf.UDFException;
import com.aliyun.odps.udf.annotation.Resolve;
// Define the custom Java class.
// Specify the @Resolve annotation.
@Resolve("double->double")
public class AggrAvg extends Aggregator {
// Implement the methods for the Java class.
  private static class AvgBuffer implements Writable {
    private double sum = 0;
    private long count = 0;
    @Override
    public void write(DataOutput out) throws IOException {
      out.writeDouble(sum);
      out.writeLong(count);
    }
    @Override
    public void readFields(DataInput in) throws IOException {
      sum = in.readDouble();
      count = in.readLong();
    }
  }
  private DoubleWritable ret = new DoubleWritable();
  @Override
  public Writable newBuffer() {
    return new AvgBuffer();
  }
  @Override
  public void iterate(Writable buffer, Writable[] args) throws UDFException {
    DoubleWritable arg = (DoubleWritable) args[0];
    AvgBuffer buf = (AvgBuffer) buffer;
    if (arg != null) {
      buf.count += 1;
      buf.sum += arg.get();
    }
  }
  @Override
  public Writable terminate(Writable buffer) throws UDFException {
    AvgBuffer buf = (AvgBuffer) buffer;
    if (buf.count == 0) {
      ret.set(0);
    } else {
      ret.set(buf.sum / buf.count);
    }
    return ret;
  }
  @Override
  public void merge(Writable buffer, Writable partial) throws UDFException {
    AvgBuffer buf = (AvgBuffer) buffer;
    AvgBuffer p = (AvgBuffer) partial;
    buf.sum += p.sum;
    buf.count += p.count;
  }
}No código da UDAF anterior, o buffer nos métodos iterate e merge é reutilizável. Ele agrega as linhas de entrada no buffer de acordo com sua implementação.
Limites
-
Acesso à Internet via UDFs
Por padrão, o MaxCompute não permite acesso à Internet por meio de UDFs. Se precisar acessar a Internet usando UDFs, preencha o formulário de solicitação de conexão de rede conforme suas necessidades de negócio e envie a solicitação. A equipe de suporte técnico do MaxCompute entrará em contato prontamente para habilitar a conectividade de rede. Para mais detalhes sobre como preencher o formulário de solicitação de conexão de rede, consulte Network connection process.
-
Acesso a VPC via UDFs
Por padrão, o MaxCompute não permite o acesso a recursos em VPCs por meio de UDFs. Para acessar recursos em uma VPC usando UDFs, estabeleça uma conexão de rede entre o MaxCompute e a VPC. Para mais informações sobre as operações relacionadas, consulte Access VPC resources from a UDF.
-
Leitura de dados de tabelas via UDFs, UDAFs ou UDTFs
Não use UDFs, UDAFs ou UDTFs para ler dados dos seguintes tipos de tabelas:
Tabelas com evolução de schema
Tabelas com tipos de dados complexos
Tabelas com tipos de dados JSON
Tabelas transacionais
Observações de uso
Ao desenvolver uma UDAF Java, observe os seguintes pontos:
Incluir classes com o mesmo nome, mas lógicas diferentes, nos arquivos JAR de UDAFs distintas pode causar resultados inesperados ou falhas de compilação. Por exemplo, suponha que UDAF1 e UDAF2 correspondam aos arquivos de recurso udaf1.jar e udaf2.jar, respectivamente. Se ambos os arquivos JAR contiverem uma classe chamada
com.aliyun.UserFunction.classcom implementações diferentes, o MaxCompute carregará uma das classes de forma imprevisível quando UDAF1 e UDAF2 forem chamadas na mesma instrução SQL.Em uma UDAF Java, os parâmetros de entrada e o valor de retorno devem ser tipos de objeto, como String e Long, e não tipos primitivos.
Valores NULL em SQL são representados por NULL em Java. Tipos primitivos Java não podem representar valores NULL em SQL e, portanto, não são permitidos.
Anotação @Resolve
O formato da anotação @Resolve é o seguinte.
@Resolve(<signature>)A signature é uma string que identifica os tipos de dados dos parâmetros de entrada e do valor de retorno. Durante a execução de uma UDAF, os tipos de seus parâmetros de entrada e do valor de retorno devem corresponder aos tipos especificados na assinatura da função. Na análise semântica, o sistema verifica usos em desconformidade com a assinatura e reporta um erro caso haja incompatibilidade de tipos. O formato específico é o seguinte.
'arg_type_list -> type'Descrição:
-
arg_type_list: Representa os tipos de dados dos parâmetros de entrada. Especifique múltiplos parâmetros separados por vírgulas (,). Os tipos suportados incluem BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), CHAR, VARCHAR, tipos complexos (ARRAY, MAP, STRUCT) e tipos complexos aninhados.O campo
arg_type_listtambém aceita um asterisco (*) ou uma string vazia ('').Se
arg_type_listfor um asterisco (*), a função aceita qualquer número de parâmetros de entrada.Caso
arg_type_listseja uma string vazia (''), a função não possui parâmetros de entrada.
Para mais informações sobre a sintaxe estendida da anotação Resolve, consulte Dynamic parameters for UDAFs and UDTFs.
type: Indica o tipo de dado do valor de retorno. Uma UDAF retorna apenas uma coluna. Os tipos suportados abrangem BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), tipos complexos (ARRAY, MAP, STRUCT) e tipos complexos aninhados.
Ao escrever o código da UDAF, selecione os tipos de dados adequados com base na edição de tipos de dados do seu projeto MaxCompute. Para mais detalhes sobre as edições de tipos de dados e os tipos suportados em cada uma, consulte Data type versions.
A seguir, exemplos válidos de anotações @Resolve.
|
Exemplo de @Resolve |
Descrição |
|
|
Os tipos dos parâmetros de entrada são BIGINT e DOUBLE, e o tipo do valor de retorno é STRING. |
|
|
Aceita qualquer quantidade de parâmetros de entrada, com valor de retorno do tipo STRING. |
|
|
Não aceita parâmetros de entrada; o valor de retorno é do tipo DOUBLE. |
|
|
O parâmetro de entrada é do tipo ARRAY<BIGINT> e o retorno é STRUCT<x:STRING, y:INT>. |
Tipos de dados
Os tipos de dados suportados pelo MaxCompute variam conforme a edição de tipos de dados. A partir do MaxCompute 2.0, novos tipos estão disponíveis, incluindo tipos complexos como ARRAY, MAP e STRUCT. Para mais informações, consulte Data type editions.
Sua UDAF Java deve usar tipos de dados compatíveis com os do MaxCompute. A tabela a seguir descreve esses mapeamentos.
|
Tipo MaxCompute |
Tipo Java |
Tipo Java Writable |
|
TINYINT |
java.lang.Byte |
ByteWritable |
|
SMALLINT |
java.lang.Short |
ShortWritable |
|
INT |
java.lang.Integer |
IntWritable |
|
BIGINT |
java.lang.Long |
LongWritable |
|
FLOAT |
java.lang.Float |
FloatWritable |
|
DOUBLE |
java.lang.Double |
DoubleWritable |
|
DECIMAL |
java.math.BigDecimal |
BigDecimalWritable |
|
BOOLEAN |
java.lang.Boolean |
BooleanWritable |
|
STRING |
java.lang.String |
Text |
|
VARCHAR |
com.aliyun.odps.data.Varchar |
VarcharWritable |
|
BINARY |
com.aliyun.odps.data.Binary |
BytesWritable |
|
DATE |
java.sql.Date |
DateWritable |
|
DATETIME |
java.util.Date |
DatetimeWritable |
|
TIMESTAMP |
java.sql.Timestamp |
TimestampWritable |
|
INTERVAL_YEAR_MONTH |
N/A |
IntervalYearMonthWritable |
|
INTERVAL_DAY_TIME |
N/A |
IntervalDayTimeWritable |
|
ARRAY |
java.util.List |
N/A |
|
MAP |
java.util.Map |
N/A |
|
STRUCT |
com.aliyun.odps.data.Struct |
N/A |
Os parâmetros de entrada ou o valor de retorno de uma UDAF só podem usar o Tipo Java Writable se o seu projeto MaxCompute estiver usando a edição de tipos de dados MaxCompute V2.0.
Uso
Após desenvolver a UDAF Java seguindo as instruções em development process, chame-a no MaxCompute SQL da seguinte forma:
Uso de UDF em um projeto MaxCompute: O procedimento assemelha-se ao uso de built-in functions. Use a função definida pelo usuário da mesma maneira que uma função integrada.
Uso de UDF entre projetos: Use uma UDF do Projeto B dentro do Projeto A. O exemplo abaixo ilustra essa situação:
select B:udf_in_other_project(arg0, arg1) as res from table_t;. Para mais detalhes sobre compartilhamento entre projetos, consulte Cross-project resource access based on packages.
Para um exemplo completo de desenvolvimento e chamada de uma UDAF Java usando o MaxCompute Studio, consulte Example.
Exemplo
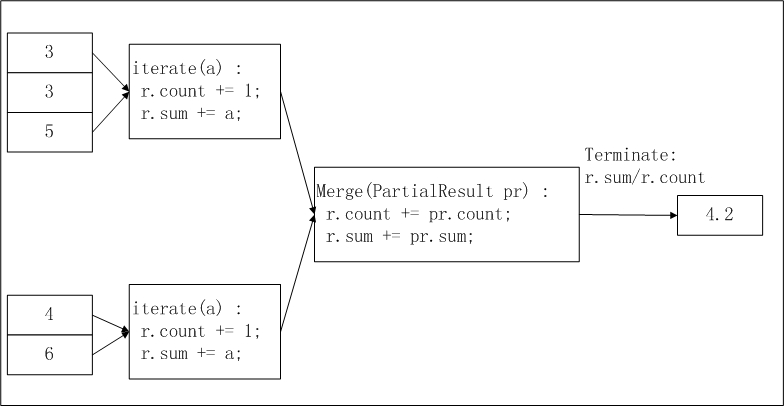
Este exemplo demonstra como usar o MaxCompute Studio para desenvolver uma UDAF chamada AggrAvg, que calcula um valor médio. A figura a seguir ilustra a lógica envolvida.
-
Fatiamento dos dados de entrada: O MaxCompute segue o fluxo de processamento MapReduce para dividir os dados de entrada em fatias que um worker possa processar eficientemente.
Configure o tamanho da fatia por meio do parâmetro
odps.stage.mapper.split.size. Primeira fase do cálculo da média: Cada worker conta o número de registros de dados e calcula sua soma dentro de sua fatia. A contagem e a soma de cada fatia constituem um resultado intermediário.
Segunda fase do cálculo da média: Os resultados intermediários de cada fatia da primeira fase são agregados.
Saída final:
r.sum/r.countrepresenta a média de todos os dados de entrada.
As etapas a seguir descrevem como desenvolver e chamar a UDAF Java:
-
Prepare o ambiente.
Antes de desenvolver e depurar uma UDF no MaxCompute Studio, instale o MaxCompute Studio e conecte-o a um projeto MaxCompute. Para mais informações, consulte os seguintes tópicos:
-
Escreva o código da UDAF
No explorador Project, clique com o botão direito no diretório de código-fonte do módulo () e selecione .
-
Na caixa de diálogo Create new MaxCompute java class, clique em UDAF, insira um nome no campo Name e pressione Enter. Neste exemplo, nomeie a classe Java como AggrAvg.
O campo Name refere-se ao nome da classe Java do MaxCompute. Se ainda não tiver criado um pacote, insira o nome no formato packagename.classname. Um pacote será gerado automaticamente.
-
No editor de código, cole o seguinte código da UDAF.
import java.io.DataInput;
import java.io.DataOutput;
import java.io.IOException;
import com.aliyun.odps.io.DoubleWritable;
import com.aliyun.odps.io.Writable;
import com.aliyun.odps.udf.Aggregator;
import com.aliyun.odps.udf.UDFException;
import com.aliyun.odps.udf.annotation.Resolve;
@Resolve("double->double")
public class AggrAvg extends Aggregator {
  private static class AvgBuffer implements Writable {
    private double sum = 0;
    private long count = 0;
    @Override
    public void write(DataOutput out) throws IOException {
      out.writeDouble(sum);
      out.writeLong(count);
    }
    @Override
    public void readFields(DataInput in) throws IOException {
      sum = in.readDouble();
      count = in.readLong();
    }
  }
  private DoubleWritable ret = new DoubleWritable();
  @Override
  public Writable newBuffer() {
    return new AvgBuffer();
  }
  @Override
  public void iterate(Writable buffer, Writable[] args) throws UDFException {
    DoubleWritable arg = (DoubleWritable) args[0];
    AvgBuffer buf = (AvgBuffer) buffer;
    if (arg != null) {
      buf.count += 1;
      buf.sum += arg.get();
    }
  }
  @Override
  public Writable terminate(Writable buffer) throws UDFException {
    AvgBuffer buf = (AvgBuffer) buffer;
    if (buf.count == 0) {
      ret.set(0);
    } else {
      ret.set(buf.sum / buf.count);
    }
    return ret;
  }
  @Override
  public void merge(Writable buffer, Writable partial) throws UDFException {
    AvgBuffer buf = (AvgBuffer) buffer;
    AvgBuffer p = (AvgBuffer) partial;
    buf.sum += p.sum;
    buf.count += p.count;
  }
}
-
Depure a UDAF localmente
Para mais operações de depuração, consulte Debug UDFs by running them locally.
Clique com o botão direito no arquivo AggrAvg.java em seu projeto e escolha Run 'AggrAvg.main()'. Na caixa de diálogo Run/Debug Configurations exibida, configure os seguintes parâmetros: MaxCompute project como
local, MaxCompute table comokmeans_in, Table columns comodim1,dim2, Download Record limit como100e Data Column Separator como vírgula. Em seguida, clique em OK.NotaUse os dados mostrados na figura como referência para os parâmetros de execução.
-
Empacote a UDAF criada em um arquivo JAR, faça upload do arquivo JAR para um projeto MaxCompute e registre a função. Por exemplo, suponha que a função se chame
user_udaf.Para mais informações sobre operações de empacotamento, consulte Steps.
No IntelliJ IDEA, clique com o botão direito no arquivo Java que contém a UDAF e escolha Deploy to server.... Na caixa de diálogo Package a jar, submit resource and register function, configure MaxCompute project, Resource name, Main class (insira o nome da classe da UDAF) e Function name. Marque a caixa de seleção Force update if already exists e clique em OK para concluir a implantação.
-
Na barra de navegação à esquerda do MaxCompute Studio, clique em Project Explorer, clique com o botão direito no projeto MaxCompute desejado, inicie o cliente MaxCompute e execute um comando SQL para chamar a UDAF recém-criada.
Suponha que a tabela alvo
my_tabletenha o seguinte schema e dados.+------------+------------+ | col0 | col1 | +------------+------------+ | 1.2 | 2.0 | | 1.6 | 2.1 | +------------+------------+Execute a seguinte instrução SQL para chamar a UDAF.
select user_udaf(col0) as c0 from my_table;O resultado retornado é o seguinte.
+----+
| c0 |
+----+
| 1.4|
+----+