Tabelas Hash Clustering usam propriedades de shuffle e ordenação para organizar dados. O MaxCompute aproveita essas propriedades para otimizar planos de execução, aumentar a eficiência e economizar recursos. Este tópico descreve como usar tabelas Hash Clustering no MaxCompute.
Informações básicas
A junção de tabelas é um cenário comum em consultas do MaxCompute. Por exemplo, a consulta abaixo executa uma inner join simples entre as tabelas t1 e t2 na coluna id.
SELECT t1.a, t2.b FROM t1 JOIN t2 ON t1.id = t2.id;O MaxCompute usa três métodos principais para implementar joins:
-
Broadcast Hash Join
Quando uma das tabelas do join é pequena, o MaxCompute usa este método para transmitir (broadcast) a tabela menor para todas as instâncias da tarefa de join. Em seguida, executa um hash join com a tabela maior.
-
Shuffle Hash Join
Se as tabelas do join forem grandes, não é possível fazer broadcast. Nesse caso, o MaxCompute executa um hash shuffle em ambas as tabelas com base na chave de junção. Registros com o mesmo valor de chave produzem o mesmo resultado de hash, o que garante o envio de registros com chaves idênticas à mesma instância da tarefa de join. Cada instância constrói uma tabela hash para o conjunto de dados menor e executa um join de leitura sequencial com o conjunto maior.
-
Sort Merge Join
Não é possível usar o método Shuffle Hash Join se as tabelas do join forem muito grandes, pois não há memória suficiente para construir a tabela hash. Este método executa primeiro um hash shuffle na chave de junção, ordena os dados por essa chave e depois mescla os dois lados do join. A figura a seguir ilustra esse processo.
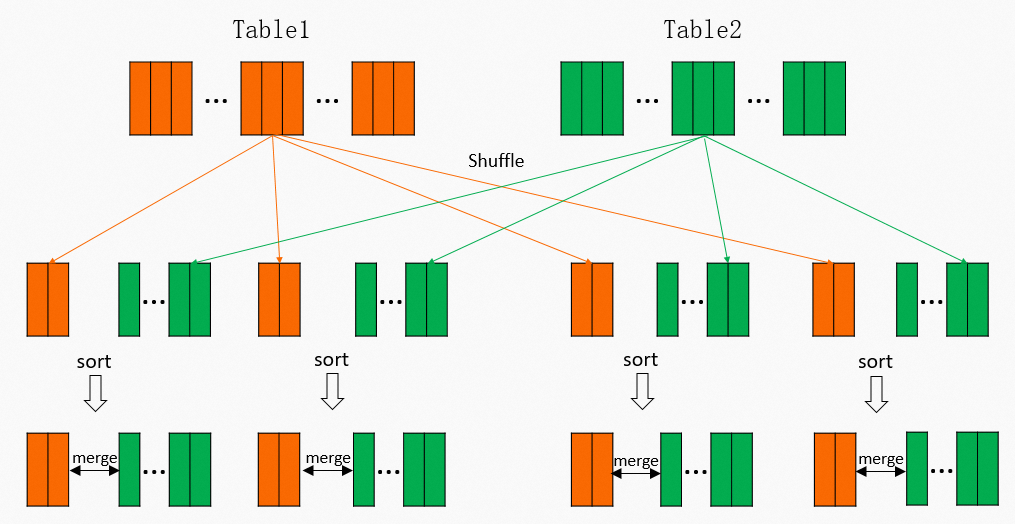 Para os volumes e a escala de dados comuns no MaxCompute, o Sort Merge Join é usado na maioria dos casos. No entanto, trata-se de uma operação bastante custosa. Como mostra a figura, a operação de shuffle exige cálculo e os resultados intermediários devem ser gravados em disco. Posteriormente, o reducer precisa ler e ordenar esses dados. Em um cenário com
Mmappers eRreducers, isso resulta emM × Roperações de leitura de I/O. O plano de execução física Fuxi correspondente aparece abaixo. Ele requer dois estágios de Mapper e um estágio de Join. As partes em vermelho indicam as operações de shuffle e ordenação.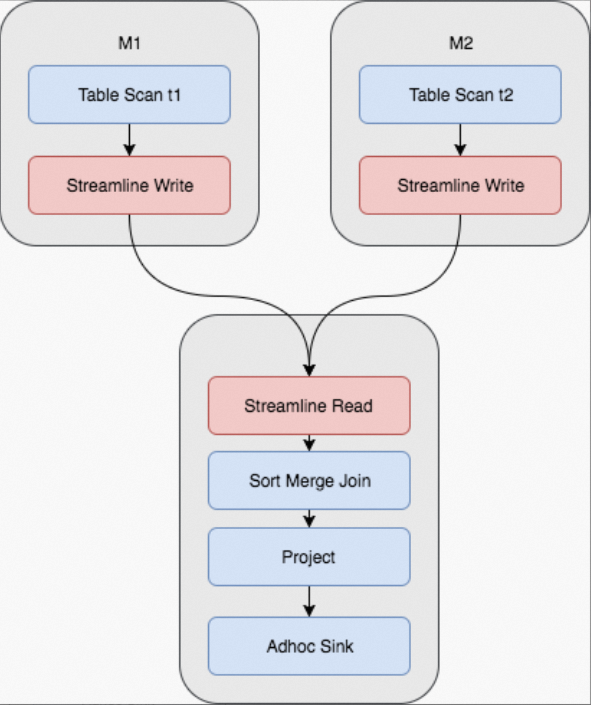 Além disso, alguns joins podem ocorrer repetidamente. Por exemplo, se a consulta for alterada para:
SELECT t1.c, t2.d FROM t1 JOIN t2 ON t1.id = t2.id;Embora as colunas selecionadas sejam diferentes, a operação de join é idêntica. Todo o processo de shuffle e ordenação também permanece o mesmo.
Ou, se a consulta for alterada para:
SELECT t1.c, t3.d FROM t1 JOIN t3 ON t1.id = t3.id;Isso une as tabelas t1 e t3. Para a tabela t1, todo o processo de shuffle e ordenação continua igual.
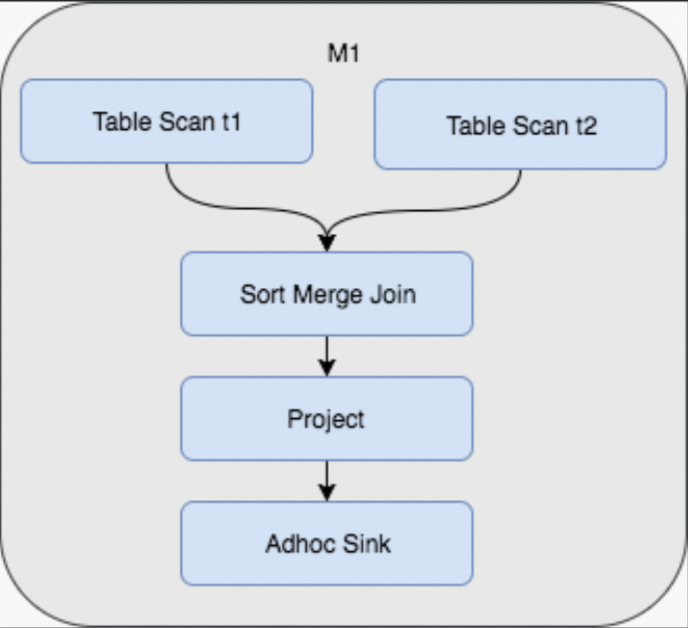
Portanto, se os dados iniciais da tabela forem armazenados usando hash shuffle e ordenação, as consultas subsequentes evitarão repetir o shuffle e a ordenação. O benefício é que um custo único durante a criação da tabela elimina custos recorrentes de shuffle e join nas consultas futuras. O plano de execução física Fuxi para o join muda conforme mostrado na figura a seguir. Essa alteração não apenas economiza as operações de shuffle e ordenação, mas também reduz a consulta de três estágios para apenas um.
Notas de uso
Crie uma tabela Hash Clustering
Use a instrução a seguir para criar uma tabela Hash Clustering. Especifique uma chave de cluster (que atua como chave de hash) e o número de buckets de hash. A ordenação é opcional. Contudo, para obter o melhor desempenho, defina a chave de ordenação igual à chave de cluster na maioria dos casos.
-
Sintaxe
CREATE TABLE [IF NOT EXISTS] <table_name> [(<col_name> <data_type> [comment <col_comment>], ...)] [comment <table_comment>] [PARTITIONED BY (<col_name> <data_type> [comment <col_comment>], ...)] [CLUSTERED BY (<col_name> [, <col_name>, ...]) [SORTED BY (<col_name> [ASC | DESC] [, <col_name> [ASC | DESC] ...])] INTO <number_of_buckets> BUCKETS] [AS <select_statement>] -
Exemplos
-
Tabela não particionada
CREATE TABLE T1 (a string, b string, c bigint) CLUSTERED BY (c) SORTED by (c) INTO 1024 BUCKETS; -
Tabela particionada
CREATE TABLE T1 (a string, b string, c bigint)
       PARTITIONED BY (dt string)
       CLUSTERED BY (c)
       SORTED by (c) INTO 1024 BUCKETS;
-
-
Propriedades
-
CLUSTERED BY
Define a chave de hash. O MaxCompute executa uma operação de hash nas colunas especificadas e distribui os dados em buckets com base nos valores de hash. Para evitar skew de dados, prevenir hot spots e garantir boa execução paralela, selecione colunas com ampla faixa de valores e poucas chaves duplicadas para a cláusula
CLUSTERED BY. Para otimizar joins, escolha chaves de junção ou agregação frequentes, semelhantes a chaves primárias em bancos de dados tradicionais. -
SORTED BY
Especifica a ordem de classificação dos campos dentro de um bucket. Para melhor desempenho, defina a chave
SORTED BYigual à chaveCLUSTERED BY. Quando a cláusulaSORTED BYé especificada, o MaxCompute cria automaticamente um índice e o utiliza para acelerar as consultas. -
INTO number_of_buckets BUCKETS
Determina o número de buckets de hash. Esse número é obrigatório e depende do volume de dados. Uma quantidade maior de buckets aumenta a concorrência e pode reduzir o tempo de execução dos jobs. No entanto, buckets em excesso geram muitos arquivos pequenos, e alta concorrência eleva o tempo de CPU. Defina o número de buckets de modo que cada um tenha entre 500 MB e 1 GB. Para tabelas muito grandes, esse valor pode ser superior. Para otimizar joins eliminando as etapas de shuffle e ordenação, o número de buckets das duas tabelas deve ser múltiplo entre si, como
256e512. Use potências de 2 para o número de buckets, como 512, 1024, 2048 ou 4096. Isso permite que o sistema divida e mescle buckets de hash automaticamente, removendo as etapas de shuffle e ordenação.
-
Alterar as propriedades de Hash Clustering de uma tabela
Use a instrução ALTER TABLE para adicionar ou remover propriedades de Hash Clustering em uma tabela particionada.
-
Instruções
-- Change the table to a Hash Clustering table ALTER TABLE <table_name> [CLUSTERED BY (<col_name> [, <col_name>, ...]) [SORTED BY (<col_name> [ASC | DESC] [, <col_name> [ASC | DESC] ...])] INTO <number_of_buckets> BUCKETS]; -- Change a Hash Clustering table to a non-Hash Clustering table ALTER TABLE <table_name> NOT CLUSTERED; -
Observações
A instrução
ALTER TABLEaltera as propriedades de cluster apenas para tabelas particionadas. Em tabelas não particionadas, não é possível modificar as propriedades de cluster após a definição inicial.A instrução
ALTER TABLEafeta somente novas partições de uma tabela particionada, incluindo partições geradas porINSERT OVERWRITE. As novas partições são armazenadas com as novas propriedades de cluster. As partições de dados existentes permanecem inalteradas.Não especifique a cláusula
PARTITIONna instrução, pois ela afeta apenas novas partições.
A instrução ALTER TABLE é adequada para tabelas existentes. Após adicionar novas propriedades de cluster, as novas partições serão armazenadas usando Hash Clustering.
Verifique propriedades da tabela
Após criar uma tabela Hash Clustering, execute o comando a seguir para visualizar suas propriedades. As propriedades de Hash Clustering aparecem na seção Extended Info.
DESC EXTENDED <table_name>;Um exemplo do resultado retornado é apresentado a seguir.
| Owner: ALIYUN$                          | Project:
| TableComment:
|
| CreateTime:               2017-06-19 14:10:55
| LastDDLTime:              2017-06-19 14:10:55
| LastModifiedTime:         2017-06-19 14:13:13
|
| InternalTable: YES    | Size: 21680295746
|
| Native Columns:
|
| Field           | Type    | Label | Comment
|
| l_orderkey      | bigint  |       |
| l_partkey       | bigint  |       |
| l_suppkey       | bigint  |       |
| l_linenumber    | bigint  |       |
| l_quantity      | double  |       |
| l_extendedprice | double  |       |
| l_discount      | double  |       |
| l_tax           | double  |       |
| l_returnflag    | string  |       |
| l_linestatus    | string  |       |
| l_shipdate      | string  |       |
| l_commitdate    | string  |       |
| l_receiptdate   | string  |       |
| l_shipinstruct  | string  |       |
| l_shipmode      | string  |       |
| l_comment       | string  |       |
|
| Extended Info:
|
| TableID:
| IsArchived:          false
| PhysicalSize:        65040887238
| FileNum:             1001
| ClusterType:         hash
| BucketNum:           1000
| ClusterColumns:      [l_orderkey]
| SortColumns:         [l_orderkey ASC]
Para uma tabela particionada, após visualizar as propriedades da tabela, execute o comando a seguir para verificar as propriedades da partição.
DESC EXTENDED <table_name> partition(<pt_spec>);Um exemplo do resultado retornado é apresentado a seguir.
| PartitionSize: 754

| CreateTime:               2017-07-07 14:01:03
| LastDDLTime:              2017-07-07 14:01:03
| LastModifiedTime:         2017-07-07 14:01:03

| IsExstore:                false
| IsArchived:               false
| PhysicalSize:             2262
| FileNum:                  2
| ClusterType:              hash
| BucketNum:                500
| ClusterColumns:           [c1]
| SortColumns:              [c1 ASC]
Benefícios do Hash Clustering
Bucket pruning e otimização de índice
CREATE TABLE t1 (id bigint,
                 a string,
                 b string)
             CLUSTERED BY (id)
             SORTED BY (id) into 1000 BUCKETS;
...
SELECT t1.a, t1.b FROM t1 WHERE t1.id=12345;idid
A consulta localiza o bucket de hash correspondente ao valor
12345. Isso exige a varredura de apenas um bucket em vez de todos os 1.000. Esse processo é conhecido como bucket pruning.Como os dados dentro do bucket estão ordenados por
id, o MaxCompute cria automaticamente um índice. Em seguida, utiliza uma busca por índice para localizar diretamente os registros relevantes.
Essa otimização não só reduz drasticamente o número de mappers, como também permite que eles localizem diretamente a página de dados por meio do índice. Isso diminui significativamente a quantidade de dados carregados e lidos.
Por exemplo, uma tarefa de big data iniciou 1.111 mappers e leu 42,7 bilhões de registros para encontrar 26 registros correspondentes. O tempo total de execução foi de 1 minuto e 48 segundos. Com uma tabela Hash Clustering, a mesma consulta sobre os mesmos dados localiza diretamente um único bucket e usa um índice para ler apenas as páginas que contêm os dados da consulta. Esse processo usa apenas 4 mappers, lê 10.000 registros e leva somente 6 segundos.
Otimização de agregação
Considere a seguinte consulta:
SELECT department, SUM(salary) FROM employee GROUP BY (department);Normalmente, essa consulta faz shuffle e ordena os dados da coluna department e então executa uma agregação em fluxo para contar cada grupo de department. Porém, se os dados da tabela já estiverem clusterizados e ordenados por department, as operações de shuffle e ordenação deixam de ser necessárias.
Otimização de armazenamento
Mesmo sem considerar otimizações computacionais, apenas o fato de armazenar os dados da tabela com shuffle e ordenação já economiza espaço significativo. O MaxCompute usa column store na camada subjacente. A ordenação agrupa registros com valores de chave iguais ou semelhantes. Isso melhora a eficácia da compressão e codificação, resultando em taxas de compressão mais altas. Em testes, uma tabela ordenada chegou a usar até 50% menos espaço de armazenamento do que uma tabela não ordenada em alguns casos extremos. Para tabelas com ciclo de vida longo, usar Hash Clustering para armazenamento é uma otimização vantajosa.
O experimento a seguir usa a tabela lineitem de 100 GB do conjunto de dados TPC-H. A tabela contém vários tipos de dados, como int, double e string. Com os mesmos dados e método de compressão, comparamos o tamanho de armazenamento de uma tabela com e sem Hash Clustering. A tabela com Hash Clustering usou aproximadamente 10% menos espaço, conforme mostram as figuras a seguir.
-
Sem Hash Clustering
odps@xxx>desc tpch_lineitem; +------------------------------------------------------------------------------------+ | Owner: xxx | Project: xxx | | TableComment: | +------------------------------------------------------------------------------------+ | CreateTime: 2016-04-17 21:48:08 | | LastDDLTime: 2016-04-17 21:48:08 | | LastModifiedTime: 2016-04-17 21:50:10 | +------------------------------------------------------------------------------------+ | InternalTable: YES | Size: 23573055432 | +------------------------------------------------------------------------------------+ | Native Columns: | +------------------------------------------------------------------------------------+ | Field | Type | Label | Comment | +------------------------------------------------------------------------------------+ | l_orderkey | bigint | | | | l_partkey | bigint | | | | l_suppkey | bigint | | | | l_linenumber | bigint | | | | l_quantity | double | | | | l_extendedprice | double | | | | l_discount | double | | | | l_tax | double | | | | l_returnflag | string | | | | l_linestatus | string | | | | l_shipdate | string | | | | l_commitdate | string | | | | l_receiptdate | string | | | | l_shipinstruct | string | | | | l_shipmode | string | | | | l_comment | string | | | +------------------------------------------------------------------------------------+ -
Com Hash Clustering
odps@ xxx      >desc tpch_lineitem_hash_500;

| Owner:          xxx               | Project:    xxx
| TableComment:

| CreateTime:          2017-07-13 14:40:11
| LastDDLTime:         2017-07-13 14:40:11
| LastModifiedTime:    2017-07-13 15:05:04

| InternalTable: YES  | Size: 21658913950

| Native Columns:

| Field            | Type      | Label | Comment

| l_orderkey       | bigint    |       |
| l_partkey        | bigint    |       |
| l_suppkey        | bigint    |       |
| l_linenumber     | bigint    |       |
| l_quantity       | double    |       |
| l_extendedprice  | double    |       |
| l_discount       | double    |       |
| l_tax            | double    |       |
| l_returnflag     | string    |       |
| l_linestatus     | string    |       |
| l_shipdate       | string    |       |
| l_commitdate     | string    |       |
| l_receiptdate    | string    |       |
| l_shipinstruct   | string    |       |
| l_shipmode       | string    |       |
| l_comment        | string    |       |
Dados de teste e análise
Os benefícios gerais de desempenho do Hash Clustering foram medidos usando o conjunto de testes padrão TPC-H. O teste usou 1 TB de dados e 500 buckets para todas as tabelas. Exceto pelas duas tabelas pequenas, nation e region, todas as demais usaram a primeira coluna como chave de cluster e ordenação. Os resultados gerais mostram que, após o uso do Hash Clustering, o tempo total de CPU foi reduzido em aproximadamente 17,3%, e o tempo total de execução dos jobs caiu cerca de 12,8%.
Note que nem todas as consultas do TPC-H conseguem aproveitar a propriedade de cluster. Em particular, as duas consultas mais longas não usam esse recurso. Por isso, a melhoria geral de eficiência não é drástica. Entretanto, para consultas que podem usar a propriedade de cluster, os benefícios são expressivos. Por exemplo, a Q4 ficou aproximadamente 68% mais rápida, a Q12 cerca de 62% mais rápida e a Q10 aproximadamente 47% mais rápida.
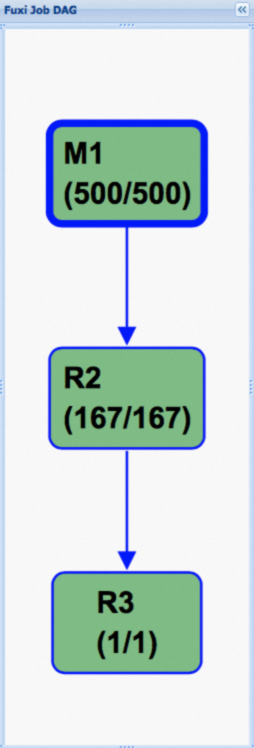
A figura a seguir mostra o plano de execução Fuxi para a Q4 do TPC-H em uma tabela padrão: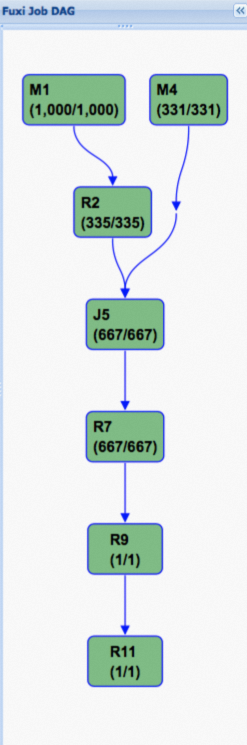 A figura seguinte apresenta o plano de execução após o uso do Hash Clustering. Como é possível observar, o Grafo Acíclico Direcionado (DAG) fica muito mais simplificado. Essa é a principal razão para a melhoria significativa de desempenho.