Perguntas frequentes (FAQs) sobre instalação, importação e uso do PyODPS.
Categoria do problema | Pergunta frequente |
Instalar o PyODPS |
|
Importar módulos |
|
Usar o PyODPS |
|
Erro durante a instalação: "Warning: XXX not installed"
Causa: Um componente obrigatório está ausente. Solução: Identifique o componente faltante no espaço reservado XXX da mensagem de erro e instale-o executando o comando pip.
Erro durante a instalação: "Project Not Found"
Esse erro ocorre por um dos seguintes motivos:
Configuração incorreta do endpoint: O endpoint foi configurado de forma errada. Utilize o endpoint do projeto de destino. Para obter mais informações sobre endpoints, consulte {{XREF_44}}.
Posição incorreta dos parâmetros: Os parâmetros do objeto de entrada do MaxCompute foram especificados nas posições erradas. Verifique se os parâmetros foram inseridos corretamente. Para obter mais informações sobre os parâmetros de um objeto de entrada do MaxCompute, consulte {{XREF_45}}.
Erro durante a instalação: "Syntax Error"
Esse erro acontece porque a versão do Python é muito antiga. O PyODPS requer Python 2.6, 2.7.6 ou superior, ou 3.3 ou superior. As versões 2.5 e anteriores do Python não são suportadas.
Erro de instalação no macOS: "Permission Denied"
Execute o seguinte comando para instalar o PyODPS: sudo pip install pyodps.
Erro de instalação no macOS: "Operation Not Permitted"
A Proteção de Integridade do Sistema (SIP) causa esse erro. Para corrigi-lo, reinicie o dispositivo e pressione ⌘+R durante a inicialização para entrar no Modo de Recuperação. Em seguida, abra o Terminal e execute os comandos abaixo.
csrutil disable
reboot
Para obter mais informações, consulte Operation Not Permitted when on root - El Capitan (rootless disabled).
Erro de importação: "No Module Named ODPS"
Não foi possível carregar o pacote ODPS. Possíveis causas:
-
Causa 1: Conflito de nomes no caminho de busca
O caminho de busca, que geralmente é o diretório atual, contém um arquivo chamado
odps.pyouinit.py, ou ainda um diretório chamado odps. Isso gera conflito com o pacote PyODPS instalado. Solução:Caso exista um diretório com nome conflitante, renomeie-o.
Se você instalou anteriormente outro pacote Python chamado odps, desinstale-o executando
sudo pip uninstall odps.
-
Causa 2: Múltiplas versões do Python instaladas
Talvez você esteja executando o script em um ambiente Python onde o PyODPS não está instalado. Solução: Certifique-se de usar o interpretador Python correto, no qual o PyODPS esteja instalado, ou instale o PyODPS na versão que você está utilizando atualmente.
-
Causa 3: PyODPS não instalado
O pacote nunca foi instalado no ambiente Python atual. Solução: Instale o PyODPS. Para obter mais informações, consulte {{XREF_46}}.
Erro de importação: "Cannot Import Name ODPS"
Verifique se existe um arquivo chamado odps.py no seu diretório de trabalho atual. Se existir, renomeie-o antes de executar a instrução de importação novamente.
Erro de importação: "Cannot Import Module odps"
Geralmente, esse erro indica um problema de dependência na instalação do PyODPS. Clique neste link para entrar no grupo de suporte técnico do PyODPS no DingTalk e entre em contato com o administrador do grupo para obter assistência.
"ImportError" no IPython ou Jupyter
Tente adicionar from odps import errors ao início do seu código. Se o problema persistir, pode ser devido a uma dependência ausente do IPython. Execute sudo pip install -U jupyter para resolver a questão.
O atributo size
O atributo size representa o tamanho físico da tabela.
Como definir um endpoint do Tunnel?
Utilize options.tunnel.endpoint para configurar o endpoint do túnel. Para obter mais informações, consulte a documentação de opções do aliyun-odps-python-sdk.
Usar pacotes de terceiros do CPython
Recomendamos empacotá-los no formato Wheel. Para obter mais informações, consulte How to create a crcmod package that can be used in MaxCompute.
Limite de processamento de dados do DataFrame
Um DataFrame do PyODPS não possui limite quanto aos dados que pode processar, pois as operações são traduzidas em jobs do MaxCompute. No entanto, um DataFrame local do pandas é limitado pela memória disponível na sua máquina.
Como usar max_pt em um DataFrame?
Utilize o módulo odps.df.func para chamar funções integradas do MaxCompute.
from odps.df import func
df = o.get_table('your_table').to_df()
df[df.ds == func.max_pt('your_project.your_table')]  # ds is a partition column.
Qual é a diferença entre open_writer() e write_table()?
Cada chamada a write_table() cria um novo arquivo no servidor, o que adiciona uma sobrecarga significativa. Muitos arquivos pequenos degradam o desempenho das consultas e podem causar erros de falta de memória no servidor. Recomendamos gravar vários lotes de dados de uma só vez ou passar um objeto gerador. Para ver um exemplo, consulte {{XREF_47}}.
Por outro lado, open_writer() cria uma sessão que permite gravar dados em blocos, sendo mais eficiente para uploads via streaming ou iterativos.
Discrepância de dados entre DataWorks e script local
Por padrão, o Instance Tunnel vem desativado no DataWorks. Isso significa que instance.open_reader utiliza a Result API, limitada a 10.000 registros.
Após ativar o Instance Tunnel, utilize reader.count para obter o número total de registros. Para iterar por todos os dados, desative o limite definindo options.tunnel.limit_instance_tunnel = False.
Como obter a contagem real de um DataFrame?
-
Após instalar o PyODPS, execute o comando abaixo no seu ambiente Python para criar um DataFrame a partir de uma tabela do MaxCompute.
iris = DataFrame(o.get_table('pyodps_iris')) -
Chame o método
count()no DataFrame para obter o número total de linhas.iris.count() -
As operações em um DataFrame são executadas de forma preguiçosa (lazy). Elas não rodam até que você chame explicitamente um método de ação, como
execute(). Para forçar a execução imediata da operaçãocount(), encadeie-a com o métodoexecute().df.count().execute()
Para obter mais informações sobre métodos que retornam valores reais, consulte {{XREF_48}}. Para saber mais sobre execução preguiçosa no PyODPS, consulte {{XREF_49}}.
Erro "sourceIP is not in the white list"
O projeto do MaxCompute que você tenta acessar é protegido por uma lista de permissões de IP. Entre em contato com o proprietário do projeto para adicionar o endereço IP da sua máquina à lista de permissões. Para obter mais informações, consulte {{XREF_50}}.
options.sql.settings falha ao definir o ambiente
-
Sintoma
Antes de executar uma consulta SQL usando o PyODPS, você usa o código a seguir para configurar o ambiente de execução do MaxCompute.
from odps import options
options.sql.settings = {'odps.sql.mapper.split.size': 32}
Após executar a tarefa, apenas seis mappers são iniciados, indicando que a configuração não surtiu efeito. Ao executar
set odps.stage.mapper.split.size=32no cliente, a tarefa é concluída em menos de um minuto. -
Causa
O nome do parâmetro usado no PyODPS difere daquele usado no cliente. O parâmetro do cliente é
odps.stage.mapper.split.size, enquanto o parâmetro do PyODPS éodps.sql.mapper.split.size. -
Solução
Altere o nome do parâmetro no seu código para
odps.stage.mapper.split.size.
"IndexError" ao chamar head()
Ocorre porque list[index] não existe ou list[index] está fora do intervalo.
Erro ao fazer upload de um DataFrame do pandas para o MaxCompute: "ODPSError"
-
Sintoma
Ao fazer upload de um DataFrame do pandas para o MaxCompute, o seguinte erro é retornado.
ODPSError: ODPS entrance should be provided. -
Causa
Falta um ponto de entrada global do objeto MaxCompute.
-
Solução
Utilize o mecanismo Room
%enter, que configura um ponto de entrada global.Chame o método
to_global()no ponto de entrada do seu objeto MaxCompute.Passe o objeto ODPS diretamente como parâmetro:
DataFrame(pd_df).persist('your_table', odps=odps).
Erro "lifecycle is not specified"
-
Sintoma
Ao gravar dados em uma tabela usando um DataFrame, o seguinte erro é retornado.
table lifecycle is not specified in mandatory mode -
Causa
O projeto de destino exige que um ciclo de vida seja especificado para todas as tabelas, mas você não definiu nenhum.
-
Solução
Especifique o ciclo de vida da tabela no seu script antes de realizar a operação de gravação.
from odps import options
options.lifecycle = 7  # Specify the lifecycle value. The value is an integer in days.
Erro "datastream from server is crushed"
Normalmente, dados inconsistentes causam esse erro. Verifique se seus dados possuem o mesmo número de colunas da tabela de destino.
Erro "Project is protected"
Uma política de segurança no projeto impede a leitura dos dados da tabela. Para acessar o conjunto completo de dados, utilize um dos métodos a seguir:
Entre em contato com o proprietário do projeto para adicionar uma regra de exceção ao seu acesso.
Use o DataWorks ou outra ferramenta para anonimizar os dados, exporte-os para um projeto não protegido e leia-os a partir daí.
Para visualizar apenas um subconjunto dos dados, utilize um dos métodos abaixo (sujeito ao limite de 10.000 registros):
Utilize o método execute_sql:
o.execute_sql('select * from <table_name>').open_reader().Converta a tabela em um DataFrame:
o.get_table('<table_name>').to_df().
Falha intermitente "ConnectionError: timed out"
Esse erro pode ter as seguintes causas:
-
Tempo limite de conexão: O tempo limite padrão de conexão do PyODPS é de 5 segundos. Se a rede estiver instável, a conexão poderá falhar. Você pode adotar uma das soluções a seguir:
-
Aumente o intervalo de tempo limite adicionando o código a seguir ao início do seu script.
# Workaround to increase timeout
from odps import options
options.connect_timeout = 30
Implemente um mecanismo de nova tentativa no seu código para tratar a exceção.
-
Restrições de sandbox: Ambientes de sandbox podem ter restrições de acesso à rede. Para resolver isso, recomendamos utilizar um grupo de recursos de agendamento exclusivo para executar a tarefa.
Erro "is not defined" para get_sql_task_cost()
-
Sintoma
Ao executar a função get_sql_task_cost, o seguinte erro é retornado.
NameError: name 'get_task_cost' is not defined. -
Causa
O nome da função está incorreto.
-
Solução
Utilize execute_sql_cost em vez de get_sql_task_cost.
Como exibir caracteres chineses corretamente nos logs do PyODPS?
Resolva isso utilizando uma string de formatação de impressão, por exemplo, print ("My name is %s" % ('abc')). Esse problema geralmente ocorre apenas no Python 2.
DATETIME torna-se STRING quando o instance tunnel está desativado
Quando Open_Reader é chamado, o PyODPS usa a interface legada Result por padrão. Consequentemente, os dados retornados pelo servidor vêm em formato CSV, e todos os valores DATETIME passam a ser do tipo STRING.
Para resolver, ative o Instance Tunnel definindo options.tunnel.use_instance_tunnel = True. Isso faz com que o PyODPS utilize o service Instance Tunnel, preservando os tipos de dados originais.
Implementar recursos avançados com Python
-
Escrever funções Python reutilizáveis
Defina uma série de funções para cálculos comuns, como calcular a distância entre dois pontos usando métodos diferentes, como distância euclidiana ou de Manhattan. Em seguida, chame a função apropriada conforme necessário.
def euclidean_distance(from_x, from_y, to_x, to_y):
    return ((from_x - to_x) ** 2 + (from_y - to_y) ** 2).sqrt()

def manhattan_distance(from_x, from_y, to_x, to_y):
   return (from_x - to_x).abs() + (from_y - to_y).abs()
Exemplo de chamada:
In [42]: df from_x from_y to_x to_y 0 0.393094 0.427736 0.463035 0.105007 1 0.629571 0.364047 0.972390 0.081533 2 0.460626 0.530383 0.443177 0.706774 3 0.647776 0.192169 0.244621 0.447979 4 0.846044 0.153819 0.873813 0.257627 5 0.702269 0.363977 0.440960 0.639756 6 0.596976 0.978124 0.669283 0.936233 7 0.376831 0.461660 0.707208 0.216863 8 0.632239 0.519418 0.881574 0.972641 9 0.071466 0.294414 0.012949 0.368514 In [43]: euclidean_distance(df.from_x, df.from_y, df.to_x, df.to_y).rename('distance') distance 0 0.330221 1 0.444229 2 0.177253 3 0.477465 4 0.107458 5 0.379916 6 0.083565 7 0.411187 8 0.517280 9 0.094420 In [44]: manhattan_distance(df.from_x, df.from_y, df.to_x, df.to_y).rename('distance') distance 0 0.392670 1 0.625334 2 0.193841 3 0.658966 4 0.131577 5 0.537088 6 0.114198 7 0.575175 8 0.702558 9 0.132617 -
Usar instruções condicionais e de loop do Python
Processar campos de tabela com base em uma configuração e depois executar um UNION ou JOIN em todas as tabelas pode resultar em SQL complexo. Os DataFrames do PyODPS simplificam essa tarefa.
Por exemplo, para combinar 30 tabelas em uma única tabela, seria necessário escrever uma consulta SQL com 30 cláusulas UNION ALL. Com o PyODPS, obtenha o mesmo resultado com o código a seguir.
table_names = ['table1', ..., 'tableN']
dfs = [o.get_table(tn).to_df() for tn in table_names]
reduce(lambda x, y: x.union(y), dfs)

# The reduce statement is equivalent to the following code.
df = dfs[0]
for other_df in dfs[1:]:
    df = df.union(other_df)
Como depurar localmente usando o backend do pandas?
Realize a depuração local de duas maneiras. O método de inicialização difere, mas o código subsequente é o mesmo:
Um DataFrame do PyODPS criado a partir de um DataFrame do pandas pode realizar computações locais usando o pandas.
Um DataFrame criado a partir de uma tabela do MaxCompute executa no MaxCompute.
O código de exemplo a seguir mostra como alternar entre depuração local e execução completa no MaxCompute.
df = o.get_table('movielens_ratings').to_df()
DEBUG = True
if DEBUG:
    # Use a small subset of data for local debugging
    df = df[:100].to_pandas(wrap=True)
Após escrever seu código, teste-o localmente para iterações rápidas. Quando os testes forem concluídos, altere o valor de DEBUG para False a fim de executar a computação completa no MaxCompute.
Recomendamos usar o MaxCompute Studio para depurar programas PyODPS locais.
Como evitar execução lenta em loops aninhados?
Colete os resultados do loop em um dict ou lista do Python e crie o objeto DataFrame fora do loop. Colocar o código de criação do DataFrame, como df=XXX, dentro do loop externo gera um novo objeto DataFrame a cada iteração, o que desacelera significativamente a execução.
Como evitar baixar dados para a máquina local?
Para obter mais informações, consulte {{XREF_51}}.
Quando baixar dados para processamento local
Baixe dados do PyODPS para processamento local nos seguintes cenários:
A quantidade de dados é pequena e cabe na memória da sua máquina local.
-
É necessário realizar operações linha a linha que expandem uma linha em várias, ou aplicar uma função Python complexa a cada linha. Um DataFrame do PyODPS lida com isso eficientemente aproveitando a computação paralela do MaxCompute.
Por exemplo, se você tiver uma coluna contendo strings JSON e quiser expandir cada objeto JSON em várias linhas com base em seus pares chave-valor, utilize o código a seguir.
In [12]: df
               json
0  {"a": 1, "b": 2}
1  {"c": 4, "b": 3}

In [14]: from odps.df import output

In [16]: @output(['k', 'v'], ['string', 'int'])
    ...: def h(row):
    ...:     import json
    ...:     for k, v in json.loads(row.json).items():
    ...:         yield k, v
    ...:

In [21]: df.apply(h, axis=1)
   k  v
0  a  1
1  b  2
2  c  4
3  b  3
Como recuperar mais de 10.000 registros com open_reader?
Utilize CREATE TABLE ... AS SELECT ... para salvar o resultado de uma consulta SQL em uma nova tabela e, em seguida, use table.open_reader para ler todos os dados dessa tabela.
Operadores integrados vs. UDFs
Uma função definida pelo usuário (UDF) é muito mais lenta que um operador integrado. Portanto, sempre que possível, prefira operadores integrados.
Em um teste com um conjunto de dados de um milhão de linhas, aplicar uma UDF a cada linha aumentou o tempo de execução de 7 para 27 segundos.
Valor de partição vazio no schema do DataFrame
Isso ocorre porque um DataFrame trata colunas de partição e colunas regulares da mesma maneira. Como resultado, schema.partitions em um objeto DataFrame não fornece informações sobre as colunas de partição da tabela subjacente. Filtre os dados usando a coluna de partição como uma coluna regular.
df = o.get_table('your_table').to_df()
print(df[df.ds == 'your_partition_value'].execute())
Para trabalhar com metadados de partição, recomendamos utilizar os métodos fornecidos pelo objeto de tabela. Para obter mais informações, consulte {{XREF_52}}.
Como realizar um produto cartesiano com um DataFrame do PyODPS?
Para obter mais informações, consulte How to handle a Cartesian product in a PyODPS DataFrame.
Como implementar segmentação de palavras chinesas Jieba no PyODPS?
Para obter mais informações, consulte {{XREF_53}}.
Como baixar conjuntos de dados completos usando o PyODPS?
Por padrão, o PyODPS não limita a leitura de dados de uma Instance. No entanto, para projetos protegidos do MaxCompute, os downloads via Tunnel são restritos. Se options.tunnel.limit_instance_tunnel não estiver definido, um limite de tamanho de dados é ativado automaticamente e o número de registros baixáveis fica limitado pela configuração do MaxCompute (geralmente 10.000 registros). Para recuperar todos os dados iterativamente, desative o limit usando as instruções a seguir para ativar globalmente o Instance Tunnel e desativar o limit.
options.tunnel.use_instance_tunnel = True
options.tunnel.limit_instance_tunnel = False  # Disable the limit to read all data.

with instance.open_reader() as reader:
    # You can read the full dataset through the Instance Tunnel.
execute_sql vs. DataFrame para cálculo de taxa de nulos
Um DataFrame oferece melhor desempenho para agregações. Recomendamos utilizar um DataFrame para executar operações de agregação.
Como configurar tipos de dados no PyODPS?
Ative novos tipos de dados no PyODPS usando um dos métodos a seguir:
Para ativar novos tipos de dados usando o método
execute_sql, executeo.execute_sql('set odps.sql.type.system.odps2=true;query_sql', hints={"odps.sql.submit.mode" : "script"}).-
Para ativar novos tipos de dados em operações de DataFrame como
persist,execute, outo_pandas, utilize o parâmetrohints. As configurações especificadas dessa forma são válidas apenas para um único job.from odps.df import DataFrame users = DataFrame(o.get_table('odps2_test')) users.persist('copy_test',hints={'odps.sql.type.system.odps2':'true'})Para ativar as configurações globalmente para todas as operações de DataFrame, defina o parâmetro de opção
options.sql.use_odps2_extension = True.
"ValueError" com tipo Decimal
Resolva esse problema de uma das seguintes formas:
Atualize o SDK para a versão V0.8.4 ou superior.
-
Adicione as instruções a seguir ao seu código:
from odps.types import Decimal
Decimal._max_precision=38
Como solucionar problemas de execução lenta de SQL no PyODPS?
O PyODPS não realiza operações intensivas antes de enviar uma tarefa SQL. Na maioria dos casos, a execução lenta de SQL não está relacionada ao PyODPS. Siga estas etapas para identificar a causa:
-
Verifique latências de rede e servidor
Verifique se há latência no servidor proxy ou no link de rede pelo qual passa o envio da tarefa.
Verifique problemas no lado do servidor, como atrasos na fila de tarefas.
-
Avalie a eficiência da leitura de dados
Se a execução do SQL envolver a leitura de uma grande quantidade de dados, verifique se a velocidade de leitura está lenta devido ao alto volume de dados ou a um número excessivo de shards de dados. Execute as etapas a seguir:
Tente separar o envio da tarefa da leitura dos dados. Para isso, envie a tarefa usando run_sql, aguarde a conclusão da tarefa usando instance.wait_for_success, e em seguida, leia os dados usando instance.open_reader para determinar a latência causada por cada instrução. Veja a seguir um exemplo dessa separação:
-
Antes da separação:
with o.execute_sql('select * from your_table').open_reader() as reader: for row in reader: print(row) -
Após a separação:
inst = o.run_sql('select * from your_table')
inst.wait_for_success()
with inst.open_reader() as reader:
    for row in reader:
        print(row)
-
-
Verifique o status do job no DataWorks (se aplicável)
Para jobs enviados no DataWorks, verifique se há tarefas SQL que foram enviadas com sucesso, mas falharam ao gerar um Logview, especialmente quando a versão do PyODPS for inferior a 0.11.6. Essas tarefas geralmente são enviadas usando os métodos execute_sql ou run_sql.
-
Analise fatores do ambiente local
Para determinar se o problema está relacionado ao seu ambiente local, recomendamos ativar o log de depuração. O PyODPS imprime todas as requisições e respostas, permitindo identificar a localização do atraso.
Exemplo:
import datetime
import logging
from odps import ODPS

logging.basicConfig(level=logging.DEBUG, format='%(asctime)s - %(name)s - %(levelname)s - %(message)s')
o = ODPS(...)  #  Enter your credentials here. Ignore this if a MaxCompute entry is already provided in the environment.
# Print the local time to determine when the local operation was initiated.
print("Check time:", datetime.datetime.now())
# Submit the task.
inst = o.run_sql("select * from your_table")
A saída padrão deve ser semelhante ao resultado a seguir:
Check time: 2025-01-24 15:34:21.531330
2025-01-24 15:34:21,532 - odps.rest - DEBUG - Start request.
2025-01-24 15:34:21,532 - odps.rest - DEBUG - POST: http://service.<region>.maxcompute.aliyun.com/api/projects/<project>/instances
2025-01-24 15:34:21,532 - odps.rest - DEBUG - data: b'<?xml version="1.0" encoding="utf-8"?>\n<Instance>\n  <Job>\n    <Priority>9</Priority>\n    <Tasks>\n      <SQL>\n        ....
2025-01-24 15:34:21,532 - odps.rest - DEBUG - headers: {'Content-Type': 'application/xml'}
2025-01-24 15:34:21,533 - odps.rest - DEBUG - request url + params /api/projects/<project>/instances?curr_project=<project>
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - headers before signing: {'Content-Type': 'application/xml', 'User-Agent': 'pyodps/0.12.2 CPython/3.7.12', 'Content-Length': '736'}
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - headers to sign: OrderedDict([('content-md5', ''), ('content-type', 'application/xml'), ('date', 'Fri, 24 Jan 2025 07:34:21 GMT')])
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - canonical string: POST

application/xml
Fri, 24 Jan 2025 07:34:21 GMT
/projects/maxframe_ci_cd/instances?curr_project=maxframe_ci_cd
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - headers after signing: {'Content-Type': 'application/xml', 'User-Agent': 'pyodps/0.12.2 CPython/3.7.12', 'Content-Length': '736', ....
2025-01-24 15:34:21,533 - urllib3.connectionpool - DEBUG - Resetting dropped connection: service.<region>.maxcompute.aliyun.com
2025-01-24 15:34:22,027 - urllib3.connectionpool - DEBUG - http://service.<region>.maxcompute.aliyun.com:80 "POST /api/projects/<project>/instances?curr_project=<project> HTTP/1.1" 201 0
2025-01-24 15:34:22,027 - odps.rest - DEBUG - response.status_code 201
2025-01-24 15:34:22,027 - odps.rest - DEBUG - response.headers:
{'Server': '<Server>', 'Date': 'Fri, 24 Jan 2025 07:34:22 GMT', 'Content-Type': 'text/plain;charset=utf-8', 'Content-Length': '0', 'Connection': 'close', 'Location': ....
2025-01-24 15:34:22,027 - odps.rest - DEBUG - response.content: b''
Essa saída mostra o momento em que o código inicia a tarefa (2025-01-24 15:34:21.531), o momento em que a requisição é enviada (2025-01-24 15:34:21.533) e o momento em que o servidor retorna uma resposta (2025-01-24 15:34:22.027). Isso permite determinar o custo de tempo de cada etapa.
Como obter a contagem de arquivos e a última hora de modificação de uma tabela do MaxCompute usando o PyODPS?
-
Descrição do problema
Executar DESC EXTENDED table_name ou DESC EXTENDED table_name PARTITION (xxx='xxx') por meio do cliente MaxCompute (odpscmd) ou de um nó MaxCompute SQL no DataWorks retorna metadados detalhados da tabela, como contagem de arquivos (file_num), tamanho físico e última hora de modificação.
No entanto, executar DESC EXTENDED por meio do método run_sql() ou execute_sql() do PyODPS não retorna as informações estendidas completas (como file_num), tornando impossível extrair essas métricas de forma estruturada.
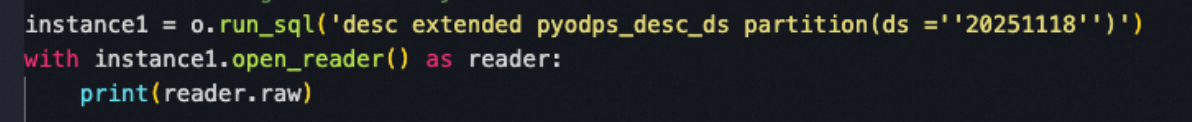
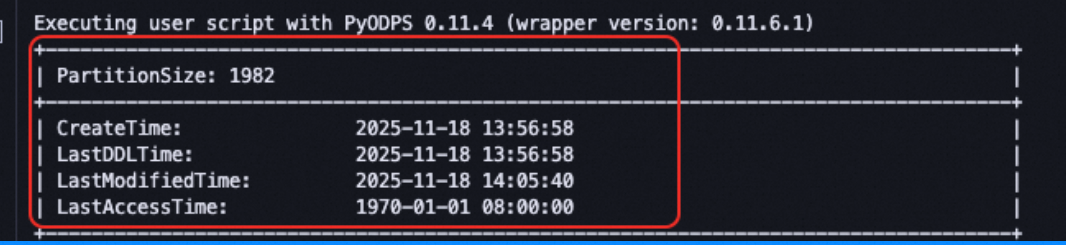
-
Solução
Utilize interfaces nativas do SDK do PyODPS, como table.reload_extend_info() ou partition.reload(), para obter essas estatísticas. Clique neste link para visualizar o source code.
O exemplo a seguir mostra como obter a contagem de arquivos de cada partição:
from odps.models import Partition

  # Replace with the actual table name
  table_name = 'your_real_table_name'

  # ========== 1. Get the table object ==========
  try:
      # Assume that o is an initialized ODPS object
      # In a DataWorks PyODPS node, uncomment the following line
      # o = odps
      table = o.get_table(table_name)
      print(f"Table object obtained: {table_name}")
  except Exception as e:
      print(f"Error: Failed to obtain table '{table_name}'. Cause: {str(e)}")
      raise

  # ========== 2. Check whether the table is partitioned ==========
  if not table.table_schema.partitions:
      print(f"Table '{table_name}' is not a partitioned table. Partition query
  is not supported.")
  else:
      print(f"Table '{table_name}' is a partitioned table. Iterating over all
  partitions...")
      print("=" * 60)

      # ========== 3. Iterate over partitions by using table.partitions
  ==========
      partition_count = 0
      try:
          for partition in table.partitions:
              try:
                  part_spec = partition.spec
                  if not part_spec:
                      part_spec = 'Unknown partition'

                  # partition.reload() loads detailed partition metadata
                  # This triggers one or more API calls to MaxCompute Metastore
                  partition.reload()

                  print(f"Partition Spec: {part_spec}")
                  print(f"  - Creation Time      : {partition.creation_time}")
                  print(f"  - Last Modified Time :
  {partition.last_data_modified_time}")
                  print(f"  - Physical Size      : {partition.physical_size}
  bytes")
                  print(f"  - File Count         : {partition.file_num}")
                  print(f"  - Is Archived        : {partition.is_archived}")
                  print("-" * 60)

                  partition_count += 1

              except Exception as e_inner:
                  print(f"Warning: Failed to load details for partition
  {partition.spec or ''}. Cause: {str(e_inner)}")
                  print("-" * 60)
                  continue

          print(f"Iteration complete: {partition_count} partitions processed.")

      except Exception as e_outer:
          print(f"Fatal error during partition iteration. Cause:
  {str(e_outer)}")