Operações JOIN são comuns em sistemas distribuídos, mas também apresentam alto custo em tempo e recursos. A operação de shuffle é particularmente cara em cenários de dados em grande escala. Para resolver isso, o MaxCompute otimiza a operação de shuffle aproveitando as propriedades dos equi-joins.
Como funciona
Um comando SQL típico que inclui um JOIN é o seguinte:
SELECT * FROM (table1) A JOIN (table2) B ON A.a = B.b;Em cenários com conjuntos de dados pequenos, o dynamic filter só entra em vigor quando usado com MergeJoin. Para garantir a execução correta, defina os seguintes flags:
set odps.optimizer.enable.conditional.mapjoin=false;set odps.optimizer.cbo.rule.filter.black=hj;
Com base nas condições de igualdade de um JOIN, o MaxCompute pode gerar um filtro a partir dos dados da tabela A para filtrar os dados da tabela B antes de uma operação de shuffle ou JOIN. O MaxCompute pode até propagar o filtro para o armazenamento subjacente, filtrando os dados na origem. Esse recurso de geração dinâmica de filtros em tempo de execução é chamado de dynamic filter (DF).
O diagrama a seguir mostra o plano de execução do comando SQL anterior antes e depois de o dynamic filter ser ativado.

Casos de uso
O recurso dynamic filter aproveita as propriedades dos equi-joins para gerar filtros em tempo de execução. Dessa forma, os dados são filtrados antes da operação de shuffle ou JOIN, acelerando a execução de consultas. Esse recurso é ideal para cenários em que uma tabela de dimensão é combinada com uma tabela de fatos.
Dynamic range ou Bloom filters
Conforme mostrado no diagrama anterior, nenhum filtro existe no plano de execução original. O sistema gera automaticamente um filtro com base nas propriedades do JOIN. Esse filtro verifica se os elementos da tabela B existem no conjunto gerado a partir da tabela A e remove os que não existem.
Na prática, um dynamic filter pode usar um Bloom filter ou outros métodos de filtragem de dados, como um range filter baseado em valores [min, max] ou um predicado IN.
Um dynamic filter segue um modelo típico de produtor-consumidor, conforme mostrado no diagrama a seguir.
Operador DFP (Dynamic Filter Producer): o produtor do dynamic filter. Usa dados da tabela menor para gerar um Bloom filter e obter os valores
minemax(para o range filter) da chave de junção. Em seguida, envia essas informações ao DFC.Operador DFC (Dynamic Filter Consumer): o consumidor do dynamic filter. Usa o Bloom filter e o range filter para filtrar os dados da tabela maior. O range filter tenta propagar as condições do filtro para o armazenamento subjacente, filtrando os dados na origem.
Para diferentes semânticas de JOIN, as tabelas na junção podem assumir papéis distintos:
A JOIN B: tanto A quanto B podem atuar como produtor ou consumidor.
A LEFT JOIN B: A só pode atuar como produtor, e B só pode atuar como consumidor.
A RIGHT JOIN B: A só pode atuar como consumidor, e B só pode atuar como produtor.
A FULL OUTER JOIN B: dynamic filters não podem ser usados.
Para informações sobre como usar dynamic filters, consulte Enable dynamic filters.
Poda dinâmica de partições
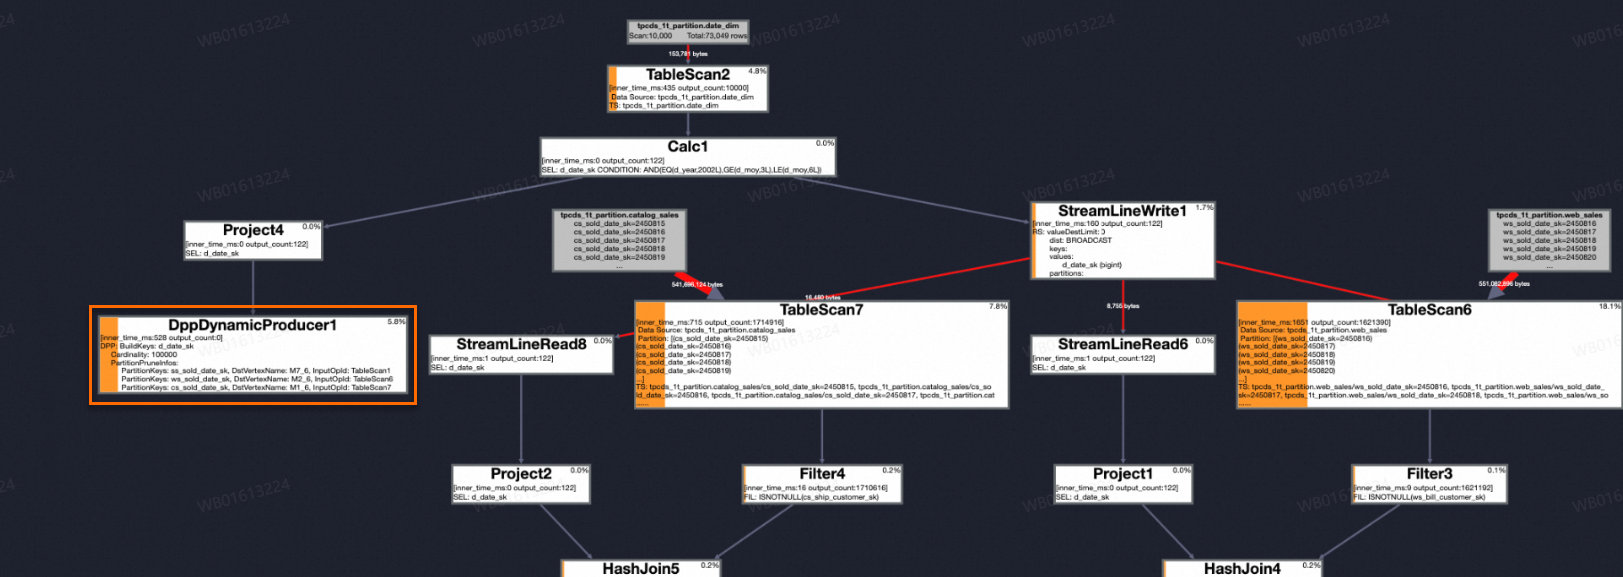
Os exemplos de Bloom filter e range filter anteriores ilustram otimizações para tabelas não particionadas, em que a chave de junção não é uma coluna de chave de partição. Quando a chave de junção é uma coluna de chave de partição, dynamic range or Bloom filters ainda podem ser usados. No entanto, o MaxCompute lê todos os dados de uma partição antes de filtrá-los. Esse processo pode ser otimizado podando partições irrelevantes antes da leitura. Esse recurso é chamado de poda dinâmica de partições (DPP).
Por exemplo, considere o seguinte comando SQL que inclui um JOIN:
-- A is a non-partitioned table. The value in column a is 20200701.
-- B is a partitioned table. The partition key column ds contains three partitions: 20200701, 20200702, and 20200703.
SELECT * FROM (table1) A JOIN (table2) B ON A.a= B.ds;
Após ativar a poda dinâmica de partições, o otimizador decide se deve aplicá-la com base em se a tabela é particionada. Quando a poda dinâmica de partições entra em vigor, o MaxCompute coleta dados da tabela menor para gerar um Bloom filter. Em seguida, filtra a lista de partições da tabela maior, identifica as partições que precisam ser lidas e poda as demais. Se todas as partições alvo de um processo forem podadas, esse processo não é agendado.
No exemplo anterior, como o único valor na coluna a da tabela A é 20200701, ativar a poda dinâmica de partições poda as partições 20200702 e 20200703 da tabela B. Isso economiza recursos e reduz o tempo de execução do job.
Para informações sobre como usar a poda dinâmica de partições, consulte Enable dynamic partition pruning.
Ativar dynamic filters
O MaxCompute oferece os seguintes métodos para ativar dynamic filters:
-
Método 1: force a filtragem dinâmica no nível da sessão. Envie o seguinte comando junto com seu comando SQL:
set odps.optimizer.force.dynamic.filter=true;NotaEssa propriedade também pode ser definida no nível do projeto, mas recomendamos defini-la no nível da sessão. Isso pode reduzir a eficiência de processamento em jobs JOIN que não se beneficiam da filtragem.
Esse método insere um dynamic filter para cada job JOIN compatível.
-
Método 2: permita que o otimizador decida de forma inteligente quando usar a filtragem dinâmica no nível da sessão.
set odps.optimizer.enable.dynamic.filter=true;Com esse método, o optimizer estima se a inserção de um dynamic filter oferece benefícios suficientes. Se sim, o otimizador insere o dynamic filter; caso contrário, não insere.
NotaEsse método depende de estatísticas de metadados, como o número de valores distintos (NDV). Para mais informações sobre estatísticas de metadados, consulte Collect information for the optimizer. Como as estatísticas de metadados são estimativas do otimizador, podem ser imprecisas. Por isso, o otimizador pode não inserir um dynamic filter conforme esperado.
-
Método 3: ative dynamic filters usando um hint no comando SQL.
O formato do hint é
/*+dynamicfilter(Producer, Consumer1[, Consumer2,...])*/. Ele permite que um produtor filtre múltiplos consumidores. O seguinte comando é um exemplo:select /*+dynamicfilter(A, B)*/ * from table1 A join table2 B on A.a= B.b;
Ativar poda dinâmica de partições
Ative a poda dinâmica de partições no nível da sessão enviando o seguinte comando junto com seu comando SQL:
set odps.optimizer.dynamic.filter.dpp.enable=true;Essa propriedade também pode ser definida no nível do projeto, mas recomendamos defini-la no nível da sessão. Se um job JOIN não se beneficiar da filtragem de dados, isso pode reduzir a eficiência de processamento.
Verificar as otimizações
Após ativar os recursos descritos em Enable dynamic filters ou Enable dynamic partition pruning, use os seguintes métodos para verificar se estão ativos:
Verify dynamic filter
Após executar o job SQL, visualize as informações de LogView. Se um operador semelhante a DynamicFilterConsumer1 aparecer no LogView, o dynamic filter entrou em vigor.
Verify dynamic partition pruning
Após executar um job SQL, verifique as informações de LogView. Se um operador como DppDynamicProducer contendo PartitionPruneInfos aparecer no LogView, a poda dinâmica de partições entrou em vigor.