Cria uma materialized view com suporte a clustering ou particionamento, adequada para cenários que utilizam esse recurso.
Contexto
Uma view é uma tabela virtual definida por uma consulta. Já a materialized view é uma tabela física que armazena resultados pré-computados e consome recursos de armazenamento. Para detalhes sobre faturamento, consulte Billing rules.
As materialized views são indicadas para os seguintes cenários:
Consultas executadas frequentemente com um padrão fixo.
Consultas que envolvem operações demoradas, como agregações e joins.
Consultas que acessam apenas um pequeno subconjunto de dados de uma tabela.
A tabela a seguir compara consultas tradicionais com consultas em materialized views.
Item | Consulta tradicional | Consulta em materialized view |
Instrução de consulta | Consulte dados diretamente usando instruções SQL. | Crie uma materialized view e depois consulte-a. A instrução a seguir cria uma materialized view: Consulte a materialized view: Se a reescrita de consulta estiver ativada para a materialized view, o sistema usará automaticamente a materialized view ao executar a seguinte consulta: |
Características da consulta | A consulta lê tabelas, executa joins e aplica filtros (cláusula WHERE). Em tabelas source grandes, essas operações são lentas e consomem muitos recursos. | A consulta lê a materialized view e aplica filtros, sem necessidade de joins. O MaxCompute associa automaticamente a consulta à materialized view ideal e lê os dados diretamente dela, o que melhora significativamente o desempenho. |
Regras de faturamento
Os custos de uma materialized view dividem-se em dois componentes:
-
Taxas de armazenamento
As materialized views consomem armazenamento físico, gerando taxas de armazenamento no modelo de pagamento conforme o uso. Para mais informações, consulte Storage pricing (pay-as-you-go).
-
Custos de computação
Criar, atualizar e consultar uma materialized view — incluindo reescritas de consulta quando a view é válida — consome recursos de computação e gera custos correspondentes.
Se o seu projeto MaxCompute estiver em um plano de assinatura , não haverá cobrança separada.
-
Caso o projeto MaxCompute esteja em um plano de pagamento conforme o uso , o MaxCompute calcula os custos com base na complexidade do SQL e no volume de dados de entrada. Para mais informações, consulte Standard SQL pricing. Observe o seguinte:
A instrução SQL usada para atualizar uma materialized view é a mesma da consulta que a define. Se o projeto estiver vinculado a um grupo de recursos de computação por assinatura, a operação utilizará os recursos adquiridos sem custo adicional. Se o projeto usar um grupo de recursos de pagamento conforme o uso, o custo dependerá do volume de dados de entrada e da complexidade do SQL. Após a atualização, as taxas de armazenamento serão cobradas com base no tamanho real da materialized view.
Quando a materialized view é válida, a reescrita de consulta lê dados diretamente da view. O volume de dados de entrada depende da materialized view, e não da tabela source. Se a view estiver inválida, a reescrita de consulta ficará indisponível e as consultas lerão dados diretamente da tabela source. Para mais informações, consulte Query materialized view status.
Quando uma materialized view é construída a partir de joins de múltiplas tabelas, pode ocorrer inflação de dados. A leitura da materialized view nem sempre reduz custos em comparação à leitura das tabelas source.
Limitações
Funções de janela, funções com valor de tabela definidas pelo usuário (UDTFs) e funções não determinísticas, como funções escalares definidas pelo usuário (UDFs) e funções de agregação definidas pelo usuário (UDAFs), não são suportadas.
Se for necessário usar uma função não determinística, defina esta propriedade no nível de sessão: set odps.sql.materialized.view.support.nondeterministic.function=true;.
Precauções
Se a execução da instrução de consulta usada como base para criar a materialized view falhar, não será possível criar a materialized view.
As colunas de chave de partição em uma materialized view devem ser derivadas de uma tabela source. A sequência e a quantidade de colunas na materialized view devem corresponder exatamente às da tabela source. Os nomes das colunas podem ser diferentes.
Especifique comentários para todas as colunas, inclusive as de chave de partição. Se você definir comentários apenas para algumas colunas, um erro será retornado.
É possível especificar tanto os atributos de particionamento quanto os de clustering para uma materialized view. Nesse caso, os dados de cada partição terão o atributo de clustering especificado.
Caso a instrução de consulta usada para criar a materialized view contenha operadores não suportados por ela, um erro será retornado. Para mais informações sobre os operadores suportados por materialized views, consulte Perform a query rewrite operation based on a materialized view.
Por padrão, o MaxCompute não permite a criação de materialized views usando funções não determinísticas, como UDFs ou UDAFs. Se seus requisitos de negócio exigirem o uso dessas funções, execute o comando
set odps.sql.materialized.view.support.nondeterministic.function=true;no nível de sessão.Se a tabela source de uma materialized view contiver uma partição vazia, atualize a materialized view para gerar uma partição vazia correspondente nela.
Sintaxe
CREATE MATERIALIZED VIEW [IF NOT EXISTS] [project_name.]<mv_name>
[LIFECYCLE <days>]    --Specifies the lifecycle.
[BUILD DEFERRED]    --Creates the schema without populating data.
[(<col_name> [COMMENT <col_comment>], ...)]    --Column comments.
[DISABLE REWRITE]    --Specifies whether the materialized view can be used for query rewrite.
[COMMENT 'table comment']    --Table comment.
[PARTITIONED BY (<col_name> [, <col_name>, ...])]    --Creates the materialized view as a partitioned table.
[CLUSTERED BY | RANGE CLUSTERED BY (<col_name> [, <col_name>, ...])
  [SORTED BY (<col_name> [ASC | DESC] [, <col_name> [ASC | DESC] ...])]
    INTO <number_of_buckets> BUCKETS]    --Sets the shuffle and sort properties for a clustered table.
[REFRESH EVERY <num> {MINUTES | HOURS | DAYS}]
[TBLPROPERTIES("compressionstrategy"="{normal|high|extreme}",    --Specifies the data storage compression strategy for the table.
                "enable_auto_substitute"="true",    --Specifies whether to enable query passthrough to the source table when a partition does not exist.
                "enable_auto_refresh"="true",    --Specifies whether to enable automatic refresh.
                "refresh_interval_minutes"="120",    --Specifies the refresh interval.
                "only_refresh_max_pt"="true"    --For partitioned materialized views, automatically refreshes only the latest partition from the source table.
                )]
AS <select_statement>;
Parâmetros
Parâmetro | Obrigatório | Descrição |
IF NOT EXISTS | Não | Se você não especificar IF NOT EXISTS e a materialized view já existir, a operação falhará com um erro. |
project_name | Não | Nome do projeto MaxCompute ao qual a materialized view pertence. Se este parâmetro for omitido, o projeto atual será usado.
|
mv_name | Sim | Nome da materialized view. |
days | Não | Ciclo de vida da materialized view em dias. O valor deve ser um número inteiro entre 1 e 37231. |
BUILD DEFERRED | Não | Se especificado, cria o esquema da materialized view sem preenchê-lo com dados. |
col_name | Não | Nome de uma coluna na materialized view. |
col_comment | Não | Comentário de uma coluna. |
DISABLE REWRITE | Não | Desativa a reescrita de consulta para a materialized view. Por padrão, a reescrita de consulta está ativada. Execute |
PARTITIONED BY | Não | Colunas de chave de partição. Use este parâmetro para criar uma materialized view particionada. |
CLUSTERED BY|RANGE CLUSTERED BY | Não | Propriedade de shuffle para criar uma tabela clusterizada. |
SORTED BY | Não | Propriedade de ordenação para criar uma tabela clusterizada. |
REFRESH EVERY | Não | Intervalo de atualização agendada da materialized view. As unidades válidas são MINUTES, HOURS ou DAYS. |
number_of_buckets | Não | Número de buckets ao criar uma tabela clusterizada. |
TBLPROPERTIES | Não |
|
select_statement | Sim | Instrução SELECT que define a materialized view. Para mais informações, consulte SELECT Syntax. |
Exemplos
Criar uma materialized view
-
Crie tabelas chamadas
mf_temf_t1e insira dados nessas tabelas.CREATE TABLE IF NOT EXISTS mf_t( id bigint, value bigint, name string) PARTITIONED BY (ds STRING); ALTER TABLE mf_t ADD PARTITION (ds='1'); INSERT INTO mf_t PARTITION (ds='1') VALUES (1,10,'kyle'),(2,20,'xia'); SELECT * FROM mf_t WHERE ds ='1'; -- The following result is returned. +------------+------------+------------+------------+ | id | value | name | ds | +------------+------------+------------+------------+ | 1 | 10 | kyle | 1 | | 2 | 20 | xia | 1 | +------------+------------+------------+------------+ CREATE TABLE IF NOT EXISTS mf_t1( id bigint, value bigint, name string) PARTITIONED BY (ds STRING); ALTER TABLE mf_t1 ADD PARTITION (ds='1'); INSERT INTO mf_t1 PARTITION (ds='1') VALUES (1,10,'kyle'),(3,20,'john'); SELECT * FROM mf_t1 WHERE ds ='1'; -- The following result is returned. +------------+------------+------------+------------+ | id | value | name | ds | +------------+------------+------------+------------+ | 1 | 10 | kyle | 1 | | 3 | 20 | john | 1 | +------------+------------+------------+------------+ -
Crie uma materialized view.
-
Exemplo 1: Crie uma materialized view contendo uma coluna de chave de partição chamada ds.
CREATE MATERIALIZED VIEW mf_mv LIFECYCLE 7 ( key comment 'unique id', value comment 'input value', ds comment 'partition' ) PARTITIONED BY (ds) AS SELECT t1.id AS key, t1.value AS value, t1.ds AS ds FROM mf_t AS t1 JOIN mf_t1 AS t2 ON t1.id = t2.id AND t1.ds=t2.ds AND t1.ds='1'; --Query the materialized view. SELECT * FROM mf_mv WHERE ds =1; +------------+------------+------------+ | key | value | ds | +------------+------------+------------+ | 1 | 10 | 1 | +------------+------------+------------+ -
Exemplo 2: Crie uma materialized view não particionada e clusterizada.
CREATE MATERIALIZED VIEW mf_mv2 LIFECYCLE 7 CLUSTERED BY (key) SORTED BY (value) INTO 1024 buckets AS SELECT t1.id AS key, t1.value AS value, t1.ds AS ds FROM mf_t AS t1 JOIN mf_t1 AS t2 ON t1.id = t2.id AND t1.ds=t2.ds AND t1.ds='1'; -
Exemplo 3: Crie uma materialized view particionada e clusterizada.
CREATE MATERIALIZED VIEW mf_mv3 LIFECYCLE 7
PARTITIONED BY (ds)
CLUSTERED BY (key) SORTED BY (value) INTO 1024 buckets
AS  SELECT t1.id AS key, t1.value AS value, t1.ds AS ds
      FROM mf_t AS t1 JOIN mf_t1 AS t2
        ON t1.id = t2.id AND t1.ds=t2.ds AND t1.ds='1';
-
Implementar reescrita de consulta baseada em materialized view
-
Cenário
Considere uma tabela de visitas a páginas chamada
visit_recordsque registra o ID da página, o ID do usuário e o horário de cada visita. Uma tarefa frequente de análise consiste em contar o número de visitas para diferentes páginas.Nessa situação, crie uma materialized view sobre
visit_recordsque agrupe por ID da página e conte as visitas de cada página. Em seguida, execute consultas subsequentes nessa materialized view.A estrutura de
visit_recordsé a seguinte:+------------------------------------------------------------------------------------+ | Field | Type | Label | Comment | +------------------------------------------------------------------------------------+ | page_id | string | | | | user_id | string | | | | visit_time | string | | | +------------------------------------------------------------------------------------+ -
Crie uma materialized view.
-- Create a materialized view for the visit_records table that groups by page ID and counts the visits for each page. CREATE MATERIALIZED VIEW count_mv AS SELECT page_id, count(*) FROM visit_records GROUP BY page_id; -
Execute a seguinte consulta:
SET odps.sql.materialized.view.enable.auto.rewriting=true;
SELECT page_id, count(*) FROM visit_records GROUP BY page_id;
Ao executar essa instrução de consulta, o MaxCompute associa automaticamente a materialized view
count_mve lê os dados pré-agregados decount_mv. -
Para verificar se a consulta foi reescrita usando a materialized view, execute o seguinte comando
EXPLAIN:EXPLAIN SELECT page_id, count(*) FROM visit_records GROUP BY page_id;O resultado retornado é:
job0 is root job

In Job job0:
root Tasks: M1

In Task M1:
    Data source: doc_test_dev.count_mv
    TS: doc_test_dev.count_mv
        FS: output: Screen
            schema:
              page_id (string)
              _c1 (bigint)

OK
O campo
Data sourceno resultado retornado mostra que a tabela lida pela consulta é acount_mvdo projetodoc_test_dev. Isso indica que a materialized view está ativa e a reescrita de consulta foi bem-sucedida.
Executar uma operação de reescrita de consulta baseada em materialized view
O principal recurso das materialized views é a capacidade de reescrever instruções de consulta. Para reescrever consultas com base em uma materialized view, adicione set odps.sql.materialized.view.enable.auto.rewriting=true; antes da instrução de consulta. Se a materialized view estiver inválida, ela não poderá ser usada para reescrita de consulta. Nesse caso, os dados serão consultados diretamente na tabela source e a velocidade da consulta não será acelerada.
Por padrão, um projeto MaxCompute só pode usar suas próprias materialized views para operações de reescrita de consulta. Se você precisar realizar reescritas de consulta baseadas em materialized views de outros projetos MaxCompute, adicione set odps.sql.materialized.view.source.project.white.list=<project_name1>,<project_name2>,<project_name3>; antes das instruções de consulta para especificar os projetos MaxCompute desejados.
A tabela a seguir compara os tipos de operadores de reescrita de consulta suportados pelo MaxCompute com os de outros produtos.
Tipo de operador | Classificação | MaxCompute | BigQuery | Amazon Redshift | Hive |
FILTER | Correspondência total de expressão | Suportado | Suportado | Suportado | Suportado |
Correspondência parcial de expressão | Suportado | Suportado | Suportado | Suportado | |
AGGREGATE | AGGREGATE único | Suportado | Suportado | Suportado | Suportado |
Múltiplos AGGREGATEs | Não suportado | Não suportado | Não suportado | Não suportado | |
JOIN | Tipo de JOIN | INNER JOIN | Não suportado | INNER JOIN | INNER JOIN |
JOIN único | Suportado | Não suportado | Suportado | Suportado | |
Múltiplos JOINs | Suportado | Não suportado | Suportado | Suportado | |
AGGREGATE+JOIN | - | Suportado | Não suportado | Suportado | Suportado |
As operações de reescrita de consulta baseadas em materialized view exigem que os dados da instrução de consulta sejam obtidos da materialized view. Esses dados incluem colunas de saída, colunas necessárias para operações de filtro, colunas exigidas por funções de agregação e colunas usadas em operações de JOIN. Se as colunas necessárias na instrução de consulta não estiverem incluídas na materialized view ou não forem suportadas pelas funções de agregação, não será possível executar a reescrita de consulta baseada na materialized view.
Exemplo 1: Reescrita com condições de filtro
-
Crie uma materialized view.
CREATE MATERIALIZED VIEW mv AS SELECT a,b,c FROM src WHERE a>5; -
A tabela a seguir apresenta exemplos de reescrita para a materialized view.
Consulta original
Consulta reescrita
SELECT a,b FROM src WHERE a>5;SELECT a,b FROM mv;SELECT a, b FROM src WHERE a=10;SELECT a,b FROM mv WHERE a=10;SELECT a, b FROM src WHERE a=10 AND b='3';SELECT a,b FROM mv WHERE a=10 AND b=3;SELECT a, b FROM src WHERE a>3;(SELECT a,b FROM src WHERE a>3 AND a<=5) UNION (SELECT a,b FROM mv);SELECT a, b FROM src WHERE a=10 AND d=4;A reescrita falha porque a materialized view não contém a coluna
d.SELECT d, e FROM src WHERE a=10;A reescrita falha porque a materialized view não contém as colunas
dee.SELECT a, b FROM src WHERE a=1;A reescrita falha porque a materialized view não contém dados onde
a=1.
Exemplo 2: Reescrita com funções de agregação
Todas as funções de agregação podem ser reescritas se a materialized view e a consulta compartilharem a mesma chave de agregação. Se as chaves de agregação forem diferentes, apenas reescritas usando SUM, MIN e MAX serão suportadas.
-
Crie uma materialized view.
CREATE MATERIALIZED VIEW mv AS SELECT a, b, sum(c) AS sum, count(d) AS cnt FROM src GROUP BY a, b; -
A tabela a seguir mostra como as consultas são reescritas com base na materialized view.
Consulta original
Consulta reescrita
SELECT a, sum(c) FROM src GROUP BY a;SELECT a, sum(sum) FROM mv GROUP BY a;SELECT a, count(d) FROM src GROUP BY a, b;SELECT a, cnt FROM mv;SELECT a, count(b) FROM (SELECT a, b FROM src GROUP BY a, b) GROUP BY a;SELECT a,count(b) FROM mv GROUP BY a;SELECT a,count(b) FROM mv GROUP BY a;A reescrita falha porque a view já agregou as colunas
aeb, então a colunabnão pode ser agregada novamente.SELECT a, count(c) FROM src GROUP BY a;A reescrita falha porque a reagregação da função
COUNTnão é suportada.
Se uma função de agregação contiver DISTINCT, a consulta só poderá ser reescrita se a materialized view e a consulta original tiverem a mesma chave de agregação. Caso contrário, a reescrita não será possível.
-
Crie uma materialized view.
CREATE MATERIALIZED VIEW mv AS SELECT a, b, sum(DISTINCT c) AS sum, count(DISTINCT d) AS cnt FROM src GROUP BY a, b; -
A tabela a seguir mostra como as consultas são reescritas com base na materialized view.
Consulta original
Consulta reescrita
SELECT a, count(DISTINCT d) FROM src GROUP BY a, b;SELECT a, cnt FROM mv;SELECT a, count(c) FROM src GROUP BY a, b;A reescrita falha porque a reagregação da função
COUNTnão é suportada.SELECT a, count(DISTINCT c) FROM src GROUP BY a;A reescrita falha porque a coluna
arequer outra agregação.
Exemplo 3: Reescrita com cláusula JOIN
Reescrever entradas de JOIN
-
Crie materialized views.
CREATE MATERIALIZED VIEW mv1 AS SELECT a, b FROM j1 WHERE b > 10; CREATE MATERIALIZED VIEW mv2 AS SELECT a, b FROM j2 WHERE b > 10; -
A tabela a seguir mostra como as consultas são reescritas com base nas materialized views.
Consulta original
Consulta reescrita
SELECT j1.a,j1.b,j2.a FROM (SELECT a,b FROM j1 WHERE b > 10) j1 JOIN j2 ON j1.a=j2.a;SELECT mv1.a, mv1.b, j2.a FROM mv1 JOIN j2 ON mv1.a=j2.a;SELECT j1.a,j1.b,j2.a FROM (SELECT a,b FROM j1 WHERE b > 10) j1 JOIN (SELECT a,b FROM j2 WHERE b > 10) j2 ON j1.a=j2.a;SELECT mv1.a,mv1.b,mv2.a FROM mv1 JOIN mv2 ON mv1.a=mv2.a;
JOIN com condições de filtro
-
Crie materialized views.
--Create a non-partitioned materialized view. CREATE MATERIALIZED VIEW mv1 AS SELECT j1.a, j1.b FROM j1 JOIN j2 ON j1.a=j2.a; CREATE MATERIALIZED VIEW mv2 AS SELECT j1.a, j1.b FROM j1 JOIN j2 ON j1.a=j2.a WHERE j1.a > 10; --Create a partitioned materialized view. CREATE MATERIALIZED VIEW mv LIFECYCLE 7 PARTITIONED BY (ds) AS SELECT t1.id, t1.ds AS ds FROM t1 JOIN t2 ON t1.id = t2.id; -
A tabela a seguir mostra como as consultas são reescritas com base nas materialized views.
Consulta original
Consulta reescrita
SELECT j1.a,j1.b FROM j1 JOIN j2 ON j1.a=j2.a WHERE j1.a=4;SELECT a, b FROM mv1 WHERE a=4;SELECT j1.a,j1.b FROM j1 JOIN j2 ON j1.a=j2.a WHERE j1.a > 20;SELECT a,b FROM mv2 WHERE a>20;SELECT j1.a,j1.b FROM j1 JOIN j2 ON j1.a=j2.a WHERE j1.a > 5;(SELECT j1.a,j1.b FROM j1 JOIN j2 ON j1.a=j2.a WHERE j1.a > 5 AND j1.a <= 10) UNION SELECT * FROM mv2;SELECT key FROM t1 JOIN t2 ON t1.id= t2.id WHERE t1.ds='20210306';SELECT key FROM mv WHERE ds='20210306';SELECT key FROM t1 JOIN t2 ON t1.id= t2.id WHERE t1.ds>='20210306';SELECT key FROM mv WHERE ds>='20210306';SELECT j1.a,j1.b FROM j1 JOIN j2 ON j1.a=j2.a WHERE j2.a=4;A reescrita falha porque a materialized view não contém a coluna
j2.a.
Estender um JOIN
-
Crie uma materialized view.
CREATE MATERIALIZED VIEW mv AS SELECT j1.a, j1.b FROM j1 JOIN j2 ON j1.a=j2.a; -
A tabela a seguir mostra como as consultas são reescritas com base na materialized view.
Consulta original
Consulta reescrita
SELECT j1.a, j1.b FROM j1 JOIN j2 JOIN j3 ON j1.a=j2.a AND j1.a=j3.a;SELECT mv.a, mv.b FROM mv JOIN j3 ON mv.a=j3.a;SELECT j1.a, j1.b FROM j1 JOIN j2 JOIN j3 ON j1.a=j2.a AND j2.a=j3.a;SELECT mv.a,mv.b FROM mv JOIN j3 ON mv.a=j3.a;
Esses três cenários de reescrita de JOIN podem ser combinados.
Como o objetivo da reescrita de consulta em materialized view é acelerar as consultas, o MaxCompute prioriza regras de reescrita que oferecem o melhor desempenho. Uma regra não será aplicada se introduzir operações que resultem em baixa aceleração.
Exemplo 4: Reescrita com cláusula LEFT JOIN
-
Crie uma materialized view.
CREATE MATERIALIZED VIEW mv LIFECYCLE 7( user_id, job, total_amount ) AS SELECT t1.user_id, t1.job, sum(t2.order_amount) AS total_amount FROM user_info AS t1 LEFT JOIN sale_order AS t2 ON t1.user_id=t2.user_id GROUP BY t1.user_id; -
A tabela a seguir mostra como uma consulta é reescrita com base na materialized view.
Consulta original
Consulta reescrita
SELECT t1.user_id, sum(t2.order_amount) AS total_amount
FROM user_info AS t1
LEFT JOIN sale_order AS t2 ON t1.user_id=t2.user_id
GROUP BY t1.user_id;
SELECT user_id, total_amount FROM mv;
Exemplo 5: Reescrita com cláusula UNION ALL
-
Crie uma materialized view.
CREATE MATERIALIZED VIEW mv LIFECYCLE 7( user_id, tran_amount, tran_date ) AS SELECT user_id, tran_amount, tran_date FROM alipay_tran UNION ALL SELECT user_id, tran_amount, tran_date FROM unionpay_tran; -
A tabela a seguir mostra como uma consulta é reescrita com base na materialized view.
Consulta original
Consulta reescrita
SELECT user_id, tran_amount FROM alipay_tran
UNION ALL SELECT user_id, tran_amount FROM unionpay_tran;
SELECT user_id, tran_amount FROM mv;
Consulta transparente em materialized view
Uma materialized view particionada pode não conter dados de todas as partições — por exemplo, se você atualizar apenas as mais recentes. Quando uma consulta visa uma partição sem dados na materialized view, o sistema recorre automaticamente à tabela source particionada. A figura a seguir ilustra esse processo.
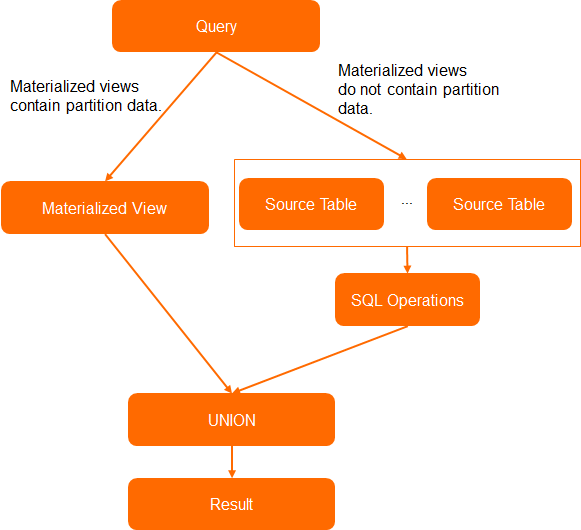
Para ativar o recurso de consulta transparente em uma materialized view, defina o seguinte parâmetro:
Ao criar a materialized view, adicione a configuração "enable_auto_substitute"="true" em tblproperties.
O exemplo a seguir demonstra como usar uma materialized view com suporte a consultas transparentes.
-
Crie uma materialized view particionada com suporte a consultas transparentes.
-- Create a source table named src. CREATE TABLE src(id bigint,name string) PARTITIONED BY (dt string); -- Insert data. INSERT INTO src PARTITION(dt='20210101') VALUES(1,'Alex'); INSERT INTO src PARTITION(dt='20210102') VALUES(2,'Flink'); -- Create a partitioned materialized view that supports penetration query. CREATE MATERIALIZED VIEW IF NOT EXISTS mv LIFECYCLE 7 PARTITIONED BY (dt) tblproperties("enable_auto_substitute"="true") AS SELECT id, name, dt FROM src; -
Consulte dados da partição
20210101na materialized viewmv.SELECT * FROM mv WHERE dt='20210101'; -
Consulte dados da partição
20210102na materialized viewmv. O sistema executa automaticamente uma consulta transparente na tabela source porque essa partição não está materializada.SELECT * FROM mv WHERE dt = '20210102'; -- Because the data for the 20210102 partition is not materialized, the query is rewritten to access the source table. This is equivalent to: SELECT * FROM (SELECT id, name, dt FROM src WHERE dt='20210102') t; -
Consulte dados de um intervalo de partições na materialized view
mv. O sistema executa automaticamente uma consulta transparente na tabela source para os dados não materializados e os combina com os dados materializados usando uma operaçãoUNIONantes de retornar o resultado.SELECT * FROM mv WHERE dt >= '20201230' AND dt<='20210102' AND id=5; -- Because data for partitions 20201230 and 20210102 is not materialized, the query is rewritten to access the source table. This is equivalent to: SELECT * FROM (SELECT id, name, dt FROM src WHERE dt='20201230' OR dt='20210102' UNION ALL SELECT * FROM mv WHERE dt='20210101' ) t WHERE id = 5;
Instruções relacionadas
ALTER MATERIALIZED VIEW: atualiza uma materialized view, altera seu ciclo de vida, ativa ou desativa o recurso de ciclo de vida ou remove partições de uma materialized view.
DESC TABLE/VIEW: visualiza informações sobre uma materialized view em um projeto MaxCompute.
SELECT MATERIALIZED VIEW: consulta o status de uma materialized view.
DROP MATERIALIZED VIEW: remove uma materialized view existente.