Modifica a estrutura, as propriedades ou as partições de uma tabela existente.
Notas de uso
A evolução de schema envolve operações como adicionar colunas com tipos de dados complexos, excluir colunas, reordenar colunas e alterar os tipos de dados das colunas. Ao reordenar colunas, adicionar e depois reordenar colunas, ou excluir colunas, o comportamento de leitura e gravação da tabela é afetado. As seguintes limitações se aplicam:
Se o tipo de job for MapReduce 1.0, as tarefas do Graph não poderão ler nem gravar dados na tabela modificada.
-
Para jobs do CUPID, apenas as seguintes versões do Spark podem ler dados da tabela. Não é possível gravar dados na tabela.
Spark-2.3.0-odps0.34.0
Spark-3.1.1-odps0.34.0
Os jobs do PAI podem ler dados da tabela, mas não podem gravar dados nela.
Para jobs do Hologres, se você usar uma versão do Hologres anterior à 1.3, não será possível ler ou gravar na tabela modificada ao referenciá-la como uma tabela externa.
Após a evolução de schema, não há suporte para o CLONE TABLE.
O Streaming Tunnel retorna um erro caso tenha ocorrido evolução de schema.
Alterar o proprietário da tabela
ALTER TABLE <table_name> changeowner TO <new_owner>;Parâmetros:
|
Parâmetro |
Obrigatório |
Descrição |
|
|
Sim |
O nome da tabela cujo proprietário você deseja alterar. |
|
|
Sim |
O nome da conta do novo proprietário. |
Exemplo:
-- Transfer ownership of the test1 table to ALIYUN$xxx@aliyun.com.
ALTER TABLE test1 changeowner TO 'ALIYUN$xxx@aliyun.com';
Alterar o comentário da tabela
ALTER TABLE <table_name> SET COMMENT '<new_comment>';Parâmetros:
|
Parâmetro |
Obrigatório |
Descrição |
|
|
Sim |
O nome da tabela cujo comentário você deseja alterar. |
|
|
Sim |
O texto do novo comentário. |
Exemplo:
ALTER TABLE sale_detail SET COMMENT 'new comments for table sale_detail';Execute DESC <table_name> para verificar o comentário atualizado.
Atualizar o LastModifiedTime de uma tabela
A operação touch define o LastModifiedTime para a hora atual, o que reinicia o cálculo do ciclo de vida da tabela.
ALTER TABLE <table_name> touch;Exemplo:
ALTER TABLE sale_detail touch;Alterar as propriedades de cluster de uma tabela
Adiciona ou remove propriedades de cluster para uma tabela particionada.
Você só pode alterar as propriedades de cluster em tabelas particionadas. Não é possível alterar as propriedades de cluster de tabelas não particionadas após a criação. A alteração afeta apenas novas partições (incluindo aquelas criadas por INSERT OVERWRITE). As partições antigas mantêm suas propriedades de cluster originais. Como esta instrução afeta apenas novas partições, você não pode especificar uma partição nesta instrução.
Sintaxe:
-- Add hash cluster properties.
ALTER TABLE <table_name> [clustered BY (<col_name> [, <col_name>, ...]) [sorted BY (<col_name> [ASC | DESC]
  [, <col_name> [ASC | DESC] ...])] INTO <number_of_buckets> buckets];

-- Remove hash or range cluster properties from a table.
ALTER TABLE <table_name> NOT clustered;

-- Add range cluster properties (bucket count is optional; the system auto-determines the optimal count).
ALTER TABLE <table_name> [RANGE clustered BY (<col_name> [, <col_name>, ...]) [sorted BY (<col_name> [ASC | DESC]
  [, <col_name> [ASC | DESC] ...])] INTO <number_of_buckets> buckets];

-- Remove range cluster properties from a partition or a table.
ALTER TABLE <table_name> NOT clustered;
ALTER TABLE <table_name> PARTITION [<pt_spec>] NOT clustered;
Os parâmetros são os mesmos do CREATE TABLE.
Exemplo:
-- Create a partitioned table.
CREATE TABLE IF NOT EXISTS sale_detail(
  shop_name     STRING,
  customer_id   STRING,
  total_price   DOUBLE)
PARTITIONED BY (sale_date STRING, region STRING);

-- Add hash cluster properties. New partitions are stored with these settings.
ALTER TABLE sale_detail clustered BY (customer_id) sorted BY (customer_id) INTO 10 buckets;
Para obter detalhes sobre os tipos de clustering, consulte Hash Clustering e Range clustering.
Alterar as propriedades de uma PK Delta Table
-- Update the bucket count for a partitioned PK Delta Table.
ALTER TABLE <table_name> SET tblproperties("write.bucket.num"="64");

-- Update the bucket count for a non-partitioned PK Delta Table.-- Existing data is redistributed based on the new bucket count.
ALTER TABLE <table_name> REWRITE tblproperties("write.bucket.num"="128");

-- Update the retain property: the time range (in hours) for Time Travel queries.
ALTER TABLE <table_name> SET tblproperties("acid.data.retain.hours"="60");
Renomear uma tabela
Renomeia uma tabela sem modificar seus dados.
ALTER TABLE <table_name> RENAME TO <new_table_name>;Parâmetros:
|
Parâmetro |
Obrigatório |
Descrição |
|
|
Sim |
A tabela a ser renomeada. |
|
|
Sim |
O novo nome. O sistema retorna um erro se já existir uma tabela com este nome. |
Exemplo:
ALTER TABLE sale_detail RENAME TO sale_detail_rename;Modificar o período do ciclo de vida
Altera o período do ciclo de vida de uma tabela particionada ou não particionada existente.
ALTER TABLE <table_name> SET LIFECYCLE <days>;Parâmetros:
|
Parâmetro |
Obrigatório |
Descrição |
|
|
Sim |
O nome da tabela cujo período do ciclo de vida você deseja alterar. |
|
|
Sim |
O novo período do ciclo de vida, em dias. Deve ser um número inteiro positivo. |
Exemplo:
-- Modify the lifecycle of sale_detail_rename to 50 days.
ALTER TABLE sale_detail_rename SET LIFECYCLE 50;
Ativar ou desativar o ciclo de vida
Ativa ou desativa o ciclo de vida de uma tabela ou de uma partição específica.
ALTER TABLE <table_name> PARTITION [<pt_spec>] {enable|disable} LIFECYCLE;Parâmetros:
|
Parâmetro |
Obrigatório |
Descrição |
|
|
Sim |
O nome da tabela. |
|
|
Não |
A partição de destino. Formato: |
|
|
— |
Reaplica a expiração do ciclo de vida na tabela e em suas partições usando as configurações atuais do ciclo de vida. Atualize as configurações do ciclo de vida antes de ativar, se necessário, para evitar a expiração não intencional de dados. |
|
|
— |
Impede que a tabela e todas as suas partições expirem. Isso tem prioridade sobre qualquer configuração |
Exemplos:
-- Example 1: Disable the lifecycle for the sale_detail_rename table.
ALTER TABLE sale_detail_rename disable LIFECYCLE;

-- Example 2: Add test partitions.
ALTER TABLE sale_detail_rename ADD IF NOT EXISTSPARTITION (sale_date='201910', region='shanghai') PARTITION (sale_date='201911', region='shanghai')
  PARTITION (sale_date='201912', region='shanghai') PARTITION (sale_date='202001', region='shanghai')
  PARTITION (sale_date='202002', region='shanghai') PARTITION (sale_date='201910', region='beijing')
  PARTITION (sale_date='201911', region='beijing') PARTITION (sale_date='201912', region='beijing')
  PARTITION (sale_date='202001', region='beijing') PARTITION (sale_date='202002', region='beijing');

-- Disable the lifecycle for a single partition.
ALTER TABLE sale_detail_rename PARTITION (sale_date='201912', region='shanghai') disable LIFECYCLE;
Adicionar uma partição
Adicione uma ou mais partições a uma tabela particionada existente.
Notas de uso
Para uma tabela particionada em vários níveis, especifique valores para todas as colunas de chave de partição ao adicionar uma partição.
Esta operação adiciona apenas valores de partição. Ela não adiciona colunas de chave de partição.
Sintaxe
ALTER TABLE <table_name> ADD [IF NOT EXISTS] PARTITION <pt_spec> [PARTITION <pt_spec> PARTITION <pt_spec>...];Parâmetros
|
Parâmetro |
Obrigatório |
Descrição |
|
table_name |
Sim |
O nome da tabela particionada. |
|
IF NOT EXISTS |
Não |
Suprime o erro se a partição já existir. |
|
pt_spec |
Sim |
A partição a ser adicionada, no formato |
Exemplos
Os exemplos a seguir usam uma tabela particionada chamada sale_detail. Para criar esta tabela, consulte Create and delete tables.
CREATE TABLE IF NOT EXISTS sale_detail(
  shop_name     STRING,
  customer_id   STRING,
  total_price   DOUBLE)
PARTITIONED BY (sale_date STRING, region STRING);-
Adicionar uma única partição
Adicione uma partição para a região de Hangzhou em dezembro de 2025.
ALTER TABLE sale_detail ADD IF NOT EXISTS PARTITION (sale_date='202512', region='hangzhou'); -
Adicionar várias partições de uma vez
Adicione duas partições para as regiões de Pequim e Xangai em dezembro de 2025.
ALTER TABLE sale_detail ADD IF NOT EXISTS PARTITION (sale_date='202512', region='beijing') PARTITION (sale_date='202512', region='shanghai'); -
Especificação de partição incompleta (erro)
Especificar apenas parte de uma chave de partição de vários níveis retorna um erro. Tanto
sale_datequantoregionsão obrigatórios.ALTER TABLE sale_detail ADD IF NOT EXISTS PARTITION (sale_date='20260111'); -- Error returned: -- FAILED: ODPS-0130071:[1,58] Semantic analysis exception - provided partition spec does not match table partition spec -
Adicionar uma partição a uma Delta Table
-- Create a Delta Table. CREATE TABLE delta_table_test_par ( pk BIGINT NOT NULL PRIMARY KEY, val BIGINT NOT NULL) PARTITIONED BY (dd STRING, hh STRING) TBLPROPERTIES ("transactional"="true"); -- Add a partition. ALTER TABLE delta_table_test_par ADD PARTITION (dd='01', hh='01'); CREATE TABLE delta_table_test_nonpar ( pk BIGINT NOT NULL PRIMARY KEY, val BIGINT NOT NULL) TBLPROPERTIES ("transactional"="true"); -
Modificar propriedades de uma PK Delta Table
-- Update the number of buckets for a partitioned PK Delta Table.
ALTER TABLE delta_table_test_par SET TBLPROPERTIES("write.bucket.num"="64");

-- Update the number of buckets for a non-partitioned PK Delta Table.
-- After the update, historical data is redistributed based on the new bucket count.
ALTER TABLE delta_table_test_nonpar REWRITE TBLPROPERTIES("write.bucket.num"="128");

-- Update the retain property. This property specifies the number of hours
-- for querying historical data states via Time Travel.
ALTER TABLE delta_table_test_par SET TBLPROPERTIES("acid.data.retain.hours"="60");
Após adicionar as partições, verifique-as com SHOW PARTITIONS. Consulte List all partitions.
Modificar o horário de atualização da partição
A operação touch redefine o LastModifiedTime de uma partição para a hora atual, acionando o recálculo do ciclo de vida.
Notas de uso
Para uma tabela particionada em vários níveis, especifique valores para todas as colunas de chave de partição.
Sintaxe
ALTER TABLE <table_name> TOUCH PARTITION (<pt_spec>);Parâmetros
|
Parâmetro |
Obrigatório |
Descrição |
|
table_name |
Sim |
O nome da tabela particionada. Retorna um erro se a tabela não existir. |
|
pt_spec |
Sim |
A partição a ser atualizada, no formato |
Exemplos
-- Update the LastModifiedTime of a specific partition in the sale_detail table.
ALTER TABLE sale_detail TOUCH PARTITION (sale_date='202512', region='shanghai');
Modificar um valor de partição
O RENAME altera os valores de uma partição existente.
Notas de uso
Esta operação altera apenas os valores da partição. Ela não renomeia as colunas de chave de partição.
Para uma tabela particionada em vários níveis, especifique valores para todas as colunas de chave de partição.
Sintaxe
ALTER TABLE <table_name> PARTITION (<pt_spec>) RENAME TO PARTITION (<new_pt_spec>);Parâmetros
|
Parâmetro |
Obrigatório |
Descrição |
|
table_name |
Sim |
O nome da tabela particionada. |
|
pt_spec |
Sim |
A especificação atual da partição, no formato |
|
new_pt_spec |
Sim |
A nova especificação da partição, no formato |
Exemplos
-- Rename a partition in the sale_detail table.
ALTER TABLE sale_detail PARTITION (sale_date = '201312', region = 'hangzhou') RENAME TO PARTITION (sale_date = '201310', region = 'beijing');
Mesclar partições
O MERGE PARTITION combina várias partições em uma única partição de destino. Os dados são movidos para o destino e as partições de origem são excluídas.
Notas de uso
Tabelas externas não são suportadas.
Mesclar partições de uma tabela com cluster remove o clustering da partição resultante.
É possível mesclar no máximo 4.000 partições por vez.
Sintaxe
ALTER TABLE <table_name> MERGE [IF EXISTS] PARTITION (<predicate>) [, PARTITION(<predicate2>) ...] OVERWRITE PARTITION (<fullpartitionSpec>) [PURGE];Parâmetros
|
Parâmetro |
Obrigatório |
Descrição |
|
table_name |
Sim |
O nome da tabela particionada. |
|
IF EXISTS |
Não |
Suprime o erro se nenhuma partição corresponder à condição. Se nenhuma partição se qualificar, nenhuma nova partição será criada. Operações simultâneas de |
|
predicate |
Sim |
A condição que as partições de origem devem atender. |
|
fullpartitionSpec |
Sim |
A especificação da partição de destino. |
|
PURGE |
Não |
Limpa o diretório da sessão. Por padrão, os logs dos últimos três dias são limpos. Para mais detalhes, consulte Purge. |
Exemplos
Mesclar partições por condição
-- View current partitions.
SHOW PARTITIONS sale_detail;

-- Sample result:
-- sale_date=202512/region=beijing
-- sale_date=202512/region=shanghai
-- sale_date=202602/region=beijing

-- Merge all partitions where sale_date='202512' into a single destination partition.
ALTER TABLE sale_detail MERGE PARTITION(sale_date='202512') OVERWRITE PARTITION(sale_date='202601', region='hangzhou');

-- View partitions after the merge.
SHOW PARTITIONS sale_detail;

-- Sample result:
-- sale_date=202601/region=hangzhou
-- sale_date=202602/region=beijing
Mesclar partições específicas com PURGE
-- Merge two named partitions into a new destination partition.
ALTER TABLE sale_detail MERGE IF EXISTS
  PARTITION(sale_date='202601', region='hangzhou'),
  PARTITION(sale_date='202602', region='beijing')
  OVERWRITE PARTITION(sale_date='202603', region='shanghai') PURGE;

-- View partitions after the merge.
SHOW PARTITIONS sale_detail;

-- Sample result:
-- sale_date=202603/region=shanghai
Excluir uma partição
Remova uma ou mais partições de uma tabela. Você pode excluir partições específicas por nome ou usar condições de filtro para exclusão em massa.
Excluir partições reduz o uso de armazenamento. Para automatizar a exclusão de partições antigas, use o recurso Lifecycle.
Notas de uso
Cada cláusula de filtro de partição pode referenciar apenas uma coluna de chave de partição.
As funções usadas nas expressões de filtro devem ser funções escalares integradas.
Sintaxe
Excluir partições específicas
-- Delete one partition.
ALTER TABLE <table_name> DROP [IF EXISTS] PARTITION <pt_spec>;

-- Delete multiple partitions.
ALTER TABLE <table_name> DROP [IF EXISTS] PARTITION <pt_spec>,PARTITION <pt_spec>[,PARTITION <pt_spec>....];
Excluir partições por condição de filtro
ALTER TABLE <table_name> DROP [IF EXISTS] PARTITION <partition_filtercondition>;Parâmetros
|
Parâmetro |
Obrigatório |
Descrição |
|
table_name |
Sim |
O nome da tabela particionada. |
|
IF EXISTS |
Não |
Suprime o erro se a partição não existir. |
|
pt_spec |
Sim |
A partição a ser excluída, no formato |
|
partition_filtercondition |
Não |
Obrigatório quando você usa a exclusão baseada em filtro. Consulte Partition filter condition syntax. |
Sintaxe da condição de filtro de partição
Tanto as operações de exclusão quanto de truncamento suportam a mesma sintaxe de filtro de partição:
partition_filtercondition
    : PARTITION (<partition_col> <relational_operators> <partition_col_value>)
    | PARTITION (scalar(<partition_col>) <relational_operators> <partition_col_value>)
    | PARTITION (<partition_filtercondition1> AND|OR <partition_filtercondition2>)
    | PARTITION (NOT <partition_filtercondition>)
| PARTITION (<partition_filtercondition1>)[,PARTITION (<partition_filtercondition2>), ...]|
Elemento |
Descrição |
|
partition_col |
O nome da coluna de chave de partição. |
|
relational_operators |
Um operador relacional. Para obter detalhes, consulte Operators. |
|
partition_col_value |
Um valor ou expressão regular para comparar com o valor da coluna de chave de partição. O tipo de dados deve corresponder ao tipo da coluna de chave de partição. |
|
scalar() |
Uma função escalar integrada. Processa o valor da coluna de chave de partição antes da comparação. |
|
NOT, AND, OR |
Operadores lógicos suportados dentro de uma única cláusula de filtro. |
|
Cláusulas separadas por vírgula |
Várias cláusulas de filtro separadas por vírgulas são combinadas com o operador OR. |
Exemplos
Excluir partições específicas
-- Delete one partition.
ALTER TABLE sale_detail DROP IF EXISTS PARTITION(sale_date='202603',region='shanghai');

-- Delete two partitions at once.
ALTER TABLE sale_detail DROP IF EXISTS PARTITION(sale_date='202412',region='hangzhou'),PARTITION(sale_date='202412',region='shanghai');
Excluir partições por condição de filtro (tabela de nível único)
-- Create a single-level partitioned table with sample partitions.
CREATE TABLE IF NOT EXISTS sale_detail_del(
shop_name     STRING,
customer_id   STRING,
total_price   DOUBLE)
PARTITIONED BY (sale_date STRING);

-- Add partitions.
ALTER TABLE sale_detail_del ADD IF NOT EXISTS
PARTITION (sale_date= '201910') PARTITION (sale_date= '201911') PARTITION (sale_date= '201912')
PARTITION (sale_date= '202001') PARTITION (sale_date= '202002') PARTITION (sale_date= '202003')
PARTITION (sale_date= '202004') PARTITION (sale_date= '202005') PARTITION (sale_date= '202006')
PARTITION (sale_date= '202007');

-- Delete by comparison.
ALTER TABLE sale_detail_del DROP IF EXISTS PARTITION(sale_date < '201911');
ALTER TABLE sale_detail_del DROP IF EXISTS PARTITION(sale_date >= '202007');

-- Delete by pattern matching.
ALTER TABLE sale_detail_del DROP IF EXISTS PARTITION(sale_date LIKE '20191%');

-- Delete by value list.
ALTER TABLE sale_detail_del DROP IF EXISTS PARTITION(sale_date IN ('202002','202004','202006'));

-- Delete by range.
ALTER TABLE sale_detail_del DROP IF EXISTS PARTITION(sale_date BETWEEN '202001' AND '202007');

-- Delete using a scalar function.
ALTER TABLE sale_detail_del DROP IF EXISTS PARTITION(substr(sale_date, 1, 4) = '2020');

-- Delete with OR condition.
ALTER TABLE sale_detail_del DROP IF EXISTS PARTITION(sale_date < '201912' OR sale_date >= '202006');

-- Delete with AND condition.
ALTER TABLE sale_detail_del DROP IF EXISTS PARTITION(sale_date > '201912' AND sale_date <= '202004');

-- Delete with NOT condition.
ALTER TABLE sale_detail_del DROP IF EXISTS PARTITION(NOT sale_date > '202004');

-- Multiple filter clauses separated by commas are combined with OR.
ALTER TABLE sale_detail_del DROP IF EXISTS PARTITION(sale_date < '201911'), PARTITION(sale_date >= '202007');

-- Delete by regular expression.
ALTER TABLE sale_detail_del ADD IF NOT EXISTS
PARTITION (sale_date= '2019-10-05')
PARTITION (sale_date= '2019-10-06')
PARTITION (sale_date= '2019-10-07');

ALTER TABLE sale_detail_del DROP IF EXISTS PARTITION(sale_date RLIKE '2019-\\d+-\\d+');
Excluir partições de uma tabela com particionamento de vários níveis
-- Create a multi-level partitioned table with sample partitions.
CREATE TABLE IF NOT EXISTS region_sale_detail(
shop_name     STRING,
customer_id   STRING,
total_price   DOUBLE)
PARTITIONED BY (sale_date STRING , region STRING );

-- Add partitions.
ALTER TABLE region_sale_detail ADD IF NOT EXISTS
PARTITION (sale_date= '201910',region = 'shanghai') PARTITION (sale_date= '201911',region = 'shanghai')
PARTITION (sale_date= '201912',region = 'shanghai') PARTITION (sale_date= '202001',region = 'shanghai')
PARTITION (sale_date= '202002',region = 'shanghai') PARTITION (sale_date= '201910',region = 'beijing')
PARTITION (sale_date= '201911',region = 'beijing') PARTITION (sale_date= '201912',region = 'beijing')
PARTITION (sale_date= '202001',region = 'beijing') PARTITION (sale_date= '202002',region = 'beijing');

-- Comma-separated filter clauses are combined with OR.
-- This deletes all partitions where sale_date < '201911' OR region = 'beijing'.
ALTER TABLE region_sale_detail DROP IF EXISTS PARTITION(sale_date < '201911'),PARTITION(region = 'beijing');

-- To combine conditions with AND, place both conditions in a single clause.
-- This deletes only partitions where sale_date < '201911' AND region = 'beijing'.
ALTER TABLE region_sale_detail DROP IF EXISTS PARTITION(sale_date < '201911', region = 'beijing');
Cada cláusula de filtro pode referenciar apenas uma coluna de chave de partição. Usar AND para combinar várias colunas de chave de partição em uma única cláusula de filtro retorna um erro.
-- The following statement fails because it references two partition key columns
-- (sale_date and region) with AND in a single filter clause.
ALTER TABLE region_sale_detail DROP IF EXISTS PARTITION(sale_date < '201911' AND region = 'beijing');

-- Error returned:
-- FAILED: ODPS-0130071:[1,82] Semantic analysis exception - invalid column reference region,
-- partition expression must have one and only one column reference
Adicionar colunas ou comentários
Você pode adicionar colunas ou comentários a uma tabela não particionada ou particionada existente. Para mais detalhes sobre as restrições, consulte Usage notes. O MaxCompute suporta a adição de colunas do tipo STRUCT, como STRUCT<x: STRING, y: BIGINT> e MAP<STRING, STRUCT<x: DOUBLE, y: DOUBLE>>.
-
Pré-requisitos
Execute o comando
setproject odps.schema.evolution.enable=true;para ativar a evolução de schema.Permissões: Esta é uma propriedade no nível do projeto. Para executar este comando, você deve ser o proprietário do projeto ou ter a função Super_Administrator ou Admin no nível do projeto. Para mais informações, consulte Assign a built-in management role to a user.
Tempo de efetivação: A alteração entra em vigor em aproximadamente 10 minutos.
-
Sintaxe
ALTER TABLE <table_name> ADD COLUMNS [IF NOT EXISTS] (<col_name1> <type1> COMMENT ['<col_comment>'] [, <col_name2> <type2> COMMENT '<col_comment>'...] ); -
Parâmetros
Parâmetro
Obrigatório
Descrição
table_name
Sim
O nome da tabela a ser modificada. As novas colunas são adicionadas ao final da tabela.
col_name
Sim
O nome da nova coluna.
type
Sim
O tipo de dados da nova coluna.
col_comment
Não
O comentário para a nova coluna.
-
Exemplos
-
Exemplo 1: Adicionar duas colunas à tabela sale_detail.
ALTER TABLE sale_detail ADD COLUMNS IF NOT EXISTS(customer_name STRING, education BIGINT); -
Exemplo 2: Adicionar duas colunas com comentários à tabela sale_detail.
ALTER TABLE sale_detail ADD COLUMNS (customer_name STRING COMMENT 'Customer', education BIGINT COMMENT 'Education' ); -
Exemplo 3: Adicionar uma coluna de um tipo de dados complexo à tabela sale_detail.
ALTER TABLE sale_detail ADD COLUMNS (region_info struct<province:string, area:string>); -
Exemplo 4: Se você usar IF NOT EXISTS para adicionar uma coluna que já existe, o comando retorna uma mensagem de sucesso sem adicionar a coluna novamente.
-- The statement is successful, but the ID column is not repeatedly added. ALTER TABLE sale_detail ADD COLUMNS IF NOT EXISTS(id bigint); -
Exemplo 5: Adicionar uma coluna a uma Delta table.
CREATE TABLE delta_table_test (pk BIGINT NOT NULL PRIMARY KEY, val BIGINT)
  TBLPROPERTIES ("transactional"="true");

ALTER TABLE delta_table_test ADD COLUMNS (val2 bigint);
-
Excluir colunas
Você pode excluir uma ou mais colunas de uma tabela não particionada ou particionada existente. Para mais detalhes sobre as restrições, consulte Usage notes.
-
Pré-requisitos
Execute o comando
setproject odps.schema.evolution.enable=true;para ativar a evolução de schema.Permissões: Esta é uma propriedade no nível do projeto. Para executar este comando, você deve ser o proprietário do projeto ou ter a função Super_Administrator ou Admin no nível do projeto. Para mais informações, consulte Assign a built-in management role to a user.
Tempo de efetivação: A alteração entra em vigor em aproximadamente 10 minutos.
-
Sintaxe
-- Delete a single column. ALTER TABLE <table_name> DROP COLUMN <col_name>; -- Delete multiple columns. ALTER TABLE <table_name> DROP COLUMNS <col_name1>[, <col_name2>...]; -
Parâmetros
table_name: Obrigatório. O nome da tabela a ser modificada.
col_name: Obrigatório. O nome da coluna a ser excluída.
-
Exemplos
-- Example 1: Delete the customer_id column from the sale_detail table.
ALTER TABLE sale_detail DROP COLUMNS customer_id;

-- Example 2: Delete the shop_name and total_price columns from the sale_detail table.
ALTER TABLE sale_detail DROP COLUMNS shop_name, total_price;
Alterar os tipos de dados das colunas
Você pode alterar o tipo de dados de uma coluna existente. Para mais detalhes sobre as restrições, consulte Usage notes.
-
Pré-requisitos
Execute o comando
setproject odps.schema.evolution.enable=true;para ativar a evolução de schema.Permissões: Esta é uma propriedade no nível do projeto. Para executar este comando, você deve ser o proprietário do projeto ou ter a função Super_Administrator ou Admin no nível do projeto. Para mais informações, consulte Assign a built-in management role to a user.
Tempo de efetivação: A alteração entra em vigor em aproximadamente 10 minutos.
-
Sintaxe
ALTER TABLE <table_name> CHANGE [COLUMN] <old_column_name> <new_column_name> <new_data_type>; -
Parâmetros
Parâmetro
Obrigatório
Descrição
table_name
Sim
O nome da tabela que contém a coluna.
old_column_name
Sim
O nome da coluna a ser modificada.
new_column_name
Sim
O novo nome da coluna.
old_column_name pode ser igual a new_column_name, o que indica que o nome da coluna não é modificado. No entanto, new_column_name não pode ser igual ao nome de nenhuma outra coluna além de old_column_name.
new_data_type
Sim
O novo tipo de dados para a coluna.
-
Exemplo
-- Change the data type of the id field in the sale_detail table from BIGINT to STRING. ALTER TABLE sale_detail CHANGE COLUMN id id STRING; -
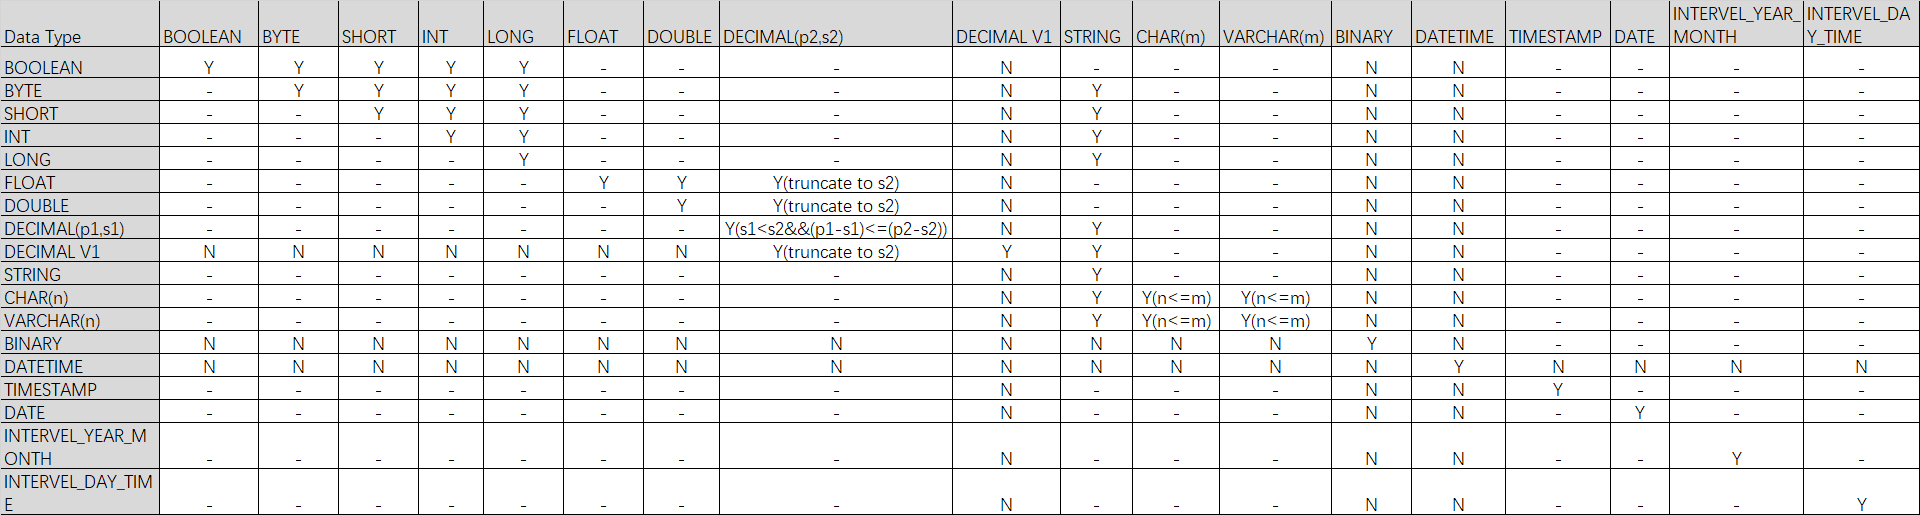
Conversões de tipo de dados suportadas
NotaY indica que a conversão é suportada. N indica que a conversão não é suportada. - indica que a conversão não se aplica. Y() indica que a conversão é suportada se a condição entre parênteses for atendida.
Alterar a ordem das colunas
Você pode alterar a ordem das colunas em uma tabela não particionada ou particionada existente. Para mais detalhes sobre as restrições, consulte Usage notes.
-
Pré-requisitos
Execute o comando
setproject odps.schema.evolution.enable=true;para ativar a evolução de schema.Permissões: Esta é uma propriedade no nível do projeto. Para executar este comando, você deve ser o proprietário do projeto ou ter a função Super_Administrator ou Admin no nível do projeto. Para mais informações, consulte Assign a built-in management role to a user.
Tempo de efetivação: A alteração entra em vigor em aproximadamente 10 minutos.
-
Sintaxe
ALTER TABLE <table_name> CHANGE <old_column_name> <new_column_name> <column_type> AFTER <column_name>; -
Parâmetros
Parâmetro
Obrigatório
Descrição
table_name
Sim
O nome da tabela a ser modificada.
old_column_name
Sim
O nome da coluna a ser movida.
new_col_name
Sim
O novo nome da coluna.
new_col_name pode ser igual a old_column_name, o que indica que o nome da coluna não é modificado. No entanto, new_col_name não pode ser igual a nenhum outro nome de coluna além de old_column_name.
column_type
Sim
O tipo de dados original da coluna. Isso não pode ser alterado.
column_name
Sim
Move a coluna a ser reordenada para depois de column_name.
-
Exemplos
-- Change the name of the customer column in the sale_detail table to customer_id and move it after the total_price column.
ALTER TABLE sale_detail CHANGE customer customer_id STRING AFTER total_price;

-- Move the customer_id column in the sale_detail table after the total_price column without changing the column name.
ALTER TABLE sale_detail CHANGE customer_id customer_id STRING AFTER total_price;
Alterar o nome de uma coluna
Você pode alterar o nome de uma coluna em uma tabela não particionada ou particionada existente.
-
Sintaxe
ALTER TABLE <table_name> CHANGE COLUMN <old_col_name> RENAME TO <new_col_name>; -
Parâmetros
Parâmetro
Obrigatório
Descrição
table_name
Sim
O nome da tabela a ser modificada.
old_col_name
Sim
O nome atual da coluna. A coluna deve existir.
new_col_name
Sim
O novo nome para a coluna. O nome da coluna deve ser exclusivo dentro da tabela.
-
Exemplo
-- Rename the customer_name column in the sale_detail table to customer.
ALTER TABLE sale_detail CHANGE COLUMN customer_name RENAME TO customer;
Alterar o comentário de uma coluna
Você pode alterar o comentário de uma coluna em uma tabela não particionada ou particionada existente.
-
Sintaxe
ALTER TABLE <table_name> CHANGE COLUMN <col_name> COMMENT '<col_comment>'; -
Parâmetros
Parâmetro
Obrigatório
Descrição
table_name
Sim
O nome da tabela a ser modificada.
col_name
Sim
O nome da coluna cujo comentário você deseja alterar. A coluna deve existir.
col_comment
Sim
O novo comentário, que deve ser uma string válida. O comprimento máximo é de 1.024 bytes.
-
Exemplo
-- Change the comment of the customer column in the sale_detail0113 table.
ALTER TABLE sale_detail0113 CHANGE COLUMN customer COMMENT 'customer';
Alterar o nome e o comentário de uma coluna
Você pode alterar o nome e o comentário de uma coluna em uma tabela não particionada ou particionada.
-
Sintaxe
ALTER TABLE <table_name> CHANGE COLUMN <old_col_name> <new_col_name> <column_type> COMMENT '<col_comment>'; -
Parâmetros
Parâmetro
Obrigatório
Descrição
table_name
Sim
O nome da tabela a ser modificada.
old_col_name
Sim
O nome atual da coluna a ser modificada. A coluna deve existir.
new_col_name
Sim
O novo nome para a coluna. O nome da coluna deve ser exclusivo dentro da tabela.
column_type
Sim
O tipo de dados da coluna.
col_comment
Opcional
O novo comentário. O comprimento máximo é de 1.024 bytes.
-
Exemplo
-- Change the name of the customer column in the sale_detail table to customer_newname and change its comment to 'customer'.
ALTER TABLE sale_detail CHANGE COLUMN customer customer_newname STRING COMMENT 'customer';
Alterar a propriedade NOT NULL de uma coluna
Você pode alterar a propriedade NOT NULL de uma coluna que não seja chave de partição. Por exemplo, se uma coluna que não seja chave de partição estiver definida para não permitir valores NULL, você pode usar este comando para alterá-la e permitir valores NULL.
Esta operação é irreversível: você não pode alterar uma coluna de volta para não permitir valores NULL após permiti-los.
-
Execute o comando
DESC EXTENDED table_name;para visualizar a propriedadeNullablee determinar se a coluna permite valores NULL:Se
Nullablefortrue, valores NULL são permitidos.Se
Nullableforfalse, valores NULL não são permitidos.
-
Sintaxe
ALTER TABLE <table_name> CHANGE COLUMN <old_col_name> NULL; -
Parâmetros
Parâmetro
Obrigatório
Descrição
table_name
Sim
O nome da tabela a ser modificada.
old_col_name
Sim
O nome da coluna que não seja chave de partição a ser modificada. A coluna deve existir.
-
Exemplo
-- Create a partitioned table in which the id column cannot be NULL.
CREATE TABLE null_test(id INT NOT NULL, name STRING) PARTITIONED BY (ds string);

-- View table properties.
DESC EXTENDED null_test;
-- The following result is returned:
+------------------------------------------------------------------------------------+
| Native Columns:                                                                    |
+------------------------------------------------------------------------------------+
| Field    | Type   | Label | ExtendedLabel | Nullable | DefaultValue | Comment      |
+------------------------------------------------------------------------------------+
| id       | int    |       |               | false    | NULL         |              |
| name     | string |       |               | true     | NULL         |              |
+------------------------------------------------------------------------------------+
| Partition Columns:                                                                 |
+------------------------------------------------------------------------------------+
| ds              | string     |                                                     |
+------------------------------------------------------------------------------------+

-- Allow the id column to be NULL.
ALTER TABLE null_test CHANGE COLUMN id NULL;
-- View table properties.
DESC EXTENDED null_test;
-- The following result is returned:
+------------------------------------------------------------------------------------+
| Native Columns:                                                                    |
+------------------------------------------------------------------------------------+
| Field    | Type   | Label | ExtendedLabel | Nullable | DefaultValue | Comment      |
+------------------------------------------------------------------------------------+
| id       | int    |       |               | true     | NULL         |              |
| name     | string |       |               | true     | NULL         |              |
+------------------------------------------------------------------------------------+
| Partition Columns:                                                                 |
+------------------------------------------------------------------------------------+
| ds              | string     |                                                     |
+------------------------------------------------------------------------------------+
Compactar arquivos de tabela transacional
O armazenamento físico subjacente de uma tabela transacional consiste em arquivos base e arquivos delta, que o sistema não lê diretamente. Ao executar operações de update ou delete em uma tabela transacional, o sistema anexa apenas arquivos delta, sem modificar os arquivos base. Consequentemente, um maior volume de atualizações ou exclusões aumenta o consumo de armazenamento e os custos de consulta.
A execução de várias operações de update ou delete na mesma tabela ou partição gera um grande número de arquivos delta. Ao ler dados, o sistema carrega esses arquivos delta para determinar quais linhas foram atualizadas ou excluídas. O excesso de arquivos delta degrada o desempenho de leitura de dados. Nesse caso, compacte os arquivos base e os arquivos delta para reduzir o armazenamento e melhorar o desempenho de leitura de dados.
-
Sintaxe
ALTER TABLE <table_name> [PARTITION (<partition_key> = '<partition_value>' [, ...])] compact {minor|major}; -
Parâmetros
table_name: Obrigatório. O nome da tabela transacional cujos arquivos serão compactados.
partition_key: Opcional. O nome da coluna de partição se a tabela transacional for uma tabela particionada.
partition_value: Opcional. O valor da coluna de partição se a tabela transacional for uma tabela particionada.
-
major|minor: Especifique pelo menos um. As diferenças são as seguintes:
minor: Mescla os arquivos base e todos os arquivos delta associados para eliminar os arquivos delta.major: Não apenas mescla os arquivos base e todos os arquivos delta associados para eliminar os arquivos delta, mas também mescla arquivos pequenos entre os arquivos base da tabela. Quando os arquivos base são pequenos (menos de 32 MB) ou existem arquivos delta, isso equivale a executar uma operação deinsert overwritena tabela. No entanto, quando os arquivos base são suficientemente grandes (32 MB ou mais) e não existem arquivos delta, nenhuma reescrita ocorre.
-
Exemplos
-
Exemplo 1: Compactar arquivos da tabela transacional acid_delete.
ALTER TABLE acid_delete compact minor;Saída de exemplo:
Summary: Nothing found to merge, set odps.merge.cross.paths=true IF cross path merge is permitted. OK -
Exemplo 2: Compactar arquivos da tabela transacional acid_update_pt.
ALTER TABLE acid_update_pt PARTITION (ds = '2019') compact major;Saída de exemplo:
Summary:
table name: acid_update_pt /ds=2019  instance count: 2  run time: 6
  before merge, file count:        8  file size: 2613  file physical size: 7839
   after merge, file count:        2  file size: 679  file physical size: 2037

OK
-
Mesclar arquivos pequenos
Um sistema de arquivos distribuído armazena dados em blocos. Arquivos menores que o tamanho do bloco (64 MB) são chamados de arquivos pequenos. Sistemas distribuídos inevitavelmente geram arquivos pequenos, como resultados de computação SQL ou de outros mecanismos distribuídos, além de saídas de ingestão de dados do Tunnel. Mesclar arquivos pequenos pode melhorar o desempenho de computação.
Sintaxe
ALTER TABLE <tablename> [PARTITION(<partition_key>=<partition_value>)] MERGE SMALLFILES;-
Parâmetros
table_name: Obrigatório. O nome da tabela cujos arquivos serão mesclados.
partition_key: Opcional. O nome da coluna de partição se a tabela for uma tabela particionada.
partition_value: Opcional. O valor da coluna de partição se a tabela for uma tabela particionada.
-
Exemplos
SET odps.merge.cross.paths=true;
SET odps.merge.smallfile.filesize.threshold=128;
SET odps.merge.max.filenumber.per.instance = 2000;
ALTER TABLE tbcdm.dwd_tb_log_pv_di PARTITION (ds='20151116') MERGE smallfiles;
O recurso de mesclagem de arquivos pequenos requer recursos de computação. Para instâncias com pagamento conforme o uso, esta operação incorre em taxas. As regras de faturamento seguem o mesmo modelo de pagamento conforme o uso para SQL. Para mais detalhes, consulte Compute pricing (pay-as-you-go).
Para mais informações, consulte Merge small files.
Instruções relacionadas
CREATE TABLE: Cria uma tabela não particionada, tabela particionada, tabela externa ou tabela com cluster.
TRUNCATE TABLE: Trunca dados em uma tabela especificada.
DROP TABLE: Exclui uma tabela particionada ou não particionada.
DESC TABLE/VIEW: Visualiza informações sobre tabelas internas do MaxCompute, visualizações, visualizações materializadas, tabelas externas, tabelas com cluster ou tabelas transacionais.
SHOW: Visualiza a instrução SQL DDL de uma tabela, lista todas as tabelas e visualizações em um projeto ou lista todas as partições de uma tabela.\