Este tópico descreve o conceito e as classificações de código legado, além de fornecer estratégias para diferentes tipos de código legado. Adicionalmente, este tópico foca em como o AI Coding AssistantCoding Assistant pode apoiar você na manutenção de código legado.
AI Coding Assistant
O novo site de documentação do Qoder CN já está disponível. O conteúdo deste site pode não refletir os recursos e as alterações mais recentes do product. Visite docs.qoder.cn para acessar a documentação mais recente do product.
Código legado
-
Código relacionado a tecnologias desatualizadas:
Código relacionado a sistemas operacionais ou bibliotecas de software que não recebem mais suporte.
Código que depende de stacks de tecnologia ou linguagens de programação obsoletas.
-
Código mantido para compatibilidade com recursos legados:
Trechos de código mantidos para compatibilidade com versões mais antigas de recursos em softwares modernos.
Código que precisa ser mantido para compatibilidade com versões anteriores (backward compatibility).
-
Código sem documentação correspondente e sem manutenção:
Código antigo que não possui documentação correspondente.
Código que carece de práticas modernas de desenvolvimento, como testes de unidade e revisões de código.
Soluções para código legado
Utilize uma das estratégias a seguir para resolver problemas de código legado:
Estratégia | Prós e contras |
Reescrever o código | Os custos são altos e o sistema existente pode continuar a executar conforme o esperado, o que gera riscos no código. |
Refatorar o código | |
Adicionar testes de unidade | Os testes de unidade identificam problemas no código e fornecem garantia de qualidade para possíveis alterações no código. |
A tabela anterior mostra que adicionar testes de unidade é um método eficaz para resolver problemas de código legado. No entanto, os seguintes desafios ainda existem com esse método:
Grande parte do código legado não possui testes de unidade, e os custos de teste são muito altos devido às dependências complexas entre os códigos.
Não há métricas específicas claras para definir um teste de unidade adequado.
O código que requer testes de unidade não é identificado claramente.
Erros comuns em testes de unidade
Testes de unidade falsos sem asserções: Desenvolvedores podem chamar funções sem asserções para melhorar a cobertura de código, o que resulta em muitos testes de unidade inválidos.
Testes de unidade considerados como testes de caixa branca: Algumas perspectivas classificam os testes de unidade como testes de caixa branca. No entanto, os testes de unidade são, na verdade, testes de caixa preta específicos para assinaturas de funções.
Testes de unidade que dependem de ambientes reais: Os principais fatores que dificultam os testes de unidade incluem negligência e configurações dependentes do ambiente. Se você não usar Stub ou Mock para remover a dependência de ambientes externos, como endereços IP ou bancos de dados, os testes de unidade não poderão atender ao princípio FIRST (rápido, independente, repetível, autovalidável e oportuno).
Executar testes de unidade seletivamente
Além dos benefícios, os testes de unidade geram custos. Se você analisar o código legado sob a perspectiva de custo e benefício, poderá adicionar testes de unidade para o código legado. Isso significa que é possível executar testes de unidade de forma seletiva. Como distinguir custos e benefícios?
Classificação em quadrantes de custo-benefício dos testes de unidade para código legado
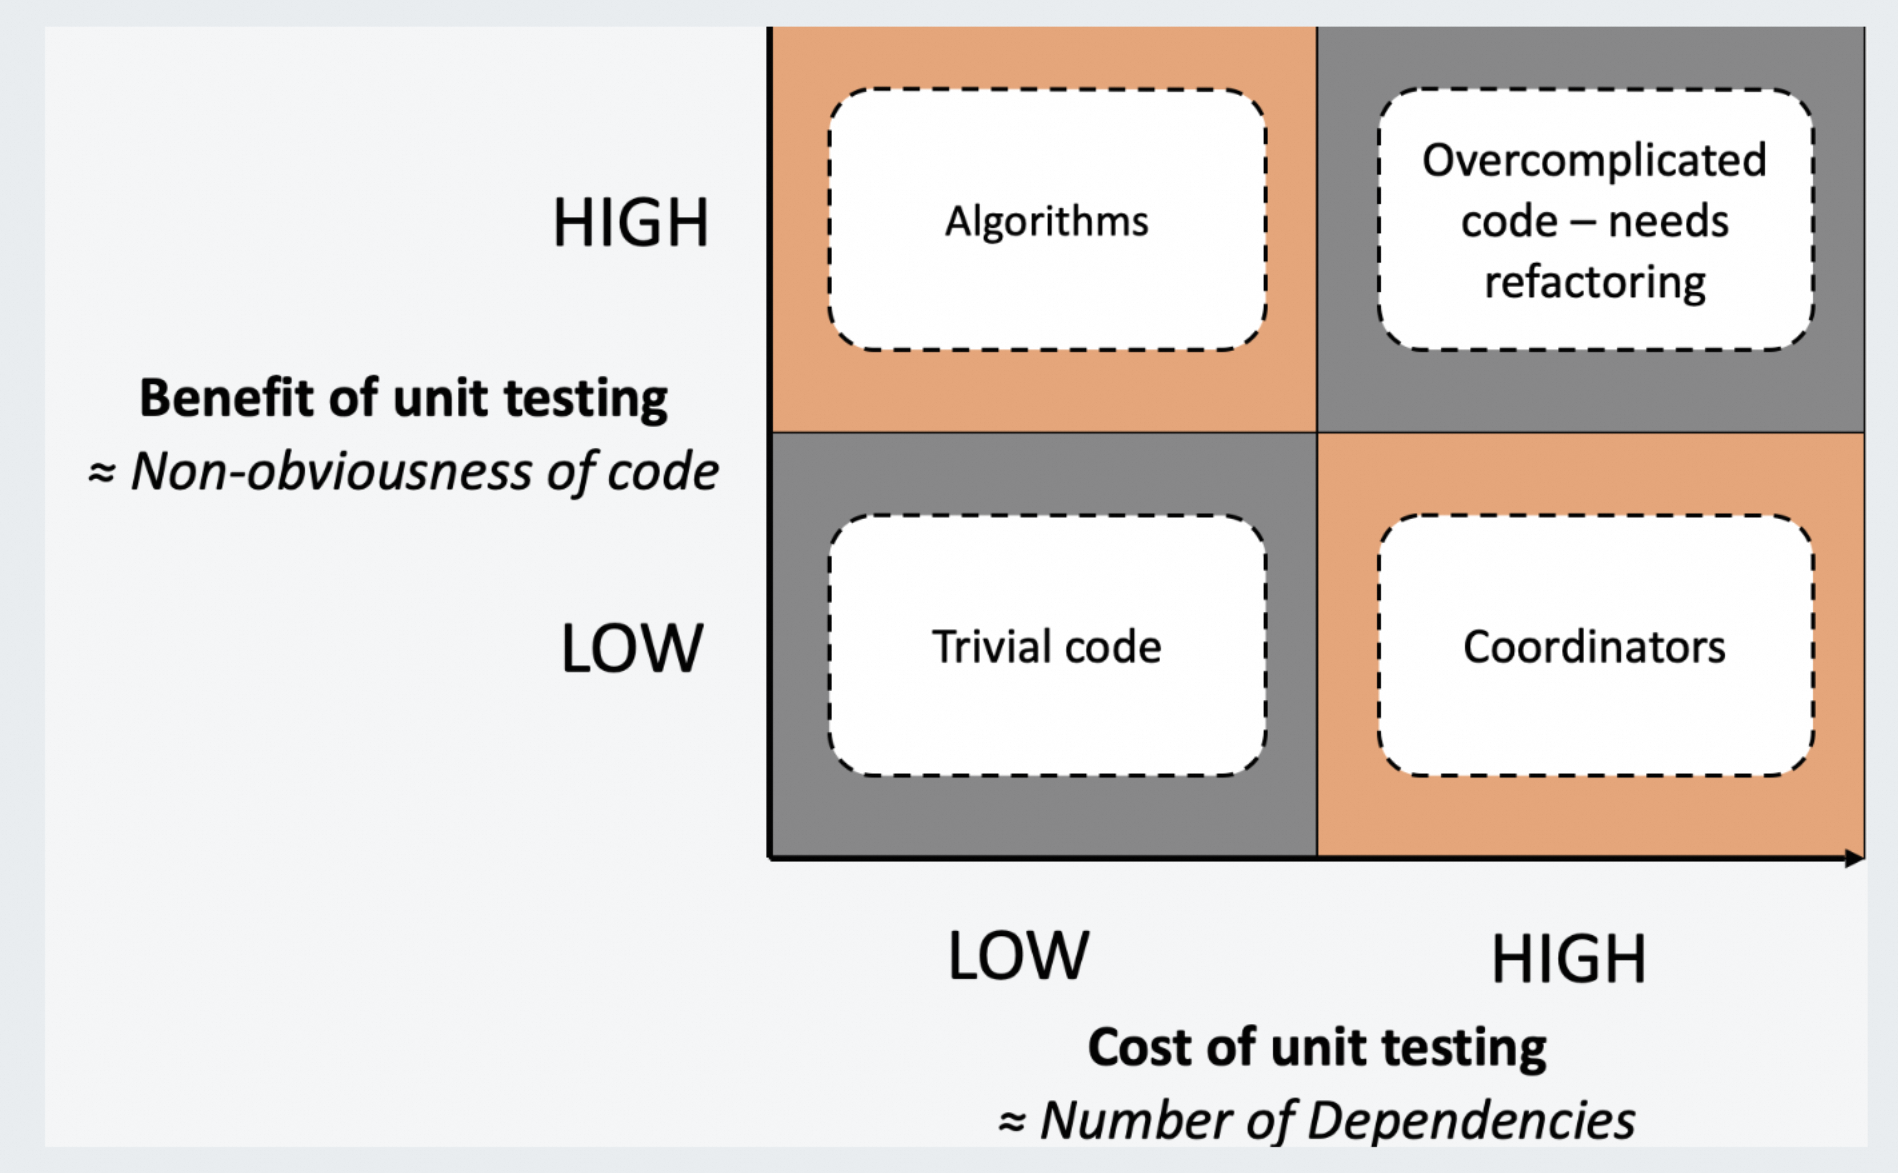
Os testes de unidade específicos para código legado podem ser categorizados em quadrantes com base em seus custos e benefícios. A figura a seguir mostra os critérios de classificação e os quadrantes dos testes de unidade.
Critérios de classificação
Eixo X (Custo): Maior dependência de código causa maior custo de teste.
Eixo Y (Benefício): Maior complexidade de código causa maior ganho de qualidade.
Quatro quadrantes
|
Classificação do código |
Características |
Descrição |
Benefícios |
Custos |
|
Código de algoritmos |
Alta complexidade ciclomática e fan-in |
Contém muitas instruções de julgamento condicional e loop, depende de poucos códigos, mas é utilizado por muitos códigos. |
Alto |
Baixo |
|
Código trivial Código trivial |
Baixa complexidade ciclomática e alto fan-in |
Utiliza lógica simples e contém apenas uma ou duas linhas de código. |
Baixo |
Baixo |
|
Código de coordenadores |
Baixa complexidade ciclomática e alto fan-in |
Está na camada superior da relação de chamadas e reflete cenários de negócios específicos ao chamar outros códigos. |
Baixo |
Alto |
|
Código excessivamente complicado |
Alta complexidade ciclomática e fan-in |
Utiliza lógica complexa, possui múltiplas dependências, contém muitas funções e parâmetros. É um típico code smell. |
Alto |
Alto |
Compreensão da complexidade ciclomática e das dependências
Complexidade ciclomática: o número de ramificações lógicas no código.
Fan-in: o número de módulos pai que chamam diretamente o módulo. Um fan-in alto indica um alto grau de reutilização do módulo.
Fan-out: o número de módulos que um módulo chama diretamente. Um fan-out alto indica que o módulo depende de muitos módulos.
Estratégias para diferentes tipos de código
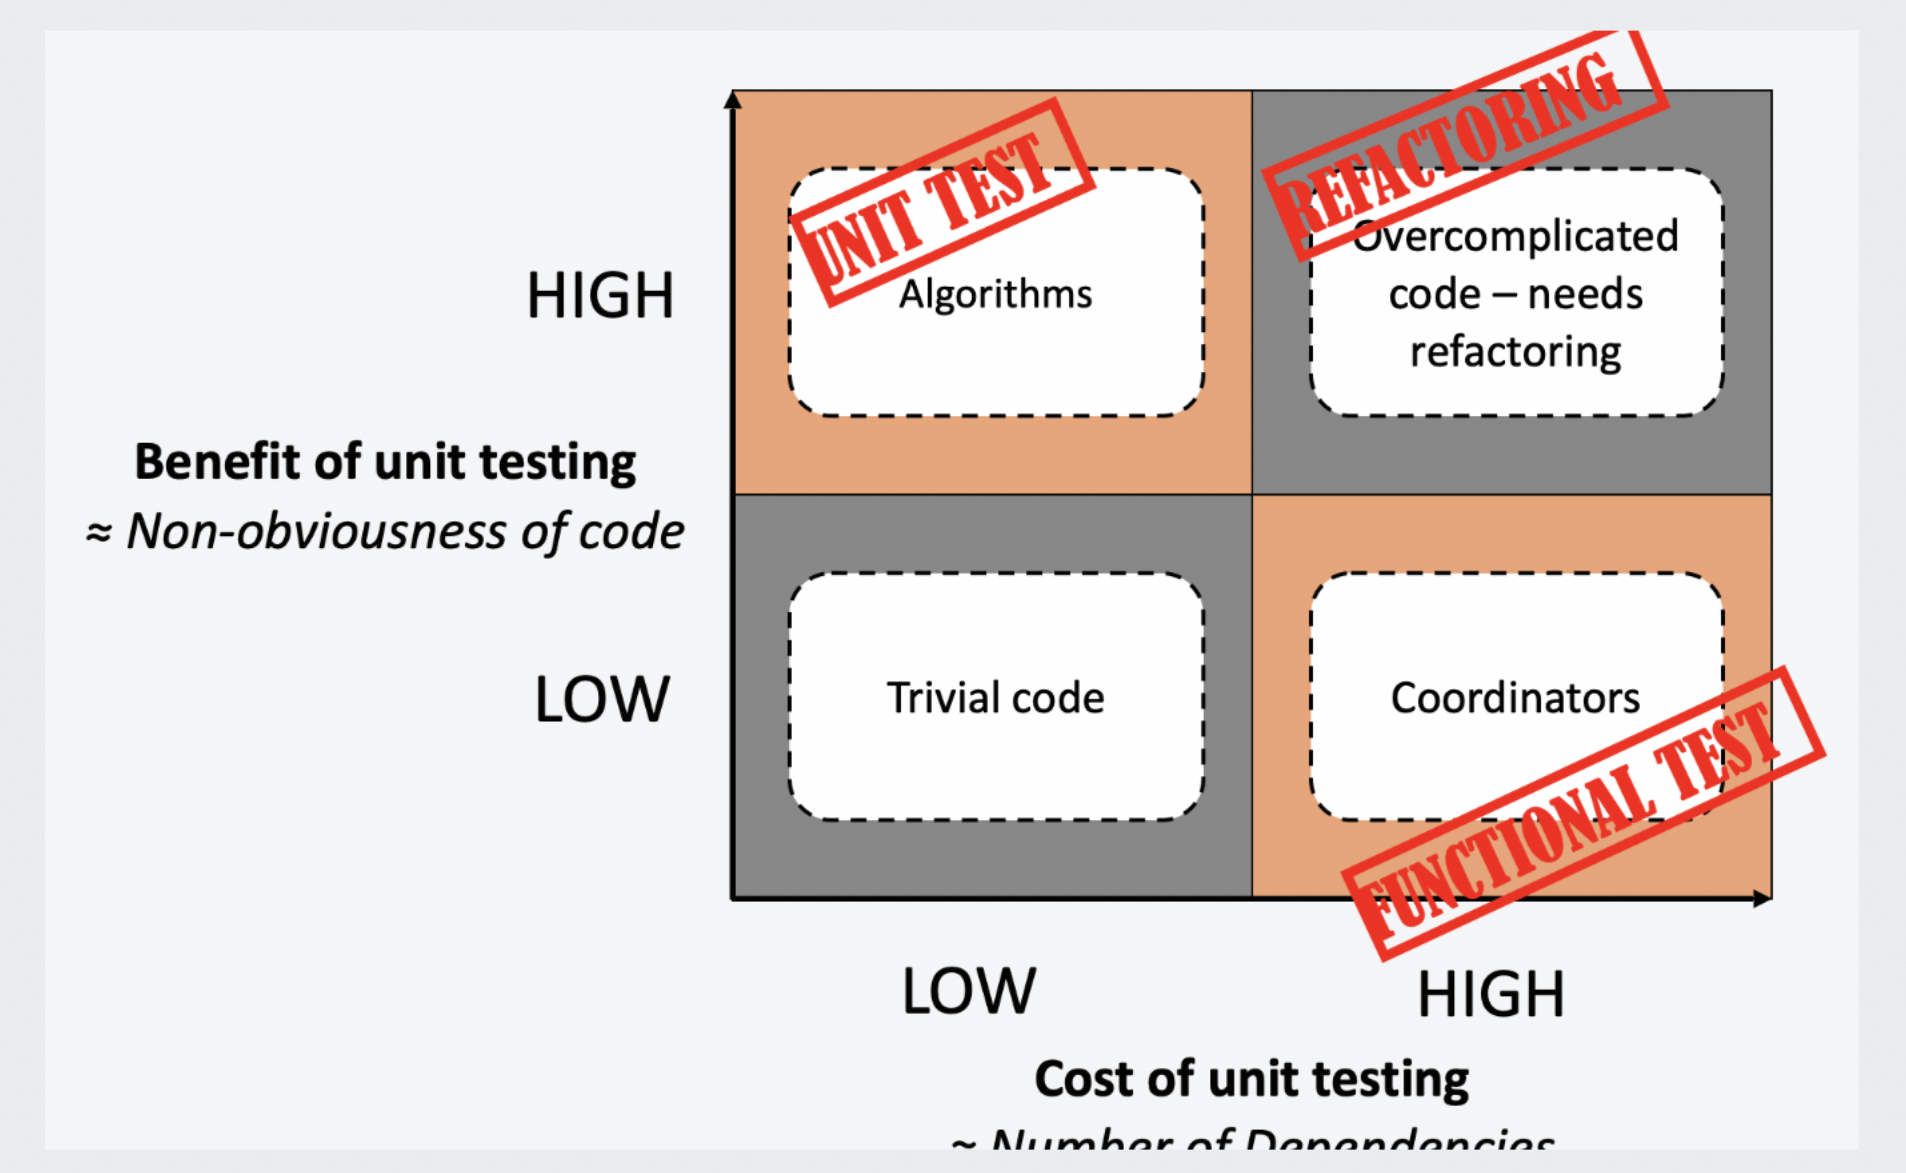
As estratégias a seguir se aplicam ao código legado com base na análise anterior:
Para código de algoritmos, gere testes de unidade.
Para código de coordenadores, execute testes de API.
Para código excessivamente complicado, busque a oportunidade certa para refatorar o código.
Para código trivial, não é necessário processar o código.
Use o Coding Assistant para processar código legado
1. Compreender um projeto
Ao manter o código legado de um projeto, utilize o recurso @workspace para compreender a finalidade de todo o projeto e os módulos envolvidos nele.

2. Processar diferentes tipos de código
Gerar testes de unidade para código de algoritmos
Selecione as seções para as quais deseja gerar código com base no código de produção. Durante a geração, foque nas informações de dependência, como o framework necessário e o Mock. Adicione informações relevantes após a geração de um comando de teste de unidade. Por exemplo, /generate unit testingCppUTest.
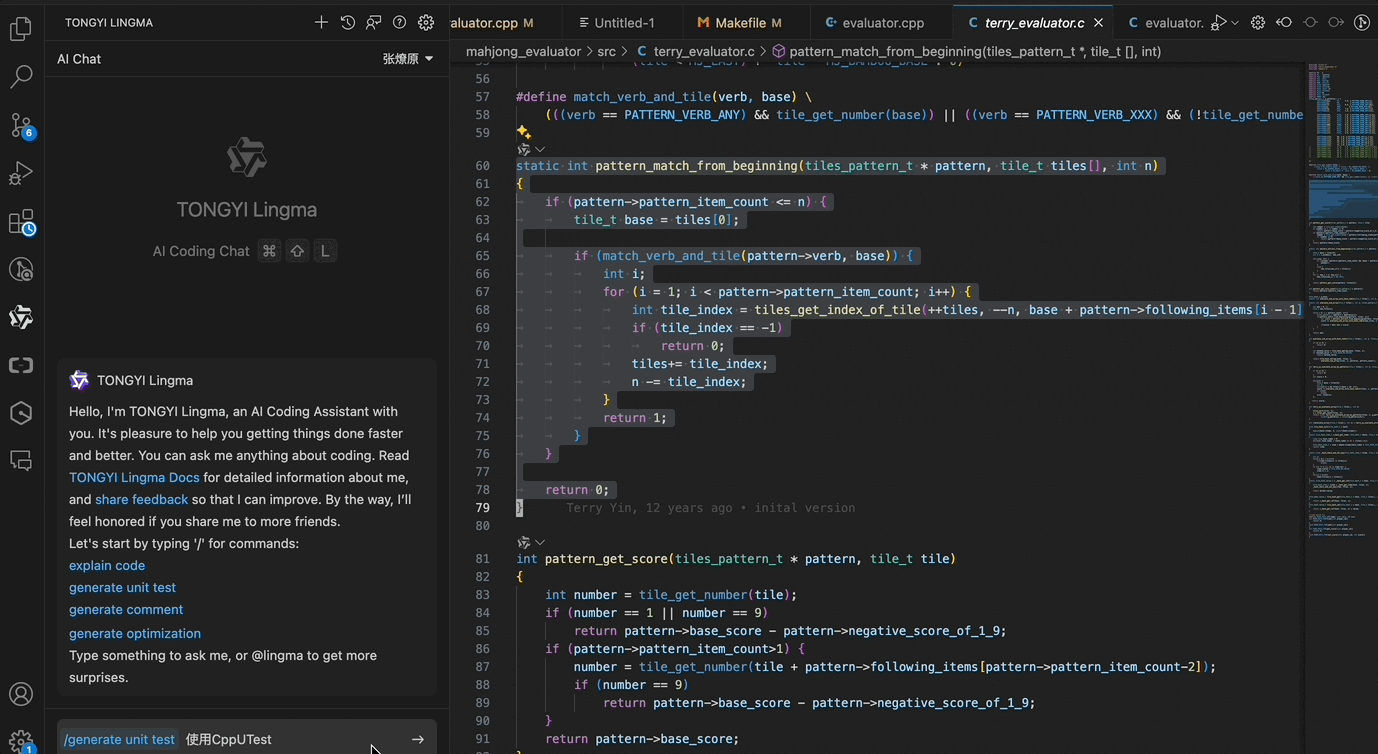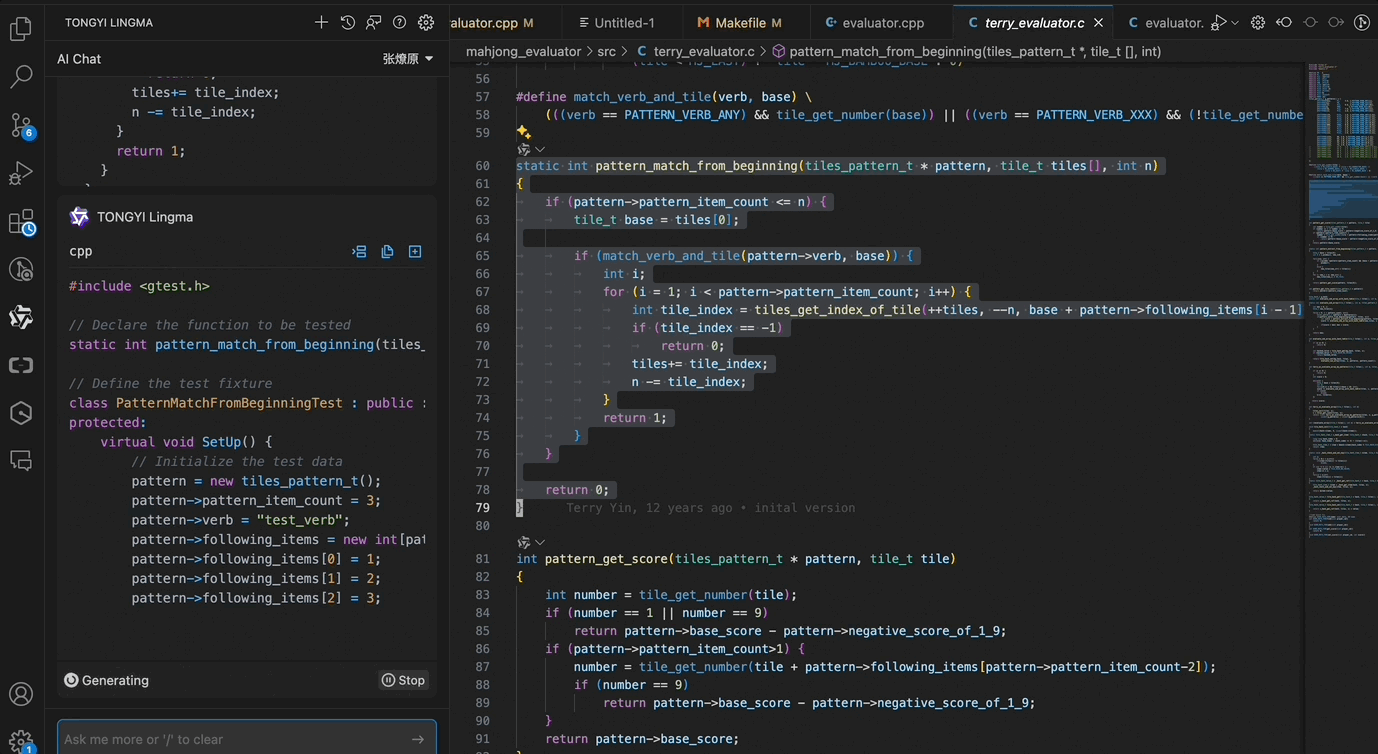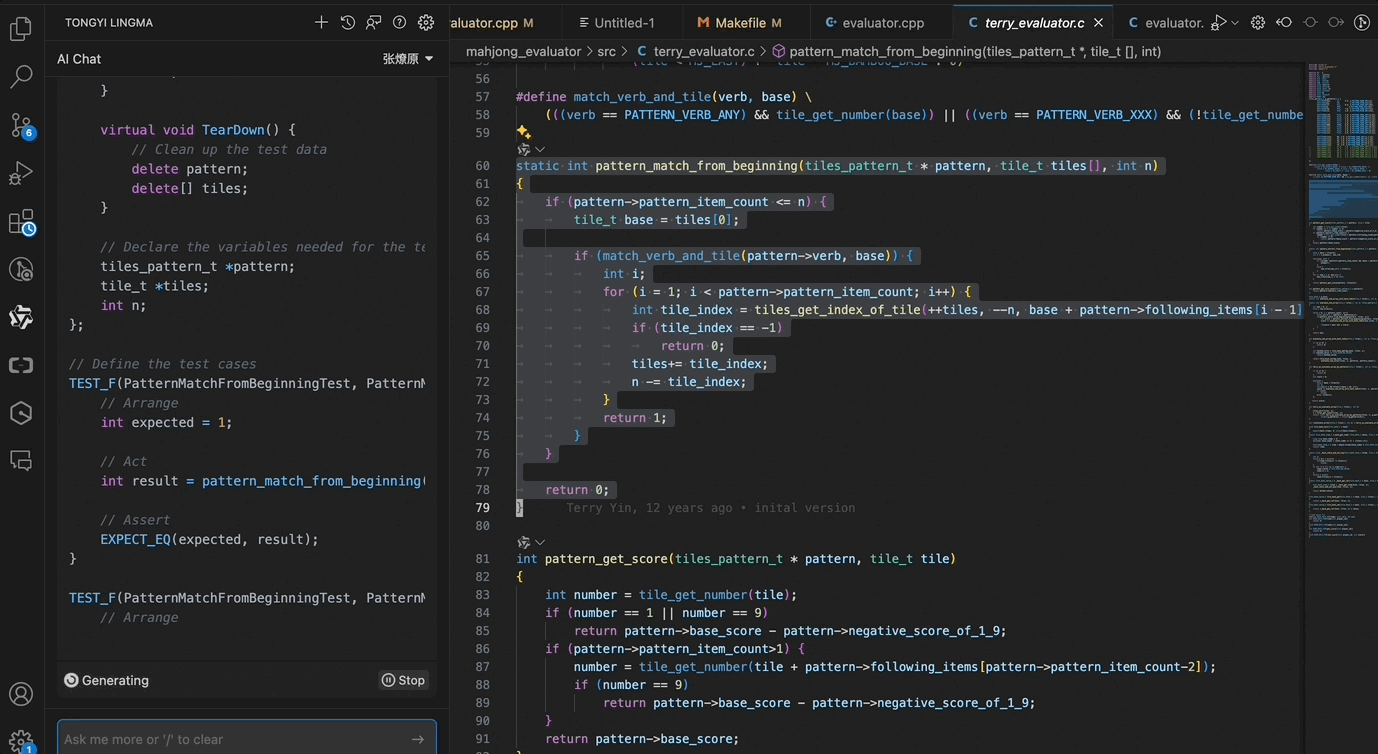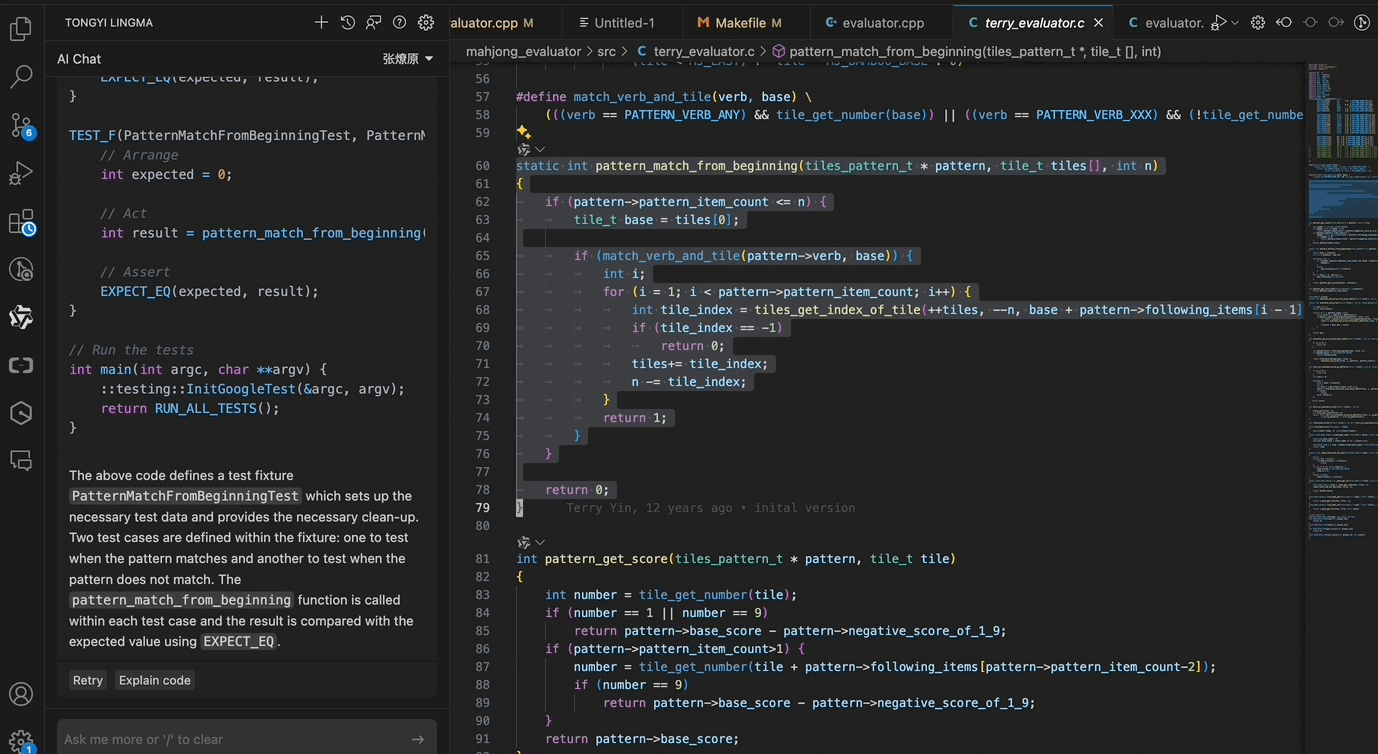
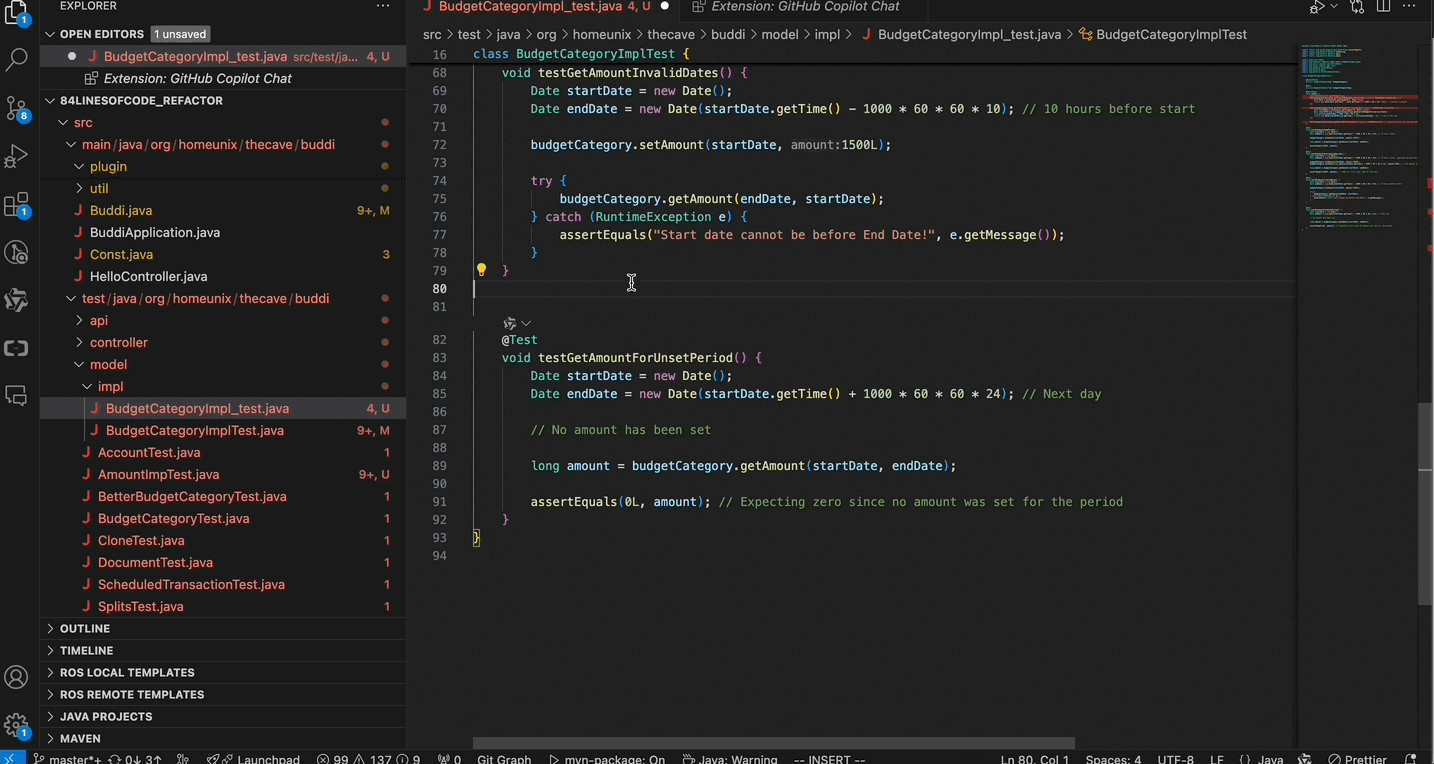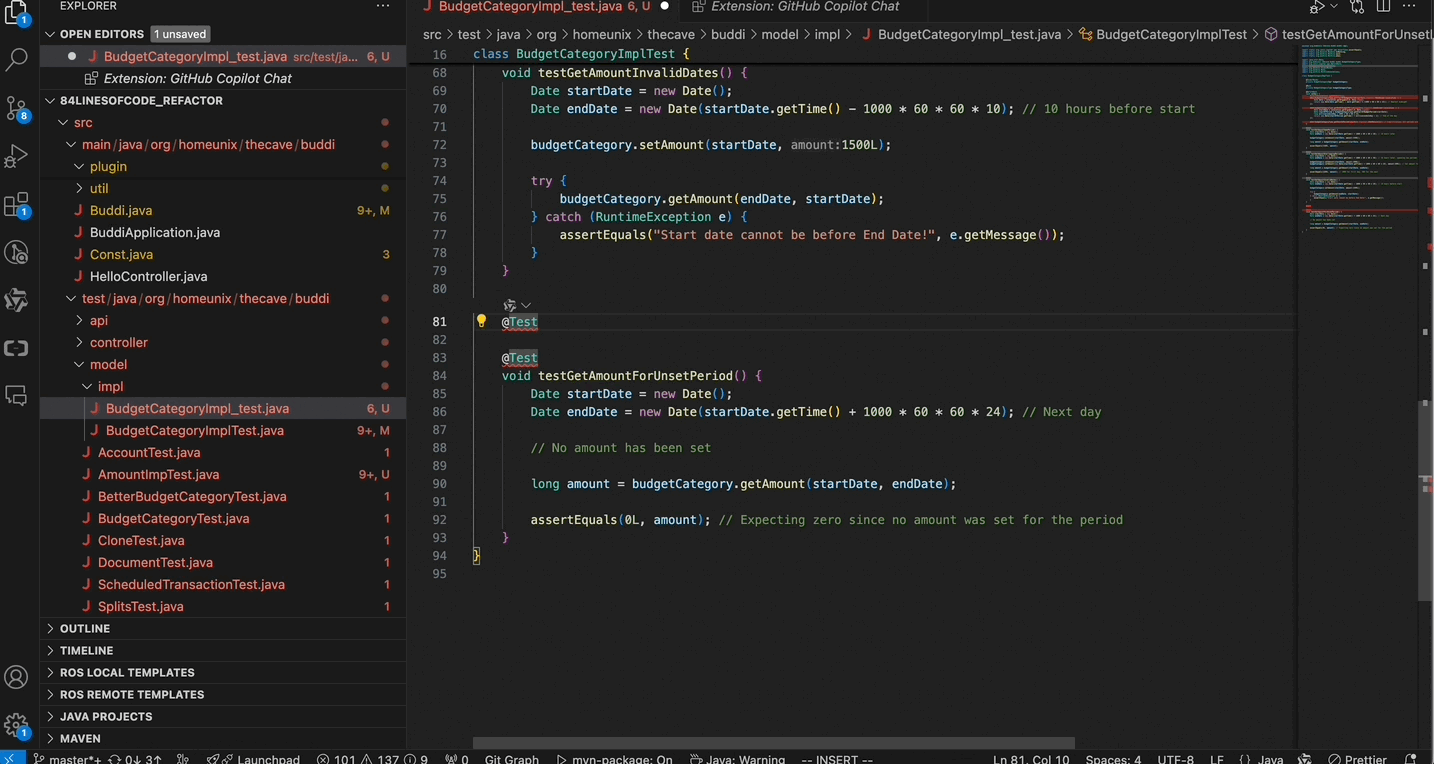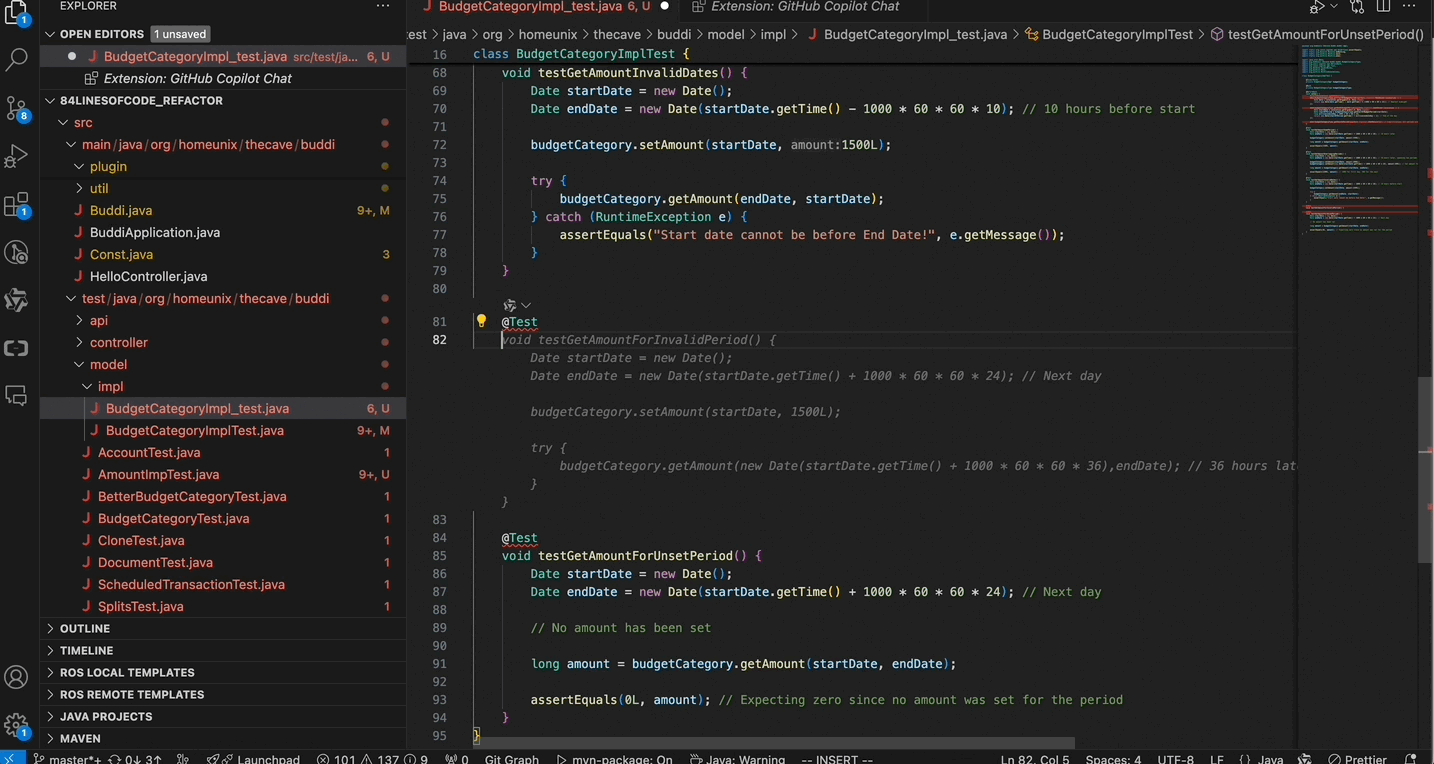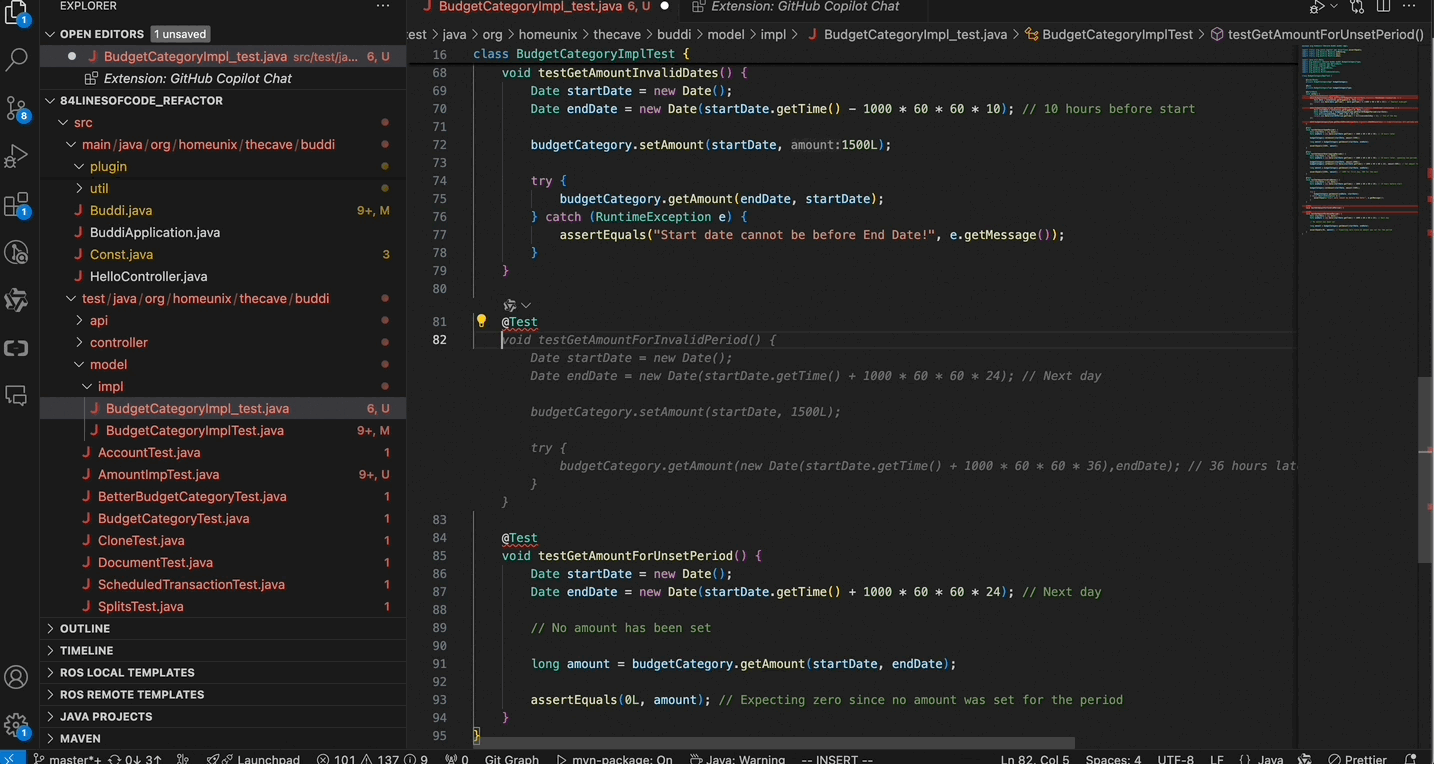
Em geral, o número de casos de teste de unidade gerados a partir do código existente costuma ser limitado. Se você tiver requisitos específicos para o número de cenários de teste e casos de uso dos testes de unidade, gere mais testes de unidade continuando as funções de teste em um arquivo de teste de unidade recém-gerado. Durante a continuação, o Coding Assistant segue os casos de uso existentes tanto quanto possível e os utiliza como referência de contexto.
Executar testes de API em código de coordenadores
O teste de unidade não é uma solução ideal para código de coordenadores, e os custos de teste aumentam significativamente devido ao número excessivo de dependências. Recomendamos executar testes de API ou de recursos nesse tipo de código. No entanto, os desenvolvedores frequentemente encontram problemas ao escrever casos de teste automatizados. Portanto, utilize o Coding Assistant para dominar e compreender rapidamente o framework de teste.
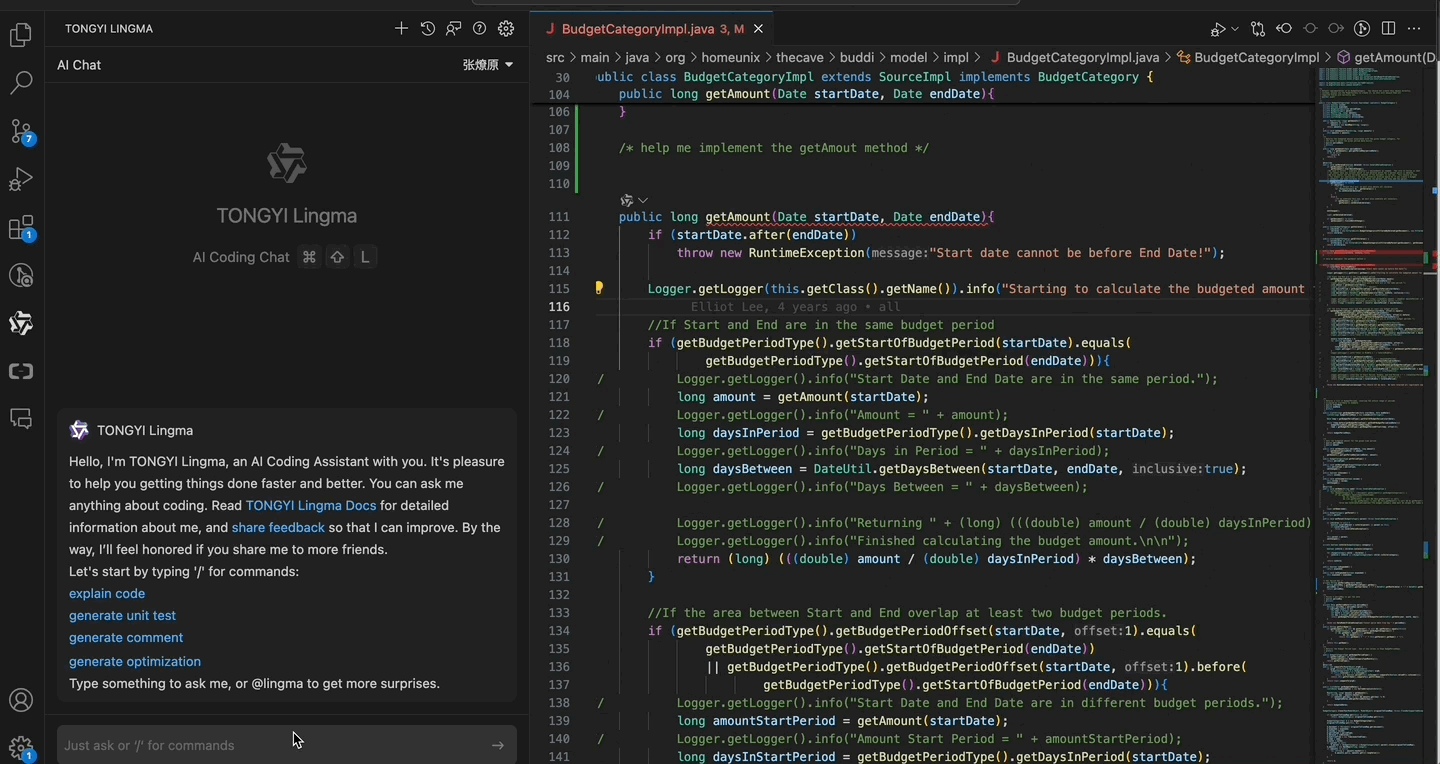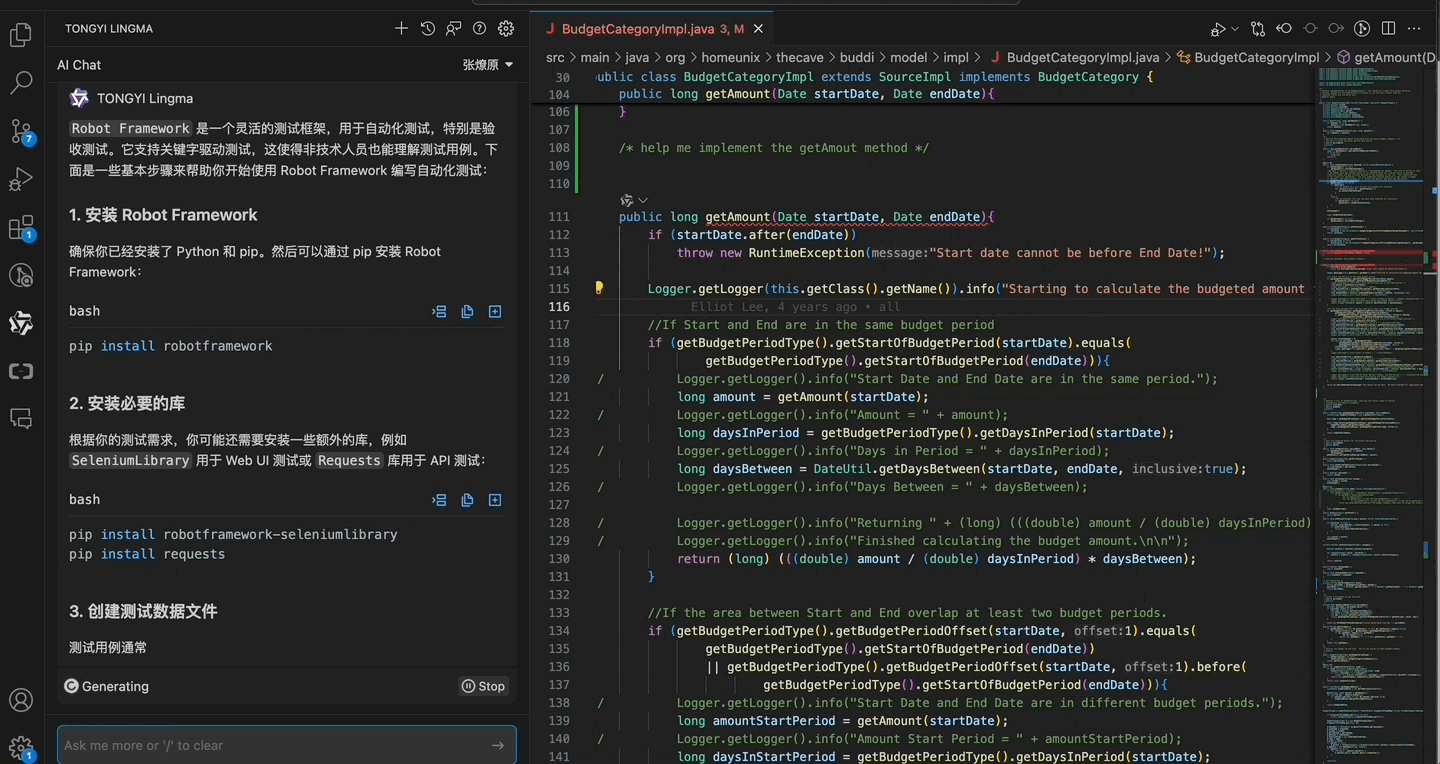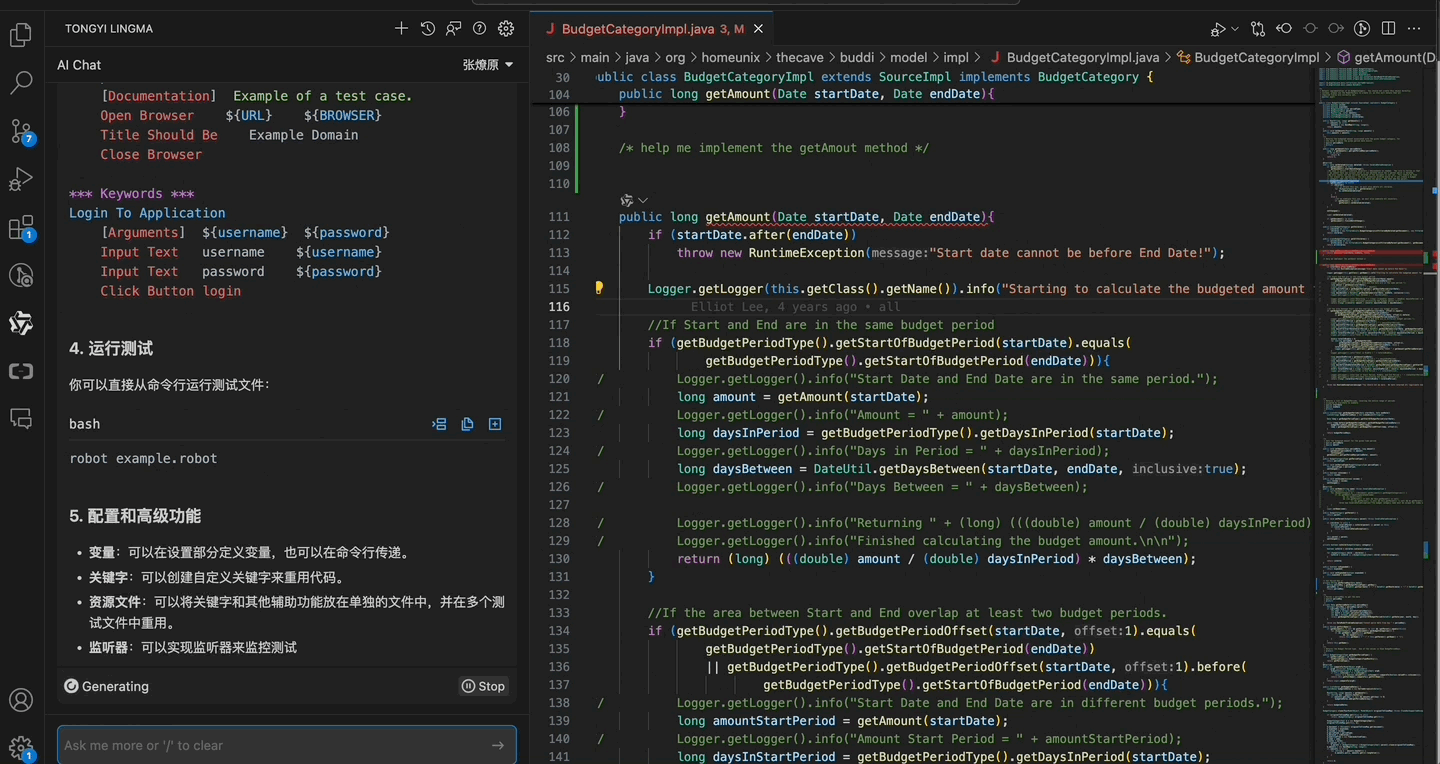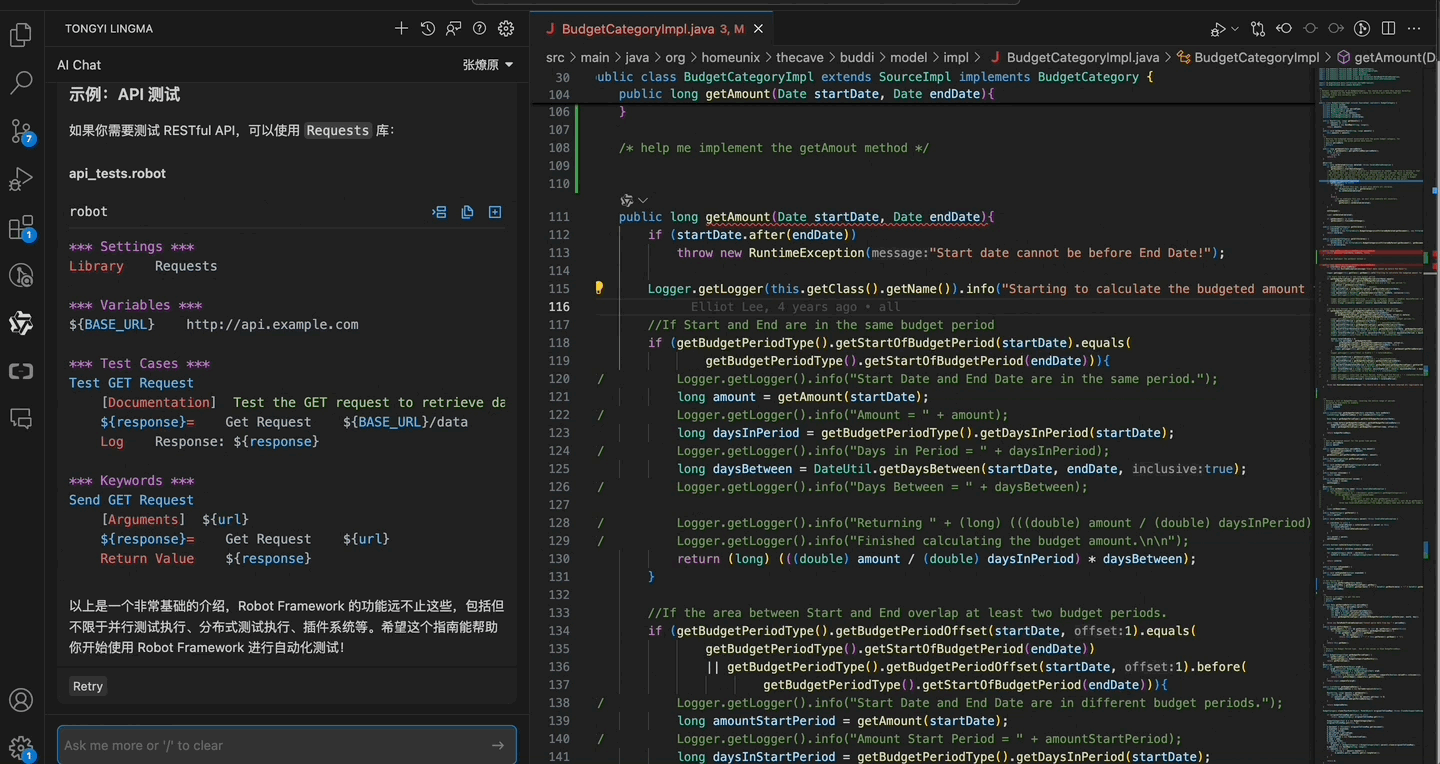
Para escrever um caso de uso, selecione a função testada do caso de uso e faça perguntas diretamente na janela de conversação do AI Coding Assistant. Por exemplo, pergunte ao AI Coding Assistant sobre o caso de teste gerado para o código a seguir com base no Robot Framework. Dessa forma, você poderá desenvolver as palavras-chave correspondentes.
Refatorar código excessivamente complicado no momento certo
Para código excessivamente complicado, utilize o comando /generate optimization do AI Coding Assistant para obter sugestões de otimização para o código selecionado. A revisão e otimização de código fornece sugestões de otimização em múltiplas dimensões, como problemas de sintaxe, melhorias de exceções, limpeza de código, segurança e riscos.
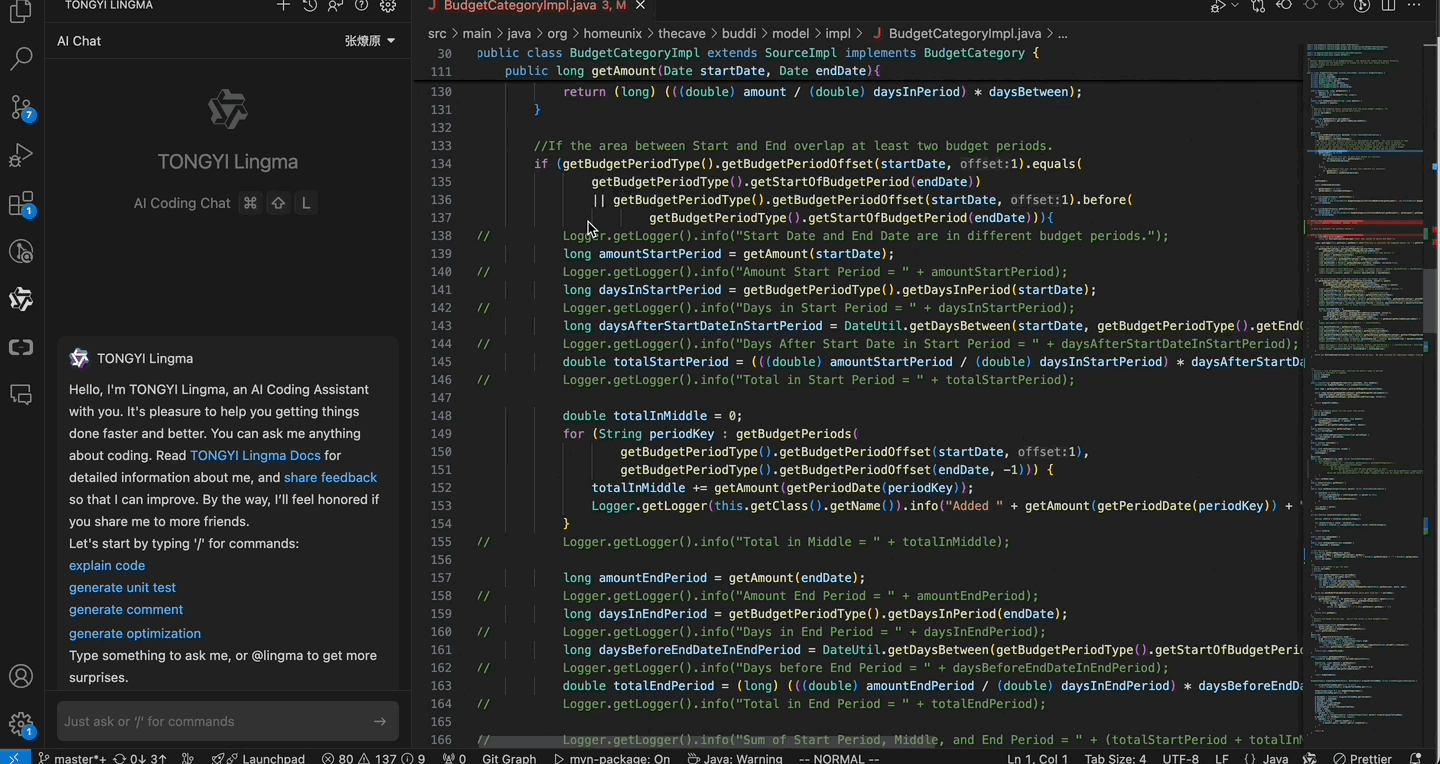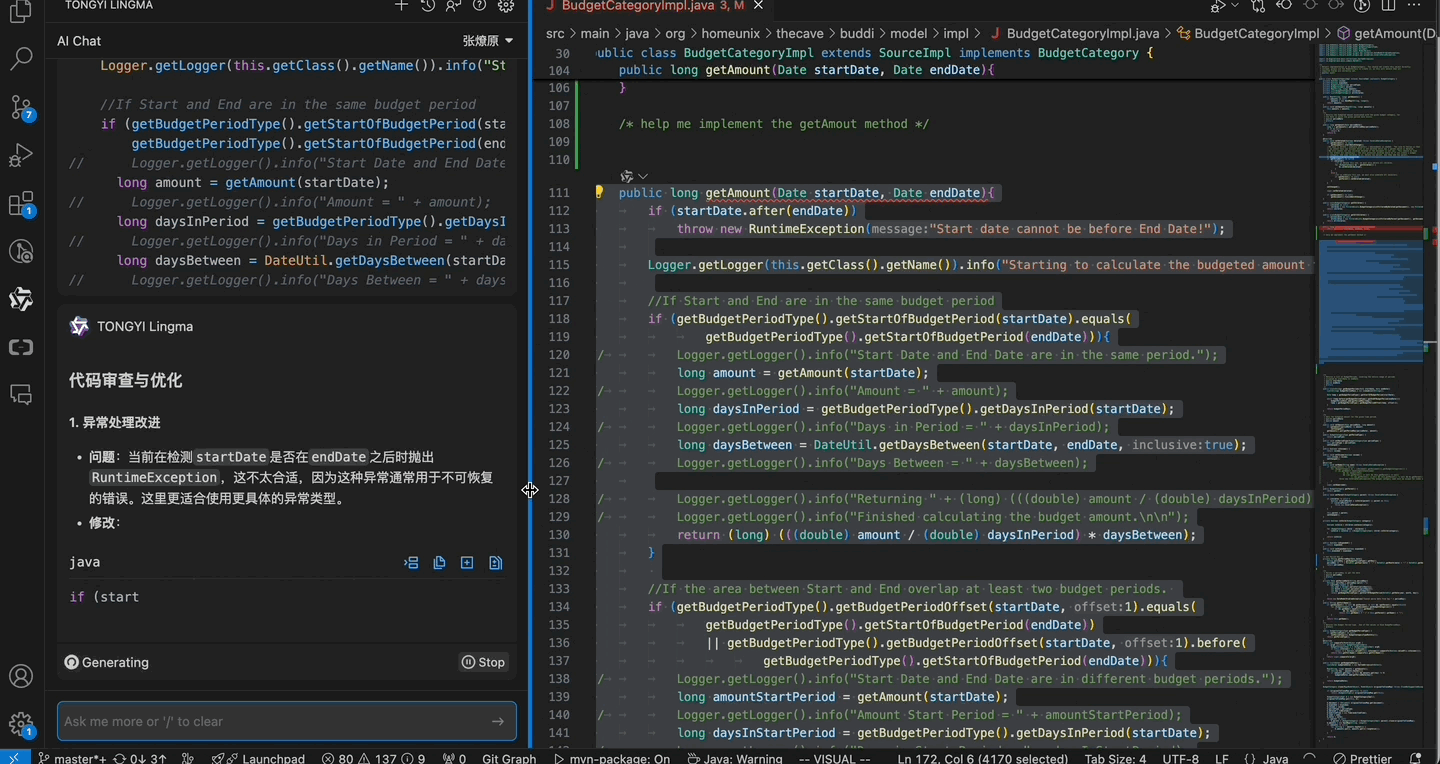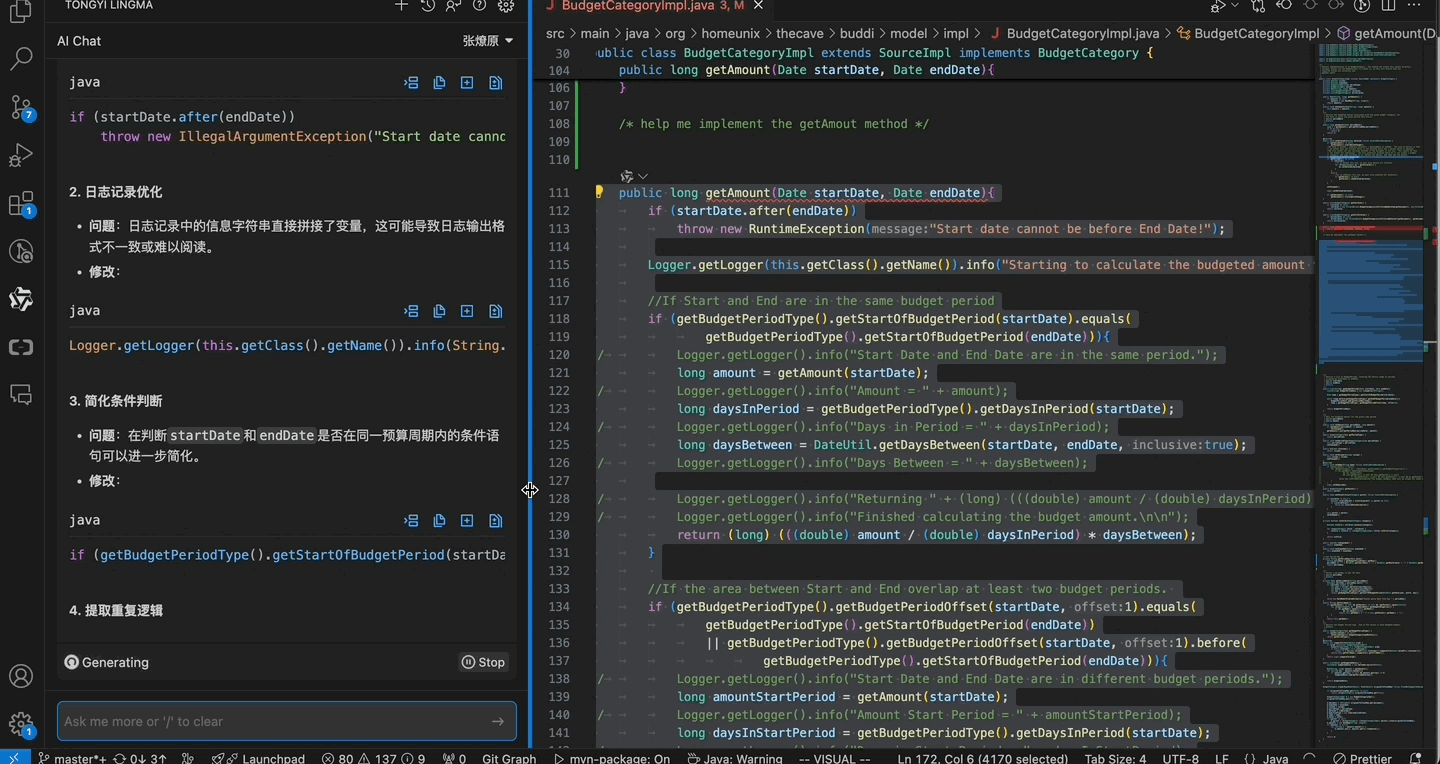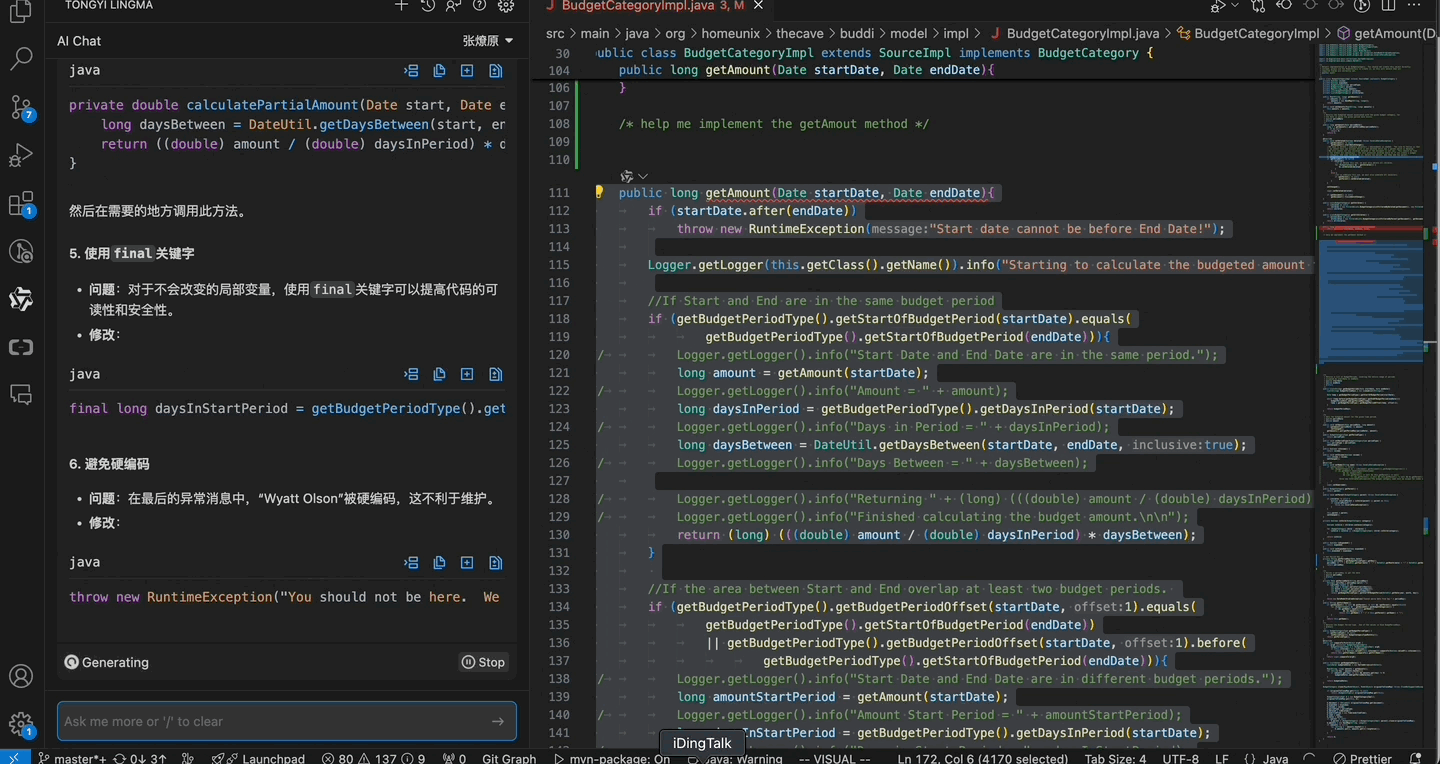
Para a otimização de código legado complexo, recomendamos que os desenvolvedores não façam otimizações e refatorações abrangentes cegamente. Alterações no código legado podem apresentar riscos significativos. Portanto, os desenvolvedores devem refatorar e otimizar o código no momento certo, com base em situações específicas, e seguir a Regra do Escoteiro. Nesse processo, o Coding Assistant também oferece um forte suporte para você.
Resumo
O conteúdo anterior fornece práticas recomendadas que você pode consultar ao processar código legado. Para processar código legado de forma eficaz, é preciso mergulhar na estrutura complexa do código e rastrear detalhadamente cada nó de ramificação possível. Nesse processo, além de identificar e corrigir possíveis defeitos, todas as tarefas devem ser concluídas dentro de um tempo limitado. Para minimizar o tempo necessário para processar código legado, recomendamos que os desenvolvedores evitem a deterioração do código, façam bom uso das ferramentas e sigam bons princípios de programação nas fases iniciais de escrita.