Este tópico compara o desempenho de compressão de dados do Lindorm com o HBase open source, MySQL e MongoDB em quatro conjuntos de dados reais: pedidos, Internet dos Veículos (IoV), logs e comportamento de usuários.
Ambiente de teste
O Lindorm é um serviço de banco de dados hiperconvergente multimodelo que usa o algoritmo de compressão zstd por padrão e oferece suporte à compressão baseada em dicionário. Esse recurso melhora a taxa de compressão ao otimizar a amostragem do dicionário durante a codificação dos dados.
A tabela a seguir mostra as versões dos bancos de dados e as configurações de compressão usadas neste teste.
|
Banco de dados |
Versão |
Compressão padrão |
Observações |
|
Lindorm |
Mais recente |
zstd (otimizado) |
Compressão baseada em dicionário disponível |
|
HBase open source |
2.3.4 |
Snappy |
O zstd tem suporte em versões posteriores do Hadoop, mas tende a apresentar problemas de estabilidade e core dumps; a maioria das implantações usa Snappy |
|
MySQL open source |
8,0 |
Nenhuma (desativada) |
O zlib está disponível, mas degrada significativamente o desempenho das consultas quando ativado |
|
MongoDB open source |
5,0 |
Snappy |
O zstd está disponível como alternativa |
Este teste segue apenas partes das especificações de benchmark TPC. Os resultados não são equivalentes nem comparáveis aos de testes que seguem integralmente as especificações de benchmark TPC.
Cada cenário testa e compara as seguintes configurações:
Lindorm com zstd (padrão)
Lindorm com compressão baseada em dicionário ativada
HBase open source com Snappy
MySQL open source com compressão desativada
MongoDB open source com Snappy
MongoDB open source com zstd
Quando usar compressão baseada em dicionário
zstd versus compressão baseada em dicionário:
|
Algoritmo |
Benefício |
Mais indicado para |
|
zstd (padrão) |
Redução significativa de armazenamento sem configuração adicional |
Todos os tipos de dados |
|
Compressão baseada em dicionário |
Redução adicional além do zstd, mediante uma etapa de treinamento do dicionário durante a ingestão de dados |
Conjuntos de dados com alta repetição entre linhas |
Dados que mais se beneficiam da compressão baseada em dicionário: conjuntos com estrutura repetitiva entre linhas, como entradas de log, campos de telemetria IoV e registros de eventos comportamentais.
Para consultar os resultados consolidados de todos os cenários, veja Resumo.
Pedidos
Conjunto de dados
Este cenário usa o conjunto de dados de benchmark TPC-H, definido pelo Transaction Processing Performance Council (TPC) para avaliar o desempenho de consultas analíticas.
Baixe a ferramenta TPC-H: TPC-H_Tools_v3.0.0.zip
Gere 10 GB de dados de teste:
# Unzip and build the data generator
unzip TPC-H_Tools_v3.0.0.zip
cd TPC-H_Tools_v3.0.0/dbgen
cp makefile.suite makefile

# Edit makefile: set the following fields
# CC = gcc
# DATABASE = ORACLE
# MACHINE = LINUX
# WORKLOAD = TPCH
make

# Generate 10 GB of test data
./dbgen -s 10
Esse processo gera oito arquivos .tbl. Este teste usa o arquivo ORDERS.tbl: 15 milhões de linhas, 1,76 GB.
|
Campo |
Tipo |
|
O_ORDERKEY |
INT |
|
O_CUSTKEY |
INT |
|
O_ORDERSTATUS |
CHAR(1) |
|
O_TOTALPRICE |
DECIMAL(15,2) |
|
O_ORDERDATE |
DATE |
|
O_ORDERPRIORITY |
CHAR(15) |
|
O_CLERK |
CHAR(15) |
|
O_SHIPPRIORITY |
INT |
|
O_COMMENT |
VARCHAR(79) |
Crie tabelas de teste
HBase
create 'ORDERS', {NAME => 'f', DATA_BLOCK_ENCODING => 'DIFF', COMPRESSION => 'SNAPPY', BLOCKSIZE => '32768}MySQL
CREATE TABLE ORDERS (
  O_ORDERKEY      INTEGER NOT NULL,
  O_CUSTKEY       INTEGER NOT NULL,
  O_ORDERSTATUS   CHAR(1) NOT NULL,
  O_TOTALPRICE    DECIMAL(15,2) NOT NULL,
  O_ORDERDATE     DATE NOT NULL,
  O_ORDERPRIORITY CHAR(15) NOT NULL,
  O_CLERK         CHAR(15) NOT NULL,
  O_SHIPPRIORITY  INTEGER NOT NULL,
  O_COMMENT       VARCHAR(79) NOT NULL
);
MongoDB
db.createCollection("ORDERS")Lindorm
-- lindorm-cli
CREATE TABLE ORDERS (
  O_ORDERKEY      INTEGER NOT NULL,
  O_CUSTKEY       INTEGER NOT NULL,
  O_ORDERSTATUS   CHAR(1) NOT NULL,
  O_TOTALPRICE    DECIMAL(15,2) NOT NULL,
  O_ORDERDATE     DATE NOT NULL,
  O_ORDERPRIORITY CHAR(15) NOT NULL,
  O_CLERK         CHAR(15) NOT NULL,
  O_SHIPPRIORITY  INTEGER NOT NULL,
  O_COMMENT       VARCHAR(79) NOT NULL,
  PRIMARY KEY(O_ORDERKEY)
);
Resultados da compressão
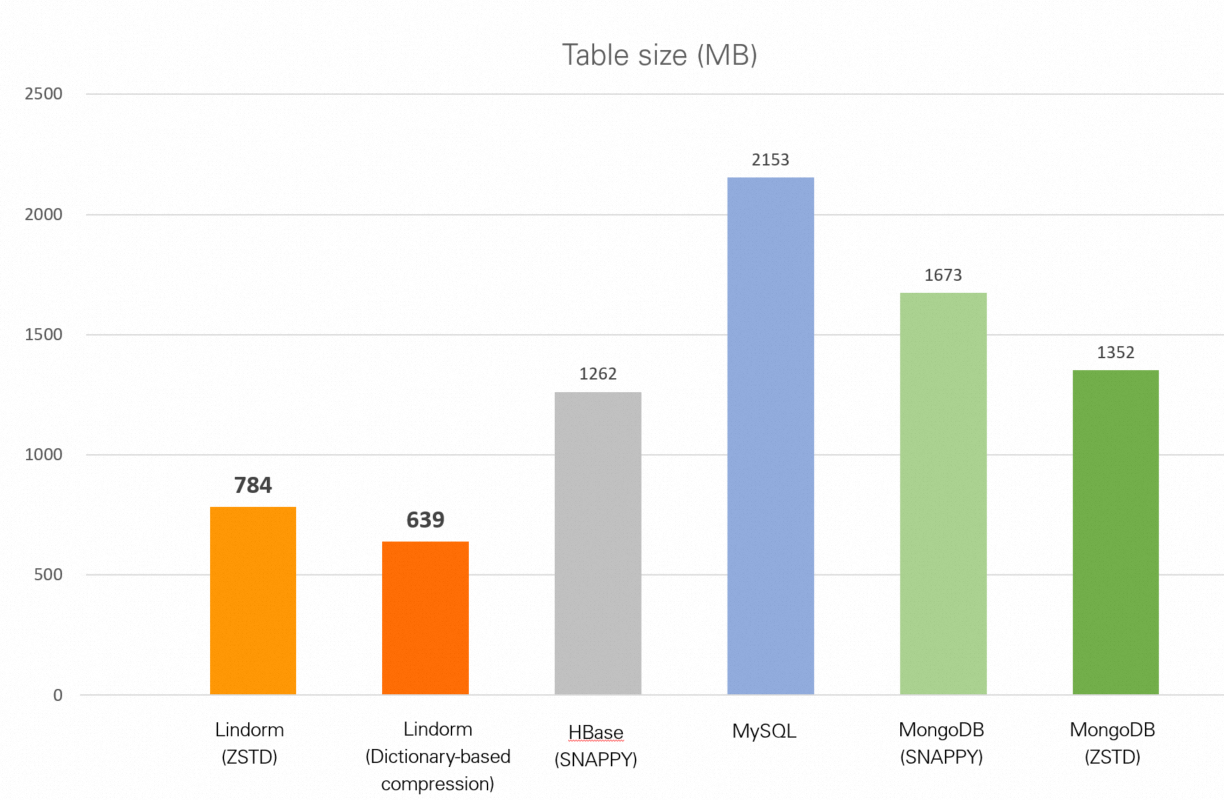
|
Banco de dados |
Tamanho da tabela |
|
Lindorm (zstd) |
784 MB |
|
Lindorm (compressão baseada em dicionário) |
639 MB |
|
HBase (Snappy) |
1,23 GB |
|
MySQL (sem compressão) |
2,10 GB |
|
MongoDB (Snappy) |
1,63 GB |
|
MongoDB (zstd) |
1,32 GB |
IoV
Conjunto de dados
Este cenário usa o conjunto de dados NGSIM (Next Generation Simulation), coletado pela Administração Federal de Rodovias dos EUA a partir de trajetórias de veículos na U.S. Route 101. O NGSIM é amplamente usado em pesquisas sobre comportamento de direção, análise de fluxo de tráfego, previsão de trajetórias veiculares e planejamento de decisões para condução autônoma.
Baixe o arquivo NGSIM_Data.csv: 11,85 milhões de linhas, 1,54 GB, 25 colunas por linha.
Crie tabelas de teste
HBase
create 'NGSIM', {NAME => 'f', DATA_BLOCK_ENCODING => 'DIFF', COMPRESSION => 'SNAPPY', BLOCKSIZE => '32768}MySQL
CREATE TABLE NGSIM (
  ID             INTEGER NOT NULL,
  Vehicle_ID     INTEGER NOT NULL,
  Frame_ID       INTEGER NOT NULL,
  Total_Frames   INTEGER NOT NULL,
  Global_Time    BIGINT NOT NULL,
  Local_X        DECIMAL(10,3) NOT NULL,
  Local_Y        DECIMAL(10,3) NOT NULL,
  Global_X       DECIMAL(15,3) NOT NULL,
  Global_Y       DECIMAL(15,3) NOT NULL,
  v_length       DECIMAL(10,3) NOT NULL,
  v_Width        DECIMAL(10,3) NOT NULL,
  v_Class        INTEGER NOT NULL,
  v_Vel          DECIMAL(10,3) NOT NULL,
  v_Acc          DECIMAL(10,3) NOT NULL,
  Lane_ID        INTEGER NOT NULL,
  O_Zone         CHAR(10),
  D_Zone         CHAR(10),
  Int_ID         CHAR(10),
  Section_ID     CHAR(10),
  Direction      CHAR(10),
  Movement       CHAR(10),
  Preceding      INTEGER NOT NULL,
  Following      INTEGER NOT NULL,
  Space_Headway  DECIMAL(10,3) NOT NULL,
  Time_Headway   DECIMAL(10,3) NOT NULL,
  Location       CHAR(10) NOT NULL,
  PRIMARY KEY(ID)
);
MongoDB
db.createCollection("NGSIM")Lindorm
-- lindorm-cli
CREATE TABLE NGSIM (
  ID             INTEGER NOT NULL,
  Vehicle_ID     INTEGER NOT NULL,
  Frame_ID       INTEGER NOT NULL,
  Total_Frames   INTEGER NOT NULL,
  Global_Time    BIGINT NOT NULL,
  Local_X        DECIMAL(10,3) NOT NULL,
  Local_Y        DECIMAL(10,3) NOT NULL,
  Global_X       DECIMAL(15,3) NOT NULL,
  Global_Y       DECIMAL(15,3) NOT NULL,
  v_length       DECIMAL(10,3) NOT NULL,
  v_Width        DECIMAL(10,3) NOT NULL,
  v_Class        INTEGER NOT NULL,
  v_Vel          DECIMAL(10,3) NOT NULL,
  v_Acc          DECIMAL(10,3) NOT NULL,
  Lane_ID        INTEGER NOT NULL,
  O_Zone         CHAR(10),
  D_Zone         CHAR(10),
  Int_ID         CHAR(10),
  Section_ID     CHAR(10),
  Direction      CHAR(10),
  Movement       CHAR(10),
  Preceding      INTEGER NOT NULL,
  Following      INTEGER NOT NULL,
  Space_Headway  DECIMAL(10,3) NOT NULL,
  Time_Headway   DECIMAL(10,3) NOT NULL,
  Location       CHAR(10) NOT NULL,
  PRIMARY KEY(ID)
);
Resultados da compressão
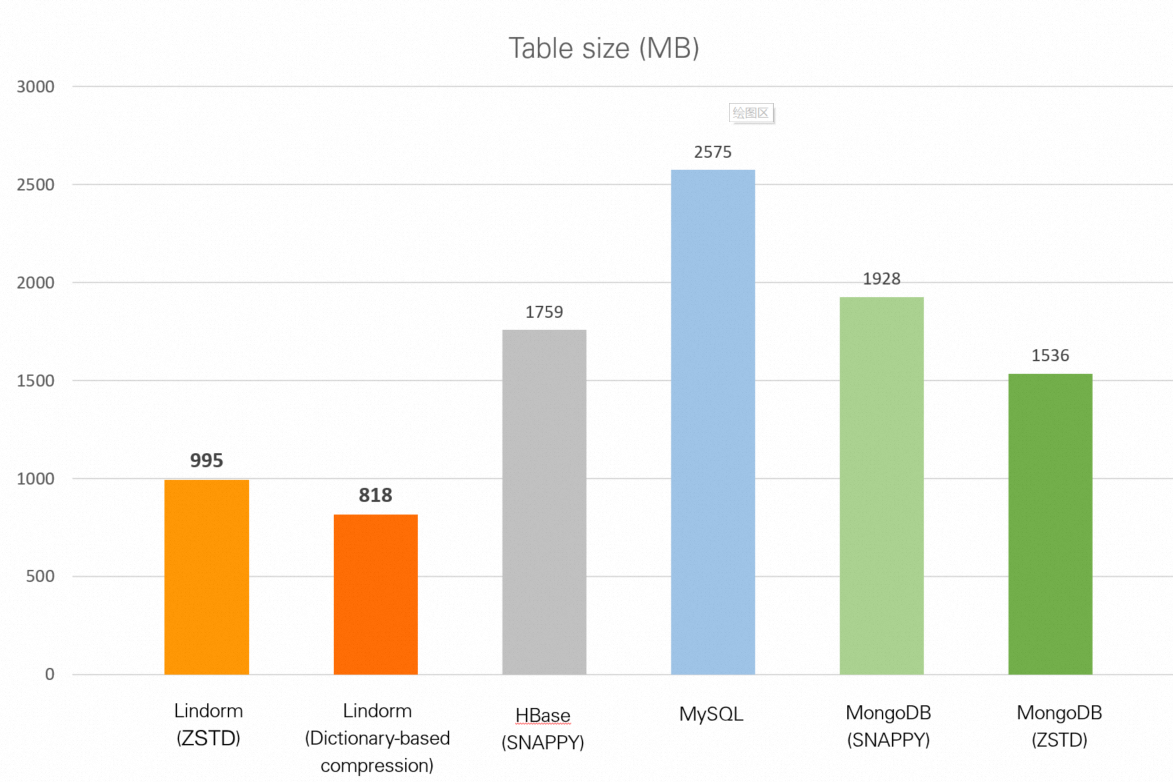
|
Banco de dados |
Tamanho da tabela |
|
Lindorm (zstd) |
995 MB |
|
Lindorm (compressão baseada em dicionário) |
818 MB |
|
HBase (Snappy) |
1,72 GB |
|
MySQL (sem compressão) |
2,51 GB |
|
MongoDB (Snappy) |
1,88 GB |
|
MongoDB (zstd) |
1,50 GB |
Logs
Conjunto de dados
Este cenário usa o conjunto de dados Online Shopping Store - Web Server Logs (Zaker, Farzin, 2019, Harvard Dataverse, V1).
Baixe o arquivo access.log: 10,36 milhões de linhas, 3,51 GB. Cada linha corresponde a uma única entrada de log. Exemplo:
54.36.149.41 - - [22/Jan/2019:03:56:14 +0330] "GET /filter/27|13%20%D9%85%DA%AF%D8%A7%D9%BE%DB%8C%DA%A9%D8%B3%D9%84,27|%DA%A9%D9%85%D8%AA%D8%B1%20%D8%A7%D8%B2%205%20%D9%85%DA%AF%D8%A7%D9%BE%DB%8C%DA%A9%D8%B3%D9%84,p53 HTTP/1.1" 200 30577 "-" "Mozilla/5.0 (compatible; AhrefsBot/6.1; +http://ahrefs.com/robot/)" "-"Os dados de log apresentam estrutura repetitiva entre as linhas, motivo pelo qual este cenário demonstra os maiores ganhos de compressão com o uso de dicionário.
Crie tabelas de teste
HBase
create 'ACCESS_LOG', {NAME => 'f', DATA_BLOCK_ENCODING => 'DIFF', COMPRESSION => 'SNAPPY', BLOCKSIZE => '32768}MySQL
CREATE TABLE ACCESS_LOG (
  ID      INTEGER NOT NULL,
  CONTENT VARCHAR(10000),
  PRIMARY KEY(ID)
);
MongoDB
db.createCollection("ACCESS_LOG")Lindorm
-- lindorm-cli
CREATE TABLE ACCESS_LOG (
  ID      INTEGER NOT NULL,
  CONTENT VARCHAR(10000),
  PRIMARY KEY(ID)
);
Resultados da compressão
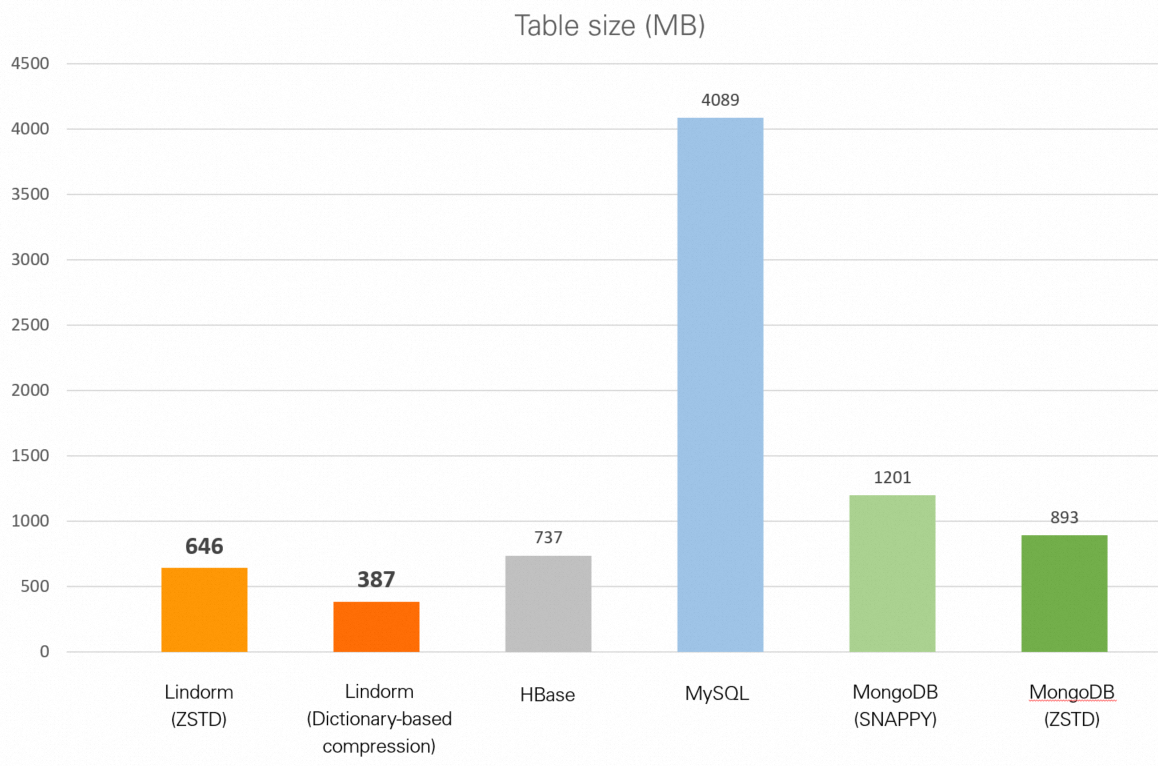
|
Banco de dados |
Tamanho da tabela |
|
Lindorm (zstd) |
646 MB |
|
Lindorm (compressão baseada em dicionário) |
387 MB |
|
HBase (Snappy) |
737 MB |
|
MySQL (sem compressão) |
3,99 GB |
|
MongoDB (Snappy) |
1,17 GB |
|
MongoDB (zstd) |
893 MB |
Comportamento de usuários
Conjunto de dados
Este cenário usa o conjunto de dados Shop Info and User Behavior data from IJCAI-15 do Alibaba Cloud Tianchi.
Baixe o arquivo data_format1.zip e use o user_log_format1.csv: 54,92 milhões de linhas, 1,91 GB.
|
Coluna |
Valores de exemplo |
|
user_id |
328862 |
|
item_id |
323294, 844400, 575153 |
|
cat_id |
833, 1271 |
|
seller_id |
2882 |
|
brand_id |
2661 |
|
time_stamp |
829 |
|
action_type |
0 |
Crie tabelas de teste
HBase
create 'USER_LOG', {NAME => 'f', DATA_BLOCK_ENCODING => 'DIFF', COMPRESSION => 'SNAPPY', BLOCKSIZE => '32768}MySQL
CREATE TABLE USER_LOG (
  ID          INTEGER NOT NULL,
  USER_ID     INTEGER NOT NULL,
  ITEM_ID     INTEGER NOT NULL,
  CAT_ID      INTEGER NOT NULL,
  SELLER_ID   INTEGER NOT NULL,
  BRAND_ID    INTEGER,
  TIME_STAMP  CHAR(4) NOT NULL,
  ACTION_TYPE CHAR(1) NOT NULL,
  PRIMARY KEY(ID)
);
MongoDB
db.createCollection("USER_LOG")Lindorm
-- lindorm-cli
CREATE TABLE USER_LOG (
  ID          INTEGER NOT NULL,
  USER_ID     INTEGER NOT NULL,
  ITEM_ID     INTEGER NOT NULL,
  CAT_ID      INTEGER NOT NULL,
  SELLER_ID   INTEGER NOT NULL,
  BRAND_ID    INTEGER,
  TIME_STAMP  CHAR(4) NOT NULL,
  ACTION_TYPE CHAR(1) NOT NULL,
  PRIMARY KEY(ID)
);
Resultados da compressão
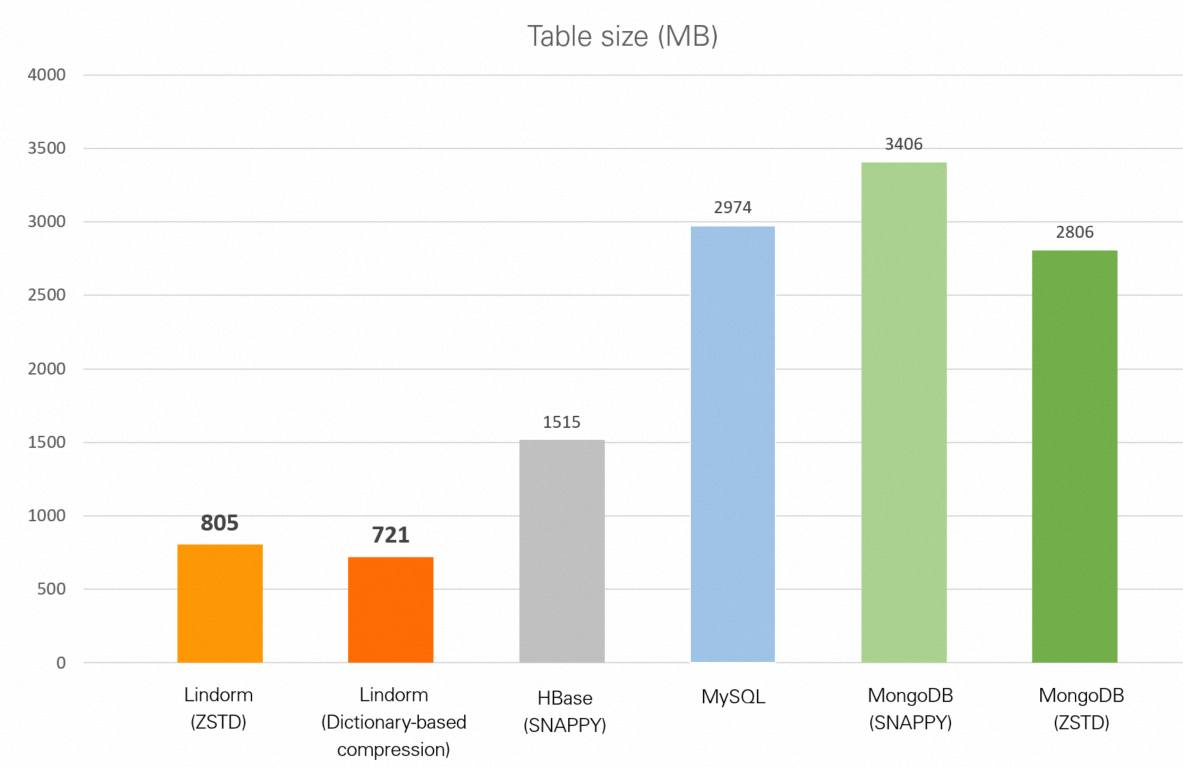
|
Banco de dados |
Tamanho da tabela |
|
Lindorm (zstd) |
805 MB |
|
Lindorm (compressão baseada em dicionário) |
721 MB |
|
HBase (Snappy) |
1,48 GB |
|
MySQL (sem compressão) |
2,90 GB |
|
MongoDB (Snappy) |
3,33 GB |
|
MongoDB (zstd) |
2,74 GB |
Resumo
O Lindorm atinge uma taxa de compressão superior à dos bancos de dados open source mesmo sem a compressão baseada em dicionário ativada. Com esse recurso, o Lindorm obtém a maior taxa de compressão nos quatro cenários avaliados. Em comparação com os padrões adotados por cada banco de dados open source, o Lindorm com compressão baseada em dicionário reduz o tamanho dos dados armazenados em:
1 a 2 vezes mais que o HBase open source (Snappy)
2 a 4 vezes mais que o MongoDB open source (Snappy ou zstd)
3 a 10 vezes mais que o MySQL open source (sem compressão)
A tabela a seguir consolida todos os resultados dos testes.
|
Conjunto de dados |
Tamanho original |
Lindorm (zstd) |
Lindorm (dicionário) |
HBase (Snappy) |
MySQL |
MongoDB (Snappy) |
MongoDB (zstd) |
|
Dados de pedidos (TPC-H) |
1,76 GB |
784 MB |
639 MB |
1,23 GB |
2,10 GB |
1,63 GB |
1,32 GB |
|
Dados IoV (NGSIM) |
1,54 GB |
995 MB |
818 MB |
1,72 GB |
2,51 GB |
1,88 GB |
1,50 GB |
|
Dados de log (servidor web) |
3,51 GB |
646 MB |
387 MB |
737 MB |
3,99 GB |
1,17 GB |
893 MB |
|
Comportamento do usuário (IJCAI-15) |
1,91 GB |
805 MB |
721 MB |
1,48 GB |
2,90 GB |
3,33 GB |
2,74 GB |
Escolha entre zstd e compressão baseada em dicionário: o zstd vem ativado por padrão e reduz custos de armazenamento para todos os tipos de dados sem necessidade de configuração adicional. A compressão baseada em dicionário proporciona uma redução ainda maior — mais expressiva em dados de log (387 MB contra 646 MB) e mais modesta em dados IoV com predominância numérica — mediante uma etapa de treinamento do dicionário durante a ingestão dos dados.