Quando o desempenho de inserção ou atualização ficar abaixo do esperado, comece verificando a métrica CPU Usage no console do Hologres. O baixo uso de CPU indica gargalos na origem (leituras de dados lentas). O uso alto de CPU — consistentemente em 100% — significa que o próprio Hologres é o gargalo. Este tópico mostra como diagnosticar e resolver ambos os casos.
Como funciona
Cada instrução SQL no Hologres segue um destes dois caminhos de execução:
Caminho padrão (HQE/PQE): passa pelo otimizador de consultas (QO) e pelo mecanismo de consulta (QE). As operações de gravação adquirem um bloqueio de tabela, portanto, as instruções
INSERT,UPDATEeDELETEsimultâneas precisam esperar umas pelas outras, o que causa alta latência sob carga. O HQE (Hologres Query Engine) processa a maioria das operações de gravação; já o PQE (PostgreSQL Query Engine) trata dos cenários de compatibilidade.Caminho do Fixed Plan (FixedQE): ignora o QO e o QE para gravações pontuais simples. Utiliza bloqueios de linha em vez de bloqueios de tabela, o que melhora drasticamente a concorrência e o throughput de gravação.
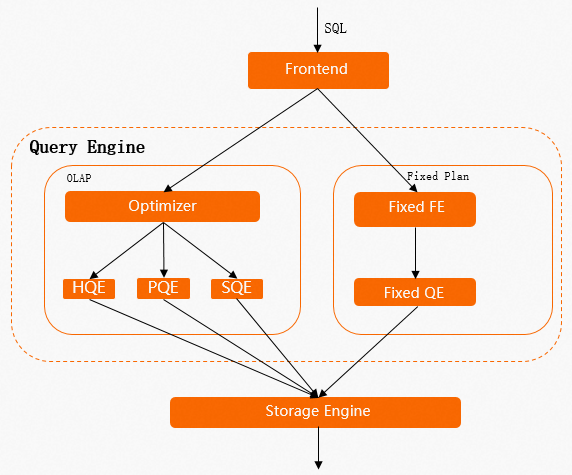
Entender essa diferença explica a maioria dos problemas de desempenho de gravação e por que ativar o Fixed Plan é a otimização de maior impacto.
Linhas de base de desempenho
Antes de iniciar os ajustes, conheça o limite de desempenho para a configuração da sua tabela.
Por formato de armazenamento (gravações/atualizações de todas as colunas):
Row-oriented > Column-oriented > Row-column hybrid
Por formato de armazenamento (gravações/atualizações de colunas parciais):
Row-oriented > Row-column hybrid > Column-oriented
Por modo de gravação para tabelas orientadas a colunas:
O desempenho é maior quando a tabela de destino não possui chave primária. Quando a tabela de destino possui uma chave primária, o desempenho segue a seguinte ordem:
InsertOrIgnore > InsertOrReplace >= InsertOrUpdate (full) > InsertOrUpdate (partial)
Por modo de gravação para tabelas orientadas a linhas:
InsertOrReplace = InsertOrUpdate (full) >= InsertOrUpdate (partial) >= InsertOrIgnore
Para tabelas com Binlog ativado:
Row-oriented > Row-column hybrid > Column-oriented
Modos de gravação
|
Modo de gravação |
Comportamento |
Requer chave primária |
|
|
Apenas adição. Não verifica linhas duplicadas. |
Não |
|
|
Se ocorrer um conflito de chave primária, descarta o registro recebido. |
Sim |
|
|
Se ocorrer um conflito de chave primária, substitui a linha existente. Define as colunas não incluídas na gravação como NULL. |
Sim |
|
|
Se ocorrer um conflito de chave primária, atualize apenas as colunas especificadas. As colunas não incluídas na gravação mantêm seus valores existentes. |
Sim |
Selecione um modo de gravação:
Use
Insertpara pipelines de apenas adição sem chave primária.Use
InsertOrIgnorequando a deduplicação for tratada na origem e for necessário o maior throughput de gravação com uma tabela de chave primária.Use
InsertOrReplacequando precisar substituir a linha inteira e o preenchimento com NULL for aceitável para colunas ausentes.Use
InsertOrUpdatepara atualizações de colunas parciais, aceitando um impacto no desempenho, pois o mecanismo precisa consultar a linha existente antes de gravar.
Identificar o gargalo
Verifique o uso de CPU no console do Hologres:
|
Uso de CPU |
Interpretação |
Próxima etapa |
|
Baixo |
Os recursos do Hologres estão subutilizados. O gargalo está na origem. |
Verifique se há leituras de dados lentas na origem. |
|
Alto (consistentemente perto de 100%) |
O Hologres atingiu um gargalo de recursos. |
Aplique os métodos de ajuste deste tópico. |
Se consultas e gravações forem executadas simultaneamente, as consultas podem elevar o uso de CPU e afetar o desempenho de gravação. Verifique os logs de consultas lentas para saber se as consultas simultâneas estão consumindo recursos. Caso estejam, considere configurar uma implantação de alta disponibilidade (HA) com read/write splitting.
Após testar todos os métodos de ajuste, se o desempenho de gravação ainda não atender aos seus requisitos, dimensione a instância do Hologres.
Ativar o Fixed Plan
O Fixed Plan é a otimização de maior impacto para o desempenho de gravação. Ative-o antes de aplicar outras otimizações.
Verificar se as gravações usam o Fixed Plan
No console do Hologres, verifique as seguintes métricas de RPS:
QE DML RPS: gravações que passam pelo caminho padrão HQE/PQE (bloqueios de tabela, maior latência).
FixedQE DML RPS: gravações que usam o Fixed Plan (bloqueios de linha, alta concorrência).
Para encontrar operações de gravação que não usam o Fixed Plan, consulte os logs de consultas lentas:
-- Find INSERT, UPDATE, and DELETE operations that did not use Fixed Plan in the last 3 hours
SELECT *
FROM hologres.hg_query_log
WHERE query_start >= now() - interval '3 h'
  AND command_tag IN ('INSERT', 'UPDATE', 'DELETE')
  AND ARRAY['HQE'] && engine_type
ORDER BY query_start DESC
LIMIT 500;
Cenários em que o Fixed Plan não é usado
As instruções SQL que atendem a qualquer uma das seguintes condições são executadas pelo caminho do HQE:
-
Sintaxe
INSERT ON CONFLICTpara várias linhas:INSERT INTO test_upsert(pk1, pk2, col1, col2) VALUES (1, 2, 5, 6), (2, 3, 7, 8) ON CONFLICT (pk1, pk2) DO UPDATE SET col1 = excluded.col1, col2 = excluded.col2; INSERT ON CONFLICTpara uma atualização parcial em que as colunas da tabela do Hologres não coincidem com as colunas dos dados inseridos.A tabela do Hologres contém colunas do tipo
SERIAL.A tabela do Hologres tem a propriedade
Defaultdefinida.UPDATEouDELETEcom base na chave primária (por exemplo:UPDATE table SET col1 = ?, col2 = ? WHERE pk1 = ? AND pk2 = ?).Tipos de dados não suportados pelo Fixed Plan.
Ativar o Fixed Plan para esses cenários
Use parâmetros GUC para estender a cobertura do Fixed Plan. Configure-os no nível do banco de dados:
|
Cenário |
Parâmetro GUC |
Observações |
|
|
|
Defina no nível do banco de dados. |
|
Colunas do tipo |
|
O padrão é |
|
Colunas com a propriedade |
Nenhum parâmetro GUC necessário no Hologres V1.3+. |
Na V1.3+, o |
|
|
|
O padrão é |
|
|
|
O padrão é |
Para mais detalhes, consulte Accelerate SQL execution with fixed plans.
Quando uma gravação usa o Fixed Plan, o Hologres a contabiliza na métrica FixedQE DML RPS, e o campo engine_type nos logs de consultas lentas mostra FixedQE.
Antes do Hologres V2.2, as gravações do Fixed Plan apresentavam o engine_type como SDK, e o console rastreava todas as gravações DML em uma única métrica de RPS combinada. A partir do Hologres V2.2, o engine_type é FixedQE, e a métrica se divide em QE DML RPS e FixedQE DML RPS. Para definições de métricas, consulte Monitoring metrics.
O Fixed Plan está ativado, mas as gravações continuam lentas
Se as gravações já usam o Fixed Plan, mas a latência permanece alta, a causa mais comum é a execução mista de gravações HQE e FixedQE na mesma tabela. As operações do HQE retêm bloqueios de tabela, o que bloqueia as gravações do FixedQE. Para verificar:
-- Find HQE operations on a specific table in the last 3 hours
SELECT *
FROM hologres.hg_query_log
WHERE query_start >= now() - interval '3 h'
  AND command_tag IN ('INSERT', 'UPDATE', 'DELETE')
  AND ARRAY['HQE'] && engine_type
  AND table_write = '<table_name>'
ORDER BY query_start DESC
LIMIT 500;
Reescreva as operações do HQE como instruções compatíveis com o FixedQE. Use Get query insights no HoloWeb para identificar rapidamente se um bloqueio do HQE está impedindo uma gravação do Fixed Plan.
Se todas as gravações já forem do FixedQE e a latência ainda estiver alta, verifique o uso de CPU. Um uso de CPU consistentemente alto indica um gargalo de recursos da instância; considere o dimensionamento horizontal.
Métodos básicos de ajuste
Usar uma conexão VPC
Use uma conexão de Virtual Private Cloud (VPC) em vez da rede pública. A rede pública tem limites de tráfego e latência maior do que uma VPC. Isso se aplica especialmente ao se conectar a partir de aplicações via Java Database Connectivity (JDBC) ou psql.
Para conhecer os tipos de rede suportados pelo Hologres e obter orientações sobre como escolher a melhor opção, consulte Network configurations.
Evitar ativar o Binlog em tabelas orientadas a colunas
O Binlog registra cada INSERT, UPDATE e DELETE no nível da linha completa. Para uma tabela orientada a colunas, registrar uma alteração de linha completa exige uma consulta pontual para ler a linha inteira, o que consome mais recursos do que em uma tabela orientada a linhas. Se o Binlog for necessário, use tabelas orientadas a linhas.
Evitar gravações em tempo real e em lote simultâneas na mesma tabela
As gravações em lote (por exemplo, do MaxCompute para o Hologres) usam bloqueios de tabela. As gravações de streaming (por exemplo, Flink ou DataWorks Data Integration) geralmente usam bloqueios de linha por meio do Fixed Plan. Quando ambas são executadas simultaneamente na mesma tabela, o bloqueio de tabela da gravação em lote bloqueia todas as gravações em tempo real até que seja liberado. Separe essas cargas de trabalho: execute gravações em lote em uma janela de manutenção ou grave em tabelas diferentes.
Usar INSERT OVERWRITE para substituir dados de partição
Quando precisar substituir ou limpar todos os dados em uma partição, use INSERT OVERWRITE em vez de DELETE seguido de INSERT.
O INSERT OVERWRITE é uma operação no nível de metadados que substitui os dados da partição trocando os ponteiros de arquivo. Ele é executado rapidamente e não aciona a lógica de poda dinâmica. Por outro lado, uma instrução DELETE exige que o mecanismo percorra todos os arquivos de dados na partição para localizar e remover linhas, causando uma sobrecarga significativa de I/O e CPU. O desempenho de gravação com DELETE + INSERT é substancialmente menor do que com INSERT OVERWRITE.
Ao usar uma tarefa agendada para gravar em uma tabela particionada, use parâmetros de agendamento e especifique a partição de destino diretamente na instrução INSERT OVERWRITE. Evite usar uma subconsulta para determinar quais dados excluir e reinserir.
-- Recommended: use INSERT OVERWRITE with scheduling parameters
INSERT OVERWRITE hologres_table PARTITION(ds='${bizdate}')
SELECT col1, col2, col3
FROM source_table
WHERE ds = '${bizdate}';

-- Not recommended: DELETE + INSERT
DELETE FROM hologres_table WHERE ds = '${bizdate}';
INSERT INTO hologres_table
SELECT col1, col2, col3
FROM source_table
WHERE ds = '${bizdate}';
Ajustar gravações do Holo Client e JDBC
Gravar em lotes
As gravações em lotes fornecem um throughput significativamente maior do que as gravações de registro único.
O Holo Client faz o agrupamento em lotes automaticamente. Use a configuração padrão.
-
JDBC: adicione
reWriteBatchedInserts=trueà string de conexão:jdbc:postgresql://{ENDPOINT}:{PORT}/{DBNAME}?ApplicationName={APPLICATION_NAME}&reWriteBatchedInserts=true
O exemplo a seguir mostra como o processamento em lotes funciona:
-- Two separate inserts (low throughput)
INSERT INTO data_t VALUES (1, 2, 3);
INSERT INTO data_t VALUES (2, 3, 4);

-- Batched insert (higher throughput)
INSERT INTO data_t VALUES (1, 2, 3), (4, 5, 6);

-- Alternatively, using unnest
INSERT INTO data_t
SELECT unnest(ARRAY[1, 4]::int[]), unnest(ARRAY[2, 5]::int[]), unnest(ARRAY[3, 6]::int[]);
Para mais detalhes, consulte Holo Client e JDBC.
Usar o modo Prepared Statement
O Hologres suporta o protocolo estendido do PostgreSQL e o modo Prepared Statement. Esse modo armazena em cache os resultados da compilação SQL no servidor, eliminando a sobrecarga de análise repetida do frontend (FE) e do QO a cada gravação, o que é especialmente benéfico para gravações de alta frequência.
Para saber como ativar o modo Prepared Statement com JDBC e Holo Client, consulte JDBC.
Ajustar gravações do Flink
Requisitos de tipo de tabela
Tabelas de origem de Binlog:
O Flink suporta um conjunto limitado de tipos de dados ao consumir o Binlog do Hologres. Se um tipo não suportado (como
SMALLINT) estiver presente no schema, o job poderá falhar mesmo que esse campo não seja consumido. No Ververica Runtime (VVR) 6.0.3 e posterior, use o modo JDBC para consumo do Binlog, pois ele suporta mais tipos de dados.Use tabelas orientadas a linhas para origens com Binlog ativado. Ativar o Binlog em tabelas orientadas a colunas consome mais recursos e reduz o desempenho de gravação.
Tabelas de dimensão:
Use tabelas orientadas a linhas ou híbridas de linha e coluna. Tabelas orientadas a colunas têm alta sobrecarga em cenários de consulta pontual.
Defina uma chave primária. Configure a chave primária como a chave de clusterização para obter um melhor desempenho.
A chave primária da tabela de dimensão deve corresponder exatamente aos campos usados na cláusula
JOIN ONdo Flink; ambos devem ser idênticos.
Tabelas de destino:
Para mesclagens de tabelas largas ou atualizações parciais, a tabela do Hologres deve ter uma chave primária. Cada tabela de destino deve declarar e gravar no campo da chave primária, usar o modo de gravação
InsertOrUpdatee definirignoredelete = truepara evitar que mensagens de retração gerem solicitaçõesDELETE.Para tabelas orientadas a colunas em cenários de mesclagem de tabelas largas, desative o Dictionary Encoding para os campos da tabela a fim de reduzir o uso de CPU em altas taxas de registros por segundo (RPS).
Defina uma
segment_keyem tabelas que possuem uma chave primária. Use um campo de timestamp ou data com forte correlação com o tempo de gravação; isso ajuda o mecanismo a localizar rapidamente o arquivo de dados de destino durante gravações e atualizações.
Configurações recomendadas do conector do Flink
Os valores padrão das opções do conector do Hologres são adequados para a maioria dos cenários. Ajuste-os quando encontrar os seguintes problemas:
Alta latência no consumo do Binlog:
O tamanho padrão do lote de leitura (binlogBatchReadSize) é de 100 linhas. Se as linhas individuais forem pequenas, aumente esse valor para reduzir a latência de consumo.
Baixo desempenho de consulta pontual na tabela de dimensão:
Defina
async = truee ative o modo assíncrono, que processa várias solicitações simultaneamente e elimina o bloqueio entre solicitações consecutivas. Vale ressaltar que o modo assíncrono não garante uma ordem rigorosa das solicitações.Para tabelas de dimensão grandes e atualizadas com pouca frequência, ative o cache LRU: defina
cache = 'LRU'. OcacheSizepadrão é de 10.000 linhas (conservador); aumente-o com base no tamanho real da tabela e nos padrões de acesso.
Esgotamento de conexões com muitos jobs do Flink:
Use o parâmetro connectionPoolName. Tabelas com o mesmo nome de pool de conexões dentro do mesmo TaskManager compartilham conexões.
Preferências no desenvolvimento de jobs
Prefira o Flink SQL ao DataStream para facilitar a manutenção e a portabilidade:
Flink SQL > Flink DataStream (connector) > Flink DataStream (holo-client) > Flink DataStream (JDBC)
Para jobs do DataStream, use o Hologres DataStream connector ou o Holo Client em vez do JDBC puro.
Diagnosticar gravações lentas do Flink
Gravações lentas no Flink podem ser causadas por gargalos anteriores no job, e não no destino do Hologres. Verifique se há backpressure nos nós. Se o backpressure aparecer nos nós de origem ou de computação, os dados que chegam ao destino do Hologres já estão lentos; otimize primeiro as etapas upstream do Flink.
Se o uso de CPU do Hologres estiver consistentemente perto de 100% e a latência de gravação estiver alta, o gargalo está no lado do Hologres.
Para erros e soluções comuns do Flink, consulte Blink and Flink FAQ and diagnostics.
Ajustar gravações do DataWorks Data Integration
Configurações de conexão e concorrência
No modo assistente, cada thread concorrente usa três conexões. No modo de editor de código, configure:
maxConnectionCount: total de conexões para a tarefa.insertThreadCount: conexões por thread concorrente.
Na maioria dos casos, as configurações padrão de concorrência e conexão oferecem um bom desempenho. Ajuste apenas quando observar contenção de recursos.
Dimensionamento do grupo de recursos exclusivo
A maioria dos jobs do Data Integration requer grupos de recursos exclusivos. As especificações do grupo de recursos definem o limite superior de desempenho para a tarefa. Para um throughput ideal, aloque uma thread concorrente por núcleo de CPU no grupo de recursos.
Se o grupo de recursos for subdimensionado em relação à concorrência da tarefa, podem ocorrer erros de memória da JVM. Se a largura de banda do grupo de recursos estiver saturada, divida a tarefa em tarefas menores e distribua-as por vários grupos de recursos. Para especificações e métricas de grupos de recursos, consulte Performance metrics.
Diagnosticar se o gargalo está na origem ou no Hologres
Se o tempo de espera do lado da leitura for maior que o tempo de espera do lado da gravação, o gargalo está na fonte de dados.
Se o uso de CPU do Hologres estiver consistentemente alto e a latência de gravação estiver elevada, o gargalo está no lado do Hologres.
Gravações do DataX estão lentas com alto uso de CPU
Se as gravações do DataX estiverem lentas e o monitoramento da instância do Hologres mostrar que o uso de CPU permanece em um nível alto (por exemplo, alguns nós de trabalho atingem 100%), a saturação dos recursos de CPU está fazendo com que as solicitações de gravação recebidas entrem em fila ou sofram atrasos no processamento.
Para resolver esse problema:
Verifique se as gravações usam o Fixed Plan. No console do Hologres, verifique as métricas de RPS. Se as gravações aparecerem em QE DML RPS (caminho do HQE) em vez de FixedQE DML RPS, elas não estão usando o Fixed Plan. Configure os parâmetros GUC ou reescreva as instruções SQL para ativar o Fixed Plan. Para obter detalhes, consulte a seção Ativar o Fixed Plan neste tópico.
Se o Fixed Plan já estiver ativado, mas o uso de CPU permanecer consistentemente alto, a instância atingiu sua capacidade de recursos. Dimensione a instância do Hologres para adicionar mais recursos de computação.
Ajustes avançados
Esses métodos resolvem problemas de desempenho causados pela distribuição de dados e pela configuração das tabelas. Aplique-os após ativar o Fixed Plan e usar os métodos básicos de ajuste.
Desbalanceamento de dados
Quando os dados estão desbalanceados ou a chave de distribuição está configurada incorretamente, os recursos de computação na instância do Hologres ficam desiguais: alguns shards fazem muito mais trabalho do que outros. Para verificar e resolver o desbalanceamento de dados, consulte Detect and handle workload skew.
Chave de segmento inadequada
A chave de segmento controla como o Hologres particiona os dados nos arquivos de armazenamento subjacentes. Durante gravações e atualizações, o Hologres usa a chave de segmento para localizar as linhas existentes. Se a chave de segmento estiver ausente, definida como um campo não relacionado, ou se os dados no campo da chave de segmento não tiverem correlação com o tempo de gravação (por exemplo, se chegarem fora de ordem), cada gravação precisará percorrer um grande número de arquivos, consumindo muito I/O e CPU mesmo quando a carga de trabalho for focada em gravação.
Um sintoma: a métrica de throughput de I/O no console mostra um valor de leitura alto durante cargas de trabalho predominantemente de gravação.
Solução: Use um campo de timestamp ou data como chave de segmento. Os dados nesse campo devem ter uma forte correlação com o tempo de gravação; valores que chegam aproximadamente em ordem cronológica produzem os melhores resultados.
Chave de clusterização inadequada em tabelas orientadas a linhas
Para uma tabela orientada a linhas com uma chave primária, o Hologres usa tanto o índice da chave primária quanto o índice da chave de clusterização para procurar as linhas existentes durante gravações ou atualizações. Se a chave de clusterização for diferente da chave primária, cada gravação realizará duas pesquisas de índice em vez de uma, aumentando a latência.
Mantenha a chave de clusterização e a chave primária idênticas em tabelas orientadas a linhas.
Em tabelas orientadas a colunas, a chave de clusterização afeta o desempenho da consulta, e não o desempenho de gravação. Nenhuma alteração é necessária para a otimização de gravação.