A Dynamic Table do Hologres é uma arquitetura declarativa de processamento de dados que processa e armazena automaticamente resultados agregados de uma ou mais tabelas base. Ela inclui políticas integradas e configuráveis de atualização de dados que permitem o encaminhamento automático de dados das tabelas base para as Dynamic Tables, atendendo às necessidades de desenvolvimento unificado, encaminhamento automático de dados e processamento oportuno.
Quando usar a Dynamic Table
A Dynamic Table é adequada quando:
Automatize a transformação de dados sem escrever código personalizado de agendamento.
Evite rastrear manualmente dependências de dados e gerenciar cronogramas de atualização.
Encadeie várias tabelas para transformação de dados em um pipeline — por exemplo, construa automaticamente as camadas de detalhe do data warehouse (DWD) → service de data warehouse (DWS) → service de dados de aplicação (ADS).
Sua carga de trabalho não exige atualidade estrita em tempo real e uma tempestividade no nível de minutos ou horas é suficiente.
Consolide uma arquitetura Lambda em um único mecanismo com uma interface SQL unificada.
Vantagens
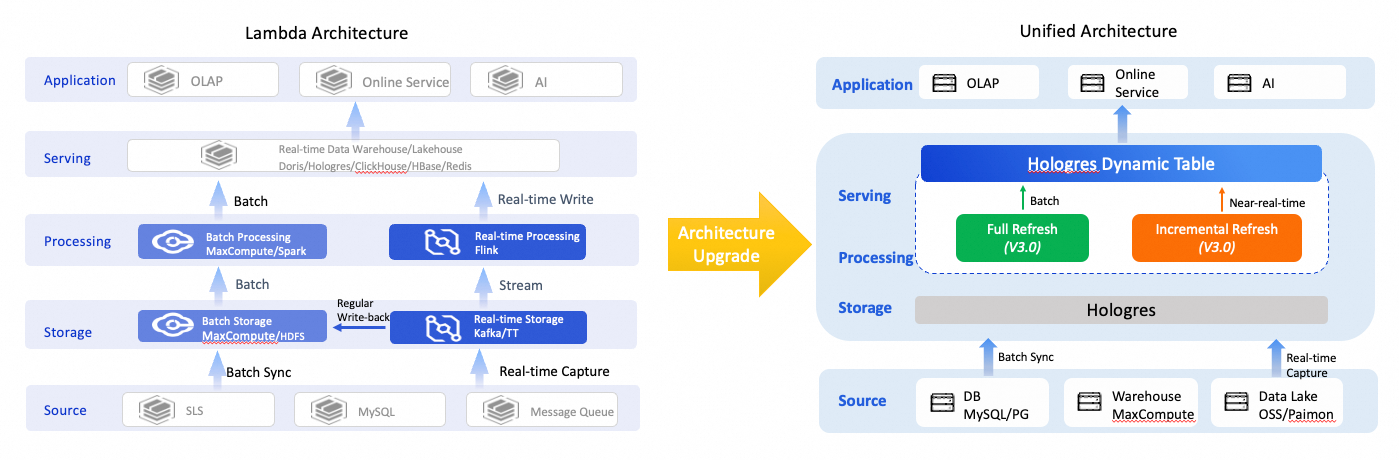
Arquitetura de data warehouse simplificada: Os modos de atualização completa e incremental suportam tanto a transformação de dados offline quanto a transformação quase em tempo real. Com base no armazenamento unificado do Hologres, a Dynamic Table atende diretamente a vários cenários de aplicação — consultas de processamento analítico online (OLAP), services online e cargas de trabalho de IA — usando um único mecanismo, uma única computação e uma única instrução SQL. Isso substitui a arquitetura Lambda e reduz os custos de desenvolvimento e de operações e manutenção (O&M).
Automatic data warehouse layering: A Dynamic Table aciona automaticamente uma atualização com base na atualidade dos dados da tabela base, permitindo o encaminhamento automático de dados entre as camadas operation data store (ODS) → DWD → DWS → ADS.
Maior eficiência de ETL: A atualização incremental processa apenas novos dados da tabela base em cada execução, reduzindo o volume de dados computados por ciclo de extração, transformação e carga (ETL). Os recursos não precisam permanecer constantemente ativos, como ocorre na computação de fluxo. As atualizações automáticas acionadas pela atualidade dos dados reduzem os custos de computação.
Menores custos de desenvolvimento e O&M: Todos os modos de atualização utilizam uma interface SQL unificada. As Dynamic Tables gerenciam automaticamente as tarefas de atualização e as dependências hierárquicas entre as camadas, simplificando fluxos de trabalho complexos de desenvolvimento e O&M.
Conceitos principais
Tabela base: source de dados para uma Dynamic Table. Pode ser uma única tabela interna ou externa, ou uma junção de várias tabelas. Os tipos de tabela base suportados variam conforme o modo de atualização. Para mais informações, consulte Supported features and limits of Dynamic Table.
Consulta: Consulta especificada ao criar uma Dynamic Table. Define como os dados da tabela base são processados, de forma semelhante a um processo de ETL. Os tipos de consulta suportados variam conforme o modo de atualização. Para mais informações, consulte Supported features and limits of Dynamic Table.
Atualização: Quando os dados em uma tabela base mudam, a Dynamic Table deve ser atualizada para refletir essas alterações. As Dynamic Tables executam automaticamente tarefas de atualização em segundo plano, com base no horário de início e no intervalo configurados. Para mais informações sobre monitoramento e gerenciamento de tarefas de atualização, consulte Manage Dynamic Table refresh tasks.
Como funciona
Os dados de uma tabela base são gravados em uma Dynamic Table por meio de um processo de atualização, seguindo o fluxo de processamento definido pela consulta da Dynamic Table. As seções a seguir descrevem os princípios técnicos da Dynamic Table, abrangendo modos de atualização, recursos de computação, armazenamento de dados e índices de tabela.
Modos de atualização
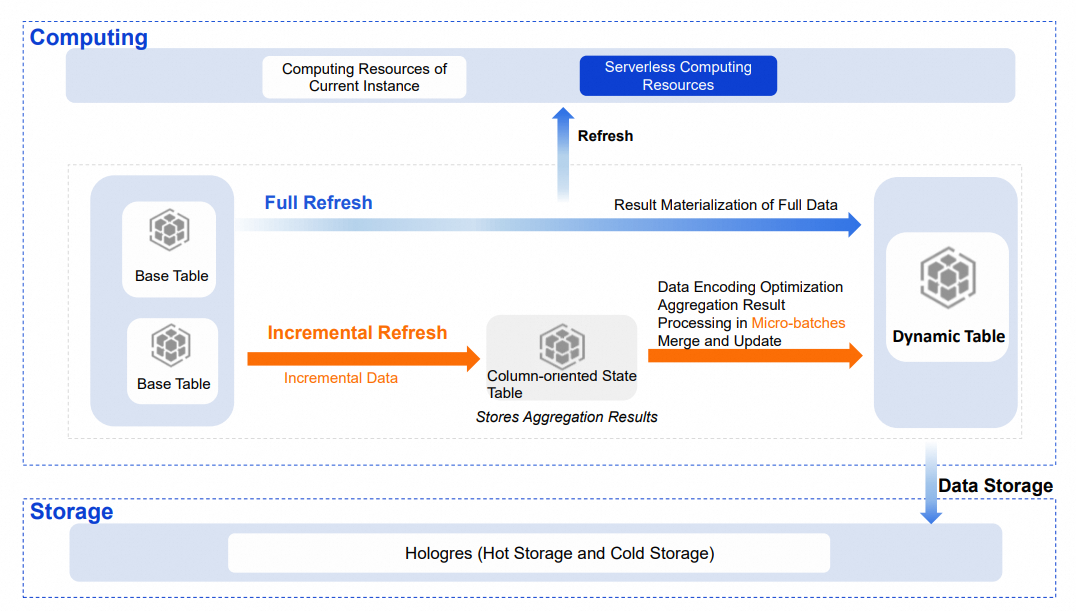
A Dynamic Table suporta dois modos de atualização: completa e incremental. Os princípios técnicos subjacentes diferem dependendo do modo de atualização configurado.
Atualização completa
Uma atualização completa reprocessa todos os dados durante cada execução e sobrescreve a Dynamic Table com os resultados completos computados a partir da tabela base, seguindo um princípio semelhante ao de uma operação INSERT OVERWRITE. Esse processo pode gerar um grande volume de dados de Binlog e causar sobrecarga significativa de armazenamento extra. Para mais informações sobre os limites e como desativar o Binlog, consulte INSERT OVERWRITE.
Atualização incremental
A atualização incremental lê apenas novos dados da tabela base em cada execução. Ela calcula o resultado final com base no estado de agregação intermediário e nos dados incrementais e, em seguida, atualiza a Dynamic Table. Em comparação com a atualização completa, a atualização incremental processa menos dados por execução, o que melhora a tempestividade e reduz o uso de recursos de computação.
Princípio técnico
Ao criar uma Dynamic Table com atualização incremental, o sistema lê dados incrementais da tabela base usando o método Stream ou Binlog. Em seguida, cria uma tabela de estado orientada a colunas em segundo plano, que armazena o estado de agregação intermediário da consulta. O mecanismo DPI otimiza a codificação e o armazenamento desse estado intermediário para acelerar a leitura e a atualização. Os dados incrementais são agregados em microlotes na memória e mesclados com a tabela de estado. Os resultados agregados mais recentes são então gravados na Dynamic Table usando o método BulkLoad.
Escolha entre Stream e Binlog
|
Método |
Princípio |
Desempenho de leitura |
Observações |
|
Stream (recomendado) |
Detecta alterações de dados no nível do arquivo para computar os dados incrementais da tabela base. |
Mais de 10 vezes superior ao Binlog. |
Mais simples de usar. Não registra alterações incrementais separadamente — sem sobrecarga extra de armazenamento e sem necessidade de gerenciamento de ciclo de vida de log binário. Não suporta tabelas orientadas a linhas como tabelas base. |
|
Binlog |
O registro binário grava alterações de Linguagem de Manipulação de Dados (DML) na tabela base e as armazena como um log binário em segundo plano. O sistema lê o log binário para detectar alterações nos dados. |
Inferior. |
Gera sobrecarga extra de armazenamento. Exige gerenciamento do ciclo de vida de armazenamento do log binário (TTL); caso contrário, o uso de armazenamento cresce continuamente conforme os dados mudam. |
Notas de uso
Existem certos limites para as tabelas base suportadas pela atualização incremental. Para mais informações, consulte Supported features and limits of Dynamic Table.
A tabela de estado integrada para atualização incremental ocupa espaço de armazenamento. O sistema define um TTL para limpar periodicamente os dados. Use a função fornecida para visualizar o tamanho de armazenamento da tabela de estado. Para mais informações, consulte Manage state tables.
Escolher um modo de atualização
Utilize os seguintes critérios para selecionar um modo de atualização:
|
Condição |
Modo recomendado |
|
A consulta usa operadores suportados e as tabelas base não são orientadas a linhas |
Incremental |
|
Uma grande porcentagem de dados muda por atualização ou a consulta inclui operadores não suportados |
Completa |
|
Carga inicial ou garantia de consistência de dados entre camadas |
Completa (única vez) |
Recursos de computação
As tarefas de atualização podem usar recursos da instância atual ou recursos Serverless:
Recursos Serverless (padrão): No Hologres V3.1 e posterior, novas Dynamic Tables usam recursos Serverless por padrão. Para consultas complexas ou grandes volumes de dados, os recursos Serverless melhoram a estabilidade da atualização e evitam contenção de recursos entre tarefas dentro da instância. Os recursos de computação para uma única tarefa de atualização podem ser ajustados independentemente.
Recursos da instância atual: A tarefa de atualização compartilha recursos com outras tarefas na instância, o que pode causar contenção de recursos durante horários de pico.
Armazenamento de dados
O armazenamento de dados de uma Dynamic Table é igual ao de uma tabela padrão, usando o modo de armazenamento quente por padrão. Para reduzir custos de armazenamento, mova dados raramente consultados para o armazenamento frio.
Índices de tabela
Consultar uma Dynamic Table diretamente equivale a consultar os resultados agregados, o que melhora significativamente o desempenho da consulta. Assim como as tabelas padrão, as Dynamic Tables suportam índices de tabela, como armazenamento de linhas ou colunas, Distribution Key e Clustering Key. O mecanismo DPI infere índices adequados com base na consulta da Dynamic Table. Defina índices adicionais para melhorar ainda mais o desempenho da consulta.
Comparação com visualizações materializadas
Dynamic Table vs. visualização materializada em tempo real do Hologres
O Hologres introduziu SQL-managed materialized views na versão V1.3. A Dynamic Table estende significativamente esses recursos.
| Recurso | Dynamic Table do Hologres | Visualização materializada em tempo real do Hologres |
|---|---|---|
| Tipo de tabela base | Tabela interna; Tabela externa (MaxCompute, Paimon, OSS); Dynamic Table; View | Única tabela interna |
| Operações na tabela base | Gravação, Atualização, Exclusão | Gravações apenas por acréscimo |
| Princípio de atualização | Atualização assíncrona (completa ou incremental) | Síncrona |
| Tempestividade da atualização | Nível de minutos ou horas | Tempo real |
| Tipos de consulta | Agregação de tabela única; Junção de múltiplas tabelas; JOIN de tabela de dimensão; OLAP complexo (funções de janela, CTEs, RB, etc.) Nota
Os tipos de consulta suportados variam conforme o modo de atualização. Para mais informações, consulte Supported features and limits of Dynamic Table. |
Suporte limitado a operadores (AGG, funções RB, etc.) |
| Modo de consulta | Consultar a Dynamic Table diretamente | Consultar a visualização materializada diretamente; Reescrita de consulta |
Dynamic Table vs. visualização materializada assíncrona
Outras plataformas oferecem recursos semelhantes à Dynamic Table, como visualizações materializadas assíncronas em products OLAP e a Dynamic Table do Snowflake.
| Recurso | Dynamic Table do Hologres | Visualização materializada assíncrona de product OLAP | Dynamic Table do Snowflake |
|---|---|---|---|
| Tipo de tabela base | Tabela interna; Tabela externa (MaxCompute, Paimon, OSS); Dynamic Table; View Nota
Os tipos de consulta suportados variam conforme o modo de atualização. Para mais informações, consulte Supported features and limits of Dynamic Table. |
Tabela interna; Tabela externa (Hive, Hudi, Iceberg, etc.); Visualização materializada; View | Tabela interna; Dynamic Table; View |
| Modo de atualização | Completa; Incremental | Completa; Atualização por partição especificada ou intervalo de timestamp | Completa; Incremental |
| Tempestividade da atualização | Nível de minutos ou horas | Nível de horas | Nível de horas ou minutos |
| Tipos de consulta | Agregação de tabela única; Junção de múltiplas tabelas; JOIN de tabela de dimensão; OLAP complexo (funções de janela, CTEs, RB, etc.) | Agregação de tabela única; Junção de múltiplas tabelas; JOIN de tabela de dimensão; OLAP complexo (funções de janela, CTEs, etc.) | Agregação de tabela única; Junção de múltiplas tabelas; JOIN de tabela de dimensão; OLAP complexo (funções de janela, CTEs, etc.) |
| Modo de consulta | Consultar a Dynamic Table diretamente | Consultar a visualização materializada diretamente; Reescrita de consulta | Consultar a Dynamic Table diretamente |
| Monitoramento/O&M | Interfaces de visualização do DataWorks e HoloWeb; Métricas ricas de monitoramento | Métricas ricas de monitoramento | Interface de visualização |
Casos de uso
A Dynamic Table conclui automaticamente a transformação e o armazenamento de dados, oferecendo aceleração de dados e melhoria na tempestividade dos negócios.
Atualização da arquitetura Lambda
A arquitetura Lambda usa vários componentes de product para atender a diferentes requisitos de tempestividade, resultando em uma arquitetura redundante, definições de dados inconsistentes, manutenção difícil e redundância de armazenamento. A Dynamic Table suporta transformação de dados em lote e processamento quase em tempo real. Combinada com o armazenamento unificado do Hologres — que suporta consultas OLAP e consultas pontuais de chave-valor (KV) — ela cobre vários cenários de aplicação dentro de um único product, simplificando a arquitetura e reduzindo a complexidade de desenvolvimento e os custos de armazenamento.
Processamento de dados quase em tempo real
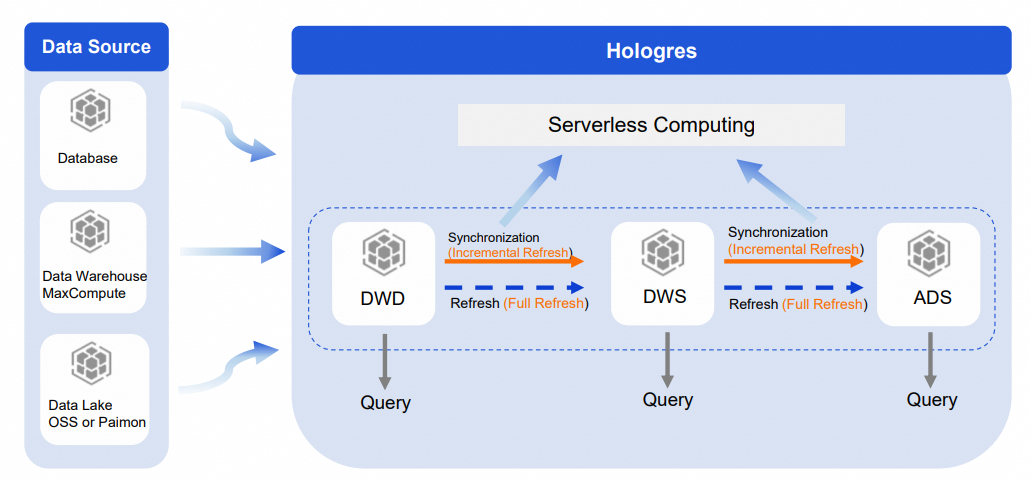
Para tabelas base grandes que exigem processamento complexo de ETL, a criação de camadas de data warehouse é a abordagem padrão. A Dynamic Table possui processamento automático de dados integrado, facilitando a implementação de camadas no Hologres.
Construa as camadas DWD → DWS → ADS no Hologres usando Dynamic Tables:
Use atualização incremental entre as camadas. Isso garante que menos dados sejam processados em cada camada, reduz cálculos repetidos e melhora a velocidade de sincronização. Envie tarefas de atualização para o Serverless Computing para aumentar ainda mais a tempestividade e a estabilidade.
Execute uma atualização completa única para garantir a consistência dos dados entre as camadas. Envie a tarefa de atualização completa também para o Serverless Computing.
Cada camada é consultável diretamente no Hologres, fornecendo camadas claras de data warehouse com visibilidade e reutilização em todos os níveis.
Aceleração de Lakehouse
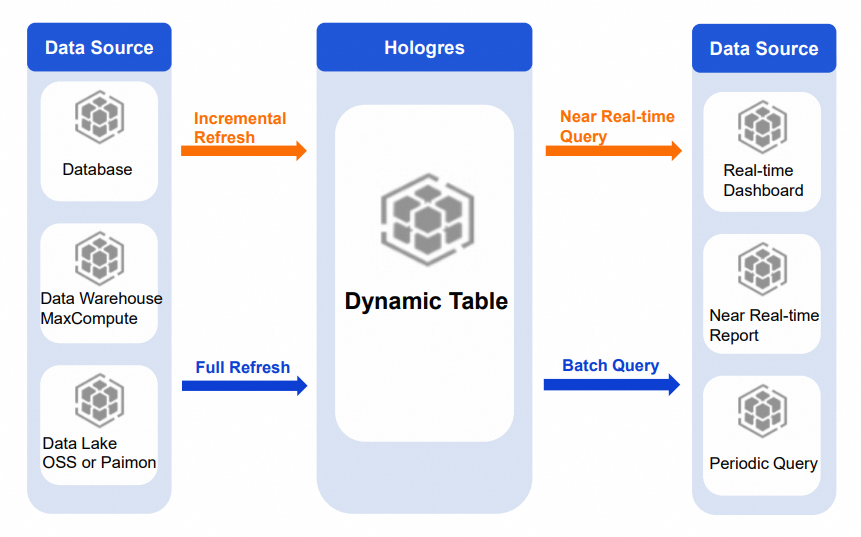
As tabelas base da Dynamic Table podem vir de tabelas do Hologres, data warehouses como MaxCompute ou data lakes como OSS e Paimon. Atualizações completas ou incrementais nesses dados atendem a várias necessidades de consulta e exploração com diferentes requisitos de tempestividade.
Consultas periódicas de relatórios: Para cenários de observação periódica com pequenos volumes de dados ou consultas simples, use atualização completa ou incremental. Atualize periodicamente os resultados de agregação e análise dos dados do lakehouse para uma Dynamic Table. A camada de aplicação consulta a Dynamic Table diretamente para recuperar resultados pré-computados, acelerando as consultas de relatórios.
Painéis e relatórios em tempo real: Para cenários com maiores requisitos de tempestividade, use atualização incremental. Atualize os resultados de agregação e análise do Paimon ou de dados em tempo real para uma Dynamic Table, permitindo análises quase em tempo real.
Substituição de agendamento periódico offline
Em cenários típicos de processamento offline, o volume de dados é grande e o ciclo de computação é longo. Uma abordagem comum executa processamento T+H (por exemplo, a cada 30 minutos) de DWD para DWS e para ADS, além de um pipeline offline T+1 separado para processar os dados dos últimos dias visando precisão. Isso resulta em computação redundante, desperdício de recursos e duplicação de dados. Tarefas agendadas também podem bloquear jobs downstream quando não são concluídas a tempo.
Com a Dynamic Table, use atualização incremental T+H para cada camada de DWD para DWS e para ADS. Vários jobs são mesclados em um único job de computação incremental. As Dynamic Tables lidam com o agendamento automaticamente, eliminando a necessidade de manter jobs de agendamento externos. Apenas dados incrementais são computados a cada vez, o que elimina computação redundante, acelera os cálculos, evita acúmulos de tarefas e reduz significativamente o uso de recursos de computação.
