Para melhorar o desempenho de consultas de dados JSONB, o Hologres V1.3 e versões posteriores oferecem otimização de armazenamento orientado a colunas para o tipo JSONB. Esse recurso reduz o tamanho do armazenamento e acelera as consultas. Este tópico explica como usar o JSONB colunar no Hologres.
Princípios do JSONB colunar
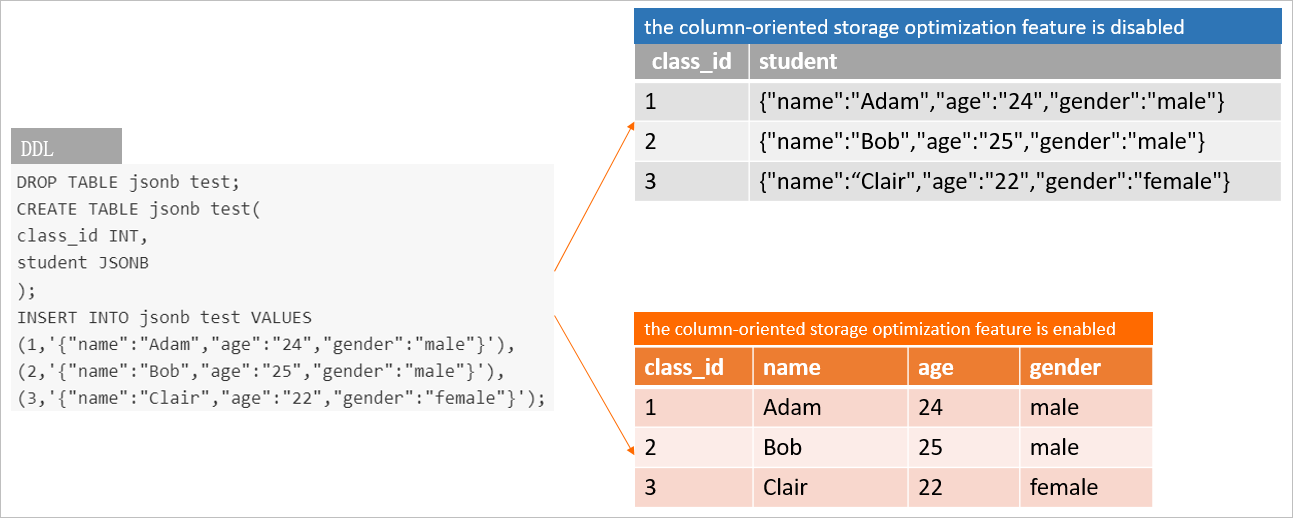
Conforme ilustrado na figura a seguir, ao ativar a otimização de armazenamento orientado a colunas para JSONB, o sistema converte automaticamente a coluna JSONB em um formato de armazenamento orientado a colunas e fortemente tipado na camada subjacente. Ao consultar um valor específico nos dados JSONB, o sistema acessa diretamente a coluna correspondente, melhorando o desempenho da consulta. Além disso, como os valores dos dados JSONB são armazenados em formato orientado a colunas, eles atingem a mesma eficiência de armazenamento e compressão dos dados estruturados comuns. Isso reduz os custos de armazenamento e aumenta a relação custo-benefício.
A otimização de armazenamento orientado a colunas para JSONB não se aplica ao tipo de dados JSON.
Limitações
Para obter o melhor desempenho, atualize sua instância do Hologres para a V1.3.37 ou posterior antes de usar o recurso de JSONB colunar. Para solicitar uma atualização, consulte Common errors when upgrade preparation fails ou entre no grupo do DingTalk do Hologres. Para mais informações, consulte How to get more online support?.
A otimização orientada a colunas para JSONB aplica-se apenas a tabelas orientadas a colunas. Além disso, a otimização é acionada somente depois que a tabela contém pelo menos 1.000 linhas.
-
Atualmente, apenas os operadores a seguir suportam a otimização de armazenamento orientado a colunas. O uso de operadores não suportados nas consultas pode degradar o desempenho.
Operador
Tipo do operando direito
Descrição
Operação e resultado
->
text
Obtém um campo de objeto JSON por chave.
-
Exemplo:
select '{"a": {"b":"foo"}}'::json->'a' -
Resultado:
{"b":"foo"}
->>
text
Obtém um campo de objeto JSON como TEXT.
-
Exemplo:
select '{"a":1,"b":2}'::json->>'b' -
Resultado:
2
-
Uso do JSONB colunar
Ative o JSONB colunar
Use a instrução a seguir para ativar a otimização de armazenamento orientado a colunas para uma coluna JSONB específica em uma tabela.
-- Enable column-oriented storage optimization for a specific column in a specific table.
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_columnar_type = ON);
table_name é o nome da tabela. column_name é o nome da coluna.
Após ativar a otimização de armazenamento orientado a colunas para JSONB, o sistema converte os dados históricos para o armazenamento orientado a colunas durante a compactação. A conversão é concluída após a compactação.
A compactação consome recursos do sistema, como memória. Execute essa operação fora dos horários de pico. Execute o comando
vacuum table_name;para forçar uma compactação. O processo de compactação termina quando o comando vacuum finaliza a execução.Depois que a compactação é concluída, os novos dados gravados são armazenados no formato orientado a colunas.
Ative inferência de tipo DECIMAL
Antes de ativar a inferência de tipo DECIMAL, certifique-se de que a otimização de armazenamento orientado a colunas para JSONB já esteja ativada.
O Hologres V2.0.11 e versões posteriores suportam a otimização de armazenamento orientado a colunas para dados DECIMAL. Considere os seguintes dados JSON como exemplo:
{
  "name":"Mike",
  "statistical_period":"2023-01-01 00:00:00+08",
  "balance":123.45
}
Ao ativar a inferência de tipo DECIMAL, o valor de balance também passa a suportar a otimização orientada a colunas. Use a instrução a seguir para ativar esse recurso:
-- Enable column-oriented optimization for DECIMAL values in a specific column in a specific table.
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_decimal = ON);
table_name é o nome da tabela. column_name é o nome da coluna.
Verifique o status do JSONB colunar
Use as instruções a seguir para verificar o status do JSONB colunar de uma tabela.
-
O comando a seguir é suportado no Hologres V1.3.37 e versões posteriores.
NotaNo Hologres V2.0.17 e versões anteriores, este comando mostra apenas tabelas no schema
public. A partir da V2.0.18, ele pode mostrar o status de tabelas em outros schemas.-- In V2.0.17 and earlier, you can query only tables in the public schema. In V2.0.18 and later, you can query tables in other schemas. SELECT * FROM hologres.hg_column_options WHERE schema_name='<schema_name>' AND table_name = '<table_name>';schema_name é o nome do schema e table_name é o nome da tabela.
-
Para o Hologres V1.3.10 até a V1.3.36, use o comando a seguir.
SELECT DISTINCT
    a.attnum as num,
    a.attname as name,
    format_type(a.atttypid, a.atttypmod) as type,
    a.attnotnull as notnull,
    com.description as comment,
    coalesce(i.indisprimary,false) as primary_key,
    def.adsrc as default,
    a.attoptions
FROM pg_attribute a
JOIN pg_class pgc ON pgc.oid = a.attrelid
LEFT JOIN pg_index i ON
    (pgc.oid = i.indrelid AND i.indkey[0] = a.attnum)
LEFT JOIN pg_description com on
    (pgc.oid = com.objoid AND a.attnum = com.objsubid)
LEFT JOIN pg_attrdef def ON
    (a.attrelid = def.adrelid AND a.attnum = def.adnum)
WHERE a.attnum > 0 AND pgc.oid = a.attrelid
AND pg_table_is_visible(pgc.oid)
AND NOT a.attisdropped
AND pgc.relname = '<table_name>'
ORDER BY a.attnum;
table_name é o nome da tabela.
-
Exemplo de resultado:
No resultado, se a propriedade attoptions ou option de uma coluna for
enable_columnar_type = ON, isso indica que a configuração foi bem-sucedida.num | name | type | notnull | comment | primary_key | default | attoptions ------+------+--------------------------+---------+---------+-------------+---------+------------------------------ 1 | ds | timestamp with time zone | f | | f | | 2 | tags | jsonb | f | | f | | {enable_columnar_type=on} (2 rows)
Desativar o JSONB colunar
Use o comando a seguir para desativar a otimização de armazenamento orientado a colunas para uma coluna JSONB específica em uma tabela.
-- Disable column-oriented storage optimization for a specific column in a specific table.
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_columnar_type = OFF);
table_name é o nome da tabela. column_name é o nome da coluna.
Após desativar a otimização de armazenamento orientado a colunas para JSONB, o sistema converte os dados históricos de volta para o formato de armazenamento JSONB padrão durante a compactação. A conversão é concluída após a compactação.
A compactação consome recursos do sistema, como memória. Execute essa operação fora dos horários de pico. Execute o comando
vacuum table_name;para forçar uma compactação. O processo de compactação termina quando o comando vacuum finaliza a execução.Depois que a compactação é concluída, os novos dados gravados são armazenados no formato JSONB padrão.
Desativar inferência de tipo DECIMAL
Para desativar a inferência de tipo DECIMAL para uma coluna específica, use o comando a seguir.
-- Disable column-oriented optimization for DECIMAL values in a specific column in a specific table.
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_decimal = OFF);
table_name é o nome da tabela. column_name é o nome da coluna.
Desativar a inferência de tipo DECIMAL aciona imediatamente uma compactação para converter os dados DECIMAL previamente otimizados de volta ao formato original.
Defina um índice bitmap
No Hologres, a propriedade bitmap_columns especifica um índice bitmap, que é uma estrutura de índice independente, separada do armazenamento de dados. Ela utiliza uma estrutura de vetor bitmap para acelerar comparações de igualdade, permitindo filtragem rápida de igualdade de dados dentro de blocos de arquivos. A partir da V2.0, o Hologres suporta a definição de um índice bitmap para colunas JSONB que têm o armazenamento orientado a colunas ativado. Após a ativação do JSONB colunar, o sistema analisa os dados em sete tipos de dados: int, int[], bigint, bigint[], text, text[] e jsonb. Quando um índice bitmap é ativado, o sistema cria um índice bitmap para dados inferidos como tipos int, int[], bigint, bigint[], text e text[].
A sintaxe é a seguinte:
call set_table_property('<table_name>', 'bitmap_columns', '[<columnName>{:[on|off]}[,...]]');Parâmetros:
|
Parâmetro |
Descrição |
|
table_name |
O nome da tabela. |
|
columnName |
O nome da coluna. |
|
on |
Ativa o índice bitmap para o campo especificado. Importante
Você só pode definir um índice bitmap para colunas JSONB que tenham o armazenamento orientado a colunas ativado. |
|
off |
Desativa o índice bitmap para o campo especificado. |
Exemplo
-
Crie uma tabela.
DROP TABLE IF EXISTS user_tags; -- Create a data table BEGIN; CREATE TABLE IF NOT EXISTS user_tags ( ds timestamptz, tags jsonb ); COMMIT; -
Ative a otimização de armazenamento orientado a colunas para a coluna
tags.ALTER TABLE user_tags ALTER COLUMN tags SET (enable_columnar_type = ON); -
Verifique o status do armazenamento JSONB colunar.
select * from hologres.hg_column_options where table_name = 'user_tags';No resultado a seguir, a propriedade options da linha tags é {enable_columnar_type=on}, o que indica que a configuração foi bem-sucedida.
schema_name | table_name | column_id | column_name | column_type | notnull | comment | default | options -------------+------------+-----------+-------------+--------------------------+---------+---------+---------+--------------------------- public | user_tags | 1 | ds | timestamp with time zone | f | | | public | user_tags | 2 | tags | jsonb | f | | | {enable_columnar_type=on} (2 rows) -
Importe dados.
INSERT INTO user_tags (ds, tags) SELECT '2022-01-01 00:00:00+08' , ('{"id":' || i || ',"first_name" :"Sig", "gender" :"Male"}')::jsonb FROM generate_series(1, 10001) i; -
(Opcional) Force um flush de dados.
Após a gravação dos dados, o sistema realiza a otimização de JSONB colunar durante um flush de dados. Para ver o efeito imediatamente, execute o comando a seguir para forçar um flush de dados.
VACUUM user_tags; -
Execute uma consulta de exemplo.
Execute a instrução SQL a seguir para consultar o
first_nameondeidé10.SELECT (tags -> 'first_name')::text AS first_name FROM user_tags WHERE (tags -> 'id')::int = 10; -
Verifique o plano de execução para confirmar que a consulta usa a otimização colunar.
-- Show detailed statistics.
SET hg_experimental_show_execution_statistics_in_explain = ON;
-- View the execution plan.
EXPLAIN ANALYZE
SELECT
    (tags -> 'first_name')::text AS first_name
FROM
    user_tags
WHERE (tags -> 'id')::int = 10;
Se
columnar_access_usedaparecer no resultado, a otimização de JSONB colunar foi utilizada. -
Para a consulta na Etapa 6, você também pode definir um índice bitmap na coluna
tagspara melhorar a eficiência de consultas de igualdade para uma chave específica usando o comando a seguir:call set_table_property('user_tags', 'bitmap_columns', 'tags'); -
Verifique o plano de execução para confirmar que o índice bitmap está ativo.
-- View the execution plan.
EXPLAIN ANALYZE
SELECT
    (tags -> 'first_name')::text AS first_name
FROM
    user_tags
WHERE (tags -> 'id')::int = 10;
O resultado é o seguinte:
QUERY PLAN
Gather  (cost=0.00..6.42 rows=3334 width=8)
[2:1 id=100002 dop=1 time=7/7/7ms rows=1(1/1/1) mem=584/584/584B open=0/0/0ms get_next=7/7/7ms]
 -> Local Gather  (cost=0.00..6.30 rows=3334 width=8)
     [id=6 dop=2 time=6/4/3ms rows=1(1/0/0) mem=584/584/584B open=0/0/0ms get_next=6/4/3ms pull_dop=0/0/0]
     -> Decode  (cost=0.00..6.30 rows=3334 width=8)
         [id=4 dop=2 time=7/5/3ms rows=1(1/0/0) mem=0/0/0B open=7/5/3ms get_next=0/0/0ms]
         -> Project  (cost=0.00..6.20 rows=3334 width=8)
             [id=3 dop=2 time=7/5/3ms rows=1(1/0/0) mem=2/2/2KB open=7/5/3ms get_next=0/0/0ms]
             -> Seq Scan on user_tags  (cost=0.00..5.18 rows=3334 width=8)
                 Filter: (int4((tags -> 'id'::text)) = 10)
                 [id=2 dop=2 time=7/5/3ms rows=1(1/0/0) mem=260/160/60KB open=7/5/3ms get_next=0/0/0ms scan_rows=10001(8192/5000/1809) bitmap_used=1]
ADVICE:
[node id : 2]  Table user_tags misses bitmap index: ColRef_0012.
Se
bitmap_usedaparecer no resultado, o índice bitmap foi utilizado.
Quando evitar o JSONB colunar
O uso de JSONB colunar pode reduzir o armazenamento e melhorar significativamente a eficiência das consultas. No entanto, ele não é adequado para todos os cenários. Não recomendamos seu uso nas situações a seguir, pois pode ser contraproducente.
Retornar toda a coluna JSONB
O JSONB colunar do Hologres oferece boa otimização para a maioria dos casos de uso. Contudo, em cenários onde o resultado da consulta precisa incluir toda a coluna JSONB, o desempenho pode ser inferior comparado ao armazenamento de dados no formato JSONB original. Por exemplo, considere as seguintes instruções SQL:
-- DDL for creating the table
CREATE TABLE TBL(key int, json_data jsonb);
SELECT json_data FROM TBL WHERE key = 123;
SELECT * FROM TBL limit 10;
Essa degradação de desempenho ocorre porque a camada subjacente já converteu os dados JSONB em armazenamento orientado a colunas. Portanto, quando você precisa consultar os dados JSON completos, o sistema deve remontar os dados colunares de volta ao formato JSONB original:

Essa etapa gera uma sobrecarga significativa de I/O e conversão. Se o volume de dados for grande e o número de colunas for alto, esse processo pode se tornar um gargalo de desempenho. Por isso, recomenda-se não ativar a otimização orientada a colunas neste cenário.
Dados JSONB extremamente esparsos
Quando o Hologres encontra um campo esparso ao converter dados JSONB para um formato orientado a colunas, ele mescla esses campos em uma coluna especial chamada holo.remaining para evitar a explosão do número de colunas. Portanto, se os dados JSONB consistirem inteiramente em campos esparsos — por exemplo, em um caso extremo onde cada campo aparece apenas uma vez — a conversão colunar não será eficaz. Como todos os campos são esparsos, todos são mesclados na coluna holo.remaining, impedindo qualquer conversão colunar real. Nesse caso, não haverá melhoria no desempenho da consulta.
Dados JSONB com estruturas aninhadas complexas
Nos dados JSONB a seguir, o nó raiz é um array que contém dados JSONB não homogêneos. Atualmente, quando o Hologres converte dados JSONB para um formato orientado a colunas, ele rebaixa essas estruturas aninhadas complexas para uma única coluna. Portanto, ativar a otimização de JSONB colunar para esse tipo de dado JSONB não trará benefícios significativos de desempenho de consulta.
'[
  {"key1": "value1"},
  {"key2": 123},
  {"key3": 123.01}
]'
Melhores práticas
Diagnóstico de consulta lenta
Se você notar que o desempenho da consulta piorou após ativar o JSONB colunar, verifique primeiro se a consulta retorna toda a coluna JSONB. Se a instrução SQL for muito complexa, use o comando EXPLAIN ANALYZE para diagnóstico. Um exemplo de comando é mostrado a seguir:
CREATE TABLE TBL(key int, json_data json); -- DDL for creating the table
ALTER TABLE TBL ALTER COLUMN json_data SET (enable_columnar_type = on);
Explain Analyze SELECT json_data FROM TBL WHERE key = 123;
O resultado do EXPLAIN ANALYZE contém informações de dica. Se a dica contiver a mensagem a seguir, significa que a consulta retornou toda a coluna JSONB, o que causou a degradação do desempenho:
Column 'json_data' has enabled columnar jsonb, but the query scanned the entire Jsonb valueSintaxe SQL mais eficiente
-
Existem várias maneiras de converter dados de campo JSONB para o formato TEXT, mas o operador
->>apresenta melhor desempenho. Por exemplo, para obter o atributo name da coluna json_data:-- Better performance SELECT json_data->>'name' FROM tbl; -- Average performance SELECT (json_data->'name')::text FROM tbl; -
Se um campo JSON armazena um array de TEXT e você precisa verificar se o array contém um valor específico, recomenda-se usar a seguinte sintaxe:
SELECT key FROM tbl WHERE jsonb_to_textarray(json_data->'phones') && ARRAY['123456'];
FAQ
Por que o uso de armazenamento aumentou depois que ativei a otimização orientada a colunas?
Após ativar a otimização de JSONB colunar, os nomes dos campos dos dados JSONB originais deixam de ser armazenados. Apenas os valores específicos de cada campo são guardados. Depois da conversão para o formato orientado a colunas, todos os dados em cada coluna são do mesmo tipo, o que permite que o armazenamento orientado a colunas atinja uma alta taxa de compressão de dados. Em teoria, isso deveria reduzir significativamente o espaço de armazenamento de dados.
No entanto, se os campos nos dados JSONB forem esparsos e o número de colunas se expandir significativamente, cada nova coluna incorrerá em sobrecarga adicional de armazenamento para metadados, como estatísticas e índices. Além disso, se a maioria das colunas for inferida como tipo TEXT, a compressão será menos eficaz. Portanto, a eficiência real de compressão de armazenamento depende das características específicas dos seus dados, como a esparsidade, e a compressão ideal não é garantida para todos os conjuntos de dados.