Construa uma solução unificada de análise em lote e em tempo real usando dados de eventos do GitHub. O MaxCompute atua como data warehouse de lote, enquanto o Realtime Compute for Apache Flink e o Hologres formam o data warehouse em tempo real. Juntos, Hologres e MaxCompute fornecem uma camada unificada para análise de dados em tempo real e em lote.
Contexto
À medida que as empresas avançam na transformação digital, cresce a demanda por dados mais atualizados. Além do processamento em lote tradicional para grandes volumes de dados, muitas organizações agora precisam de processamento, armazenamento e análise de dados em tempo real. A análise unificada de dados em lote e em tempo real surge para atender a essa necessidade.
A análise unificada em lote e em tempo real gerencia e processa dados de ambas as naturezas em uma única plataforma, permitindo uma conexão contínua entre o processamento em tempo real e a análise em lote. Os principais benefícios incluem:
Maior eficiência no processamento de dados: a integração de dados em tempo real e em lote em uma única plataforma reduz os custos de transferência e conversão de dados.
Maior precisão nas análises: combinar dados em tempo real e em lote melhora a exatidão dos resultados obtidos.
Gestão de dados simplificada: uma abordagem unificada facilita o gerenciamento e o processamento dos dados.
Melhor suporte à tomada de decisão: aproveite ao máximo seus dados para embasar as decisões de negócio.
A Alibaba Cloud oferece uma solução simplificada e unificada de data warehouse para cenários de lote e tempo real. Essa solução usa o MaxCompute para processamento em lote e o Hologres para análise em tempo real. Combinados com as capacidades de processamento em tempo real do Realtime Compute for Apache Flink, esses serviços formam o mecanismo central do data warehouse unificado da Alibaba Cloud.
Arquitetura da solução
O diagrama a seguir ilustra o pipeline completo de análise unificada em lote e em tempo real sobre o dataset público de eventos do GitHub, usando MaxCompute e Hologres.
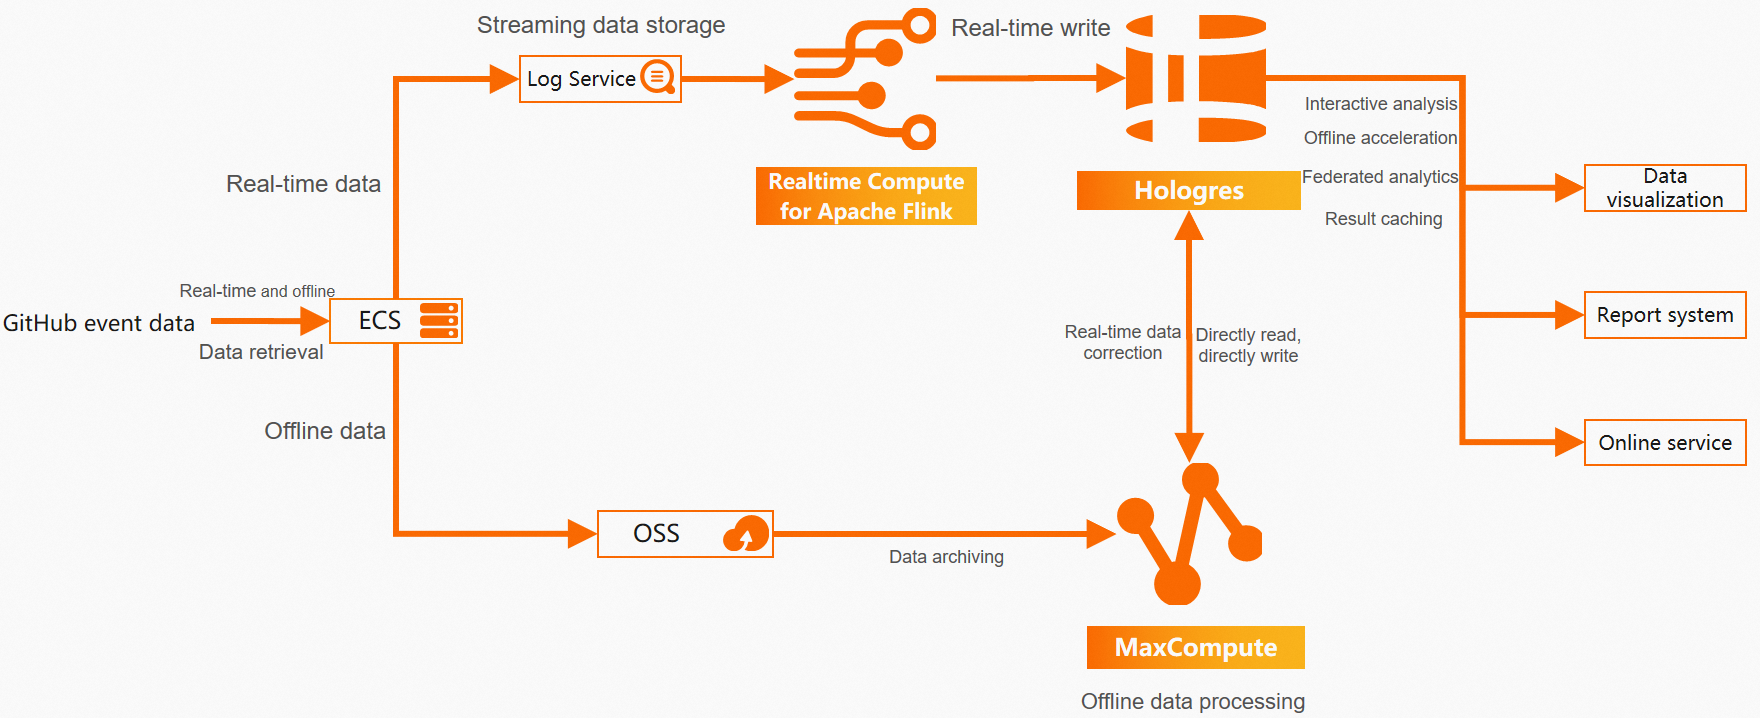
Nessa arquitetura, uma instância do ECS coleta e agrega dados de eventos em tempo real e em lote do GitHub como source de dados. Os dados alimentam um pipeline em tempo real e um pipeline em lote e se consolidam no Hologres como camada de service unificada.
Pipeline em tempo real: o Realtime Compute for Apache Flink processa dados do Simple Log Service (SLS) em tempo real e os grava no Hologres. O Hologres suporta gravações e atualizações em tempo real, com dados consultáveis imediatamente após a ingestão. A integração nativa entre os dois serviços viabiliza o desenvolvimento de data warehouses em tempo real com alto throughput, baixa latência e orientados a modelos — ideal para casos de uso como extração dos eventos mais recentes e análise de eventos em tendência.
Pipeline em lote: o MaxCompute processa e arquiva grandes volumes de dados em lote. O Object Storage Service (OSS) oferece armazenamento conveniente, seguro e de baixo custo para os dados json brutos. O MaxCompute lê e analisa diretamente dados semiestruturados no OSS por meio de tabelas externas, integra dados de alto valor ao seu armazenamento interno e trabalha em conjunto com o dataworks para construir um data warehouse de lote.
O Hologres é integrado nativamente ao MaxCompute na camada de armazenamento, permitindo acelerar consultas sobre grandes volumes de dados históricos no MaxCompute. Isso viabiliza consultas de alta performance e baixa frequência sobre dados históricos. O pipeline em lote também pode ser usado para corrigir dados em tempo real e resolver problemas como omissões de dados no pipeline em tempo real.
Esta solução oferece as seguintes vantagens:
Pipeline em lote estável e eficiente: suporta gravações e atualizações horárias, processamento em lote em grande escala, cálculos complexos e redução dos custos de computação.
Pipeline em tempo real maduro: suporta ingestão em tempo real, computação de eventos e análise, entregando respostas em segundos.
Armazenamento e service unificados: o Hologres fornece uma camada de service unificada com armazenamento centralizado de dados e uma interface externa consistente (uma única interface SQL tanto para consultas OLAP quanto para consultas Key-Value).
Análise unificada em lote e em tempo real: reduz a redundância e a movimentação de dados, além de permitir correções de dados.
Essa abordagem de desenvolvimento one-stop garante resposta de dados em nível de segundos, visibilidade do status de ponta a ponta, uma arquitetura simplificada com menos componentes e custos de O&M reduzidos.
Entendendo o negócio e os dados
Ao trabalhar em projetos open source no GitHub, os desenvolvedores geram uma grande variedade de eventos. O GitHub registra os detalhes de cada evento, incluindo o tipo de evento, o desenvolvedor e o repositório de código. O GitHub disponibiliza publicamente eventos como marcar um repositório com estrela ou realizar um commit. Para a lista completa de tipos de eventos, consulte Webhook events and payloads.
O GitHub disponibiliza eventos públicos por meio de uma OpenAPI. A API fornece dados em tempo real com um atraso de cinco minutos. Para mais informações, consulte Events.
O projeto GH Archive coleta e disponibiliza arquivos horários dos eventos públicos do GitHub. Use esses arquivos para obter dados offline. Para mais informações, consulte GH Archive.
Entendendo o negócio do GitHub
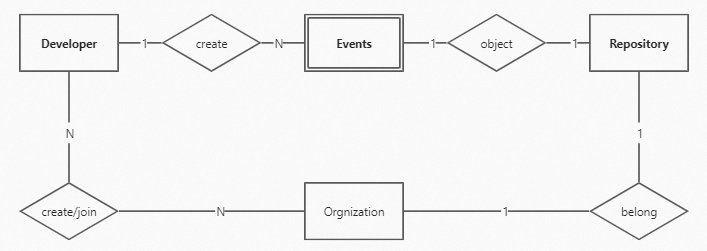
O negócio central do GitHub é o gerenciamento de código e interações. Ele envolve três entidades principais: Developer, Repository e Organization.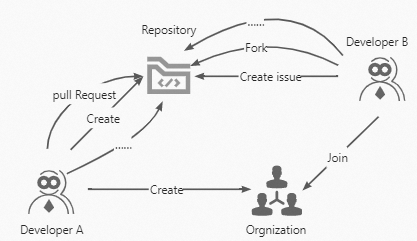
Para esta análise de dados, um Event também é armazenado e registrado como uma entidade.
Entendendo os dados brutos de eventos públicos
O exemplo a seguir mostra os dados json de um evento bruto:
{
    "id": "19541192931",
    "type": "WatchEvent",
    "actor":
    {
        "id": 23286640,
        "login": "herekeo",
        "display_login": "herekeo",
        "gravatar_id": "",
        "url": "https://api.github.com/users/herekeo",
        "avatar_url": "https://avatars.githubusercontent.com/u/23286640?"
    },
    "repo":
    {
        "id": 52760178,
        "name": "crazyguitar/pysheeet",
        "url": "https://api.github.com/repos/crazyguitar/pysheeet"
    },
    "payload":
    {
        "action": "started"
    },
    "public": true,
    "created_at": "2022-01-01T00:03:04Z"
}
Esta análise cobre 15 tipos de eventos públicos, excluindo eventos que nunca ocorreram ou que não são mais registrados. Para detalhes sobre esses tipos de eventos, consulte Github public event types.
Pré-requisitos
Crie uma instância do Elastic Compute Service (ECS) e associe um Elastic IP Address (EIP) a ela. A instância é usada para extrair dados de eventos em tempo real da API do GitHub. Para mais informações, consulte Creation guide e Elastic IP Address.
Ative o Object Storage Service (OSS) e instale a ferramenta ossutil na instância do ECS para armazenar os arquivos de dados json do GH Archive. Para mais informações, consulte Activate OSS e Install ossutil.
Ative o MaxCompute e crie um projeto. Para mais informações, consulte Create a MaxCompute project.
Ative o DataWorks e crie um workspace para criar tarefas de agendamento offline. Para mais informações, consulte Create a workspace.
Ative o Simple Log Service (SLS) e crie um projeto e um Logstore para coletar dados da instância do ECS como logs. Para mais informações, consulte Collect and analyze ECS text logs using LoongCollector.
Ative uma instância do Realtime Compute for Apache Flink para gravar dados de log do SLS no Hologres em tempo real. Para mais informações, consulte Activate Realtime Compute for Apache Flink.
Ative o Hologres. Para mais informações, consulte Purchase a Hologres instance.
Construindo o data warehouse offline (atualizações horárias)
Baixar arquivos de dados brutos usando uma instância do ECS e enviá-los ao OSS
Use uma instância do Elastic Compute Service (ECS) para baixar arquivos de dados json do GH Archive.
Baixe dados históricos com o comando
wget. Por exemplo, executewget https://data.gharchive.org/{2012..2022}-{01..12}-{01..31}-{0..23}.json.gzpara baixar os dados horários de 2012 a 2022.-
Para baixar novos dados gerados a cada hora, configure uma tarefa agendada horária conforme descrito a seguir.
NotaCertifique-se de que o ossutil está instalado na instância do ECS. Para mais informações, consulte Install ossutil. Baixe o pacote de instalação do ossutil e envie-o para a instância do ECS. Execute
yum install unzippara instalar o software unzip. Em seguida, descompacte o pacote do ossutil e mova o arquivo executável para o diretório/usr/bin/.Certifique-se de ter criado um bucket do Object Storage Service (OSS) na mesma região da instância do ECS. Você pode usar um nome de bucket personalizado. Este exemplo usa o nome de bucket
githubevents.Neste exemplo, os arquivos são baixados para o diretório
/opt/hourlydata/gh_datana instância do ECS. Você pode usar um diretório diferente.
-
Execute o comando a seguir para criar um arquivo chamado
download_code.shno diretório/opt/hourlydata.cd /opt/hourlydata vim download_code.sh -
Pressione
ipara entrar no modo de edição e adicione o script a seguir.d=$(TZ=UTC date --date='1 hour ago' '+%Y-%m-%d-%-H') h=$(TZ=UTC date --date='1 hour ago' '+%Y-%m-%d-%H') url=https://data.gharchive.org/${d}.json.gz echo ${url} # Download the data to the ./gh_data/ directory. You can use a different directory. wget ${url} -P ./gh_data/ # Change to the gh_data directory. cd gh_data # Decompress the downloaded data into a JSON file. gzip -d ${d}.json echo ${d}.json # Change to the root directory. cd /root # Use ossutil to upload the data to OSS. # Create the hr=${h} directory in the githubevents OSS bucket. ossutil mkdir oss://githubevents/hr=${h} # Upload the data from the /opt/hourlydata/gh_data directory to OSS. You can use a different directory. ossutil cp -r /opt/hourlydata/gh_data oss://githubevents/hr=${h} -u echo oss uploaded successfully! rm -rf /opt/hourlydata/gh_data/${d}.json echo ecs deleted! Pressione a tecla Esc, insira
:wqe pressione Enter para salvar e fechar o arquivo.-
Execute o comando a seguir para executar o script
download_code.shaos 10 minutos de cada hora.# 1. Run the following command and press I to enter edit mode. crontab -e # 2. Add the following command. Then, press Esc, enter :wq, and press Enter to exit. 10 * * * * cd /opt/hourlydata && sh download_code.sh > download.logApós a execução do script, o arquivo json da hora anterior é baixado aos 10 minutos de cada hora. O arquivo é então descompactado na instância do ECS e enviado ao oss no caminho
oss://githubevents. Para ler apenas o arquivo da hora anterior, um diretório chamado'hr=%Y-%M-%D-%H'é criado como partição para cada arquivo durante o envio. Isso garante que as operações subsequentes de gravação de dados leiam somente os arquivos da partição mais recente.
Importar dados do OSS para o MaxCompute usando uma tabela externa
Execute os comandos a seguir no cliente MaxCompute ou em um nó ODPS SQL no dataworks. Para mais informações, consulte Connect to MaxCompute by using the client (odpscmd) ou Develop an ODPS SQL task.
-
Crie a tabela externa
githubeventspara ler os arquivos json armazenados no oss:CREATE EXTERNAL TABLE IF NOT EXISTS githubevents ( col STRING ) PARTITIONED BY ( hr STRING ) STORED AS textfile LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/githubevents/' ;Para mais informações sobre como criar tabelas externas para acessar dados do OSS no MaxCompute, consulte Access unstructured data in OSS.
-
Crie a tabela fato
dwd_github_events_odpspara armazenar os dados. A seguir está a instrução DDL (Data Definition Language):CREATE TABLE IF NOT EXISTS dwd_github_events_odps ( id BIGINT COMMENT 'Event ID' ,actor_id BIGINT COMMENT 'ID of the event initiator' ,actor_login STRING COMMENT 'Logon name of the event initiator' ,repo_id BIGINT COMMENT 'Repository ID' ,repo_name STRING COMMENT 'Full name of the repository in the format of owner/repository_name' ,org_id BIGINT COMMENT 'ID of the organization to which the repository belongs' ,org_login STRING COMMENT 'Name of the organization to which the repository belongs' ,`type` STRING COMMENT 'Event type' ,created_at DATETIME COMMENT 'Time when the event occurred' ,action STRING COMMENT 'Event action' ,iss_or_pr_id BIGINT COMMENT 'ID of the issue or pull request' ,number BIGINT COMMENT 'Number of the issue or pull request' ,comment_id BIGINT COMMENT 'Comment ID' ,commit_id STRING COMMENT 'Commit ID' ,member_id BIGINT COMMENT 'Member ID' ,rev_or_push_or_rel_id BIGINT COMMENT 'ID of the review, push, or release' ,ref STRING COMMENT 'Name of the created or deleted resource' ,ref_type STRING COMMENT 'Type of the created or deleted resource' ,state STRING COMMENT 'Status of the issue, pull request, or pull request review' ,author_association STRING COMMENT 'Relationship between the actor and the repository' ,language STRING COMMENT 'Language of the code in the pull request' ,merged BOOLEAN COMMENT 'Indicates whether the pull request was merged' ,merged_at DATETIME COMMENT 'Time when the code was merged' ,additions BIGINT COMMENT 'Number of added lines of code' ,deletions BIGINT COMMENT 'Number of deleted lines of code' ,changed_files BIGINT COMMENT 'Number of files changed in the pull request' ,push_size BIGINT COMMENT 'Number of commits' ,push_distinct_size BIGINT COMMENT 'Number of distinct commits' ,hr STRING COMMENT 'Hour when the event occurred. For example, if the event occurred at 00:23, the value of hr is 00.' ,`month` STRING COMMENT 'Month when the event occurred. For example, if the event occurred in October 2015, the value of month is 2015-10.' ,`year` STRING COMMENT 'Year when the event occurred. For example, if the event occurred in 2015, the value of year is 2015.' ) PARTITIONED BY ( ds STRING COMMENT 'Date when the event occurred, in the yyyy-mm-dd format.' ); -
Analise os dados json e grave-os na tabela fato.
Execute o comando a seguir para adicionar partições, analisar os dados json e gravá-los na tabela
dwd_github_events_odps:msck repair table githubevents add partitions; set odps.sql.hive.compatible = true; set odps.sql.split.hive.bridge = true; INSERT into TABLE dwd_github_events_odps PARTITION(ds) SELECT CAST(GET_JSON_OBJECT(col,'$.id') AS BIGINT ) AS id ,CAST(GET_JSON_OBJECT(col,'$.actor.id')AS BIGINT) AS actor_id ,GET_JSON_OBJECT(col,'$.actor.login') AS actor_login ,CAST(GET_JSON_OBJECT(col,'$.repo.id')AS BIGINT) AS repo_id ,GET_JSON_OBJECT(col,'$.repo.name') AS repo_name ,CAST(GET_JSON_OBJECT(col,'$.org.id')AS BIGINT) AS org_id ,GET_JSON_OBJECT(col,'$.org.login') AS org_login ,GET_JSON_OBJECT(col,'$.type') as type ,to_date(GET_JSON_OBJECT(col,'$.created_at'), 'yyyy-mm-ddThh:mi:ssZ') AS created_at ,GET_JSON_OBJECT(col,'$.payload.action') AS action ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.issue.id')AS BIGINT) END AS iss_or_pr_id ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.number')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.issue.number')AS BIGINT) ELSE CAST(GET_JSON_OBJECT(col,'$.payload.number')AS BIGINT) END AS number ,CAST(GET_JSON_OBJECT(col,'$.payload.comment.id')AS BIGINT) AS comment_id ,GET_JSON_OBJECT(col,'$.payload.comment.commit_id') AS commit_id ,CAST(GET_JSON_OBJECT(col,'$.payload.member.id')AS BIGINT) AS member_id ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.review.id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="PushEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.push_id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="ReleaseEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.release.id')AS BIGINT) END AS rev_or_push_or_rel_id ,GET_JSON_OBJECT(col,'$.payload.ref') AS ref ,GET_JSON_OBJECT(col,'$.payload.ref_type') AS ref_type ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN GET_JSON_OBJECT(col,'$.payload.pull_request.state') WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN GET_JSON_OBJECT(col,'$.payload.issue.state') WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN GET_JSON_OBJECT(col,'$.payload.review.state') END AS state ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN GET_JSON_OBJECT(col,'$.payload.pull_request.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN GET_JSON_OBJECT(col,'$.payload.issue.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="IssueCommentEvent" THEN GET_JSON_OBJECT(col,'$.payload.comment.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN GET_JSON_OBJECT(col,'$.payload.review.author_association') END AS author_association ,GET_JSON_OBJECT(col,'$.payload.pull_request.base.repo.language') AS language ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.merged') AS BOOLEAN) AS merged ,to_date(GET_JSON_OBJECT(col,'$.payload.pull_request.merged_at'), 'yyyy-mm-ddThh:mi:ssZ') AS merged_at ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.additions')AS BIGINT) AS additions ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.deletions')AS BIGINT) AS deletions ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.changed_files')AS BIGINT) AS changed_files ,CAST(GET_JSON_OBJECT(col,'$.payload.size')AS BIGINT) AS push_size ,CAST(GET_JSON_OBJECT(col,'$.payload.distinct_size')AS BIGINT) AS push_distinct_size ,SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),12,2) as hr ,REPLACE(SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,7),'/','-') as month ,SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,4) as year ,REPLACE(SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,10),'/','-') as ds from githubevents where hr = cast(to_char(dateadd(getdate(),-9,'hh'), 'yyyy-mm-dd-hh') as string); -
Consulte os dados.
Execute o comando a seguir para consultar dados da tabela
dwd_github_events_odps:SET odps.sql.allow.fullscan=true; SELECT * FROM dwd_github_events_odps where ds = '2023-03-31' limit 10;O resultado de exemplo retornado é o seguinte:
O resultado contém os seguintes campos:
id: ID do eventoactor_id/actor_login: ID e nome do usuáriorepo_id/repo_name: ID e nome do repositórioorg_id/org_login: ID e nome da organização (vazio para alguns eventos)type: tipo do evento, como CreateEvent, PushEvent, DeleteEvent, PullRequestReviewEventcreated_at: horário de criaçãoaction: tipo de ação
Construindo o data warehouse em tempo real
Obter dados em tempo real usando o ECS
Uma instância do Elastic Compute Service (ECS) extrai dados de eventos em tempo real da API do GitHub. O script de exemplo a seguir mostra como coletar dados em tempo real da API do GitHub.
A cada execução, o script roda por 1 minuto. Durante esse período, ele coleta os dados de eventos em tempo real fornecidos pela API e armazena cada evento no formato json.
Este script não garante a coleta de todos os dados de eventos em tempo real.
Para coletar dados continuamente da API do GitHub, forneça os cabeçalhos Accept e Authorization. O valor de Accept é fixo. Para Authorization, insira o token de acesso pessoal obtido do GitHub. Para mais informações sobre como criar um token de acesso pessoal, consulte esta documentação.
-
Execute os comandos a seguir para criar um arquivo chamado
download_realtime_data.pyno diretório/opt/realtime.cd /opt/realtime vim download_realtime_data.py -
Pressione
ipara entrar no modo de edição e adicione o conteúdo de exemplo a seguir ao arquivo.#!python import requests import json import sys import time # Get the API URL def get_next_link(resp): resp_link = resp.headers['link'] link = '' for l in resp_link.split(', '): link = l.split('; ')[0][1:-1] rel = l.split('; ')[1] if rel == 'rel="next"': return link return None # Collect one page of data from the API def download(link, fname): # Define the Accept and Authorization headers for the GitHub API headers = {"Accept": "application/vnd.github+json","Authorization": "<Bearer> <github_api_token>"} resp = requests.get(link, headers=headers) if int(resp.status_code) != 200: return None with open(fname, 'a') as f: for j in resp.json(): f.write(json.dumps(j)) f.write('\n') print('downloaded {} events to {}'.format(len(resp.json()), fname)) return resp # Collect multiple pages of data from the API def download_all_data(fname): link = 'https://api.github.com/events?per_page=100&page=1' while True: resp = download(link, fname) if resp is None: break link = get_next_link(resp) if link is None: break # Define the current time def get_current_ms(): return round(time.time()*1000) # Define the script execution duration as 1 minute def main(fname): current_ms = get_current_ms() while get_current_ms() - current_ms < 60*1000: download_all_data(fname) time.sleep(0.1) # Run the script if __name__ == '__main__': if len(sys.argv) < 2: print('usage: python {} <log_file>'.format(sys.argv[0])) exit(0) main(sys.argv[1]) -
Pressione a tecla Esc, insira
:wqe pressione Enter para salvar e fechar o arquivo. -
Crie um arquivo
run_py.shpara executardownload_realtime_data.pye armazenar separadamente os dados coletados em cada execução. O conteúdo é o seguinte.python /opt/realtime/download_realtime_data.py /opt/realtime/gh_realtime_data/$(date '+%Y-%m-%d-%H:%M:%S').json -
Crie um arquivo
delete_log.shpara excluir dados históricos. O conteúdo é o seguinte.d=$(TZ=UTC date --date='2 day ago' '+%Y-%m-%d') rm -f /opt/realtime/gh_realtime_data/*${d}*.json -
Execute os comandos a seguir para coletar dados do GitHub a cada minuto e excluir dados históricos diariamente.
#1. Run the following command and press I to enter edit mode.
crontab -e

#2. Add the following commands. Then, press Esc, enter :wq, and press Enter to exit.
* * * * * bash /opt/realtime/run_py.sh
1 1 * * * bash /opt/realtime/delete_log.sh
Coletar dados do ECS usando o SLS
O Simple Log Service (SLS) coleta os dados de eventos em tempo real da instância do ECS como logs.
O SLS suporta a coleta de logs de instâncias do ECS por meio do Logtail. Como os dados estão no formato json, use o modo json do Logtail para coletar rapidamente os logs json incrementais da instância do ECS. Para mais informações, consulte Collect logs in JSON mode. Neste tópico, o SLS é configurado para analisar os pares chave-valor de nível superior dos dados brutos.
Neste exemplo, o parâmetro de caminho de log da configuração do Logtail é definido como /opt/realtime/gh_realtime_data/**/*.json.
Após a configuração, o SLS coleta continuamente dados de eventos incrementais da instância do ECS. Você pode visualize os dados de log coletados na aba Raw Logs do console do SLS. Cada entrada de log contém campos de nível superior analisados, como actor, created_at, id, org, payload, public, repo e type.
Gravar dados do SLS no Hologres em tempo real usando o Flink
O Flink grava os dados de log coletados pelo SLS no Hologres em tempo real. Com uma tabela source do SLS e uma tabela result do Hologres no Flink, os dados são transmitidos do SLS para o Hologres. Para mais informações, consulte Import data from Simple Log Service.
-
Crie uma tabela interna no Hologres.
A tabela interna retém apenas alguns pares chave-valor dos dados json brutos. O
iddo evento e a datadssão definidos como chave primária. Oiddo evento é definido como chave de distribuição. A datadsé definida como chave de partição. O horário do eventocreated_até definido como event_time_column. Você pode criar índices para outros campos conforme necessário. Para mais informações sobre índices, consulte CREATE TABLE. A instrução DDL a seguir é usada para criar a tabela neste exemplo.DROP TABLE IF EXISTS gh_realtime_data; BEGIN; CREATE TABLE gh_realtime_data ( id bigint, actor_id bigint, actor_login text, repo_id bigint, repo_name text, org_id bigint, org_login text, type text, created_at timestamp with time zone NOT NULL, action text, iss_or_pr_id bigint, number bigint, comment_id bigint, commit_id text, member_id bigint, rev_or_push_or_rel_id bigint, ref text, ref_type text, state text, author_association text, language text, merged boolean, merged_at timestamp with time zone, additions bigint, deletions bigint, changed_files bigint, push_size bigint, push_distinct_size bigint, hr text, month text, year text, ds text, PRIMARY KEY (id,ds) ) PARTITION BY LIST (ds); CALL set_table_property('public.gh_realtime_data', 'distribution_key', 'id'); CALL set_table_property('public.gh_realtime_data', 'event_time_column', 'created_at'); CALL set_table_property('public.gh_realtime_data', 'clustering_key', 'created_at'); COMMENT ON COLUMN public.gh_realtime_data.id IS 'Event ID'; COMMENT ON COLUMN public.gh_realtime_data.actor_id IS 'ID of the event initiator'; COMMENT ON COLUMN public.gh_realtime_data.actor_login IS 'Logon name of the event initiator'; COMMENT ON COLUMN public.gh_realtime_data.repo_id IS 'repo ID'; COMMENT ON COLUMN public.gh_realtime_data.repo_name IS 'repo name'; COMMENT ON COLUMN public.gh_realtime_data.org_id IS 'ID of the organization to which the repo belongs'; COMMENT ON COLUMN public.gh_realtime_data.org_login IS 'Name of the organization to which the repo belongs'; COMMENT ON COLUMN public.gh_realtime_data.type IS 'Event type'; COMMENT ON COLUMN public.gh_realtime_data.created_at IS 'Time when the event occurred'; COMMENT ON COLUMN public.gh_realtime_data.action IS 'Event action'; COMMENT ON COLUMN public.gh_realtime_data.iss_or_pr_id IS 'issue/pull_request ID'; COMMENT ON COLUMN public.gh_realtime_data.number IS 'issue/pull_request number'; COMMENT ON COLUMN public.gh_realtime_data.comment_id IS 'comment ID'; COMMENT ON COLUMN public.gh_realtime_data.commit_id IS 'Commit ID'; COMMENT ON COLUMN public.gh_realtime_data.member_id IS 'Member ID'; COMMENT ON COLUMN public.gh_realtime_data.rev_or_push_or_rel_id IS 'review/push/release ID'; COMMENT ON COLUMN public.gh_realtime_data.ref IS 'Name of the created or deleted resource'; COMMENT ON COLUMN public.gh_realtime_data.ref_type IS 'Type of the created or deleted resource'; COMMENT ON COLUMN public.gh_realtime_data.state IS 'Status of the issue/pull_request/pull_request_review'; COMMENT ON COLUMN public.gh_realtime_data.author_association IS 'Relationship between the actor and the repo'; COMMENT ON COLUMN public.gh_realtime_data.language IS 'Programming language'; COMMENT ON COLUMN public.gh_realtime_data.merged IS 'Specifies whether the merge is accepted'; COMMENT ON COLUMN public.gh_realtime_data.merged_at IS 'Time when the code was merged'; COMMENT ON COLUMN public.gh_realtime_data.additions IS 'Number of added lines of code'; COMMENT ON COLUMN public.gh_realtime_data.deletions IS 'Number of deleted lines of code'; COMMENT ON COLUMN public.gh_realtime_data.changed_files IS 'Number of files changed in the pull request'; COMMENT ON COLUMN public.gh_realtime_data.push_size IS 'Number of pushes'; COMMENT ON COLUMN public.gh_realtime_data.push_distinct_size IS 'Number of distinct pushes'; COMMENT ON COLUMN public.gh_realtime_data.hr IS 'The hour when the event occurred. For example, if the time is 00:23, hr=00.'; COMMENT ON COLUMN public.gh_realtime_data.month IS 'The month when the event occurred. For example, if the date is October 2015, month=2015-10.'; COMMENT ON COLUMN public.gh_realtime_data.year IS 'The year when the event occurred. For example, if the year is 2015, year=2015.'; COMMENT ON COLUMN public.gh_realtime_data.ds IS 'The day when the event occurred. ds=yyyy-mm-dd.'; COMMIT; -
Grave dados em tempo real usando o Flink.
Use o Flink para analisar os dados do SLS e gravá-los no Hologres em tempo real. As instruções Flink a seguir filtram os dados: dados incorretos em que o ID do evento ou o horário do evento (
created_at) é nulo são descartados, e apenas os dados de eventos recentes são retidos.CREATE TEMPORARY TABLE sls_input ( actor varchar, created_at varchar, id bigint, org varchar, payload varchar, public varchar, repo varchar, type varchar ) WITH ( 'connector' = 'sls', 'endpoint' = '<endpoint>',--The private endpoint of SLS 'accessid' = '<accesskey id>',--The AccessKey ID of your account 'accesskey' = '<accesskey secret>',--The AccessKey secret of your account 'project' = '<project name>',--The name of the SLS project 'logstore' = '<logstore name>'--The name of the SLS Logstore 'starttime' = '2023-04-06 00:00:00',--The start time for SLS data collection ); CREATE TEMPORARY TABLE hologres_sink ( id bigint, actor_id bigint, actor_login string, repo_id bigint, repo_name string, org_id bigint, org_login string, type string, created_at timestamp, action string, iss_or_pr_id bigint, number bigint, comment_id bigint, commit_id string, member_id bigint, rev_or_push_or_rel_id bigint, `ref` string, ref_type string, state string, author_association string, `language` string, merged boolean, merged_at timestamp, additions bigint, deletions bigint, changed_files bigint, push_size bigint, push_distinct_size bigint, hr string, `month` string, `year` string, ds string ) WITH ( 'connector' = 'hologres', 'dbname' = '<hologres dbname>', --The name of the Hologres database 'tablename' = '<hologres tablename>', --The name of the Hologres table that receives data 'username' = '<accesskey id>', --The AccessKey ID of the current Alibaba Cloud account 'password' = '<accesskey secret>', --The AccessKey Secret of the current Alibaba Cloud account 'endpoint' = '<endpoint>', --The VPC endpoint of the current Hologres instance 'jdbcretrycount' = '1', --The number of retries upon connection failure 'partitionrouter' = 'true', --Specifies whether to write data to a partitioned table 'createparttable' = 'true', --Specifies whether to automatically create partitions 'mutatetype' = 'insertorignore' --The data writing mode ); INSERT INTO hologres_sink SELECT id ,CAST(JSON_VALUE(actor, '$.id') AS bigint) AS actor_id ,JSON_VALUE(actor, '$.login') AS actor_login ,CAST(JSON_VALUE(repo, '$.id') AS bigint) AS repo_id ,JSON_VALUE(repo, '$.name') AS repo_name ,CAST(JSON_VALUE(org, '$.id') AS bigint) AS org_id ,JSON_VALUE(org, '$.login') AS org_login ,type ,TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC') AS created_at ,JSON_VALUE(payload, '$.action') AS action ,CASE WHEN type='PullRequestEvent' THEN CAST(JSON_VALUE(payload, '$.pull_request.id') AS bigint) WHEN type='IssuesEvent' THEN CAST(JSON_VALUE(payload, '$.issue.id') AS bigint) END AS iss_or_pr_id ,CASE WHEN type='PullRequestEvent' THEN CAST(JSON_VALUE(payload, '$.pull_request.number') AS bigint) WHEN type='IssuesEvent' THEN CAST(JSON_VALUE(payload, '$.issue.number') AS bigint) ELSE CAST(JSON_VALUE(payload, '$.number') AS bigint) END AS number ,CAST(JSON_VALUE(payload, '$.comment.id') AS bigint) AS comment_id ,JSON_VALUE(payload, '$.comment.commit_id') AS commit_id ,CAST(JSON_VALUE(payload, '$.member.id') AS bigint) AS member_id ,CASE WHEN type='PullRequestReviewEvent' THEN CAST(JSON_VALUE(payload, '$.review.id') AS bigint) WHEN type='PushEvent' THEN CAST(JSON_VALUE(payload, '$.push_id') AS bigint) WHEN type='ReleaseEvent' THEN CAST(JSON_VALUE(payload, '$.release.id') AS bigint) END AS rev_or_push_or_rel_id ,JSON_VALUE(payload, '$.ref') AS `ref` ,JSON_VALUE(payload, '$.ref_type') AS ref_type ,CASE WHEN type='PullRequestEvent' THEN JSON_VALUE(payload, '$.pull_request.state') WHEN type='IssuesEvent' THEN JSON_VALUE(payload, '$.issue.state') WHEN type='PullRequestReviewEvent' THEN JSON_VALUE(payload, '$.review.state') END AS state ,CASE WHEN type='PullRequestEvent' THEN JSON_VALUE(payload, '$.pull_request.author_association') WHEN type='IssuesEvent' THEN JSON_VALUE(payload, '$.issue.author_association') WHEN type='IssueCommentEvent' THEN JSON_VALUE(payload, '$.comment.author_association') WHEN type='PullRequestReviewEvent' THEN JSON_VALUE(payload, '$.review.author_association') END AS author_association ,JSON_VALUE(payload, '$.pull_request.base.repo.language') AS `language` ,CAST(JSON_VALUE(payload, '$.pull_request.merged') AS boolean) AS merged ,TO_TIMESTAMP_TZ(replace(JSON_VALUE(payload, '$.pull_request.merged_at'),'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC') AS merged_at ,CAST(JSON_VALUE(payload, '$.pull_request.additions') AS bigint) AS additions ,CAST(JSON_VALUE(payload, '$.pull_request.deletions') AS bigint) AS deletions ,CAST(JSON_VALUE(payload, '$.pull_request.changed_files') AS bigint) AS changed_files ,CAST(JSON_VALUE(payload, '$.size') AS bigint) AS push_size ,CAST(JSON_VALUE(payload, '$.distinct_size') AS bigint) AS push_distinct_size ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),12,2) as hr ,REPLACE(SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,7),'/','-') as `month` ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,4) as `year` ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,10) as ds FROM sls_input WHERE id IS NOT NULL AND created_at IS NOT NULL AND to_date(replace(created_at,'T',' ')) >= date_add(CURRENT_DATE, -1);Para mais informações sobre os parâmetros, consulte Simple Log Service (SLS) e Hologres.
NotaOs dados brutos de eventos do GitHub usam o fuso horário UTC e não possuem atributo de fuso horário. O fuso horário padrão do Hologres é UTC+8. Portanto, ajuste o fuso horário ao gravar dados do Flink para o Hologres em tempo real. Atribua o fuso horário UTC aos dados da tabela source no Flink SQL. Os passos são os seguintes:
Passo 1: Acesse a página de edição do job
Faça login no console do Realtime Compute for Apache Flink
Acesse o workspace de destino
Localize seu job Flink SQL ou JAR e clique em Edit
Passo 2: Abra a aba Deployment Details
⚠️ Mudança importante: "Flink Configuration" não é mais uma seção separada. Ela foi incorporada a "Deployment Details".
No topo da página de edição do job, alterne para a aba Deployment Details.
Role a página até a seção Parameter Configuration.
Passo 3: Adicione uma configuração personalizada
Clique no botão Edit à direita de Parameter Configuration.
Na caixa de diálogo exibida, localize o campo de texto Other Configuration.
No campo de texto, adicione o parâmetro Flink
table.local-time-zone:Asia/Shanghaicomo um par chave-valor para defina o fuso horário do sistema Flink comoAsia/Shanghai.
-
Consulte os dados.
Consulte os dados do SLS gravados no Hologres pelo Flink e realize o desenvolvimento de dados conforme necessário.
SELECT * FROM public.gh_realtime_data limit 10;O resultado da consulta retorna os seguintes campos:
idactor_idactor_loginrepo_idrepo_nameorg_idorg_logintype(tipo de evento, como PullRequestReviewEvent, CreateEvent, PushEvent, PullRequestEvent)created_atactioniss_or_pr_id
Corrigir dados em tempo real usando dados offline
Neste cenário, pode haver lacunas nos dados em tempo real. Use os dados offline para corrigi-los. Os passos a seguir mostram como corrigir os dados em tempo real do dia anterior. Ajuste o período de correção conforme necessário.
-
Crie uma tabela estrangeira no Hologres para obter os dados offline do MaxCompute.
IMPORT FOREIGN SCHEMA <maxcompute_project_name> LIMIT to
(
    <foreign_table_name>
)
FROM SERVER odps_server INTO public OPTIONS(if_table_exist 'update',if_unsupported_type 'error');
Para mais informações sobre os parâmetros, consulte IMPORT FOREIGN SCHEMA.
-
Crie uma tabela temporária para corrigir os dados em tempo real do dia anterior com os dados offline.
NotaO Hologres V2.1.17 e versões posteriores suportam Serverless Computing. Para cenários como importação de dados offline em grande escala, grandes jobs de ETL e consultas de alto volume em tabelas estrangeiras, use o Serverless Computing para executar essas tarefas. Esse recurso utiliza recursos serverless adicionais em vez dos recursos da sua instância, o que melhora a estabilidade da instância e reduz a probabilidade de erros de out-of-memory (OOM). Não é necessário reservar recursos de computação extras para sua instância, e você paga apenas pelas tarefas executadas. Para mais informações sobre Serverless Computing, consulte Serverless Computing. Para instruções sobre como usar o Serverless Computing, consulte Use Serverless Computing.
-- Clean up potential temporary tables
DROP TABLE IF EXISTS gh_realtime_data_tmp;

-- Create a temporary table
SET hg_experimental_enable_create_table_like_properties = ON;
CALL HG_CREATE_TABLE_LIKE ('gh_realtime_data_tmp', 'select * from gh_realtime_data');

-- (Optional) Use Serverless Computing to perform large-scale offline data import and ETL jobs.
SET hg_computing_resource = 'serverless';

-- Insert data into the temporary table and update statistics
INSERT INTO gh_realtime_data_tmp
SELECT
    *
FROM
    <foreign_table_name>
WHERE
    ds = current_date - interval '1 day'
ON CONFLICT (id, ds)
    DO NOTHING;
ANALYZE gh_realtime_data_tmp;

-- Reset the configuration to ensure that non-essential SQL statements do not use Serverless resources.
RESET hg_computing_resource;

-- Replace the atomic table with the existing temporary child table
BEGIN;
DROP TABLE IF EXISTS "gh_realtime_data_<yesterday_date>";
ALTER TABLE gh_realtime_data_tmp RENAME TO "gh_realtime_data_<yesterday_date>";
ALTER TABLE gh_realtime_data ATTACH PARTITION "gh_realtime_data_<yesterday_date>" FOR VALUES IN ('<yesterday_date>');
COMMIT;
Análise de dados
É possível realizar uma ampla variedade de análises sobre os dados coletados. Com base no intervalo de tempo exigido pelo seu negócio, projete o data warehouse em camadas para suportar análise em tempo real, análise offline e análise integrada em tempo real e offline.
Os exemplos a seguir analisam dados em tempo real. Você também pode analisar dados de repositórios de código ou desenvolvedores específicos.
-
Consulte o total de eventos públicos do dia de hoje.
SELECT
    count(*)
FROM
    gh_realtime_data
WHERE
    created_at >= date_trunc('day', now());
O resultado de exemplo é o seguinte:
count ------ 1006 -
Consulte os projetos mais ativos (com mais eventos) no último dia.
SELECT
    repo_name,
    COUNT(*) AS events
FROM
    gh_realtime_data
WHERE
    created_at >= now() - interval '1 day'
GROUP BY
    repo_name
ORDER BY
    events DESC
LIMIT 5;
O resultado de exemplo é o seguinte:
repo_name events ----------------------------------------+------ leo424y/heysiri.ml 29 arm-on/plan 10 Christoffel-T/fiverr-pat-20230331 9 mate-academy/react_dynamic-list-of-goods 9 openvinotoolkit/openvino 7 -
Consulte os desenvolvedores mais ativos (com mais eventos) no último dia.
SELECT
    actor_login,
    COUNT(*) AS events
FROM
    gh_realtime_data
WHERE
    created_at >= now() - interval '1 day'
    AND actor_login NOT LIKE '%[bot]'
GROUP BY
    actor_login
ORDER BY
    events DESC
LIMIT 5;
O resultado de exemplo é o seguinte:
actor_login events ------------------+------ direwolf-github 13 arm-on 10 sergii-nosachenko 9 Christoffel-T 9 yangwang201911 7 -
Consulte o ranking das linguagens de programação mais populares na última hora.
SELECT
    language,
    count(*) total
FROM
    gh_realtime_data
WHERE
    created_at > now() - interval '1 hour'
    AND language IS NOT NULL
GROUP BY
    language
ORDER BY
    total DESC
LIMIT 10;
O resultado de exemplo é o seguinte:
language total -----------+---- JavaScript 25 C++ 15 Python 14 TypeScript 13 Java 8 PHP 8 -
Consulte o ranking dos projetos pelo número de estrelas recebidas no último dia.
NotaEste exemplo não considera os casos em que usuários removem a estrela de um projeto.
SELECT
    repo_id,
    repo_name,
    COUNT(actor_login) total
FROM
    gh_realtime_data
WHERE
    type = 'WatchEvent'
    AND created_at > now() - interval '1 day'
GROUP BY
    repo_id,
    repo_name
ORDER BY
    total DESC
LIMIT 10;
O resultado de exemplo é o seguinte:
repo_id repo_name total ---------+----------------------------------+----- 618058471 facebookresearch/segment-anything 4 619959033 nomic-ai/gpt4all 1 97249406 denysdovhan/wtfjs 1 9791525 digininja/DVWA 1 168118422 aylei/interview 1 343520006 joehillen/sysz 1 162279822 agalwood/Motrix 1 577723410 huggingface/swift-coreml-diffusers 1 609539715 e2b-dev/e2b 1 254839429 maniackk/KKCallStack 1 -
Consulte os usuários ativos diários e os projetos do dia de hoje.
SELECT
    uniq (actor_id) actor_num,
    uniq (repo_id) repo_num
FROM
    gh_realtime_data
WHERE
    created_at > date_trunc('day', now());
O resultado de exemplo é o seguinte:
actor_num	repo_num
---------+--------
743	      816