O Hologres utiliza uma arquitetura de Desagregação de Armazenamento. Esta página descreve o design da arquitetura e a função de cada componente.
Modelos de arquitetura de armazenamento e computação
Sistemas distribuídos geralmente adotam três modelos de arquitetura para armazenamento e computação.
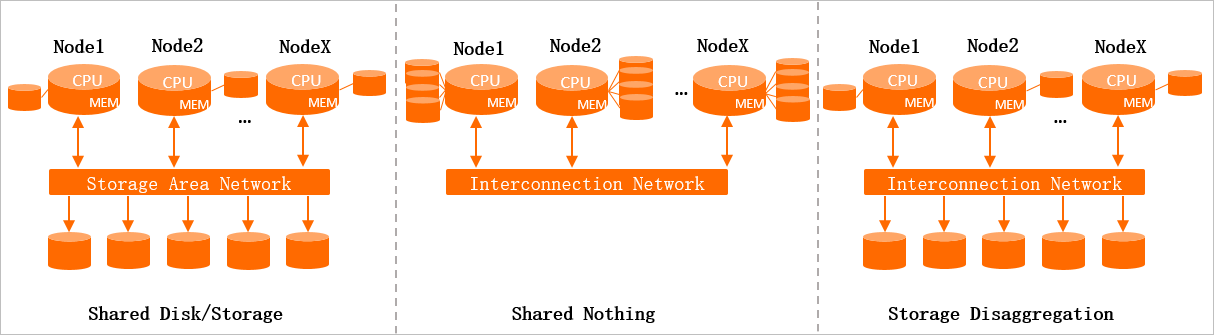
Disco Compartilhado / Armazenamento Compartilhado
Todos os nós de trabalho compartilham um cluster de armazenamento distribuído. Cada nó acessa os dados como se fossem locais. O cluster de armazenamento escala facilmente, mas os nós de trabalho exigem coordenação distribuída para manter a consistência, o que limita o número máximo de nós suportados.
Shared Nothing
Cada nó de trabalho monta seu próprio armazenamento local e processa dados de um único shard. Os nós se comunicam entre si, e um nó de resumo dedicado agrega os resultados. Essa arquitetura permite escalabilidade horizontal, mas apresenta contrapartidas: após um failover, o nó em recuperação precisa recarregar os dados antes de atender às solicitações. Além disso, qualquer expansão exige rebalanceamento de dados entre os nós — um processo demorado.
Desagregação de Armazenamento
Um cluster de armazenamento distribuído é compartilhado, mas cada nó de computação processa dados de um shard dedicado — semelhante ao modelo Shared Nothing — e mantém um cache local. Essa arquitetura oferece:
Consistência de dados simplificada: Apenas um nó de trabalho grava em um shard por vez, eliminando a necessidade de coordenação complexa.
Escalabilidade flexível: Recursos de computação e armazenamento escalam independentemente. Em picos de tráfego, escale apenas a camada de computação sem acionar o rebalanceamento de dados.
Recuperação rápida de failover: Após uma falha, um novo nó busca dados do armazenamento distribuído de forma assíncrona e retoma o serviço rapidamente.
O Hologres adota a arquitetura de Desagregação de Armazenamento, combinando a simplicidade de gerenciamento do armazenamento compartilhado com o desempenho e a escalabilidade da computação baseada em shards. O armazenamento subjacente é o Pangu, sistema de arquivos distribuído da Alibaba, que desempenha um papel semelhante ao Hadoop Distributed File System (HDFS).
Componentes da arquitetura do Hologres
A figura a seguir ilustra a arquitetura do Hologres.
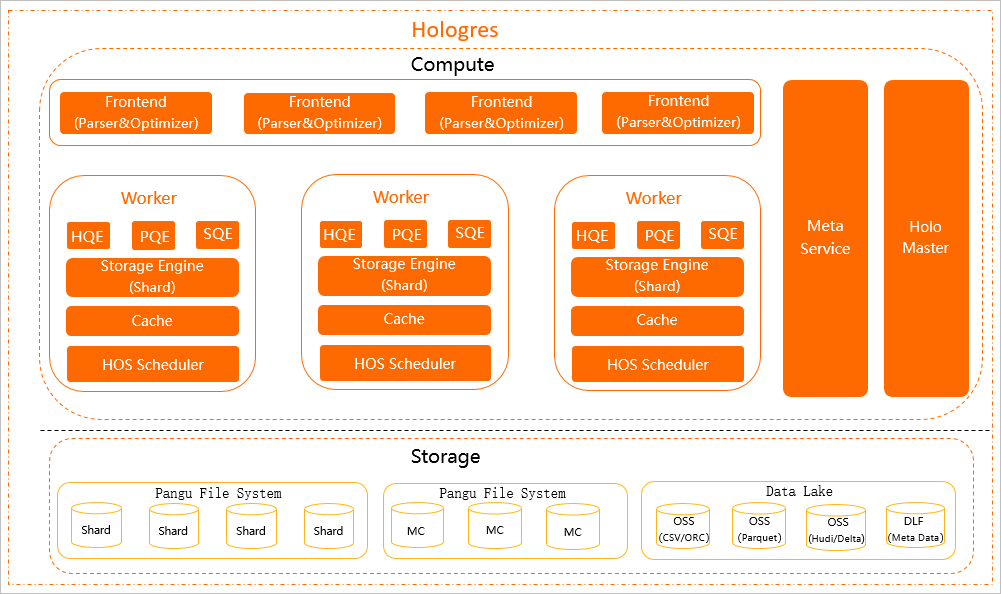
Camada de computação
Frontend (FE)
O FE autentica, analisa e otimiza instruções SQL. Uma instância do Hologres executa múltiplos FEs. Como o Hologres é compatível com PostgreSQL 11, use sintaxe padrão PostgreSQL e conecte ferramentas de desenvolvimento e Business Intelligence (BI) compatíveis com PostgreSQL sem configuração adicional.
HoloWorker
Os HoloWorkers agendam e executam consultas dos usuários. Cada HoloWorker contém um Query Engine (QE), Storage Engine (SE), Cache e HOS Scheduler.
Query Engine (QE)
O HoloWorker suporta três mecanismos de consulta, cada um atendendo a uma carga de trabalho diferente:
| Mecanismo | Finalidade | Principais características |
|---|---|---|
| Hologres Query Engine (HQE) | Mecanismo principal para consultas analíticas | Arquitetura MPP escalável com operadores vetorizados; maximiza a utilização da CPU para alto desempenho de consultas |
| PostgreSQL Query Engine (PQE) | Camada de compatibilidade com PostgreSQL | Suporta PostGIS e UDFs escritas em PL/Java, PL/SQL ou PL/Python; lida com operações ainda não suportadas pelo HQE |
| Seahawks Query Engine (SQE) | Integração com MaxCompute | Conecta-se ao MaxCompute sem migração de dados; suporta tabelas hash, tabelas com clustering por intervalo e análise interativa de dados em lote na escala de PB |
O objetivo de longo prazo é integrar todas as funcionalidades do PQE ao HQE.
Storage Engine (SE)
O SE gerencia dados e trata todas as operações de crie, leitura, atualize e exclua (CRUD).
Cache
O componente Cache armazena resultados de consultas em cache para melhorar o desempenho.
HOS Scheduler
O HOS Scheduler fornece recursos de agendamento leve.
Meta Service
O Meta Service gerencia metadados — incluindo estruturas de tabelas e distribuição de dados no SE — e os disponibiliza para os FEs.
Holo Master
O Hologres executa nativamente no Kubernetes. Se um nó de trabalho falhar, o Kubernetes provisiona um substituto rapidamente, mantendo a disponibilidade no nível do nó. O Holo Master monitora a integridade dos componentes em cada nó de trabalho e reinicia qualquer componente em estado anormal, reduzindo interrupções de serviço.
Camada de armazenamento
Os dados do Hologres são armazenados no Pangu, sistema de arquivos distribuído da Alibaba. A camada de armazenamento também se integra a fontes de dados externas:
MaxCompute: O Hologres lê dados do MaxCompute armazenados no Pangu. O Pangu permite acesso mútuo eficiente entre Hologres e MaxCompute sem movimentação de dados.
Object Storage Service (OSS) e Data Lake Formation (DLF): O Hologres consulta dados no OSS e no DLF para acelerar análises em data lakes. Os formatos suportados incluem CSV, ORC, Parquet, Hudi, Delta e Meta Data. O Hologres também pode gravar dados no OSS para reduzir custos de armazenamento.