O recurso de clone de namespace permite copiar rapidamente entidades e configurações de um namespace de origem para um namespace de destino na mesma região. Isso reduz o trabalho repetitivo de desenvolvimento, melhora a utilização de recursos e fornece um backup frio para recuperação de desastres. Este tópico aborda os casos de uso, o procedimento e as considerações importantes para clonar um namespace.
Casos de uso
Categoria | Caso de uso | Recomendação |
Backup de dados |
|
|
Clonagem e compartilhamento de recursos |
|
|
Migração de armazenamento e dados |
| Permissões de armazenamento: Para clonar de um armazenamento OSS para um armazenamento totalmente gerenciado, conceda permissões de somente leitura (incluindo a ação ListObject) no bucket associado ao namespace à conta totalmente gerenciada |
Limitações
Restrição de região: A clonagem tem suporte apenas para namespaces dentro da mesma região. Não há suporte para operações entre regiões.
Escopo da clonagem: É possível clonar apenas namespaces, não workspaces inteiros.
Conteúdo excluído: Orquestração de tarefas, filas, permissões e configurações de alerta não são clonados.
Política de versão: Apenas o rascunho mais recente do ambiente de desenvolvimento e a implantação do ambiente de operações são clonados. Versões históricas de rascunhos são ignoradas.
Operações simultâneas: Não é possível clonar um namespace de origem para vários destinos, ou vários namespaces de origem para um único destino, simultaneamente.
Compatibilidade de armazenamento: Se o workspace de origem usar armazenamento totalmente gerenciado, o workspace de destino também deverá usar. Não é possível selecionar como destino um workspace que utilize OSS.
Compatibilidade de arquitetura: A clonagem tem suporte apenas entre namespaces com a mesma arquitetura. Não há suporte para clonagem entre arquiteturas x86 e ARM.
Clonagem com estado: A clonagem com estado (um checkpoint ou savepoint) tem suporte apenas para versões de engine VVR 6.0.2 e posteriores.
Considerações
PermissõesPara iniciar um clone, você deve ter a função Editor tanto para o namespace de origem quanto para o de destino. O sistema usa a identidade desse usuário para autenticação de ponta a ponta. Para obter mais informações, consulte Autorizar usuários no console de desenvolvimento.
Restrições de clonagem
Bloqueio de recursos: Não é possível alterar configurações de recursos durante o processo de clonagem.
Operação irreversível: A operação de clone não pode ser desfeita. Se você interromper o processo, será necessário excluir manualmente quaisquer recursos que já tenham sido clonados.
Evite duplicação: Clonar para o mesmo namespace de destino várias vezes resulta em recursos duplicados.
Permissões de armazenamento: Para clonar de um armazenamento OSS para um armazenamento totalmente gerenciado, conceda permissões de somente leitura (incluindo a ação ListObject) no bucket associado ao namespace à conta totalmente gerenciada
arn:sts::1060219998962774:assumed-role/aliyunstreamasidefaultrole/refresh_token. Para obter mais informações, consulte Definir uma política de bucket.
Status do job clonado
Ao optar por clonar com estado:
Para jobs de streaming concluídos ou parados, o sistema clona o snapshot mais recente ou o checkpoint do sistema.
Para jobs de streaming em execução ou em transição, se você selecionar a política Do not skip, o sistema cria automaticamente um snapshot antes da clonagem. No entanto, como o job continua em execução, ele pode gerar um checkpoint de sistema mais novo; portanto, não há garantia de que o snapshot clonado seja o estado mais recente.
Verifique o status do job de streaming
Em cenários de migração, pare o job de origem antes de clonar para evitar inconsistências de dados causadas por estados recém-gerados.
Executar o job de origem e sua cópia clonada simultaneamente pode prejudicar sua lógica de negócios. Certifique-se de que não haverá impacto antes de iniciar o job clonado.
Um checkpoint de sistema bem-sucedido indica que o job clonado está funcionando corretamente. Monitore seu status de perto.
Lide com conflitos de nomenclaturaO sistema renomeia automaticamente qualquer entidade no namespace de destino que tenha o mesmo nome de uma entidade clonada. Você pode visualizar uma lista de itens renomeados na página Details do histórico de clonagem.
Atualize configurações manualmenteNomes de catálogos configurados ou referenciados em um job não são atualizados automaticamente. Modifique-os manualmente no código e na configuração do job para evitar falhas.
Depure jobsApós a conclusão da clonagem, todos os jobs clonados e o cluster de sessão estarão no estado parado. Um job clonado pode não ser executado corretamente sem ajustes, por exemplo, se configurações de dependência estiverem ausentes. Execute as seguintes ações:
Depure o rascunho do job.
Verifique se os arquivos de dependência estão conforme o esperado.
Ajuste as configurações de dependência do job.
Procedimento
Prepare o namespace de origem, o workspace de destino e o namespace de destino. Para obter mais informações, consulte Ativar o Realtime Compute for Apache Flink ou Gerenciar namespaces.
-
Clone as entidades e as informações de configuração do namespace.
Faça login no console do Realtime Compute for Apache Flink.
Na coluna More do workspace que contém o namespace de origem, selecione .
-
Configure as definições de clonagem.
Selecione os namespaces de origem e de destino.
-
Selecione os objetos a serem clonados.
Selecione os objetos para clonagem conforme necessário, como rascunhos, implantações, recursos de arquivo, catálogos personalizados, UDFs, conectores, formatos de dados e configurações de variáveis.
Ao clonar implantações, todos os jobs no namespace atual são selecionados por padrão. Filtre a lista para selecionar jobs específicos. A filtragem tem suporte por nome do job, tipo de job, versão da engine, status de execução e horário da última conclusão de clone.
-
Configure as políticas de clonagem.
Configuração
Opção
Descrição
Política de clonagem de estado de job de streaming
Com estado
Clona o snapshot mais recente ou o checkpoint do sistema para evitar o reprocessamento de dados já processados.
Sem estado
Clona apenas a configuração e o código do job, sem nenhum snapshot ou checkpoint do sistema.
Política de clonagem de job de streaming em execução
Pular
Ignora jobs de streaming em execução para evitar interferência de dados devido a novos estados gerados pelo job de origem. Recomendado para migrações.
Não pular
Cria um snapshot de jobs de streaming em execução antes da clonagem para garantir que o estado mais recente seja capturado. Recomendado para backups.
Política de tratamento de erros
Pular e continuar
Se uma entidade falhar ao clonar, a falha é registrada e o processo continua com as entidades restantes.
Parar clonagem
Se qualquer entidade falhar ao clonar, toda a tarefa de clonagem é interrompida imediatamente. Os dados que foram clonados com sucesso são retidos.
Permitir clonagem sem estado
Se a clonagem com estado falhar, o processo reverte automaticamente para clonagem sem estado e continua.
Clique em Start cloning.
-
Visualize o progresso e os resultados da clonagem.
-
Durante a clonagem
Logo após clicar em Start cloning, uma notificação aparece. Clique em View cloning progress para monitorar a tarefa, que pode ser executada em segundo plano.
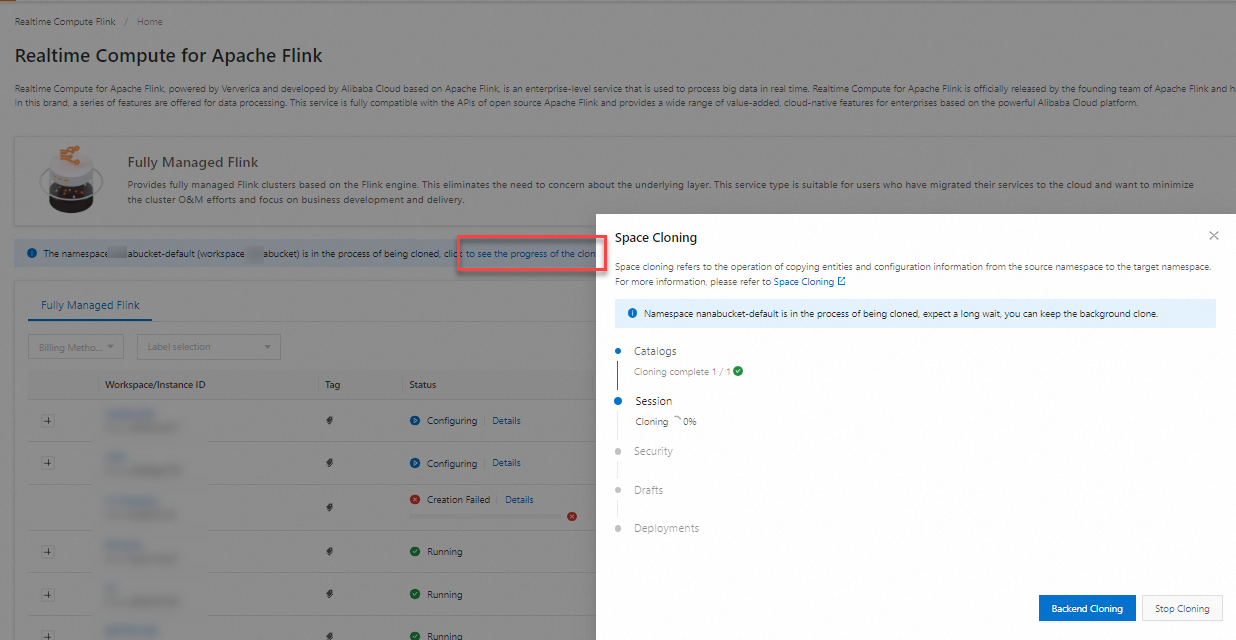
-
Após a conclusão da clonagem
Na coluna More do workspace de destino, selecione e clique em Details. Visualize as categorias, a contagem total e a contagem de falhas das entidades clonadas. Uma lista de entidades renomeadas também é exibida.
-
Documentação relacionada
Para saber como fazer backup de jobs SQL e DataStream, consulte Fazer backup e implantar um job.