Processar dados de comportamento do usuário é desafiador devido ao alto volume e à diversidade de formatos. Modelos tradicionais de tabela wide oferecem consultas eficientes, mas geram alta redundância de dados, maior sobrecarga de armazenamento e ciclos lentos de manutenção. Este tutorial demonstra como usar o Realtime Compute for Apache Flink, o ApsaraDB for MongoDB e o Hologres para criar um pipeline de tabela wide em tempo real que equilibra esses fatores.
Como funciona
O Realtime Compute for Apache Flink gerencia o processamento de fluxo. O ApsaraDB for MongoDB armazena as tabelas de fatos e dimensões como um banco de dados NoSQL orientado a documentos, com esquema flexível e alto throughput de leitura e escrita. O Hologres atua como data warehouse analítico: os dados ficam disponíveis para consulta imediatamente após a gravação.
O pipeline utiliza dois jobs do Flink conectados por um tópico Kafka:
Job 1: lê o fluxo de captura de dados de alteração (CDC) do MongoDB. Quando a tabela de fatos (
game_sales) sofre alterações, suas chaves primárias (PKs) são enviadas diretamente ao Kafka. Se uma tabela de dimensões for alterada, um lookup join identifica os registros afetados na tabela de fatos e envia suas PKs ao Kafka.Job 2: consome as PKs do Kafka, executa lookup joins nas tabelas de fatos e dimensões do MongoDB para reconstruir o registro completo da tabela wide e faz o upsert do resultado no Hologres.

Benefícios:
Alto throughput de escrita: O ApsaraDB for MongoDB lida com leituras e escritas de alta concorrência em clusters fragmentados. Ele escala desempenho e armazenamento para acomodar grandes volumes de atualizações frequentes.
Propagação eficiente de alterações: Apenas as PKs dos registros afetados são encaminhadas ao Kafka, não as linhas completas. Isso mantém o reprocessamento mínimo, independentemente do volume total de dados.
Consulta em tempo real: O Hologres suporta upserts de baixa latência e disponibiliza os dados para consulta imediata após cada escrita.
Prática guiada
Ao final deste tutorial, você terá um pipeline ativo. As alterações no MongoDB — tanto na tabela de fatos quanto nas tabelas de dimensões — se propagarão automaticamente para uma tabela wide no Hologres e ficarão imediatamente disponíveis para consulta.

O pipeline une três coleções do MongoDB em uma única tabela wide no Hologres:
game_sales
<table> <thead> <tr> <td><p>sale_id</p></td> <td><p>game_id</p></td> <td><p>platform_id</p></td> <td><p>sale_date</p></td> <td><p>units_sold</p></td> <td><p>sale_amt</p></td> <td><p>status</p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody></tbody> </table>
game_dimension
<table> <thead> <tr> <td><p>game_id</p></td> <td><p>game_name</p></td> <td><p>release_date</p></td> <td><p>developer</p></td> <td><p>publisher</p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody></tbody> </table>
platform_dimension
<table> <thead> <tr> <td><p>platform_id</p></td> <td><p>platform_name</p></td> <td><p>type</p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody></tbody> </table>
game_sales_details
<table> <thead> <tr> <td><p>sale_id</p></td> <td><p>game_id</p></td> <td><p>platform_id</p></td> <td><p>sale_date</p></td> <td><p>units_sold</p></td> <td><p>sale_amt</p></td> <td><p>status</p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody> <tr> <td><p>game_name</p></td> <td><p>release_date</p></td> <td><p>developer</p></td> <td><p>publisher</p></td> <td><p>platform_name</p></td> <td><p>type</p></td> <td><p></p></td> </tr> </tbody> </table>
Fluxo de propagação de alterações
Cada alteração passa por quatro estágios:
Captura: Detecta alterações em tempo real nas tabelas de dimensões do MongoDB.
Propagação: Ao detectar uma mudança na tabela de dimensões, o Job 1 executa um lookup join (por exemplo, em
game_id) para localizar as linhas afetadas na tabela de fatos e extrai suas PKs (por exemplo,sale_id).Disparo: Envia as PKs ao Kafka para notificar o Job 2 sobre atualizações pendentes.
Upsert: O Job 2 busca os dados mais recentes, reconstrói a linha da tabela wide e executa o upsert no Hologres.
Pré-requisitos
Antes de começar, verifique se você possui:
Um workspace do Realtime Compute for Apache Flink executando VVR 8.0.5 ou posterior. Para mais informações, consulte Ativar o Realtime Compute for Apache Flink.
Uma instância do ApsaraDB for MongoDB executando a versão 4,0 ou posterior. Para mais informações, consulte Criar uma instância de cluster fragmentado.
Uma instância exclusiva do Hologres executando a versão 1,3 ou posterior. Para mais informações, consulte Adquirir uma instância do Hologres.
Uma instância do ApsaraMQ for Kafka. Para mais informações, consulte Implantar uma instância do ApsaraMQ for Kafka.
Todas as quatro instâncias na mesma Virtual Private Cloud (VPC). Caso estejam em VPCs diferentes, estabeleça conectividade entre VPCs ou ative o acesso à internet para o Realtime Compute for Apache Flink. Para mais informações, consulte Como o Realtime Compute for Apache Flink acessa um serviço entre VPCs? e Como o Realtime Compute for Apache Flink acessa a Internet?
Permissões de usuário RAM ou função RAM para os recursos relevantes.
Etapa 1: Preparar os dados
Criar coleções do MongoDB
Adicione o bloco CIDR do seu workspace Flink à lista de permissões do MongoDB. Para detalhes, consulte Configurar uma lista de permissões para uma instância e Como configuro uma lista de permissões?
-
No editor SQL do console do Data Management (DMS), crie o banco de dados
mongo_test:use mongo_test; -
Crie as coleções
game_sales,game_dimensioneplatform_dimensione insira dados de exemplo:// Game sales table (status: 1 = active, 0 = logically deleted) db.game_sales.insert( [ {sale_id:0,game_id:101,platform_id:1,"sale_date":"2024-01-01",units_sold:500,sale_amt:2500,status:1}, ] ); // Game dimension table db.game_dimension.insert( [ {game_id:101,"game_name":"SpaceInvaders","release_date":"2023-06-15","developer":"DevCorp","publisher":"PubInc"}, {game_id:102,"game_name":"PuzzleQuest","release_date":"2023-07-20","developer":"PuzzleDev","publisher":"QuestPub"}, {game_id:103,"game_name":"RacingFever","release_date":"2023-08-10","developer":"SpeedCo","publisher":"RaceLtd"}, {game_id:104,"game_name":"AdventureLand","release_date":"2023-09-05","developer":"Adventure","publisher":"LandCo"}, ] ); // Platform dimension table db.platform_dimension.insert( [ {platform_id:1,"platform_name":"PCGaming","type":"PC"}, {platform_id:2,"platform_name":"PlayStation","type":"Console"}, {platform_id:3,"platform_name":"Mobile","type":"Mobile"} ] ); -
Verifique as inserções:
db.game_sales.find();
db.game_dimension.find();
db.platform_dimension.find();
Criar a tabela do Hologres
Faça logon no console do Hologres, clique em Instances no painel de navegação à esquerda e selecione sua instância do Hologres. No canto superior direito, clique em Connect to Instance.
-
Na barra de navegação superior, clique em Metadata Management > Create Database. Insira
testno campo Database Name, defina Policy como SPM e clique em OK. Para mais informações, consulte Criar um banco de dados.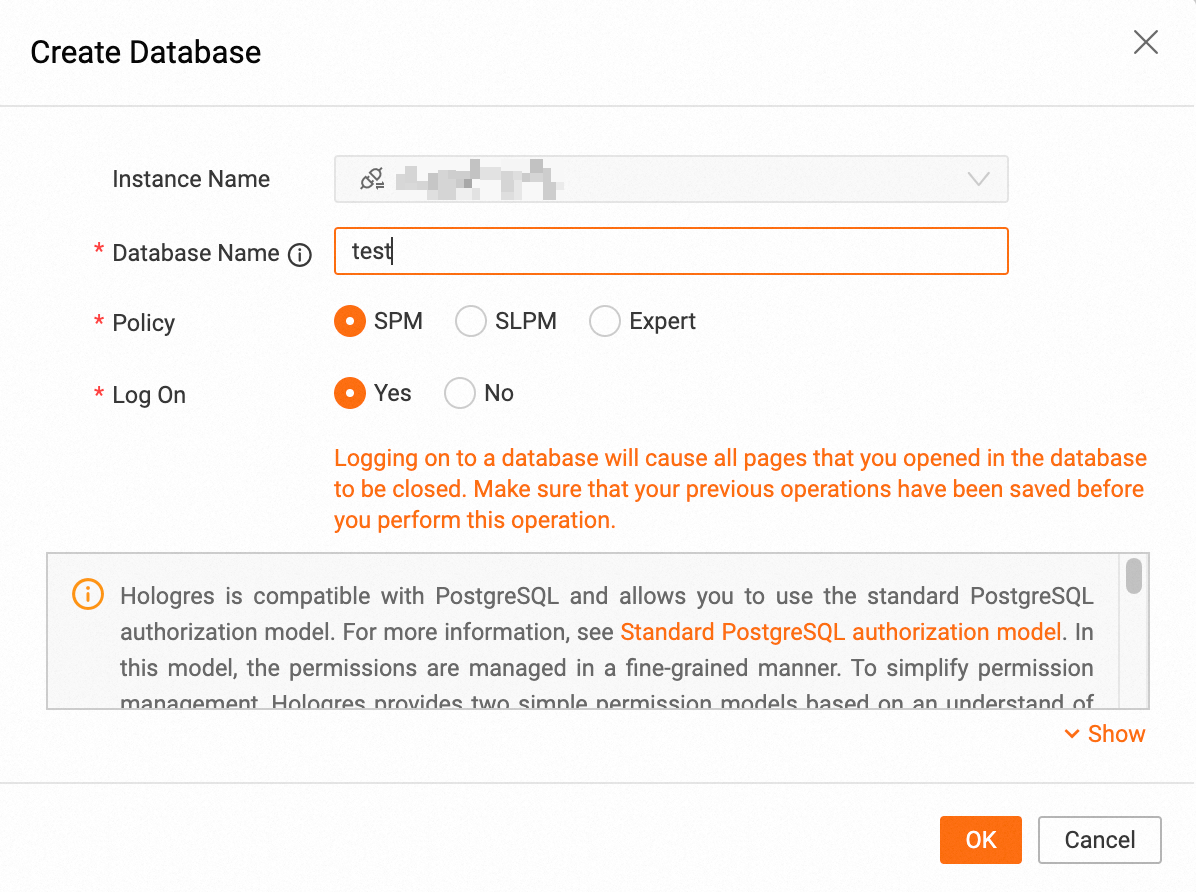
-
Na barra de navegação superior, clique em SQL Editor. Clique no ícone SQL para criar uma nova consulta, selecione a instância e o banco de dados de destino e execute a seguinte instrução para criar a tabela wide
game_sales_details:CREATE TABLE game_sales_details( sale_id INT not null primary key, game_id INT, platform_id INT, sale_date VARCHAR(50), units_sold INT, sale_amt INT, status INT, game_name VARCHAR(50), release_date VARCHAR(50), developer VARCHAR(50), publisher VARCHAR(50), platform_name VARCHAR(50), type VARCHAR(50) );
Criar o tópico Kafka
Faça logon no console do ApsaraMQ for Kafka. Clique em Instances no painel de navegação à esquerda e selecione sua instância.
No painel de navegação à esquerda, clique em Whitelist Management e adicione o bloco CIDR do seu workspace Flink.
No painel de navegação à esquerda, clique em Topics > Create Topic. No painel direito, insira
game_sales_factno campo Name, adicione uma descrição e mantenha os valores padrão para todos os outros campos. Clique em OK.
Etapa 2: Criar jobs de fluxo
Job 1: Gravar chaves primárias no Kafka
O Job 1 monitora todas as três coleções do MongoDB. Quando há alterações em game_sales, o valor de sale_id é enviado diretamente ao Kafka. Se uma tabela de dimensões for modificada, um lookup join em game_sales recupera os valores de sale_id afetados e os transmite ao Kafka.
O conector do MongoDB desempenha duas funções neste pipeline. No Job 1, atua como source CDC e lê o fluxo de alterações do MongoDB. No Job 2, funciona como source de lookup e busca o estado atual de cada documento pela chave primária. Ambas as funções utilizam a mesma configuração de conector.

Faça logon no console do Realtime Compute for Apache Flink.
Na coluna Actions do seu workspace, clique em Console.
No menu de navegação à esquerda, clique em Development > ETL.
Clique em New Blank Stream Draft.
Na caixa de diálogo New Draft, insira
dwd_mongo_kafkaem Name, selecione uma versão do mecanismo e clique em Create.-
Copie o seguinte SQL para o editor. Cada uma das três instruções
INSERTcaptura independentemente as alterações de uma coleção do MongoDB e transmite os valores desale_idafetados ao sink do Kafka. Isso garante que o Hologres seja atualizado com precisão e em tempo real sempre que qualquer tabela for modificada. Armazene valores sensíveis, como strings de conexão e senhas, como variáveis em vez de codificá-los diretamente. Para mais informações, consulte Gerenciar variáveis.Tempo
**Estado de
game_dimensionparagame_id = 101**T1
game_name = "SpaceInvaders"T2
Atualizado para
game_name = "SpaceInvaders_v2"-- Source: game_sales (CDC stream) CREATE TEMPORARY TABLE game_sales ( `_id` STRING, -- MongoDB auto-generated ID sale_id INT, -- Sales ID PRIMARY KEY (_id) NOT ENFORCED ) WITH ( 'connector' = 'mongodb', 'uri' = '${secret_values.MongoDB-URI}', 'database' = 'mongo_test', 'collection' = 'game_sales' ); -- Source: game_dimension (CDC stream) CREATE TEMPORARY TABLE game_dimension ( `_id` STRING, game_id INT, PRIMARY KEY (_id) NOT ENFORCED ) WITH ( 'connector' = 'mongodb', 'uri' = '${secret_values.MongoDB-URI}', 'database' = 'mongo_test', 'collection' = 'game_dimension' ); -- Source: platform_dimension (CDC stream) CREATE TEMPORARY TABLE platform_dimension ( `_id` STRING, platform_id INT, PRIMARY KEY (_id) NOT ENFORCED ) WITH ( 'connector' = 'mongodb', 'uri' = '${secret_values.MongoDB-URI}', 'database' = 'mongo_test', 'collection' = 'platform_dimension' ); -- Lookup source: game_sales (used for dimension-change joins) CREATE TEMPORARY TABLE game_sales_dim ( `_id` STRING, sale_id INT, game_id INT, platform_id INT, PRIMARY KEY (_id) NOT ENFORCED ) WITH ( 'connector' = 'mongodb', 'uri' = '${secret_values.MongoDB-URI}', 'database' = 'mongo_test', 'collection' = 'game_sales' ); -- Sink: Kafka topic that stores affected PKs CREATE TEMPORARY TABLE game_sales_fact ( sale_id INT, PRIMARY KEY (sale_id) NOT ENFORCED ) WITH ( 'connector' = 'upsert-kafka', 'properties.bootstrap.servers' = '${secret_values.Kafka-hosts}', 'topic' = 'game_sales_fact', 'key.format' = 'json', 'value.format' = 'json', 'properties.enable.idempotence' = 'false' -- Required when writing to ApsaraMQ for Kafka ); BEGIN STATEMENT SET; -- Stream PKs from game_sales changes INSERT INTO game_sales_fact (sale_id) SELECT sale_id FROM game_sales; -- Stream PKs of game_sales rows affected by game_dimension changes INSERT INTO game_sales_fact (sale_id) SELECT gs.sale_id FROM game_dimension AS gd JOIN game_sales_dim FOR SYSTEM_TIME AS OF PROCTIME() AS gs ON gd.game_id = gs.game_id; -- Stream PKs of game_sales rows affected by platform_dimension changes INSERT INTO game_sales_fact (sale_id) SELECT gs.sale_id FROM platform_dimension AS pd JOIN game_sales_dim FOR SYSTEM_TIME AS OF PROCTIME() AS gs ON pd.platform_id = gs.platform_id; END;Sobre lookup joins A cláusula
FOR SYSTEM_TIME AS OF PROCTIME()define um lookup join (um tipo de junção temporal). No momento em que uma linha da source é processada, a junção busca a linha correspondente na tabela de dimensões do MongoDB e congela esse snapshot para o resultado da junção. Se a tabela de dimensões for atualizada posteriormente, as linhas já processadas não serão afetadas. Por exemplo: uma linha degame_salesprocessada em T1 faz junção com"SpaceInvaders". Uma linha processada em T2 faz junção com"SpaceInvaders_v2". As condições de junção sãogd.game_id = gs.game_idepd.platform_id = gs.platform_id. Para mais informações, consulte Instruções JOIN para tabelas de dimensões e Escolher Kafka, Upsert Kafka ou catálogo Kafka JSON. No canto superior direito, clique em Deploy. Na caixa de diálogo, clique em Confirm. Para mais informações, consulte Implantar um job.
Job 2: Reconstruir a tabela wide e fazer upsert no Hologres
O Job 2 consome valores de sale_id do tópico Kafka game_sales_fact, executa lookup joins nas tabelas de fatos e dimensões do MongoDB e faz o upsert das linhas resultantes da tabela wide no Hologres.

Siga as etapas em Job 1 para criar um novo rascunho chamado dws_kafka_mongo_holo e implantá-lo com o seguinte SQL:
-- Source: Kafka topic that provides affected PKs
CREATE TEMPORARY TABLE game_sales_fact
(
  sale_id  INT,
  PRIMARY KEY (sale_id) NOT ENFORCED
)
WITH (
  'connector' = 'upsert-kafka',
  'properties.bootstrap.servers' = '${secret_values.Kafka-hosts}',
  'topic' = 'game_sales_fact',
  'key.format' = 'json',
  'value.format' = 'json',
  'properties.group.id' = 'game_sales_fact',
  'properties.auto.offset.reset' = 'earliest'
);

-- Lookup source: game_sales fact table
CREATE TEMPORARY TABLE game_sales
(
  `_id`       STRING,
  sale_id     INT,
  game_id     INT,
  platform_id INT,
  sale_date   STRING,
  units_sold  INT,
  sale_amt    INT,
  status      INT,
  PRIMARY KEY (_id) NOT ENFORCED
)
WITH (
  'connector' = 'mongodb',
  'uri' = '${secret_values.MongoDB-URI}',
  'database' = 'mongo_test',
  'collection' = 'game_sales'
);

-- Lookup source: game_dimension
CREATE TEMPORARY TABLE game_dimension
(
  `_id`        STRING,
  game_id      INT,
  game_name    STRING,
  release_date STRING,
  developer    STRING,
  publisher    STRING,
  PRIMARY KEY (_id) NOT ENFORCED
)
WITH (
  'connector' = 'mongodb',
  'uri' = '${secret_values.MongoDB-URI}',
  'database' = 'mongo_test',
  'collection' = 'game_dimension'
);

-- Lookup source: platform_dimension
CREATE TEMPORARY TABLE platform_dimension
(
  `_id`          STRING,
  platform_id    INT,
  platform_name  STRING,
  type           STRING,
  PRIMARY KEY (_id) NOT ENFORCED
)
WITH (
  'connector' = 'mongodb',
  'uri' = '${secret_values.MongoDB-URI}',
  'database' = 'mongo_test',
  'collection' = 'platform_dimension'
);

-- Sink: Hologres wide table
CREATE TEMPORARY TABLE IF NOT EXISTS game_sales_details
(
  sale_id       INT,
  game_id       INT,
  platform_id   INT,
  sale_date     STRING,
  units_sold    INT,
  sale_amt      INT,
  status        INT,
  game_name     STRING,
  release_date  STRING,
  developer     STRING,
  publisher     STRING,
  platform_name STRING,
  type          STRING,
  PRIMARY KEY (sale_id) NOT ENFORCED
)
WITH (
  'connector' = 'hologres',
  'dbname' = 'test',
  'tablename' = 'public.game_sales_details',
  'username' = '${secret_values.AccessKeyID}',
  'password' = '${secret_values.AccessKeySecret}',
  'endpoint' = '${secret_values.Hologres-endpoint}',
  'sink.delete-strategy' = 'IGNORE_DELETE',       -- Insert or update only; never delete rows
  'sink.on-conflict-action' = 'INSERT_OR_UPDATE',  -- Enable partial column updates
  'sink.partial-insert.enabled' = 'true'
);

INSERT INTO game_sales_details (
  sale_id, game_id, platform_id, sale_date, units_sold, sale_amt, status,
  game_name, release_date, developer, publisher, platform_name, type
)
SELECT
  gsf.sale_id,
  gs.game_id,
  gs.platform_id,
  gs.sale_date,
  gs.units_sold,
  gs.sale_amt,
  gs.status,
  gd.game_name,
  gd.release_date,
  gd.developer,
  gd.publisher,
  pd.platform_name,
  pd.type
FROM game_sales_fact AS gsf
JOIN game_sales FOR SYSTEM_TIME AS OF PROCTIME() AS gs
  ON gsf.sale_id = gs.sale_id
JOIN game_dimension FOR SYSTEM_TIME AS OF PROCTIME() AS gd
  ON gs.game_id = gd.game_id
JOIN platform_dimension FOR SYSTEM_TIME AS OF PROCTIME() AS pd
  ON gs.platform_id = pd.platform_id;
Etapa 3: Iniciar os jobs
No Console de Desenvolvimento, escolha O&M > Deployments e inicie ambas as implantações de job.
-
Depois que ambos os jobs atingirem o estado Running, acesse o HoloWeb e consulte a tabela
game_sales_details:SELECT * FROM game_sales_details;A linha inicial inserida na Etapa 1 aparece no resultado.

Etapa 4: Atualizar e consultar dados
As alterações em game_sales e nas tabelas de dimensões no MongoDB se propagam automaticamente para o Hologres. Os exemplos a seguir demonstram cada tipo de atualização.
Atualizações da tabela de fatos
-
Insira mais cinco linhas em
game_sales:db.game_sales.insert( [ {sale_id:1,game_id:101,platform_id:1,"sale_date":"2024-01-01",units_sold:500,sale_amt:2500,status:1}, {sale_id:2,game_id:102,platform_id:2,"sale_date":"2024-08-02",units_sold:400,sale_amt:2000,status:1}, {sale_id:3,game_id:103,platform_id:1,"sale_date":"2024-08-03",units_sold:300,sale_amt:1500,status:1}, {sale_id:4,game_id:101,platform_id:3,"sale_date":"2024-08-04",units_sold:200,sale_amt:1000,status:1}, {sale_id:5,game_id:104,platform_id:2,"sale_date":"2024-08-05",units_sold:100,sale_amt:3000,status:1} ] );Consulte
game_sales_detailsno Hologres. Cinco novas linhas aparecem.
-
Atualize
sale_datede2024-01-01para2024-08-01:db.game_sales.updateMany({"sale_date": "2024-01-01"}, {$set: {"sale_date": "2024-08-01"}});Consulte
game_sales_details. A colunasale_datereflete o novo valor.
-
Exclua logicamente a linha onde
sale_id = 5definindostatuscomo0:db.game_sales.updateMany({"sale_id": 5}, {$set: {"status": 0}});Consulte
game_sales_details. A colunastatusparasale_id = 5muda para0.
Atualizações da tabela de dimensões
-
Adicione novos jogos e plataformas às tabelas de dimensões:
// New games
db.game_dimension.insert(
  [
{game_id:105,"game_name":"HSHWK","release_date":"2024-08-20","developer":"GameSC","publisher":"GameSC"},
{game_id:106,"game_name":"HPBUBG","release_date":"2018-01-01","developer":"BLUE","publisher":"KK"}
  ]
);

// New platforms
db.platform_dimension.insert(
  [
{platform_id:4,"platform_name":"Steam","type":"PC"},
{platform_id:5,"platform_name":"Epic","type":"PC"}
  ]
);
Inserir dados apenas nas tabelas de dimensões não aciona a sincronização. O pipeline é impulsionado por alterações em
game_sales. Insira registros de vendas correspondentes para disparar a atualização da tabela wide:db.game_sales.insert( [ {sale_id:6,game_id:105,platform_id:4,"sale_date":"2024-09-01",units_sold:400,sale_amt:2000,status:1}, {sale_id:7,game_id:106,platform_id:1,"sale_date":"2024-09-01",units_sold:300,sale_amt:1500,status:1} ] );Consulte
game_sales_details. Duas novas linhas aparecem com os dados enriquecidos das dimensões.
-
Atualize os dados de dimensão no MongoDB:
// Update release date
db.game_dimension.updateMany({"release_date": "2018-01-01"}, {$set: {"release_date": "2024-01-01"}});

// Update platform type
db.platform_dimension.updateMany({"type": "PC"}, {$set: {"type": "Swich"}});
Os campos atualizados se propagam para as linhas correspondentes no Hologres.
