Ao usar o Flink SQL para processamento de dados em tempo real, eventos de changelog fora de ordem podem corromper resultados silenciosamente: registros são excluídos quando deveriam existir ou atualizações chegam na sequência errada. Este tópico explica por que esses eventos ocorrem, como o SinkUpsertMaterializer os corrige e como ajustar ou evitar esse operador quando o desempenho for crítico.
Conceitos principais
Tipos de changelog e stream
Em bancos de dados relacionais como o MySQL, o log binário (binlog) captura todas as operações INSERT, UPDATE e DELETE. O Flink SQL utiliza um mecanismo semelhante chamado changelog para rastrear alterações de dados e permitir o processamento incremental em pipelines de streaming.
Um stream de changelog se enquadra em uma das duas categorias a seguir:
|
Tipo de stream |
Tipos de evento |
Descrição |
|
Stream apenas de adição |
Somente +I |
Contém apenas eventos INSERT. Não há atualizações nem exclusões. Também conhecido como stream sem atualizações. |
|
Stream de atualização |
+I, +U, -U, -D |
Inclui eventos de atualização ou exclusão além das inserções. Operadores como agregação por grupo e deduplicação geram esse tipo. |
Nem todos os operadores consomem streams de atualização. Os operadores de over aggregation e interval join aceitam apenas streams somente de adição como entrada.
Tipos de eventos de changelog
O Flink SQL trabalha com quatro tipos de eventos, baseados no enum RowKind da API do Apache Flink:
|
Nome curto |
Nome completo |
Semântica |
|
|
INSERT |
Insere uma nova linha. |
|
|
UPDATE_BEFORE |
Retrai o conteúdo anterior de uma linha atualizada. Sempre vem em par com um evento |
|
|
UPDATE_AFTER |
Contém o novo conteúdo de uma linha atualizada. Sempre vem em par com um evento |
|
|
DELETE |
Exclui uma linha. |
O Flink mantém UPDATE_BEFORE (-U) e UPDATE_AFTER (+U) como tipos de evento separados, em vez de combiná-los em um único evento UPDATE composto, por dois motivos:
Estrutura uniforme: Ambos os eventos compartilham a mesma estrutura de linha e diferenciam-se apenas pela propriedade
RowKind. Um tipo de evento composto exigiria estruturas heterogêneas ou alinhamentos especiais entre eventos INSERT e DELETE.Shuffling distribuído: Em pipelines paralelos, operações de join e agregação redistribuem dados entre tarefas. Eventos UPDATE compostos ainda precisariam ser divididos em eventos separados durante o shuffling para garantir a corretude. Portanto, mantê-los separados desde o início simplifica o modelo.
Como ocorrem os eventos fora de ordem
Considere este exemplo, utilizado ao longo deste tópico para ilustrar o problema e sua solução:
-- CDC source tables
CREATE TEMPORARY TABLE s1 (
  id    BIGINT,
  level BIGINT,
  PRIMARY KEY(id) NOT ENFORCED
) WITH (...);

CREATE TEMPORARY TABLE s2 (
  id   BIGINT,
  attr VARCHAR,
  PRIMARY KEY(id) NOT ENFORCED
) WITH (...);

-- Sink table
CREATE TEMPORARY TABLE t1 (
  id    BIGINT,
  level BIGINT,
  attr  VARCHAR,
  PRIMARY KEY(id) NOT ENFORCED
) WITH (...);

-- Join s1 and s2 and write the result to t1
INSERT INTO t1
SELECT s1.*, s2.attr
FROM s1 JOIN s2
ON s1.level = s2.id;
Quando o registro (id=1, level=10) na tabela s1 é inserido no instante t0 e depois atualizado para (id=1, level=20) no instante t1, três eventos de changelog são produzidos:
|
Evento |
Tipo |
|
|
INSERT |
|
|
UPDATE_BEFORE |
|
|
UPDATE_AFTER |
A chave primária de s1 é id, mas a cláusula JOIN redistribui os dados com base na coluna level. Com paralelismo 2 no operador Join, esses três eventos podem ser roteados para duas tarefas diferentes: uma processando level=10 e outra processando level=20.
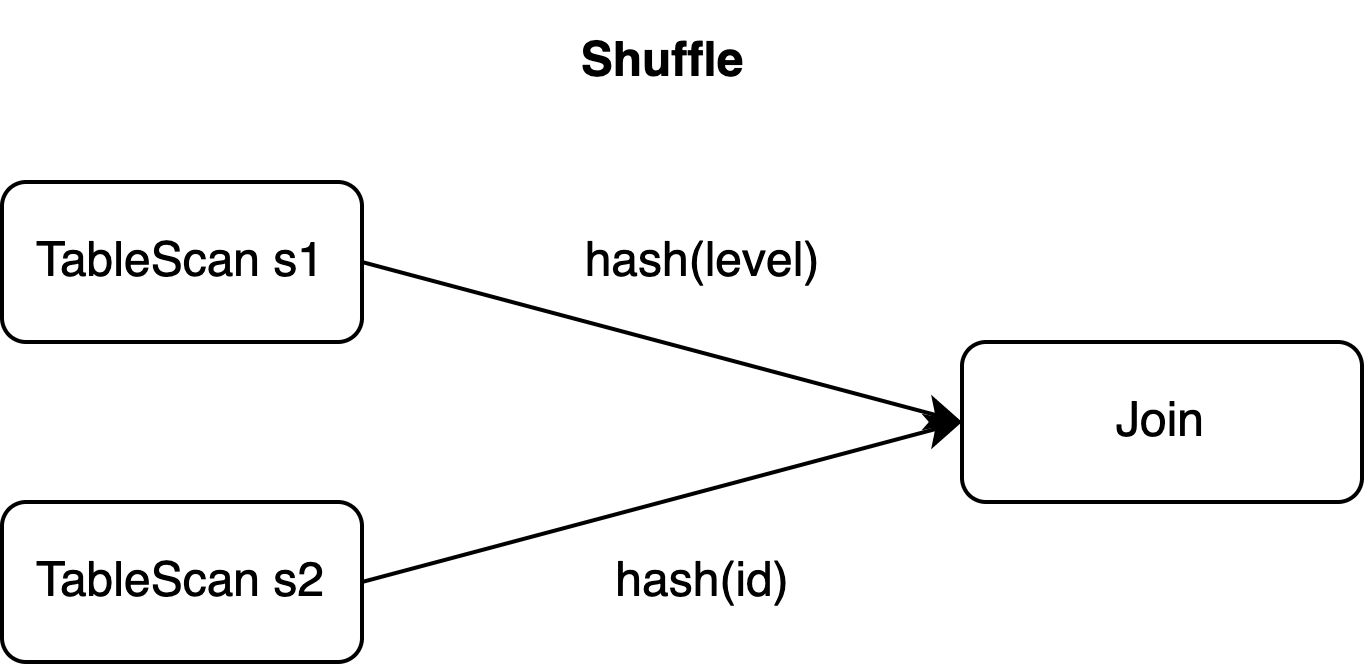
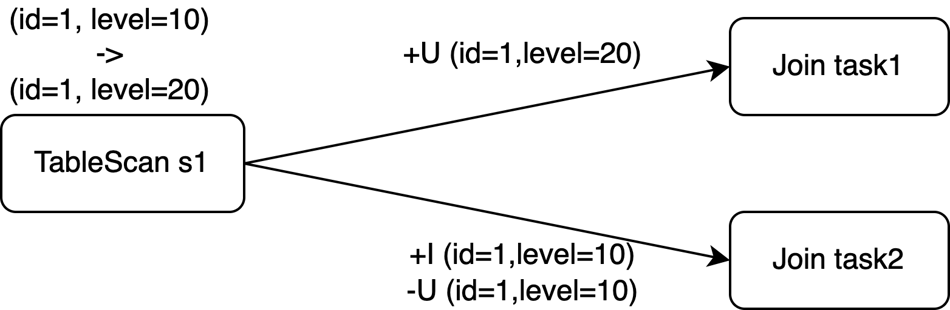
Como os eventos são processados em paralelo, o operador Sink downstream pode recebê-los em qualquer uma das três ordens possíveis:
|
Caso 1 (ordem correta) |
Caso 2 (fora de ordem) |
Caso 3 (fora de ordem) |
|
|
|
|
|
|
|
|
|
|
|
|
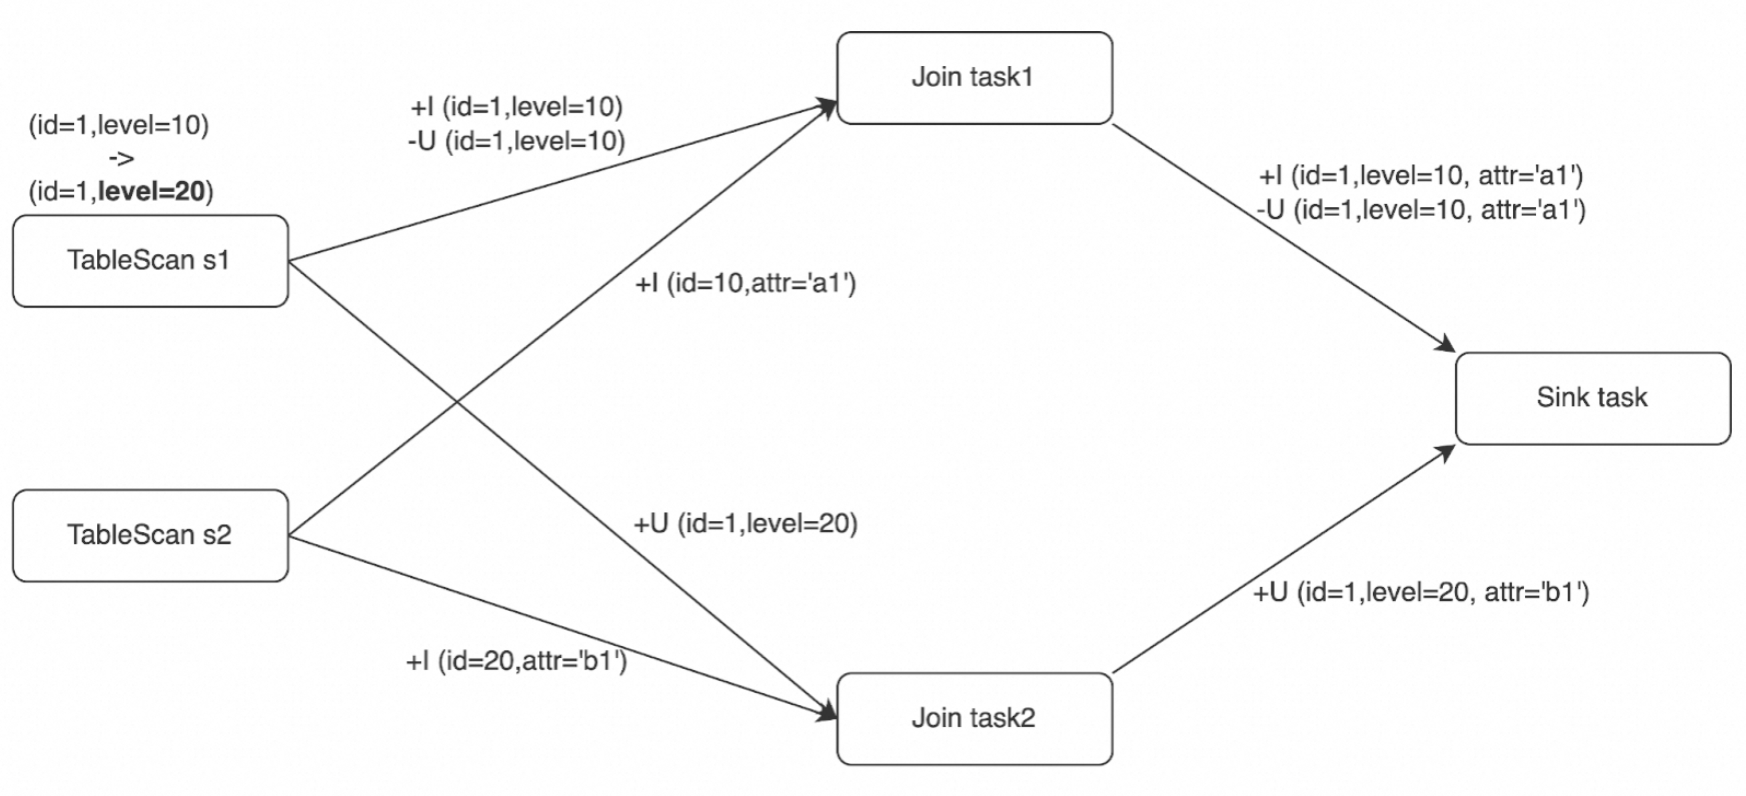
No Caso 1, os eventos seguem a sequência original, sem problemas. Nos Casos 2 e 3, a tabela sink possui id como chave primária. Se o armazenamento externo executar um upsert, o registro com id=1 acabará excluído, mesmo que o estado final esperado seja (id=1, level=20, attr='b1').
Eventos fora de ordem só ocorrem quando o paralelismo do operador Join é maior que 1. Um par de eventos com a mesma chave de upsert sempre é roteado para a mesma tarefa, motivo pelo qual apenas três cenários de ordenação são possíveis nesse caso.
SinkUpsertMaterializer
Funcionamento
O SinkUpsertMaterializer é um operador intermediário que o Flink insere para resolver problemas de ordenação. Ele foi introduzido para solucionar a issue FLINK-20374.
Para entender a necessidade do SinkUpsertMaterializer, é importante compreender as chaves de upsert. Uma upsert key é uma coluna (ou conjunto de colunas) que preserva a ordem de classificação de uma chave única ao longo de uma operação SQL. Quando existem chaves de upsert, o operador downstream recebe eventos de atualização na ordem correta. Já quando uma operação de redistribuição de dados quebra a ordenação da chave única — como faz o JOIN em level neste exemplo — a chave de upsert fica vazia.
Neste exemplo, as linhas de s1 são redistribuídas por level, então a saída do Join contém linhas com o mesmo valor de s1.id, porém em ordem arbitrária. As chaves únicas são (s1.id), (s1.id, s1.level) e (s1.id, s2.id), mas a chave de upsert está vazia. Além disso, a chave primária da tabela sink (id) não corresponde à chave de upsert na saída do Join. O SinkUpsertMaterializer preenche essa lacuna.
Eventos de changelog fora de ordem seguem regras específicas: para uma determinada chave de upsert (ou para todas as colunas, caso a chave esteja vazia), eventos ADD (+I e +U) sempre ocorrem antes dos eventos RETRACT correspondentes (-D e -U). Um par de eventos de changelog com a mesma chave de upsert é processado pela mesma tarefa, mesmo quando há redistribuição de dados. Essas garantias de ordenação são a base que o SinkUpsertMaterializer usa para reconstruir resultados corretos.
O operador funciona da seguinte forma:
Mantém uma lista de valores
RowDatano estado, indexada pela chave de upsert deduzida (ou pela linha inteira, caso a chave esteja vazia).Diante de um evento ADD (
+Iou+U): adiciona ou atualiza a linha no estado.Diante de um evento RETRACT (
-Uou-D): remove a linha do estado.Gera eventos de changelog corretos com base na chave primária da tabela sink.
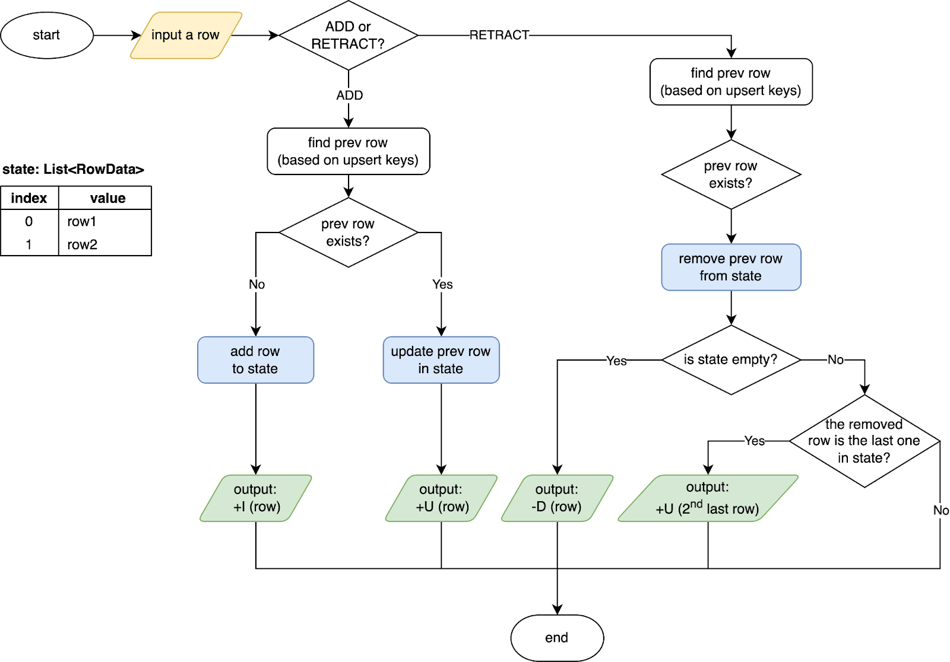
O diagrama abaixo mostra como o SinkUpsertMaterializer lida com os Casos 2 e 3 do exemplo anterior:
Caso 2: Quando
-U (id=1, level=10, attr='a1')chega por último, o SinkUpsertMaterializer remove essa linha do estado e gera um evento UPDATE baseado na penúltima linha. O resultado final é(id=1, level=20, attr='b1').Caso 3: Ao receber
+U (id=1, level=20, attr='b1'), o operador o repassa para o downstream. Quando-U (id=1, level=10, attr='a1')chega posteriormente, o operador remove a linha correspondente do estado sem emitir nenhum evento. Novamente, o resultado final é(id=1, level=20, attr='b1').
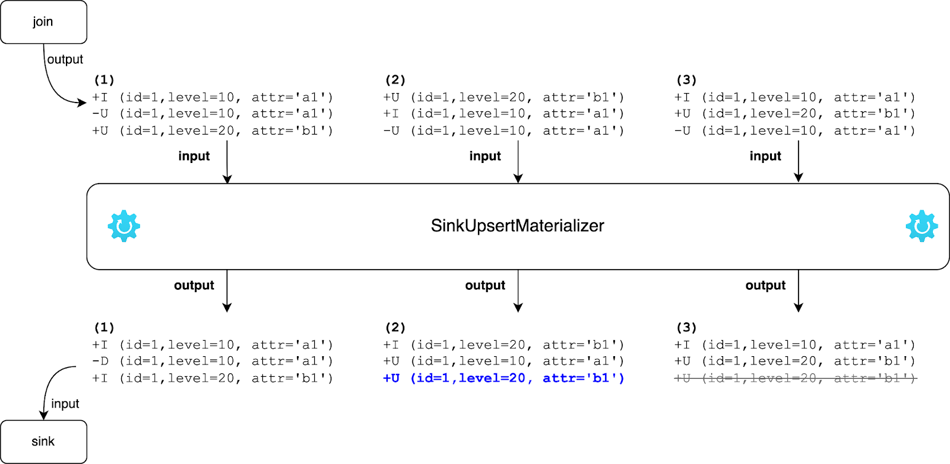
Para consultar o código-fonte, visualize SinkUpsertMaterializer (Flink release-1.17).
Quando o SinkUpsertMaterializer é acionado
O Flink adiciona o operador SinkUpsertMaterializer nos seguintes cenários:
-
A tabela sink possui chave primária, mas os dados recebidos não satisfazem a restrição UNIQUE. Causas comuns incluem:
Definir uma chave primária na tabela sink quando a tabela source não tem chave primária.
Excluir a coluna da chave primária da source ao gravar na sink, ou mapear uma coluna que não é chave primária da source para a chave primária da sink.
Reduzir a precisão de uma coluna de chave primária por meio de conversão de tipo ou agregação por grupo (por exemplo, converter de BIGINT para INT).
-
Transformar a coluna de chave primária, como concatenar várias colunas em uma só:
CREATE TABLE students (
  student_id   BIGINT NOT NULL,
  student_name STRING NOT NULL,
  course_id    BIGINT NOT NULL,
  score        DOUBLE NOT NULL,
  PRIMARY KEY(student_id) NOT ENFORCED
) WITH (...);

CREATE TABLE performance_report (
  student_info STRING NOT NULL PRIMARY KEY NOT ENFORCED,
  avg_score    DOUBLE NOT NULL
) WITH (...);

CREATE TEMPORARY VIEW v AS
SELECT student_id, student_name, AVG(score) AS avg_score
FROM students
GROUP BY student_id, student_name;

-- The concatenated result no longer satisfies the UNIQUE constraint
-- but is used as the primary key of the sink table.
INSERT INTO performance_report
SELECT
  CONCAT('id:', student_id, ',name:', student_name) AS student_info,
  avg_score
FROM v;
Uma operação de redistribuição de dados interrompe a ordem de classificação de uma chave única antes da gravação na tabela sink. Esse é o cenário do exemplo de join acima: o JOIN em
levelredistribui as linhas de s1 e quebra a ordem de classificação da chave primáriaid.O parâmetro
table.exec.sink.upsert-materializeestá definido comoforce.
Configure o SinkUpsertMaterializer
Use o parâmetro table.exec.sink.upsert-materialize para controlar quando o Flink adiciona o operador SinkUpsertMaterializer:
|
Valor |
Comportamento |
|
|
O Flink infere se eventos fora de ordem são possíveis e adiciona o operador se necessário. |
|
|
Desativa completamente o operador. |
|
|
Sempre adiciona o operador, mesmo quando nenhuma chave primária estiver definida na tabela sink. |
Definirautonão garante que os eventos estejam realmente fora de ordem. Por exemplo, usar uma cláusulaGROUPING SETScomCOALESCEpara converter valores nulos pode impedir que o planejador SQL determine se a chave de upsert corresponde à chave primária da sink. Nesse caso, o Flink adiciona o SinkUpsertMaterializer por precaução. Se os resultados estiverem corretos sem o operador, definatable.exec.sink.upsert-materializecomonone.
Para obter informações sobre operações de consulta suportadas no Realtime Compute for Apache Flink com Ververica Runtime (VVR) 6.0 ou posterior, operadores de runtime correspondentes e suporte a streams de atualização, consulte Execução de consultas.
Notas sobre desempenho e operação
O SinkUpsertMaterializer mantém estado para cada linha processada. Isso aumenta o tamanho do estado e adiciona sobrecarga de I/O nas leituras e gravações, reduzindo o throughput. Evite usar esse operador sempre que possível.
Como evitar o acionamento do SinkUpsertMaterializer
Garanta que a chave de partição usada para deduplicação ou agregação por grupo corresponda à chave primária da tabela sink.
Se um único paralelismo for suficiente para seu conjunto de dados e você quiser evitar eventos fora de ordem, defina o paralelismo como 1 e desative o SinkUpsertMaterializer configurando
table.exec.sink.upsert-materializecomonone.Caso exista uma cadeia de operadores entre o operador Sink e um operador stateful upstream (como deduplicação ou agregação por grupo), e não tenham ocorrido problemas de precisão de dados em versões do VVR anteriores à 6,0, migre a implantação para o VVR 6,0 ou superior. Defina
table.exec.sink.upsert-materializecomononee mantenha as demais configurações inalteradas. Para etapas de migração, consulte Atualize a versão do motor das implantações.
Quando o uso do SinkUpsertMaterializer é obrigatório
Não grave colunas geradas por funções não determinísticas (como
CURRENT_TIMESTAMPouNOW()) na tabela sink. Quando a chave de upsert não está disponível, o SinkUpsertMaterializer compara linhas inteiras, e valores não determinísticos impedem que linhas históricas sejam encontradas e removidas, causando crescimento ilimitado do estado.Se o estado do operador crescer a ponto de afetar o desempenho, aumente o paralelismo da implantação. Consulte Configure recursos para uma implantação.
Problemas conhecidos
O SinkUpsertMaterializer pode causar crescimento ilimitado do estado nas seguintes situações:
-
Sem TTL de estado, TTL muito longo ou TTL muito curto: Sem um tempo de vida (TTL) configurado, o estado acumula indefinidamente. Um TTL excessivamente curto também causa problemas: se o intervalo entre um evento DELETE e seu evento ADD correspondente exceder o TTL configurado, o Flink retém a linha no estado como dado sujo (veja FLINK-29225) e produz a seguinte mensagem de log:
int index = findremoveFirst(values, row);
if (index == -1) {
    LOG.info(STATE_CLEARED_WARN_MSG);
    return;
}
Configure o TTL conforme seus requisitos de negócio. Consulte Configure uma implantação. O Realtime Compute for Apache Flink com VVR 8.0.7 ou posterior suporta configuração de TTL por operador para reduzir o consumo de recursos em implantações com estados grandes. Visualize Configure paralelismo, estratégia de encadeamento e TTL de um operador.
Colunas não determinísticas sem chave de upsert: Se o stream de atualização que chega ao SinkUpsertMaterializer não tiver uma chave de upsert dedutível e incluir colunas de funções não determinísticas, as linhas históricas não poderão ser correspondidas por valor e nunca serão excluídas, causando crescimento contínuo do estado.
Próximos passos
Notas de versão — Mapeamento de versões do motor entre Realtime Compute for Apache Flink e Apache Flink
Execução de consultas — Operações de consulta suportadas e suporte a streams de atualização para VVR 6,0 e posteriores
Configure recursos para uma implantação — Aumentar o paralelismo para lidar com estados grandes do SinkUpsertMaterializer